ARTICLE · 1252923
29%的博士论文是AI写的:「信任两头塌」,用得最凶的是英语最吃力的人
加州大学伯克利分校数学系的一间办公室里,理查德·博彻兹做了个安静的决定。不再雇人批改作业。他手里有菲尔兹奖,数学界的最高荣誉,教了二十多年书。学生用AI稳定拿高分之后,他的原话是,看不出再花钱改对错还有什么意义。作业交了,就给完成度分。
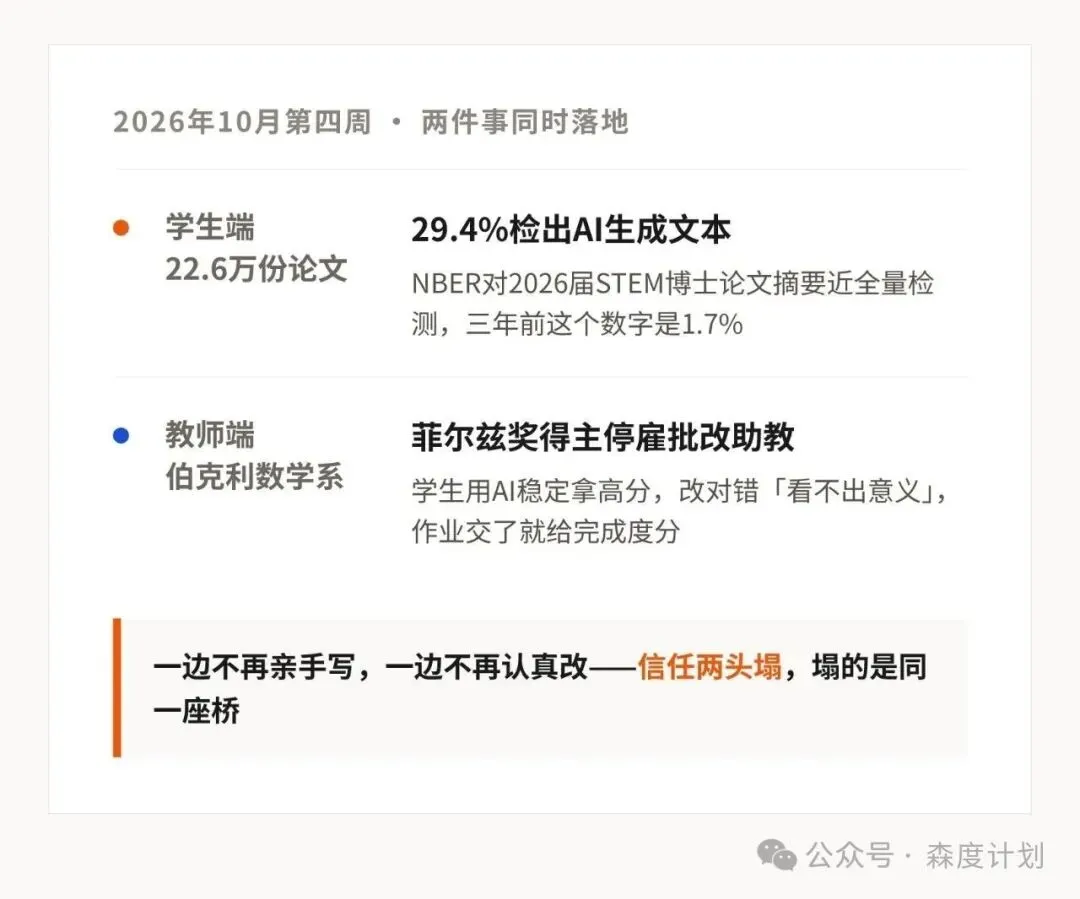
同一个星期,一份工作论文把226,591份STEM博士论文摘要跑了一遍AI检测。出品方是美国全国经济研究局(NBER),经济学界最有影响力的研究机构之一,团队在杜克大学。结果:2026届,29.4%检出AI生成文本。学生这头把写作交给机器,教授那头把批改停了。就像一场婚姻:一方不再说真话,另一方不再追问,剩下的只是手续问题。
🔑 费曼摘要:一份覆盖
22.6万份博士论文的检测账单说:2026届美国STEM博士论文29.4%含AI生成文本,三年涨了17倍。用得最凶的不是成绩最差的,是英语写作最吃力的。非英语背景41%,英语背景23%。同一周,伯克利的菲尔兹奖教授因为AI放弃批改作业。学生不再亲手写,老师不再认真改,学术评价赖以运转的信号正在两头塌陷。国内高校的AIGC检测红线(如30%)是同题的另一种解法,但误伤名单已经先到了。
01|先核账单:12.6万份旧论文,只误报了6份
这份论文编号w35859,样本近乎美国STEM博士全量。来源是ProQuest(美国学位论文数据库)加上各校库补全,2019年到2026年5月,226,591份摘要,外加340份全文随机抽样。检测工具是🏷️Pangram,一家商业AI文本检测服务。规模是应用史上最大的一次AI文本检测。
数字准不准?作者留了一手验证。ChatGPT问世前的2019到2022年,约12.6万份论文全是人写的,检测器只标红了6份。6÷126,000≈0.005%,误报率低到可以忽略。这个数先记下,后面还有用。
逐年看,曲线什么形状?2023届1.7%,2024届5.5%,2025届18.8%,2026届前五个月29.4%。我自己算了一遍:三年,29.4÷1.7≈17倍。照这个增速,作者推算2028年过半。
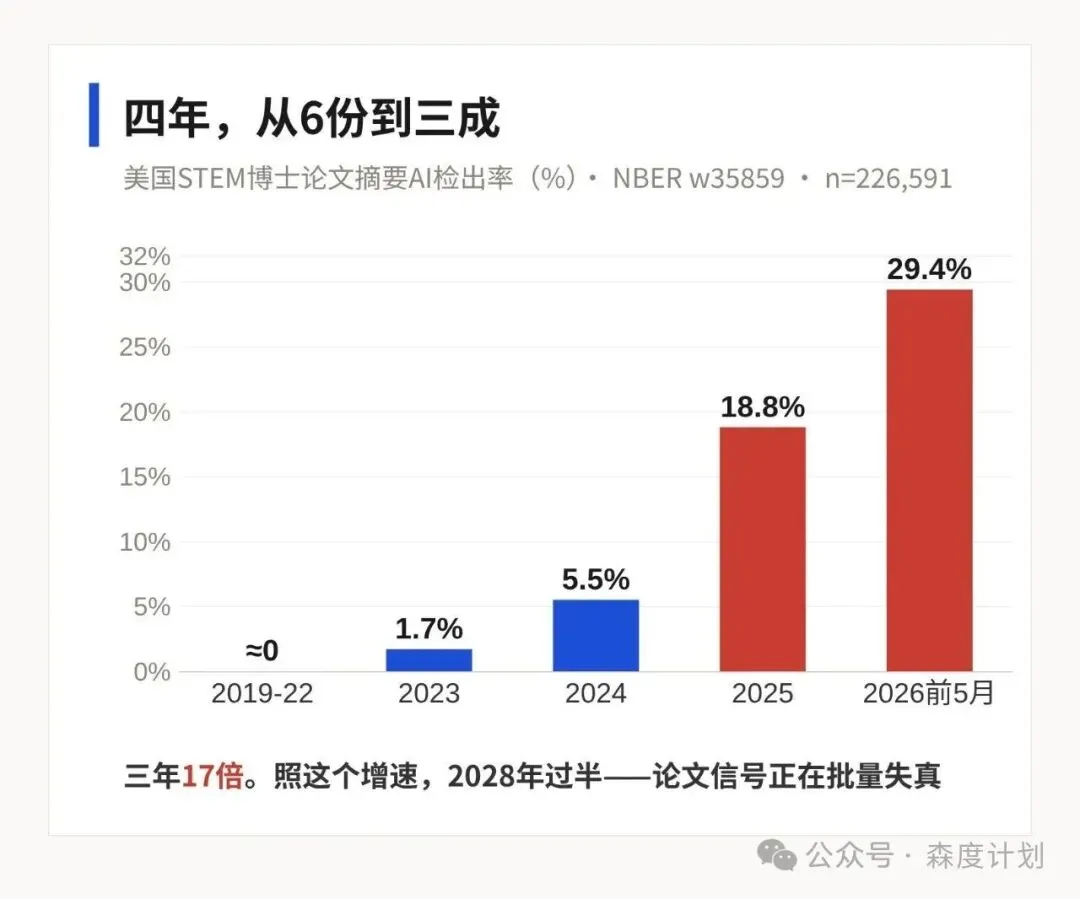
⚠️ 现实检验:三个限定要摆在明处。其一,Pangram是商业公司,论文致谢里写着它提供了API额度和折扣。检测标准属厂商自证口径。其二,摘要口径是下界,换算成全文,2026届约
31%。其三,NBER工作论文未经同行评审。方向可信,精确值存疑。
平均数说完了。拆开人群,才是这份账单真正的爆点。
02|用得最凶的,不是学渣
读这份研究之前,你多半默认代写主力是学渣:成绩差,想蒙混,拖到截止前夜抱佛脚。数据把这幅图推翻了。
分界线不在成绩,在语言。2026届里,非英语国家背景的博士生,论文AI检出率41%;英语背景,23%。
分国家看:中国44%、印度43%、韩国49%、伊朗51%,全都压着美国本土的23%打。把同一项目、同一届的博士生放在一起比,排除学校和专业差异。2025-26年差距仍有11.7个百分点。
学校梯度同样反直觉:顶尖的R1大学28%,R2是31%,其他博士授予院校37%。MIT只有9%,Caltech 10%,普林斯顿13%;专业排名前10的项目15%,排到90-100名,26%。学科上呢?计算机48%、土木工程51%,数学与统计反而只有17%。
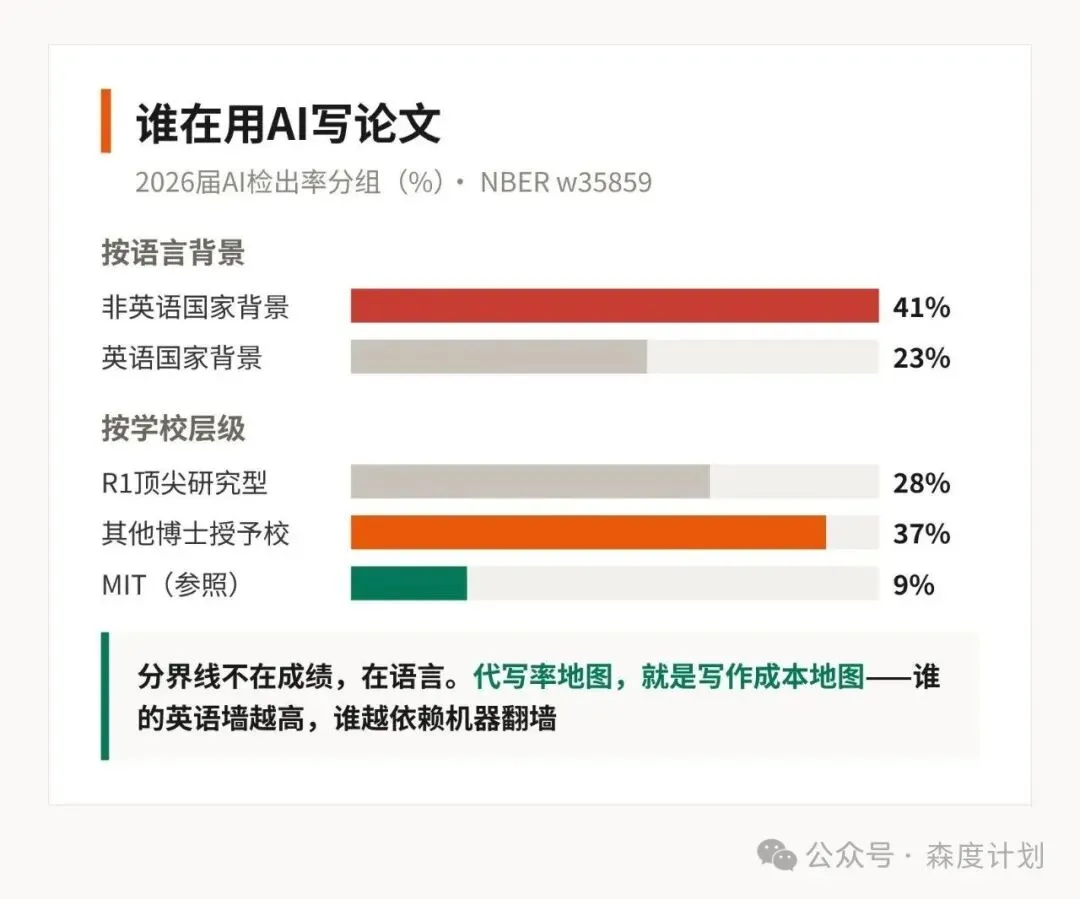
为什么是这个分布?经济学逻辑就一条:写作成本套利。博士论文对非母语者是一堵语言墙,LLM把翻墙成本降到几乎为零,成本越高的人,套利越狠。MIT的学生不缺英语,代写收益小;英语吃力的博士生,AI是救生圈。这件事的本质:代写率地图,就是写作成本地图。
这批用AI最多的学生,毕业后去了哪?账单还记着这一笔。
03|AI写论文的人,正在离开学术界
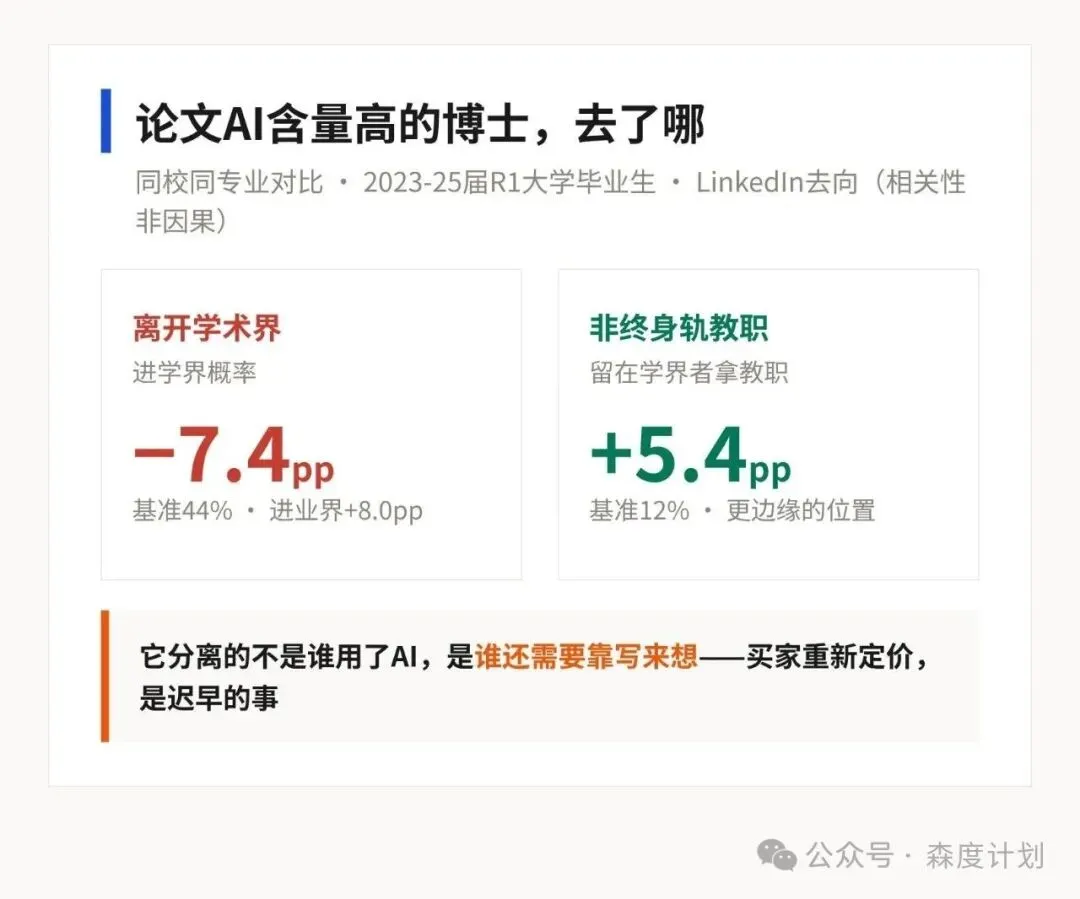
作者把这批毕业生(2023-2025届、R1大学)的LinkedIn去向扒了出来,跟同校同专业不用AI的同期对比。导师们看到两个词就该紧张:分流,重定价。
进学术界的概率,低7.4个百分点,基准是44%。进工业界,高8.0个百分点,基准50%。留在学术界的那部分,拿非终身轨教职的概率高5.4个百分点。方向一致:论文AI含量高的博士生,更早、更彻底地离开了研究这条路。
因果要小心:这是相关性,作者自己也承认。一种是AI代写掏空了训练,写作能力没长出来,学术市场用脚投票;另一种反过来,本来就不想搞学术的人对论文投入低,顺手交给了AI。两种解释哪个对?
作者拿论文页数做过检验:代写与否和篇幅不相关,低投入的说法不完整,但定不了案。
我的判断是:两种解释可能同时为真,而劳动力市场不在乎区分。论文AI含量正在变成一个分离变量,它分离的不是谁用了AI,是谁还需要靠写来想。
博士学位的隐性市价,买的本是一套研究能力信号:五年以上的训练、每年数万美元的资助、导师投入的时间。信号源里三成内容由机器生成,买家重新定价是迟早的事。
谁受益,谁受损,谁买单?受益的是短期的通关者和按论文数考核的课题组。受损的是信号系统本身,还有跳过写作训练的学生。买单的是下一个雇主,和答辩委员会。
学生这端撤了。教授那端呢?
04|菲尔兹奖得主不批改作业了
回到开头的👤博彻兹。我去核了《加州日报》10月24日的采访原文。他把话说得很直:学生用AI稳定拿高分。再花钱请批改助教(reader)改对错,看不出意义,no point。现在的规则是作业交了就给完成度分。他自己承认,not a very good system,不是个好系统,但眼下没有替代。
伯克利校方试过怎么办?试过Turnitin,又试过Rumi,两代AI检测工具。校方对它们的信任,都不足以推进全校标准化:师生两头的利益都没法交代。
博彻兹还补了一刀:学术系统惯性很大。纸质期刊毫无意义地活了二十年,数学系再撑几年不成问题。有学生问他该不该入行数学,他去问ChatGPT,ChatGPT也说不知道。
这个个案的分量在哪?数学是答案对错最容易验证的学科,批改成本最低,查作弊也最不难。连这里都弃守,人文学科的处境可想而知。
当一个领域的顶级从业者把作业信号的信用作废,等于官方广播:这个频道不再播真话。师生之间那纸信任契约,先于检测器破产。
一边是检测器不被信任,一边是干脆不改了。还没完,这个局面在结构上比个案大得多。
05|信号两头塌:写的不真,改的不信
把两端放在一起看,才看得到这件事的本质:评估赖以运转的信任,正在两头塌陷。
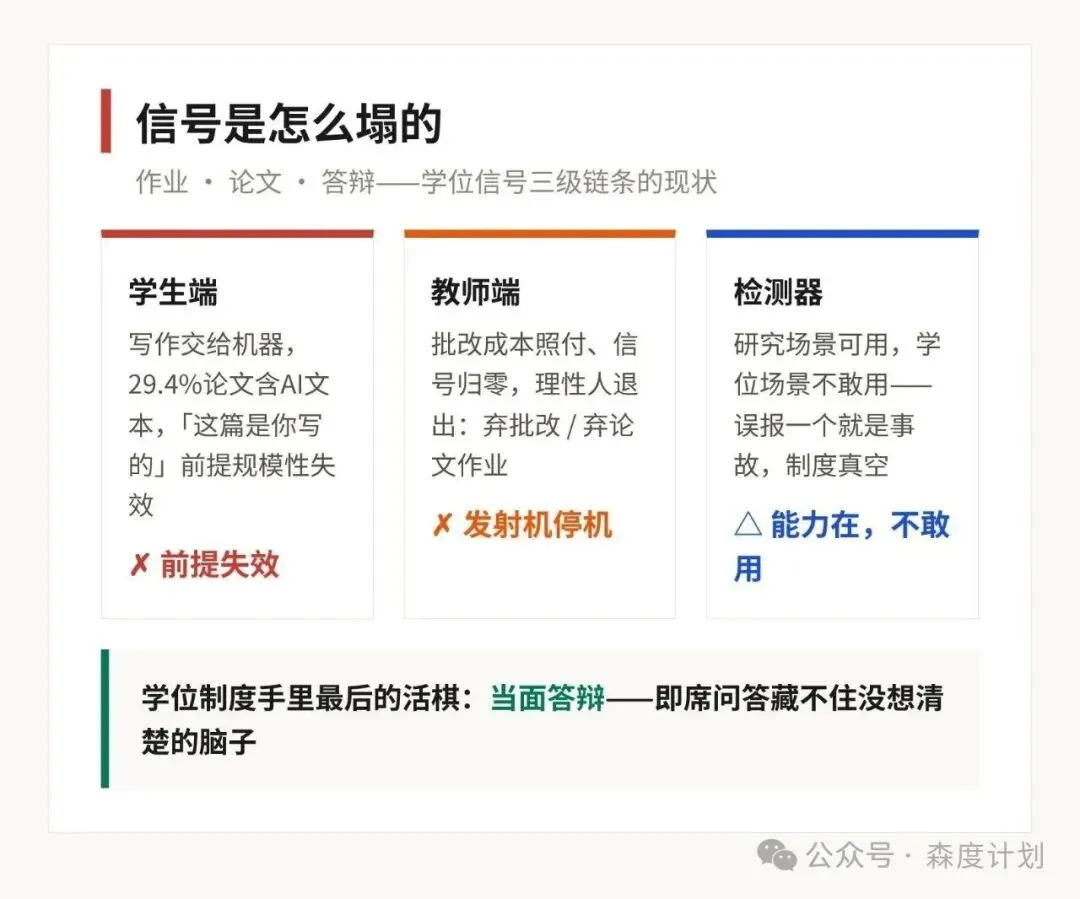
学生端,论文和作业的价值建立在「这篇文字是你写的」这个前提上。29.4%的检出率说明,前提已经在规模性失效。更麻烦的是,检测与反检测是一场不对等的攻防。检测标准必须公开,学生有权知道规则;伪装手段必然私密。公开的一方永远在追私密的一方。
教师端,博彻兹停发对错信号是止损动作。批改的成本照付,信号的含金量归零,理性人退出。
国内的镜像动作方向相反、逻辑相同。同济大学法学院张韬略教授干脆取消了期末论文,改成现场开卷、脱离电子设备作答。美国教授弃批改,中国教授弃论文作业,弃的都是被污染的信道。
🌉 类比桥:劣币驱逐良币说的是,货币成色没人验,人人藏起好币、花出坏币,最后市场上只流通坏币。论文信号与此同构。当成色验不出来(检测器不合格),亲手写的人得不到奖励,代写的人付不出代价。可验证的努力,就从系统里退出了。
中间还夹着检测器这门生意。伯克利判了不合格的🏷️Turnitin们,和论文里表现不错的Pangram,差在哪?部署环境。研究场景误报几个无伤大雅,学位授予场景误报一个就是事故。能力存在,制度不敢用。
作业、论文、答辩,学位信号的三级链条,前两级正在同时松动,只剩答辩这一环还活着。NBER作者给出的两个出口也印证了这个结构。要么改评价方式,把权重压到口头答辩。要么上验证技术,给「人写的努力」发可核查的凭证。
这件事跟中国读者的距离,比看起来近得多。红线已经画到了自家门口。
06|中国版答案:红线30%,误伤先到
美国名校弃检测,国内高校反着来:全量上。
去年3月,西南交通大学发文,全部本科毕业论文加测AIGC率,原则上不超过30%。天津科技大学、湖北大学等校跟进;复旦大学2024年底出台了AI工具使用规定;中国传媒大学要求学生披露用了什么模型、什么版本、什么时间。检测进学位授予环节,已成事实。
为什么方向相反?制度的风险账不同。美国高校怕误伤官司,国内高校怕漏检问责,各自把风险定价进了流程。
误伤名单也已成事实。中国人民大学新闻学院副教授董晨宇,把自己团队做了三年的直播产业研究论文送检。系统标红「高度疑似AI生成」,总检出率82.54%。标红的恰是三年田野调查写出来的部分。
网友把《滕王阁序》《岳阳楼记》塞进检测器,AI率超过50%。四川师范大学专门设计了申诉表格:没用过AI却被判高AI率的学生,填表交学院研判。
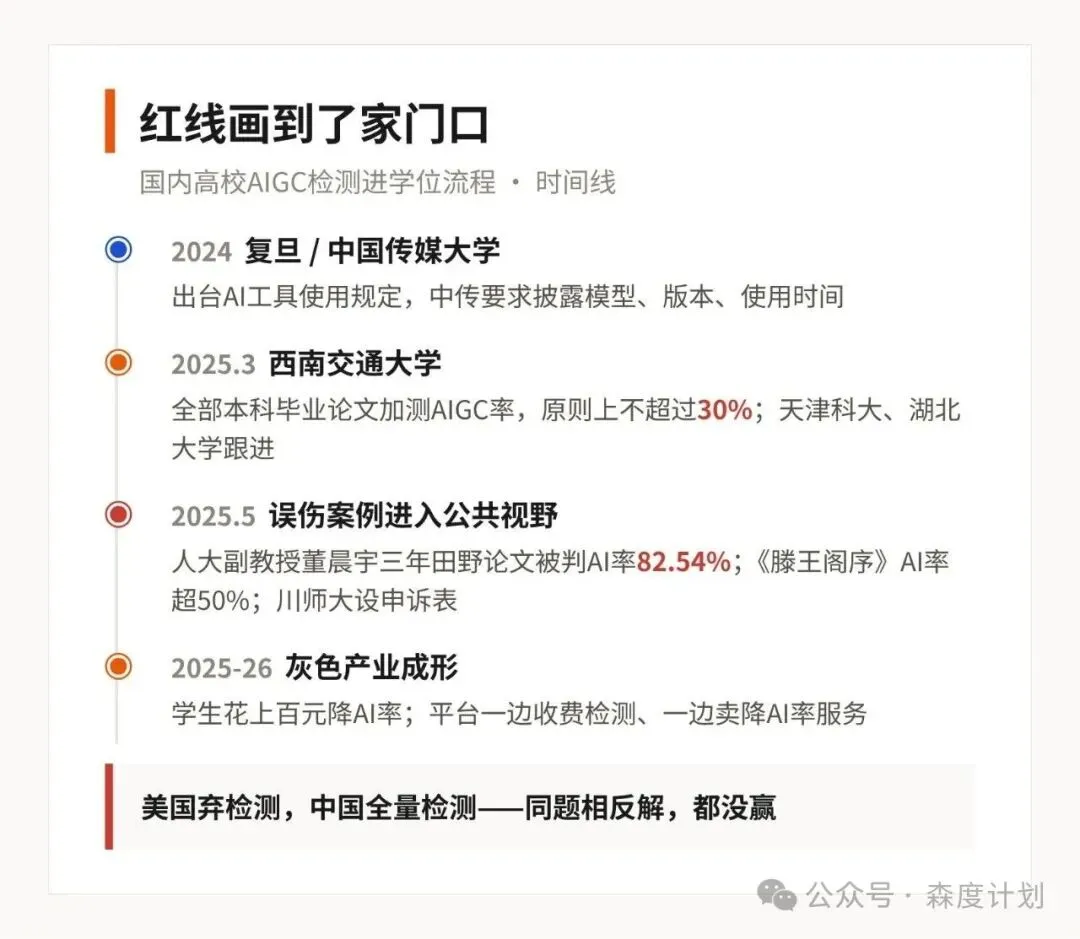
学生端已经摸出游击规律:排比句、押韵对偶、带冒号的并列句容易被判成AI。改成长句混着写,检测就过了。有人为降AI率花掉上百元,还有平台一边收费检测,一边兜售降AI率服务。检测器没拦住代写,先训练出一批把文章故意写糊的学生。
同一道题,两国给了相反的解:一个放弃检测,一个全量检测。哪个对?答案不在工具里,在博弈结构里。
07|军备竞赛为什么打不赢
先看检测器的原理天花板。现有工具靠文本特征比对加概率阈值:句式工整、用词平滑,加分。可AI学的就是人类表达,人类又在模仿AI的工整,两边特征逐年趋同。
好比钞票越印越真,验钞机却在用上一版的模板。OpenAI自己2023年就下架了自家的AI文本检测器,理由是准确率不够。厂商尚且不敢担保,学校拿它定生死,误伤只是时间问题。
再看博弈结构。检测每公开一个特征,伪装就多一个靶子。国内学生「改长句过检」的经验,就是这条规律的微观样本。
真正的问题不在算法精度,在攻防的不对等。防守方的规则必须透明,进攻方的手段永远保密。
核心判断:这场军备竞赛检测器赢不了,置信度高。可证伪信号也摆在明处。若下一代检测器把误报率压到十万分之一以下,且通过独立验证,这个判断作废。
💡 出路不在更准的检测,在换地方验证。 学位制度手里本来就握着一样检测器做不到的东西:当面答辩。写作可以外包,即席问答藏不住没想清楚的脑子。NBER作者点名的另一个出口,给「人写的努力」发可核查凭证,正是过程性评价在做的事。不看最终文本像不像人,看生产过程留没留痕。
一周之内,学生端、教师端、制度端三份证据同时到齐。普通人这一周能带走什么?
08|带得走的判断
📋 一张对照表带走全文 论文AI率(2026届美国STEM)|
29.4%,三年17倍 用得最凶的群体|非英语背景41%vs 英语背景23%顶尖校 vs 普通博士校|MIT9%vs37%教师端回应|伯克利弃批改,两代检测器不被信任 国内回应|红线30%全量检测,82.54%误伤案例在案 还立着的环节|当面答辩
学生问自己两句:交出去的文本里,有多少是你想清楚的?全交给AI,答辩那天你靠什么站着?教师和导师同问一句:你还在批改对错,还是已经在给完成度打分?
为什么最后守住的是答辩?因为即席问答的因果链没法外包:你讲不清推导,就是因为没想穿。这是制度设计里躲不掉的约束。
失效条件说清楚。一,检测器误报率进入十万分之一量级并通过独立验证,本文「军备竞赛打不赢」的判断作废。二,2028年前主流高校把评价权重移到口试和过程留痕,信号两头塌自动缓解。三,两个语言群体的使用率差距收窄到5个百分点以内,说明AI成了全员基线。套利结构消失,本文的核心反差失效。
🔭 下一步观察:盯三个窗口。NBER论文的同行评审版。第一个把AIGC申诉做成正式制度的省份。第一所公开把答辩权重提过论文本身的高校。为什么盯这三个?它们分别对应检测、申诉、改道的第一次制度化落地。任何一个到位,这个领域的一年期图景就要重画。
🧠 本质:博士论文的价值从来不在那几万字,在写的人被迫把想法想穿。29.4%真正测出的是,有一批人正在跳过这道工序。而评价系统还没找到新办法,逼任何人想穿任何事。
参考来源
[1] NBER, "How Heavily Are PhD Students Offloading Their Scientific Writing to AI? Evidence from US STEM PhD Dissertations"(w35859), 2026-10.[2] The Daily Californian, "AI use leads UC Berkeley math professor to see 'no point' in grading homework", 2026-10-24.[3] 中国青年报, "论文AI率检测如何避免'误伤'", 2025-05-17.[4] OpenAI, "New AI classifier for indicating AI-written text"(已下架公告), 2023-07.