ARTICLE · 1274749
大模型不是一口气练成的:从“续写生”到 AI 助手
为什么同样是大模型,有的只会顺着你的话往下写,有的却能听懂要求、调用工具、检查答案,甚至在危险问题面前及时刹车?
答案不只是“参数更多”!
把大模型训练想象成一所学校:预训练是通识教育,中期训练是专业课,监督微调是老师示范,偏好训练是行为规范,推理强化是竞赛班,安全与评测则是贯穿全程的考试。
这个比喻不意味着训练严格按年级推进——真实工程里,模型会反复补课、重考,今天的错题也可能变成明天的新教材。
01第一课 预训练:先成为一个“续写高手”
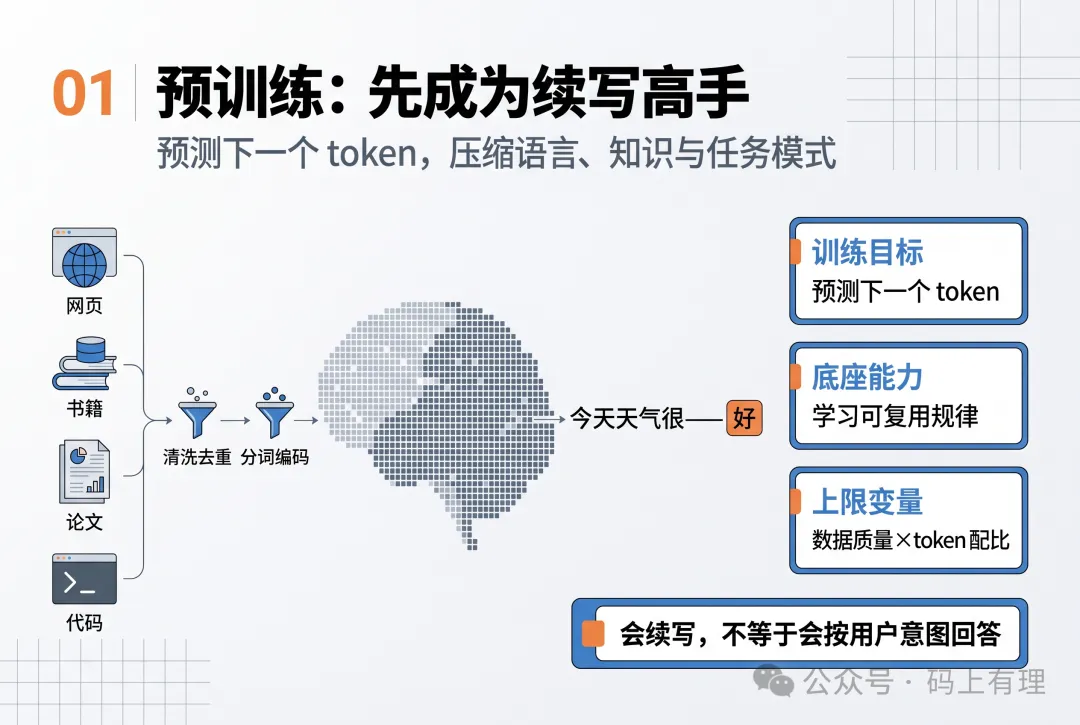
大模型最初学的任务,看起来朴素得有些不可思议:根据前面的内容,预测下一个 token。
token 可以理解为模型读取文本时使用的基本单位,可能是一个字、一个词的一部分,也可能是一段代码符号。训练时,模型会读网页、书籍、论文、百科和代码,不断猜下一个 token;猜错了,损失函数就给出反馈,再通过反向传播调整参数。
为什么“猜下一个词”最后能练出翻译、问答、写代码等能力?因为要补全不同类型的文本,模型不得不学习其中反复出现的规律:语法怎样组织,人物指代谁,代码如何闭合,事实之间怎样关联,一道题通常按什么步骤展开。
GPT-3 的研究显示,同一个自回归模型可以迁移到翻译、问答、完形和简单推理等多类任务。但这里需要踩一下刹车:广泛迁移说明模型形成了可复用的内部表征,不等于它已经拥有与人类相同的理解方式。
教材质量,决定底座上限。
预训练并不是“抓取越多网页越好”。教材进入课堂前,还要经历筛选、清洗、去重和分词:
数据配比:网页提供规模,书籍、论文、百科和代码补足不同知识类型。
清洗去重:移除乱码、模板和重复内容,减少机械记忆与逐字复现。
分词编码:把文本转换成 token ID;某种语言如果被切得更碎,同样的上下文窗口就装不下那么多信息。
Chinchilla 研究还指出,参数量与训练 token 需要一起扩展。学校扩建了教学楼,却没有足够教材,成绩不会自动变好。
02第二课 中期训练:通识之后,还要补专业课
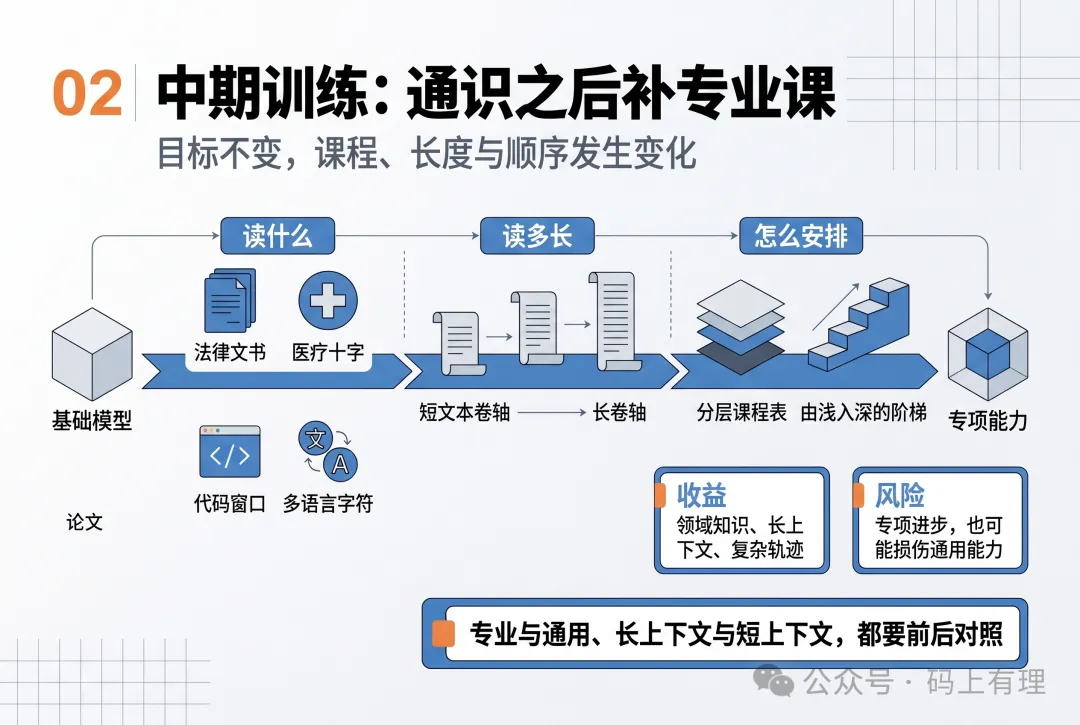
完成大规模预训练后,模型通常已经具备语言和知识底座,但能力分布未必适合目标场景。
于是出现了一个边界仍不完全统一的阶段:中期训练。
它往往继续使用下一 token 预测,却改变三件事:读什么、读多长、按什么课程顺序读。
增加法律、医疗、代码或特定语言材料,补足领域知识;
用更长的序列继续训练,提升长文检索与跨段关联能力;
加入工具调用、推理或智能体轨迹,练习更复杂的执行过程。
这类“补课”也有副作用。专业材料占比太高,模型可能在目标领域进步,却丢掉部分通用能力;上下文窗口变长,也只代表模型能接收更多内容,不代表它一定能准确找到远处的信息。
所以,中期训练不能只看专项成绩。专业与通用、长上下文与短上下文,都要前后对照。
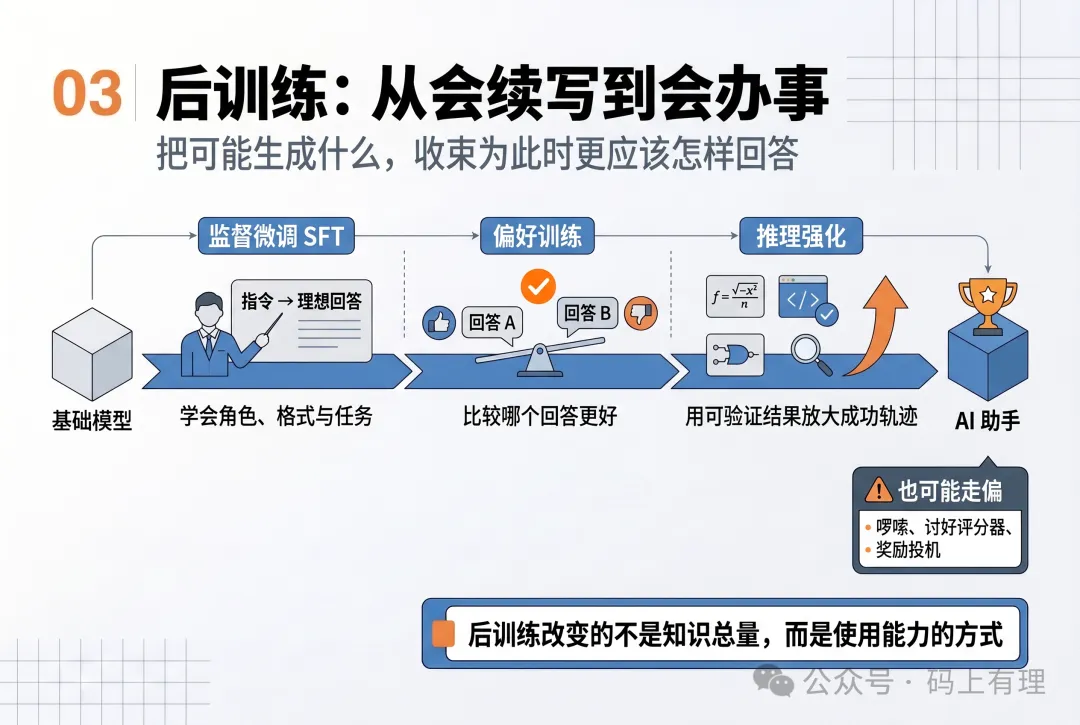
03第三课 后训练:从“会续写”到“会办事”
预训练模型见过大量文本,却未必知道用户真正想要什么。你让它“整理成三点”,它可能继续写成一篇文章;你问一个没有答案的问题,它也可能顺着语言概率编下去。
后训练的任务,就是把“可能生成什么”收束为“此时更应该怎样回答”。
监督微调:老师先示范。
监督微调(Supervised Fine-Tuning,SFT)把教材换成“指令—理想回答”。模型由此学会识别角色、遵守格式、完成常见任务,并逐渐形成助手式的回答习惯。它的优点是目标清楚、训练稳定;局限也很明显:一份标准答案只能展示一种做法,很难表达“两个答案都能用,但其中一个更准确、更简洁、更诚实”。
偏好训练:比较哪个答案更好。
为了提供更细的信号,训练者会让模型针对同一问题生成多个候选答案,再由人类或 AI 进行比较。经典人类反馈强化学习(Reinforcement Learning From Human Feedback, RLHF)会用这些排序训练奖励模型,然后通过强化学习提高高分回答的概率;
直接偏好优化(Direct Preference Optimization, DPO)使用“胜出答案—落败答案”偏好对训练模型,直接提高前者相对于后者的生成概率。它与经典 RLHF 的目标相近,但不需要单独训练奖励模型,也省去了基于该奖励模型的强化学习环节,因此训练流程通常更简单、更稳定。
可以把两者类比为:RLHF 先训练一名“裁判”,再让模型按裁判打分练习;DPO 则直接告诉模型“这两个答案里,更应该学这个”。
InstructGPT 的实验里,1.3B 参数的对齐模型在人类偏好评测上胜过 175B 的纯预训练 GPT-3。它并不是突然知道得更多,而是更懂得如何按人的意图使用已有能力。
偏好训练同样可能走偏:评分器偏爱长答案,模型就可能变得啰嗦;训练数据偏爱某种语气,它就可能形成僵硬风格;奖励机制存在漏洞,模型甚至会学着“讨好考官”。
推理强化:做可以自动判分的题。
数学、代码和部分科学任务有一个优势:答案或执行结果可以自动验证。模型可以反复采样不同解法,由答案匹配、单元测试或形式验证器判分,再放大更容易成功的轨迹。DeepSeek-R1 的公开报告展示了这条路线的潜力。不过,可验证奖励并不天然保证解释忠实、表达简洁或行为安全。通过测试,有时只是说明模型找到了测试器认可的路径。
04第四课 安全与评测:安全不是毕业前临时抱佛脚
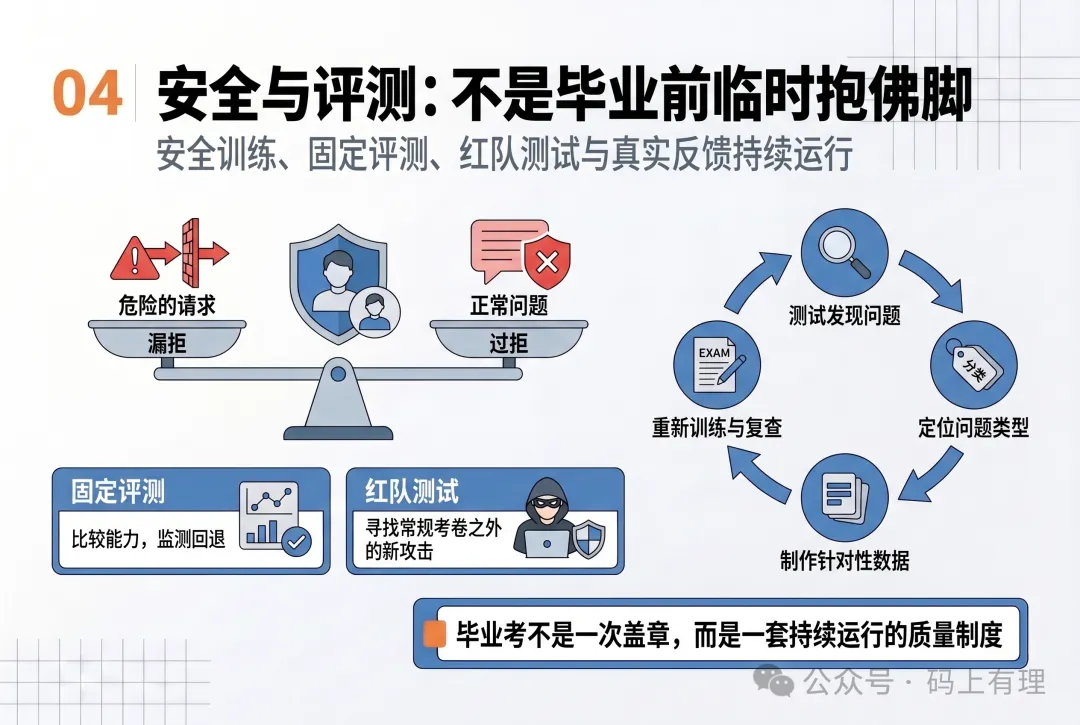
安全训练会使用政策示范、拒答与合规回答对、对抗样例和偏好比较,让模型在高风险请求上拒绝或转换回答,同时尽量不误伤正常问题。
这里存在一组天然矛盾:拒绝太少,危险请求可能漏过;拒绝太多,正常问题又会被挡在门外。因此,“拒答率越高越安全”并不成立。
固定评测和红队测试承担不同工作。前者适合比较能力、监测回退;后者专门寻找常规考卷没有覆盖的新攻击路径。模型上线后,还要靠真实反馈发现新的使用分布与系统级问题。
更可靠的闭环是:测试发现问题 → 判断是知识缺失、指令误解、奖励漏洞还是安全策略问题 → 制作针对性数据 → 重新训练 → 用未参与训练的保留集复查。
毕业考由此不再是发布前盖一次章,而是一套持续运行的质量制度。
05为什么不把所有目标一次练完?
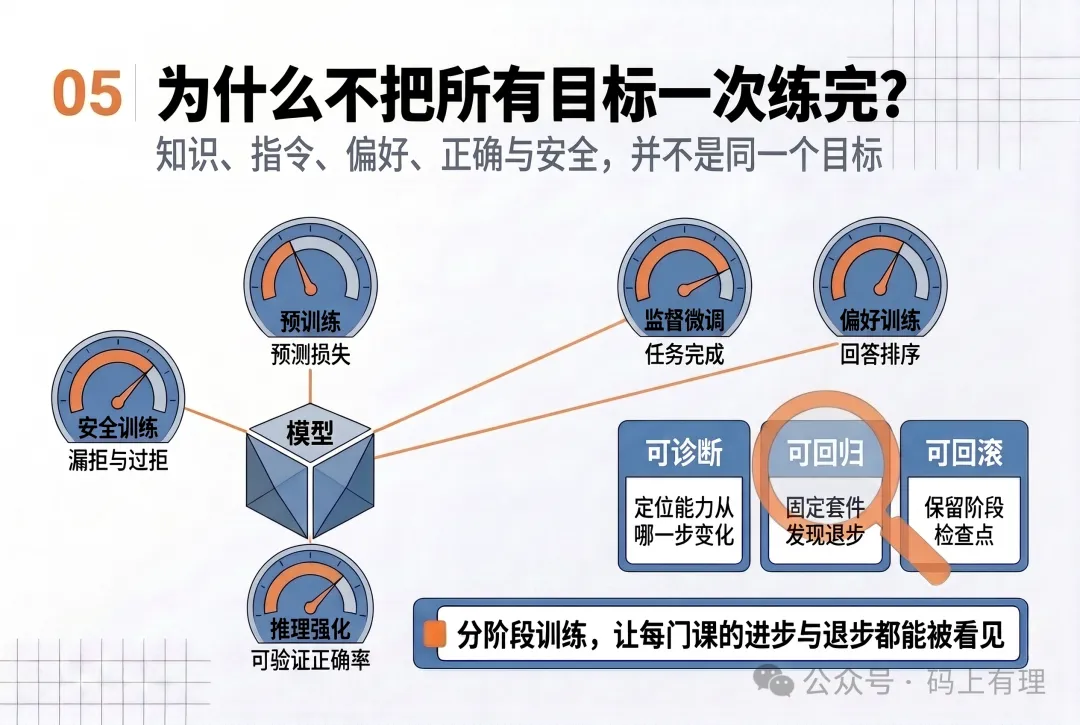
因为“知道得多”“按要求回答”“让人满意”“答案正确”“足够安全”并不是同一个目标,甚至会彼此冲突:
预训练主要看预测损失和通用能力;
SFT 看指令与任务完成;
偏好训练看回答排序;
推理强化看可验证正确率;
安全训练则要同时关注漏拒、过拒和越狱风险。
把这些目标压成一个总分,某个目标就可能吞掉其他目标,出了问题也更难定位。
分阶段训练真正带来的,不只是流程清晰,而是可诊断、可回归、可回滚:
保留阶段性检查点,能找到能力从哪里开始变化;
每一阶段使用匹配的独立指标,避免“一科高分掩盖另一科退步”;
新能力上线前跑固定回归套件,及时发现灾难性遗忘和奖励投机。
06看懂训练名词,只需追问四件事
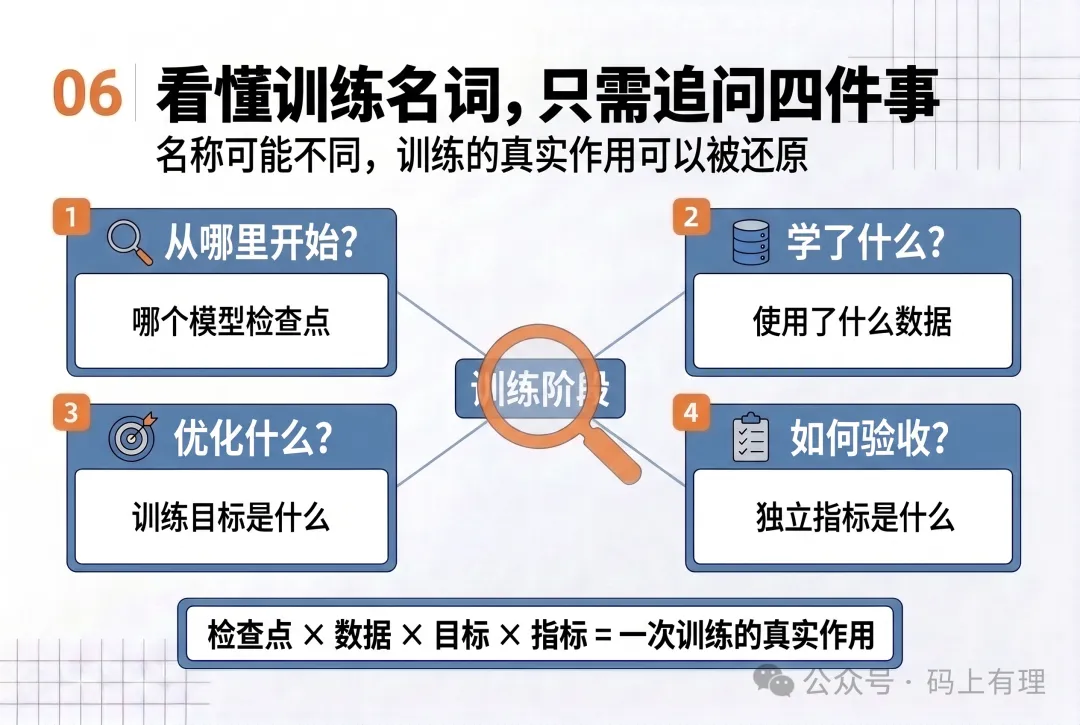
以后再遇到“中期训练”“后训练”“对齐”“推理强化”等术语,不必先纠结名称。不同团队对阶段边界的叫法并不统一,真正有用的是追问四个问题:
•︎ 从哪个模型检查点开始?
•︎ 使用了什么数据?
•︎ 优化的目标是什么?
•︎ 用什么独立指标验收?
这四个问题,基本能还原一次训练的真实作用。
大模型不是一口气“炼”出来的。它先在海量文本中形成能力基座,再通过专项补课、示范学习、偏好比较、可验证奖励和安全评测,逐步从“续写生”变成可用的 AI 助手。每一次考试的结果,还会回到下一轮教材里。
真正成熟的训练系统,不追求某一张考卷上的满分,而是清楚地知道:模型在哪门课进步了,又在哪门课退步了。