ARTICLE · 1289788
AI读论文总是漏公式、串表格?先检查PDF有没有被正确解析
你把论文交给AI,追问一张表里的数值,得到的回答却把两列混在一起。再让它解释公式,变量又少了一项。这时继续追问,可能只是在错误的输入上反复加工。
理解论文之前,还有文档解析这一关。对双栏、公式、跨页表格或扫描材料,先做一次小范围核对,后面的阅读和检索才能有可靠起点。
01 / 看得到的页面,不等于读得到的结构
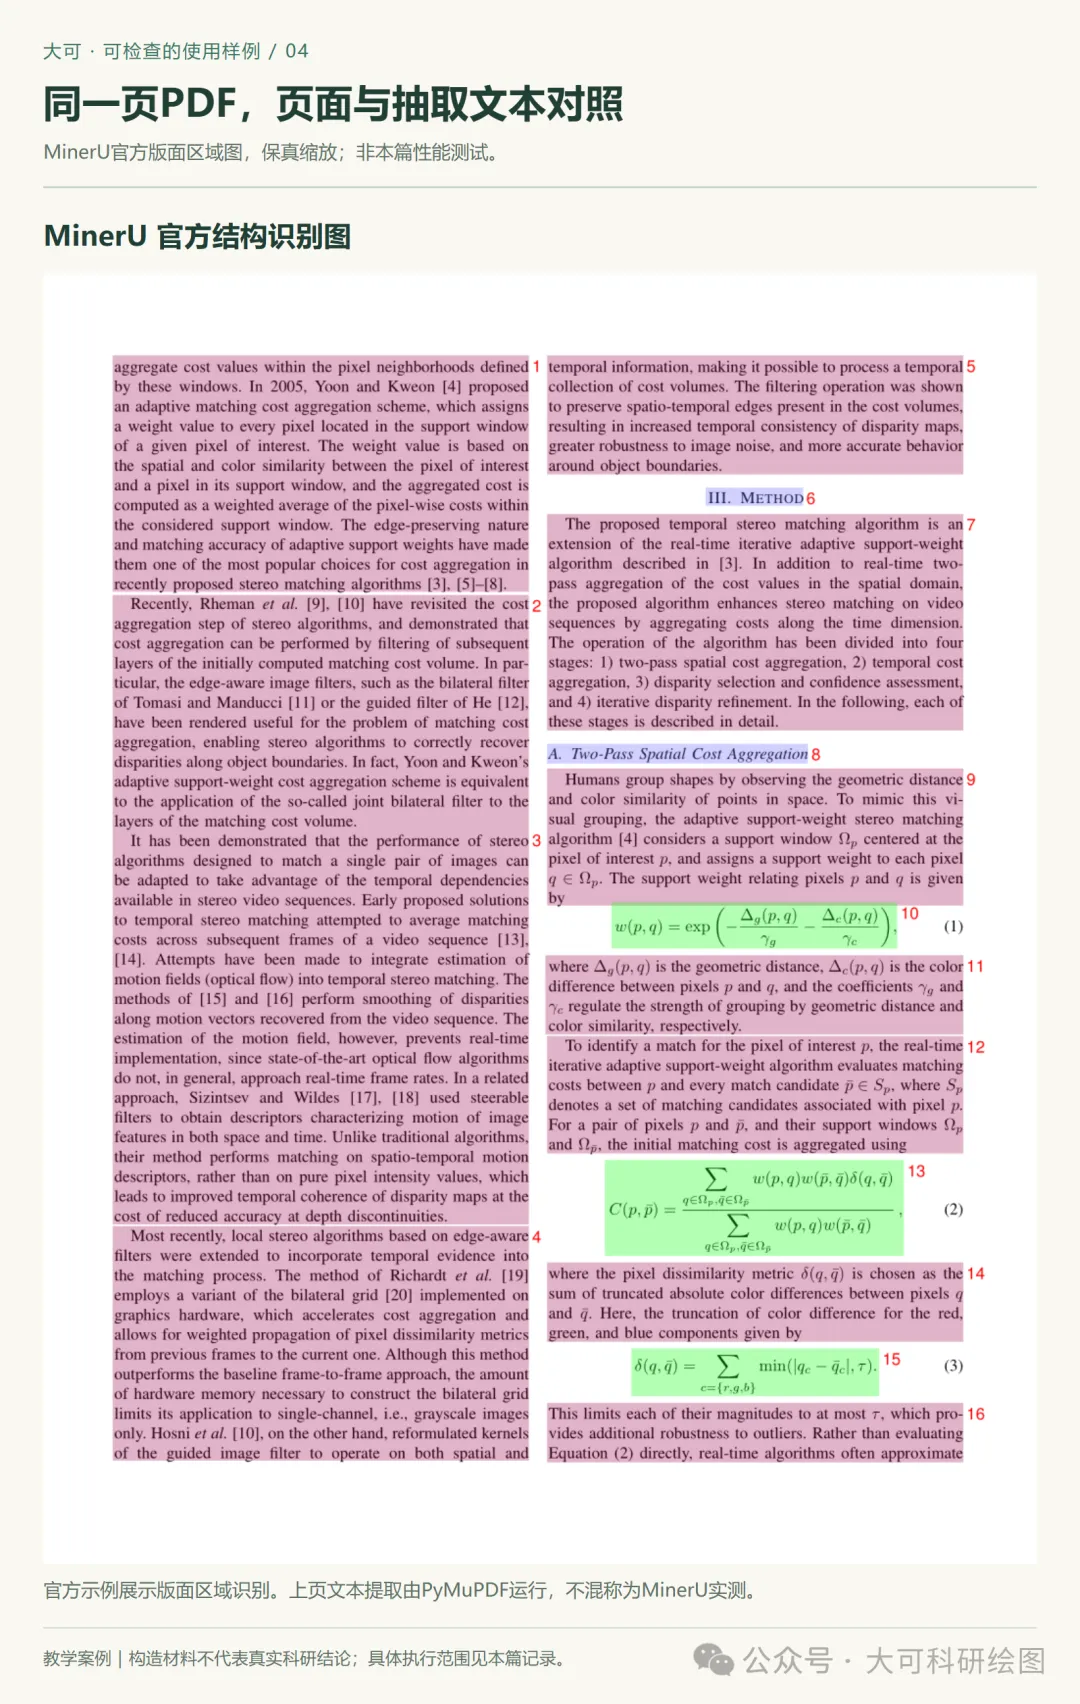
PDF页面的视觉位置和文本抽取顺序未必一致。双栏正文可能被交叉读取,页眉页脚可能混入段落,表头与数值也可能在转换后失去对应。扫描页还要经过文字识别。
因此,“文件已经上传”只说明助手拿到了文件;它实际读到什么,应该用抽取结果与原页对照。先选内容复杂的页面,比只抽查封面和摘要更有意义。
先看官方用法与入口
先以一页正文、一页公式、一页表格检查结构,再批量转换。
MinerU 官方入口
https://github.com/opendatalab/MinerU
02 / 用三种页面做一次抽查
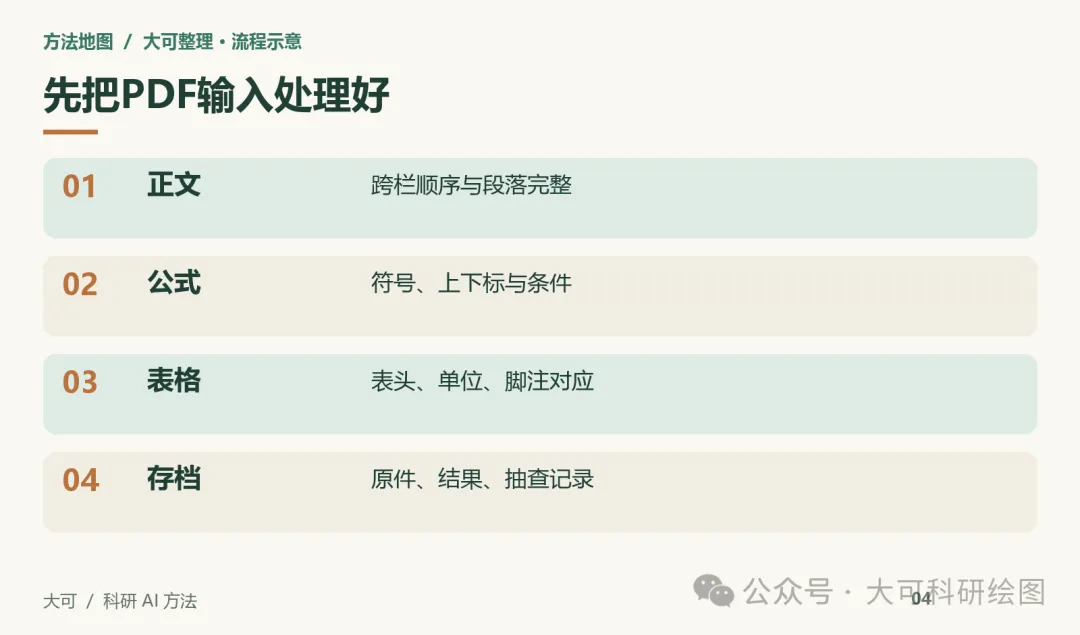
大可建议从当前论文各选一页:双栏正文、关键公式、主要结果表。正文页检查段落顺序;公式页检查符号、上下标和条件;表格页检查表头、单位、脚注与数值对应。
如果论文最关键的是一张流程图,还应单独检查图内标签和箭头。文本抽取正确,并不能自动说明图像里的关系已经被理解。把解析任务和图表理解任务分开,后面更容易定位错误。
这次具体看一个例子
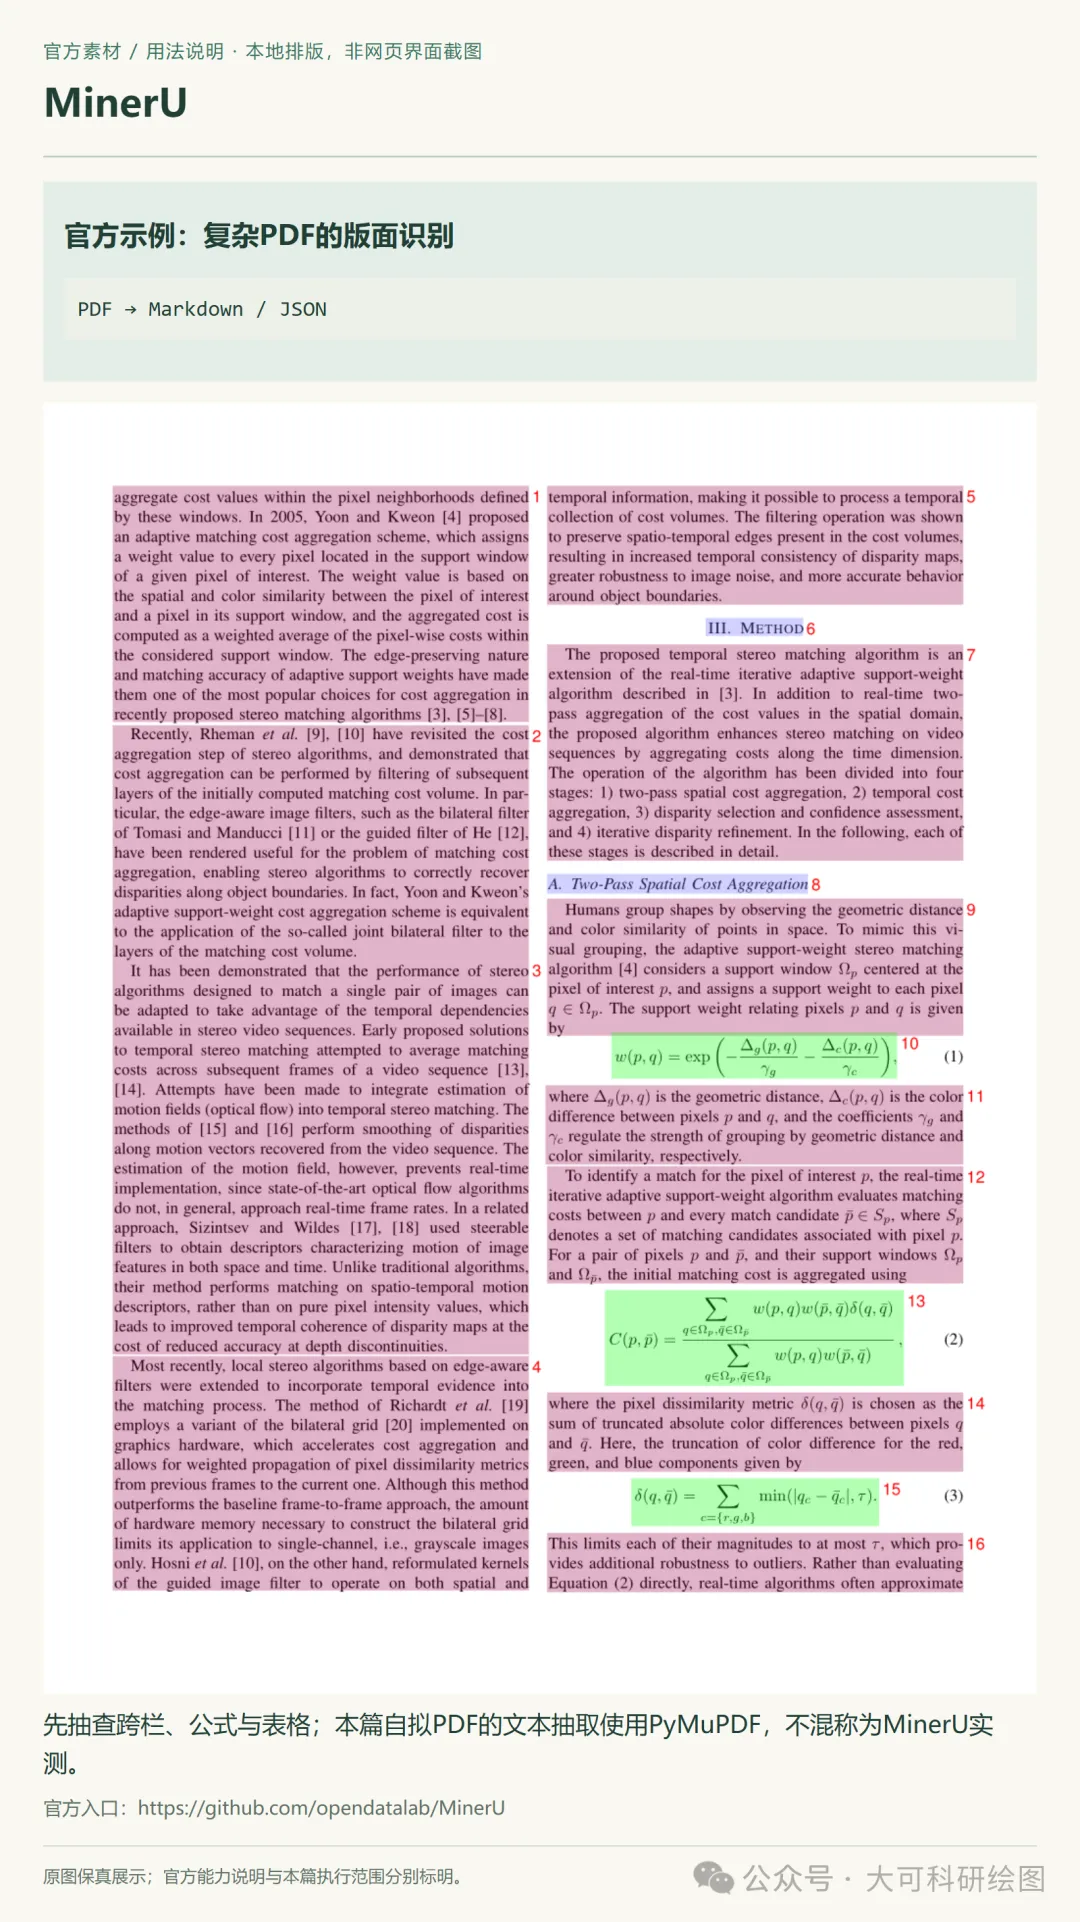
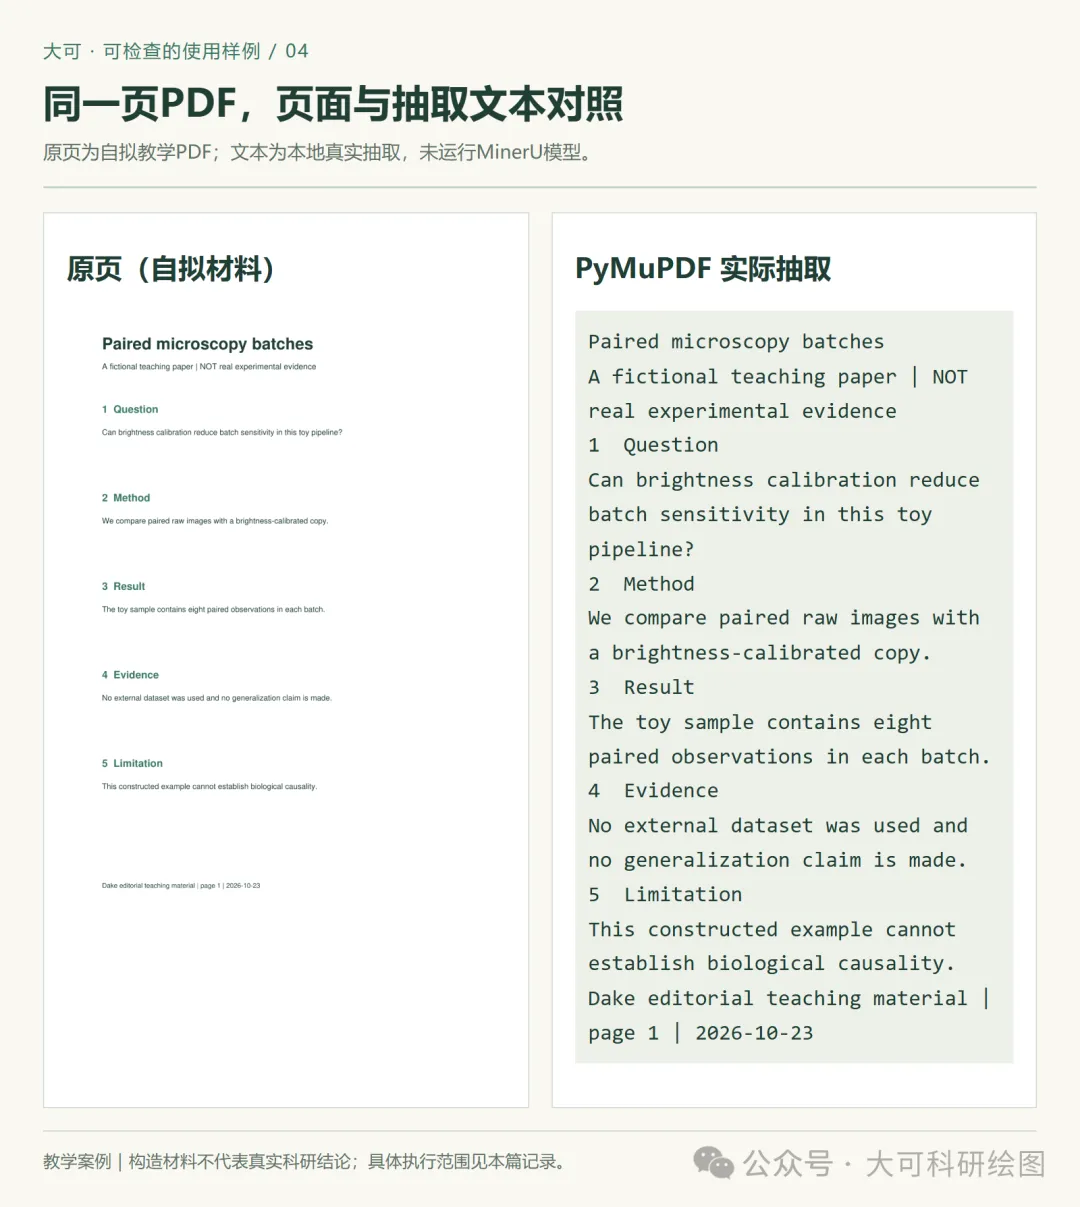
我们另做了一页教学PDF,用PyMuPDF实际抽取文本,再把原页和结果并排放在图里。这个简单样本方便理解对照方式,不能证明复杂论文都能解析正确。旁边的MinerU官方图展示另一层工作:识别版面中的文字、表格等区域。两张图对应的执行工具分别标注。
03 / MinerU可以放在哪个位置
MinerU官方将项目定位为把复杂文档转成便于后续处理的Markdown、JSON等内容。它适合放在“准备输入资料”这一层,再把结果交给检索、问答或阅读流程。
具体使用前,需要按当前官方说明确认可用入口与运行条件。本文没有进行不同解析器的统一评测,也不把某个复杂样本的成功解析推广到所有论文。选择工具时,优先拿自己真正要处理的文档抽查。
04 / 解析结果要和原件放在一起
可以给每篇论文保留原PDF、转换文本、图片目录和抽查记录。转换文件中如果没有可靠页码映射,就不要在后续问答里让AI凭空给出原页位置。
发现某个公式或表格不可靠,可以将该页单独作为图像补充,并说明“以原页为准”。这种局部修复比重新生成整份总结更容易控制,也能减少同一个错误被复制到多个笔记。
对照结果,再决定下一步
05 / 批量处理前,先固定验收规则
当第一篇论文通过抽查,再考虑处理同类文档。给每份文件留下状态:可直接使用、部分页面需人工核对、解析失败。无法提取的内容要有清单,不能在汇总时悄悄消失。
用于文献库时,还应保留论文标识符和文件版本,避免同一篇论文被重复索引。后续AI回答有问题时,你才能分清是原文件、解析结果、检索片段还是解释环节出了偏差。
可以复用的任务指令
先检查【PDF】的文本与结构提取质量,暂不总结全文。选取双栏正文、关键公式和主要结果表各一页,对照原页列出阅读顺序、公式符号、表头单位与脚注是否完整。输出问题位置与处理建议,缺失项明确列出;确认通过后再继续建索引或精读。
当AI读错论文,先回到输入层看一眼。把一页表格拆对,往往比让模型再解释一遍更接近问题本身。
官方资料与进一步阅读
MinerU
https://github.com/opendatalab/MinerU
资料与图片来源核对于2026年10月23日。官方用法、官方原图、本篇实际运行和教学示例均按图注区分;教学材料不代表真实研究结果。
AI工具 / Skill分享与交流
想继续了解科研AI工具与Skill的选择和用法,欢迎加入“大可 ai 工具分享群”。我们会分享公开项目入口与使用方法,也欢迎带着你正在处理的具体问题一起交流。
科研绘图课程咨询与购买
想系统学习科研绘图,或咨询、购买相关课程、PPT素材会员与大可SCI插件,请扫描下方二维码,添加“Dake大可科研绘图”,联系大可了解具体内容与购买方式。
更多科研绘图工具与课程信息,可以访问大可官网:
大可官网
https://www.dakekyht.top