ARTICLE · 1327479
《2.8万亿参数免费下载,我却劝你别下:Kimi K3.1 Pro开源的3个真相》
《2.8万亿参数免费下载,我却劝你别下:Kimi K3.1 Pro开源的3个真相》摘要:月之暗面把自家最强模型 2.8 万亿参数的权重免费公开了。开源榜第一,写代码逼近 Claude Opus 5.5,API 价格只有 GPT-6 Astra 的五分之一。但 1.56TB 的下载包,普通人根本跑不起来——这篇把“谁该下、谁该调 API、谁直接在 App 里用”一次讲清。 每次开源大模型刷屏,我的第一反应都是先问一句:这“免费”到底轮不轮得到我?过去两年我下过好几个开源权重,结局出奇地一致——下载进度条跑半天,显卡先投降,最后默默删掉,只剩一句“下次一定”。11 月 5 日月之暗面把 Kimi K3.1 Pro 的完整权重推上 Hugging Face,我又去验了一遍,这次的结论不太一样:模型是真强,免费也是真免费,只是“免费”和“能用”是两回事。 🌊 01 这次开源,到底给了什么 先说时间线,免得被各种二手消息绕晕。Kimi K3.1 Pro 是 10 月 23 日先在 Kimi 产品和 API 上线的,月之暗面当时就承诺 11 月 4 日前公开权重,11 月 5 日如约兑现。给的是标准版的完整推理权重,Hugging Face 仓库名 moonshotai/Kimi-K3.1-Pro,同步上架魔搭社区。 参数规模是这次最抓眼球的数字:总参数 2.8 万亿,每次推理只激活约 1040 亿,896 个专家里每次挑 16 个干活。上下文 100 万 Token,文本、图像、视频都能当输入。权重用 MXFP4 量化感知训练压到了 1.56TB——不压的话,2.8 万亿参数按 16 位精度存要 5.6TB。 许可证也值得单独说一句:主体是 MIT 风格,个人和中小团队免费使用、修改、微调、商用都没问题,只有两条红线留给大公司——做模型 API 服务且 12 个月收入超 2000 万美元的要另签协议,月活超 1 亿或月收入超 2000 万美元的产品要在界面上标注模型名。换句话说,普通人拿它干活,法律上基本没有门槛。 但有一点要讲清楚:公开的是权重,不是“全部开源”。训练代码和原始训练数据没给,所以它离开源基金会的严格定义还差一截。你拿到的是一个训练好的、可以直接跑的模型,不是一套能从头复现它的配方。这个区别不影响使用,但影响你对它的期待。 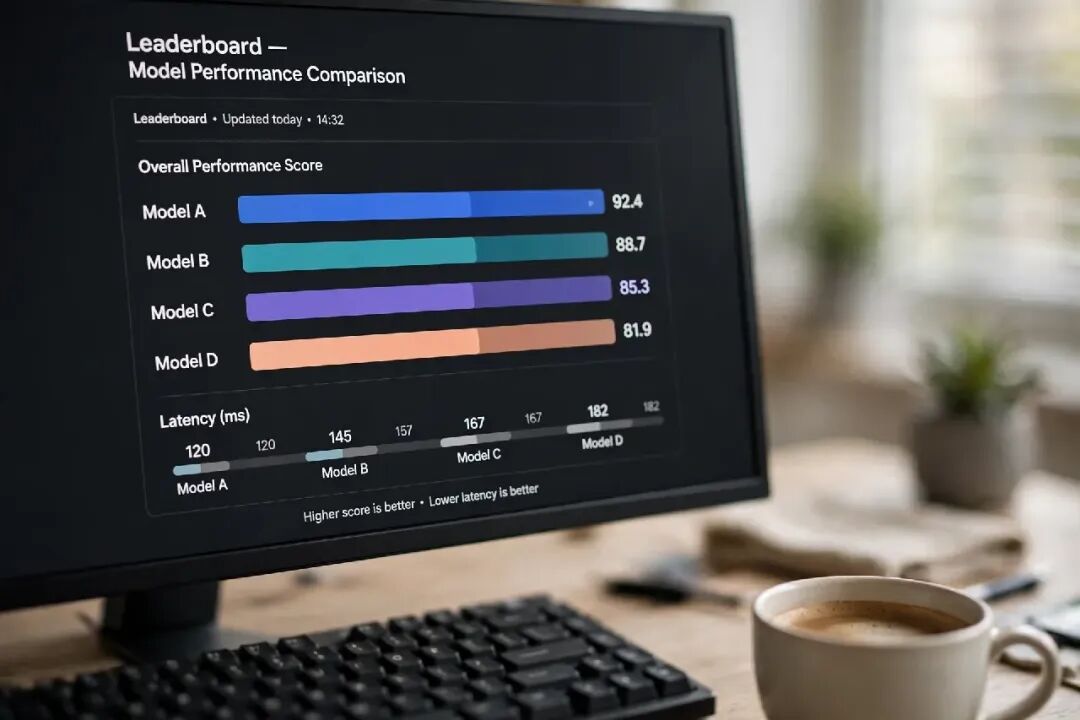
🌊 02 跑分什么水平:离顶级只差一口气 跑分先说结论:这是目前开源模型里最能打的一个,而且强的点正好长在“干活”上,不是只会考试。Agent Arena 的榜单最有说服力,因为它不看选择题,看的是 1.75 万多段全球用户真实提交的长任务对话。Kimi K3.1 Pro(Max)排开源第一、全球第 13,工作、编程、聊天三个分榜全是开源第一。净改进率 +5.1%,上一代 K3 只有 +0.9%;执行 shell 命令的 Bash 可靠性 +7.9%,也是开源第一,K3 当时是 -4.5% 排第 13——这个翻身幅度,说明它在“真的去执行任务”这件事上脱胎换骨了。 写代码的硬指标也对得上。Terminal-Bench 4.0 上它拿了 65.7%,只比 Claude Opus 5.5 的 66.4% 低 0.7 个百分点,把 GPT-6 Astra 的 58.2% 甩在身后。DeepSWE 75.5%,金融研究测试 58.6 分对 GPT-6 Astra 的 45.0 分。国内的 SuperCLUE 11 月榜单,它 61.46 分排国产第一。有一点要老实交代:这些分数大多是官方或合作榜单公布的,实验室自测总有偏向,真正可信的是权重已经公开——任何人都能下载复核,吹牛的成本一下子变高了。 横向比价格,差距更直观。K3.1 Pro 的 API 定价是输入每百万 Token 2 美元、输出 10 美元,人民币口径是输入 13 元、缓存命中 1.3 元、输出 68 元,比上一代 K3 便宜了三分之一,大约是 GPT-6 Astra 的五分之一。还有个高速版,价格翻倍、速度快 2 到 3 倍。
🌊 03 普通人三条路,我替你算过账了 第一条路:在 Kimi App 里直接用,0 元。这是 99% 的人的正确选择。Kimi App、kimi.com、Kimi Work、Kimi Code 里都已经上了 K3.1 Pro,11 月 6 日起原来的 K3 还原地升级成了它,你不用换任何东西,打开就是新版。100 万 Token 上下文意味着你可以直接扔一整份招股书、一整个代码仓库进去让它慢慢啃,长文档总结和跨文件改代码是它最舒服的场景。免费额度用完再说,至少先把手感摸熟。 
第二条路:调 API,适合开发者和重度用户。模型名 kimi-k3.1-pro,兼容 OpenAI 和 Anthropic 两种格式,Claude Code 用户改个地址和 Key 就能直接用——月之暗面自己测编程跑分就是拿 Claude Code 当环境测的。按官方价算,一次中等 Coding Agent 任务大约 26 元,差不多一杯半奶茶。注意两个细节:API 至少要先充 10 元,新用户那 15 元券不能用在这个模型上;另外它只支持思考模式,关掉思考的请求会被直接拒绝,写代码时默认推理强度就是最高的 Max 档。 第三条路:本地部署,劝退 99.9% 的人。1.56TB 的权重文件,官方 vLLM 方案的最低配置是一组 8 卡张量并行:两个 GB300 托盘、一台 8 卡 B300,或一台 8 卡 MI355X。消费级显卡不用想,单台 8 卡 H100 也放不下。华为昇腾和阿里云在权重公开当天就宣布了部署支持,Databricks、Runpod 这些云平台也陆续上架了——这条路是给云厂商和有大算力的大机构准备的,个人用户看个热闹就行。真想私有化部署,云端按量调用比自己买卡便宜得多。 
🌊 04 两个坑,动手之前先知道 第一个坑在 10 月 26 日就爆过一次:K3.1 Pro API 上线才两天,会员额度消耗过快,月之暗面公开致歉,重置额度并按月度总额 25% 补偿。教训很实在——长任务跑起来 Token 烧得比想象快,API 用户最好先设好预算上限,别等账单来了才心疼。 第二个坑是“开源”的边界感。权重免费不等于成本为零:下载 1.56TB 要带宽和硬盘,跑起来要一整柜显卡,微调更贵。以及它对中文长任务的优化确实下了功夫,但多模态和 3D 创作这些亮点,普通用户在 App 里感知不会太强,别冲着“全能”去,冲着“写代码和啃长文档”去才不会失望。 一句话收尾:这不是一个“下载即拥有”的开源故事,而是一个“好模型终于轮到普通人免费用”的故事。下载包留给有算力的人,App 和 API 才是你的入口。 --- 能用、便宜、还开源——国产大模型第一次在“最强”那一档上,把选择权交到了每个人手里。 👍 如果这篇帮你省了下载 1.56TB 的时间,点个在看;觉得 K3.1 Pro 值得一试,点赞告诉我;转发给还在纠结换不换模型的朋友。 「AI大玩家」—— 专注新兴 AI 工具实测与分享,帮你把每一个新工具都先玩明白。