ARTICLE · 1331079
如何分析 Codex 源码
如何分析 Codex 源码
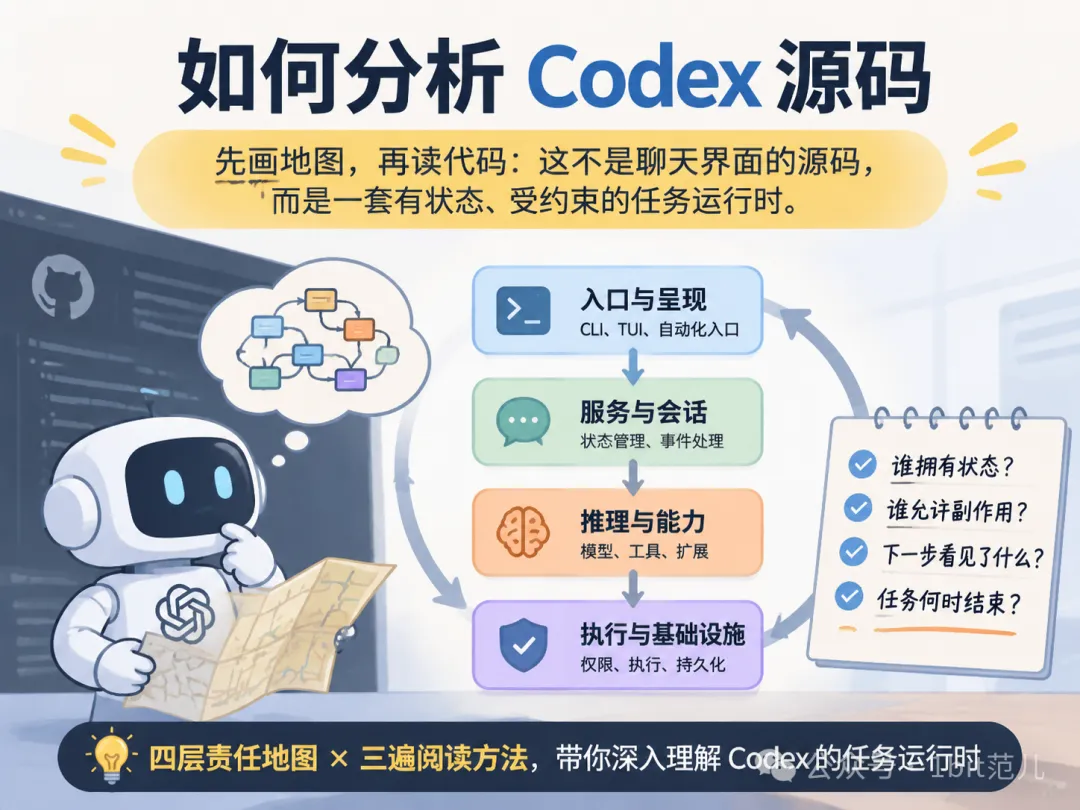
先画地图,再读代码:这不是聊天界面的源码,而是一套有状态、受约束的任务运行时。
打开 Codex 的源码仓库,很容易先被终端界面、模型请求或工具调用吸引。这些部分直观,也容易找到入口。但如果只沿着其中一条线往下读,就很难解释一个完整任务:状态由谁维护,工具执行由谁批准,执行结果如何影响下一步,以及任务如何取消、恢复和结束。
更有效的起点,是先画一张责任地图。把入口、会话、推理和执行放到各自的位置,再沿着一次真实任务验证它们之间的联系。
一、先确定我们正在分析什么
源码分析的第一步,是确定分析对象和版本边界。版本信息很重要,因为教程中的文件名可能已经过时。同一种职责,可能在重构后被拆分到几个模块,也可能被移动到新的目录。文档可以提供线索,实际控制流仍要回到实现中验证。
例如,在这份快照中,可以从以下位置寻找对应职责:
codex-rs/core/src/session/turn.rs:回合相关逻辑。codex-rs/core/src/client.rs:模型客户端相关逻辑。codex-rs/codex-mcp:MCP 连接相关模块。
读这些文件之前,先明确一个判断:聊天界面只是入口,分析的主体是持续推进任务的运行时。 它既要组织模型可见的上下文,也要管理工具执行、权限边界和任务状态。
因此,阅读笔记应同时记录两件事:某个机制解决什么问题,以及当前版本由哪些模块承担这个职责。这样,即使文件位置变化,理解也能保留下来。
二、四个层次,而不是一个大循环
“请求模型,执行工具,再请求模型”可以概括 Agent 的基本闭环,却不足以解释整个工程。为了读清责任边界,可以先把系统分成四层。
这是一张概念地图,不要求每一层恰好对应一个目录。实际阅读时,需要把模块放回地图,再检查它们之间的依赖方向。
例如,界面可以展示审批请求,但工具执行的权限判断属于什么位置?如果换一个入口,审批规则是否仍然有效?类似的问题,能帮助我们判断责任有没有被界面实现绑住。
分包不等于解耦。 Rust workspace 中有很多 crate,只能说明工程做了模块划分。是否真正解耦,还要看终端、自动化和客户端能否复用同一套任务语义,以及审批、工具编排、上下文压缩等机制是否有清楚的归属。
三、一个 Agent 的最小定义
理解复杂系统之前,可以先提取一个最小模型。一个能够推进任务的 Agent,至少要包含五件事:
模型决策:根据当前上下文决定下一步。 工具目录:描述可用能力及其调用方式。 受控执行:检查请求,并在允许的边界内执行动作。 观测回灌:把执行结果交回模型,形成下一步判断的依据。 终止条件:决定继续推进,还是结束当前任务。
可以把这个闭环写成:
上下文 → 模型决策 → 工具请求 → 检查与执行 → 结果回灌 ↑ │ └──────── 继续推进 ──────────────┘ 或结束当前任务其中最容易被忽略的边界,是“模型提出动作”与“动作已经执行”之间的距离。
模型输出了工具调用,并不意味着命令已经运行。协议解析可能失败,工具路由可能找不到对应能力,审批可能拒绝请求,执行器也可能因约束或环境问题无法完成动作。
因此,分析时要分别追踪请求、执行和结果。只看模型输出,很容易把意图当成事实;只看执行器,又会遗漏模型如何获得结果、如何据此调整后续行动。
在这个最小闭环之上,Codex 还需要处理多会话、流式事件、取消、恢复、上下文压缩和平台差异。先掌握闭环,再看这些机制如何改变状态和控制流,会更容易理解它们存在的原因。
四、推荐分三遍阅读源码
第一遍:建立入口、状态、上下文和循环的地图
第一遍的目标,是能够描述任务经过哪些责任边界。
从入口出发,找到请求如何进入会话,谁维护任务状态,模型请求如何组装,以及一次回合如何继续或结束。阅读到较大的模块时,先标记职责、输入和输出,再进入关键分支。
这一遍结束后,应当能够用自己的话说明:用户提出任务之后,哪些模块接手了它,模型又是在什么条件下被调用的。
第二遍:沿着一次改代码任务追踪完整过程
第二遍选择一个具体场景,例如“修改一个函数并运行相关测试”,沿着同一项任务追踪工具、安全、执行、恢复和压缩。
重点记录状态如何变化:模型产生了什么请求,运行时怎样检查,执行产生了什么结果,这些结果如何进入后续上下文。如果执行失败、用户取消或任务需要恢复,又会走向哪些分支?
这种读法能够把分散的模块连接起来,也能暴露看似简单的工具调用背后有哪些工程约束。
第三遍:通过扩展和故障验证理解
第三遍进入扩展点和练习,主动制造可控的失败。例如,让工具返回错误、触发一次审批拒绝,或中断任务后观察恢复行为。
这些练习的目的,是检查自己的控制流地图是否足够完整:失败由谁接住,事件由谁发出,下一轮模型看见什么,任务是否仍然能够推进。
每一遍都可以采用同样的顺序:先问为什么,再读关键片段,最后回到完整文件核对上下文。 阅读结束后,尝试脱离文件名复述控制流。能够解释因果关系,比记住入口函数的位置更有价值。
五、设计亮点与工程代价
这套设计值得关注的地方,是统一核心:终端、自动化和客户端能够共享同一套任务语义。会话状态、工具策略和执行约束因此可以跨入口复用。
相应的工程代价也很具体。模块与配置组合增多后,一个局部改动可能同时影响协议、事件映射、界面和测试。维护者需要判断它改变了哪个边界,以及其他入口是否仍然正确理解这些变化。
对于小型 Agent 项目,最值得借鉴的是责任划分:把模型决策、状态管理、工具策略、执行和存储的归属想清楚。是否需要同样数量的模块,则应由实际复杂度决定。
可以用一道题检验自己的理解:
如果把终端界面换成 Web 界面,核心逻辑、工具策略和存储是否仍然成立?哪些部分需要适配,哪些机制应当继续复用?
如果能够清楚回答,就说明你开始理解系统的边界,而不只是看懂了一次模型调用。
阅读过程中,可以一直在笔记旁保留四个问题:
谁拥有状态? 谁允许副作用? 下一步看见了什么? 任务何时结束?
每进入一个新模块,都尝试把它放到这四个问题中。带着这张地图深入代码,文件之间的关系才会逐渐变成一条可以解释、可以验证的任务执行路径。