ARTICLE · 1334745
同样是 PDF,凭什么命运完全不同?一文讲透普通版与扫描件两条链路
同样是 PDF,凭什么命运完全不同?一文讲透普通版与扫描件两条链路
适合谁:做企业知识库、RAG、智能问答的产品与研发
你将搞懂:PDF 为什么要分流,普通版和扫描件分别怎么被 AI 读懂
开场:先做个小实验
你在公司系统里,同时上传两份 PDF。
第一份,Word 导出的。鼠标轻轻一拖,文字能直接复制。
第二份,扫描仪扫出来的。人眼看得清清楚楚,可一复制 ——
要么是空的,要么是一堆乱序字符。
如果系统用同一套办法处理它们,结果可想而知:
第一份好好的,第二份要么失败,要么把表格、双栏切得乱七八糟。
所以处理 PDF 的第一件事,不是急着切分。
而是先分清它是文字版还是扫描件,再让它们各走各的路。
这篇文章,就带你走一遍这两条 "闯关链路"。
第一站:先认人,你手里的是哪类 PDF
先记住两个基础概念。
文字层
PDF 内部真正存着的字,能复制、能检索。
Word 导出的 PDF,通常都有完整文字层。
扫描件
每一页本质上是一张图片,字是 "画" 在图上的,没有可直接复制的文字层。
注意一个迷惑项:有些扫描仪会自动做一次识别,塞进一层质量很差的文字。看起来有字,其实行列错乱、双栏穿插,反而更容易骗过系统。
顺着再认识两个词:
OCR (光学字符识别):把图里的字认成文本; 表格结构识别:不光认字,还要把表格的行和列也还原出来。 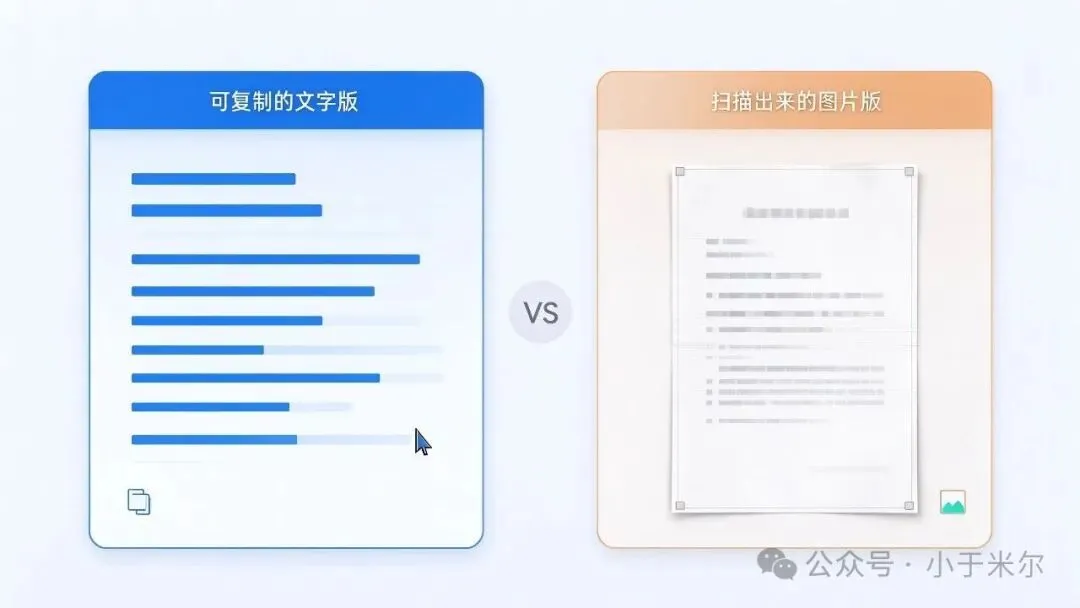
第二站:先看全景,一张分流路线图
整个 PDF 处理,遵循 "分流" 设计。
上传 PDF│Java 快判(不加载模型)│┌──────────────┼───────────────┐│ │ │确认是文字版 打不开/加密/0页 拿不准│ │ │直接走普通入库 明确失败(PARSE) 进独立识别服务│ ││ 版面分析 + OCR│ 表格结构识别│ ││ 成功输出 Markdown│ 没把握整份拒绝│ │└──────────────┬───────────────┘▼同一套切分 → 向量化 → 入库
两个关键设计,先记住:
能用文字层,就不调用识别模型—— 又快又省,识别服务停了也不影响普通 PDF; 识别没把握,整份不入库—— 宁可明确失败,也不让错误内容污染知识库。
下面分别走这两条路。
路线 A:普通 PDF 的四级闯关
有文字层的 PDF,系统不是简单 "把字读出来"。
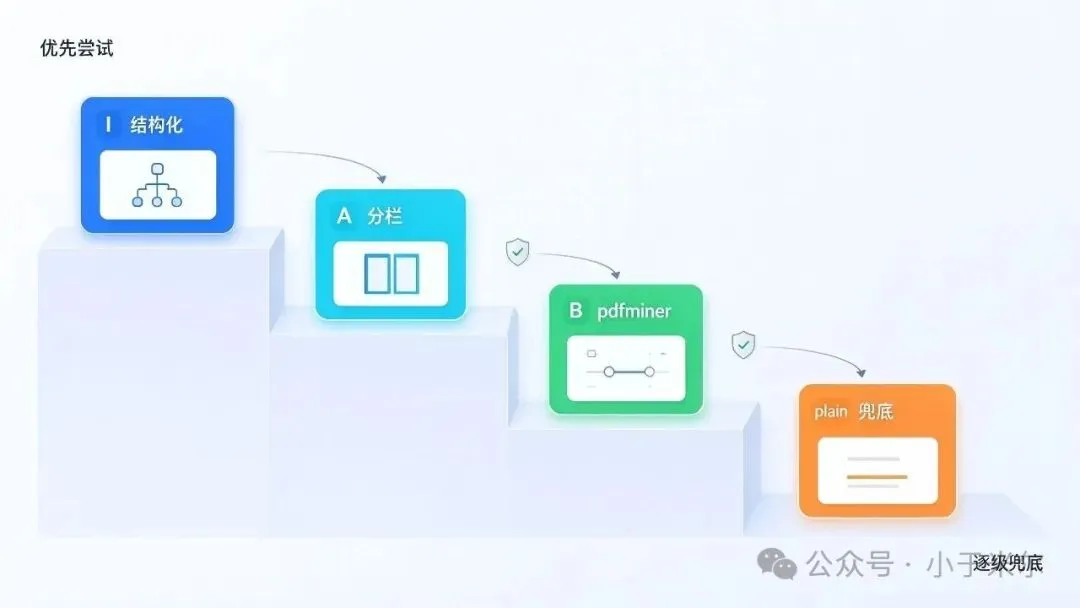
它按I → A → B → 兜底四级级联抽字:第一档合格就停,不合格才往下走。
先看全景表:
I 档:优先保留结构
有些 PDF 内部自带一棵结构树(Catalog 里的 StructTreeRoot,结构树根)。
它标注了 "这里是一级标题、那里是表格"。这类文件叫Tagged PDF (带标签的结构化 PDF)。
系统借助PyMuPDF把页面转成XHTML (可扩展超文本标记语言),然后做两件事:
标题(h1~h6)转成 Markdown 的 #标题;表格转成行首行尾带竖线 |的 Markdown 表。
这一步同样保守,几条规则先看清:
标题里带句号、问号的,按正文处理; 标题超过 80 字,不转; 同一标题出现 3 次以上,判定为重复页眉; 一份文件标题超过 200 个,认为结构树不可靠,退回纯文字; 表格要求列数 ≤ 12、行数 ≤ 100、行列对齐,否则保持纯文字。
A 档:坐标分栏,专治双栏
没有可靠结构树,就按每个文字块的bbox (包围盒,即文字在页面上的位置坐标)聚类。
自动识别页面中间的 "竖缝",判断是不是双栏; 双栏严格按先左栏从上到下、再右栏从上到下排顺序; 通栏标题、通栏表格保持整块,不被竖缝切成两半; 页眉、页脚(页面上下各约 6% 的区域)先摘掉。
B 档:pdfminer 多组参数调优
用pdfminer配合多组LAParams (版面分析参数)尝试抽取。
其中有专门参数控制对几何分栏的尊重程度,取第一组通过质量门的结果。
兜底:plain 纯内容流抽取
最后用底层基于pypdf的读取器,按 PDF 内容流把字抽出来,保证不轻易放弃。
贯穿全程的 "质量门"
每一档抽完,系统都会打分,而不是 "有字就用"。
评分主要看三件事:
长度够不够(太短可能是结构残缺); 条款序号是否大体递增; 极短行(不超过 12 字)占比是否过高。
为什么要盯条款序号?双栏被左右穿插时,典型坏顺序是 "第 1 条、第 8 条、第 2 条、第 9 条"。这种顺序切分救不回来,必须在抽字阶段拦下。
某一档没过质量门,就交给下一档。
各档都不理想时,挑分数最高的一份,避免 "明明能抽出字、却整份失败"。
只有所有档位都抽不出字,才会报错 —— 这通常意味着,它其实是扫描件。
路线 B:扫描件交给独立识别服务
扫描件没有可用文字层,前面的级联对它无能为力。
但我们没有把识别逻辑硬塞进入库程序,而是单独建了一个识别服务。
第一步:Java 快判,不加载模型
上传时,Java 侧用 PDFBox 做一次轻量判断。
每一页都要同时满足下面三条,才认定为文字版、直接入库:
任何一页不满足、或者系统拿不准,就送去识别服务,而不是冒险当文字版。
第二步:识别服务读懂版面
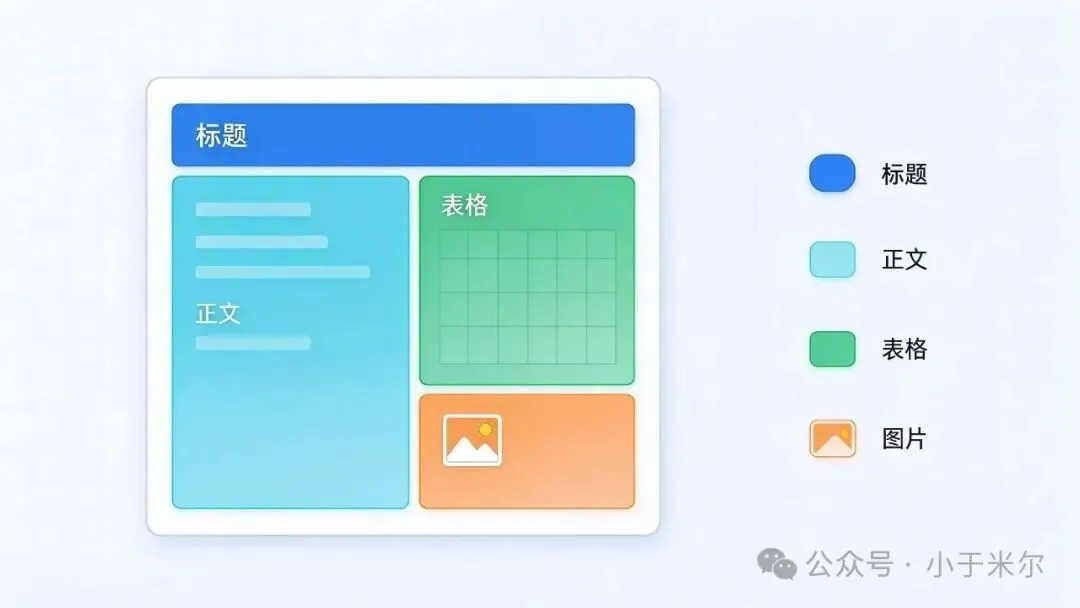
先做版面分析(Layout Analysis),把一页划成这些区域:
标题、正文、表格、图片、页眉页脚、印章。
然后:
对正文区域做 OCR,把图里的字认成文本; 对表格做表格结构识别,还原行列; 交出一份规范的 Markdown 文件,而不是散乱纯文本。
引擎怎么选?
倾向 MinerU 的解析档:它本身就是为 "PDF 转 Markdown" 设计的,双栏和跨页表格通常更完整; 前期技术验证(探针)不过线,再换 PP-Structure(飞桨的版面、表格、文字一体流水线)。
模型全部部署在内网,制度原文不出内网,也不使用云端接口。
第三步:多层置信度门槛,没把握就拒绝
识别结果不是 "认出来就收",而是有多层置信度(Confidence,模型对 "认对了" 的把握,0 到 1)门槛。
数字为什么要求更高?因为金额、天数认错一位,制度结论就错了。
同时有明确上限,超出就整份拒绝:
页数不超过 200; 全文档表格数据行不超过 2000; 单行超宽表归一后仍超过约 400 字。
还有几个细节:
页眉、页脚、页码、印章、空白页,不参与置信度; 图片、流程图只保留图题并贴到相邻正文; 不会把流程图里的箭头步骤,误认成制度条款
只要有一处关键内容没把握,就整份拒绝。不做 "只给管理员看、员工搜不到" 的半成品。
第三站:为什么识别服务要独立出来
你可能会问:为什么不把 OCR 直接写进现有入库程序?
三个原因。
1. 职责解耦
入库程序负责切分、向量化、写Milvus (向量数据库)。
识别服务只负责 "读懂页面"。
两者通过一份 Markdown 衔接,各自可独立升级、独立测试。
2. 长任务不拖垮消息队列
一份厚扫描件,可能要跑几十分钟。
如果让它一直占着一条消息不确认,消息队列会误以为进程死了,重复投递,导致两个进程同时识别同一份文件。
独立服务的做法是:消息只负责叫醒,任务状态落在自己的表里。
靠心跳和租约(Lease,认领任务后的执行权),保证挂了能被别的进程接管重跑。
3. 故障可隔离、可降级
识别服务停了,普通 PDF、Word、Excel 照常入库。
整体故障时,还能切到bypass (旁路降级)模式走旧链路,不会让整个知识库停摆。
终点:两条路最终汇合
无论走哪条路,终点是一致的。
普通 PDF,由级联抽出规范文本; 扫描件,由识别服务产出规范 Markdown; 之后都进入同一套流程:
切分(每段不超过约 480 字)→ Embedding (向量化) → 写入 Milvus
还有一个值得一提的细节:
管理员下载到的,始终是当时上传的那份原始 PDF。用于检索的,是另一份派生出来的文本。
原件和派生文件分开存储,既保证溯源,又让检索内容干净可控。
写在最后:三句话记住全链路
1. 先分流PDF 先分文字版和扫描件。前者走 I→A→B→兜底级联,质量门防双栏穿插;后者走独立识别,版面分析 + OCR + 表格识别,输出 Markdown。2. 全程保守能走文字层就不调模型,数字置信度要求更高,没把握整份拒绝、不做半成品。3. 最终汇合两条路进入同一套切分、向量化、入库流程。原件供下载,派生文本供检索,故障可隔离、可降级、可灰度。
理解了这套 "分流 + 级联 + 独立识别" 的设计,你就掌握了企业知识库里最棘手的 PDF 处理全链路。
看不懂别憋着,评论区摆开擂台畅聊,文明交锋,输了不许偷偷记仇~