ARTICLE · 1342492
9.3 万 star 的文档引擎:RAG 的成败在切分那一步
9.3 万 star 的文档引擎:RAG 的成败在切分那一步
infiniflow/ragflow · 数据与知识 · 框架或库 · ★ 92,607(数字在变) · Go · Apache-2.0RAG 效果不好,八成不是模型的问题
我调过几套 RAG。最常见的情况是:检索明明召回了几段相关文档,模型答得还是不对。
后来我把精力从「换个更强的模型」转到「看看文档是怎么被切开的」,问题少了一大半。
切分这一步,决定了模型能不能看到完整的语义。切碎了,句子没了上下文;切大了,噪声灌进来。
RAGFlow 把这一层做得很重。
它的四个功能模块
README 的功能列表里,四个词是核心:
1. Template-based chunking,模板化切分
不是所有文档都按同一刀切。论文、合同、表格、说明书,切法完全不一样。
它按文档类型给不同的切分模板,让切出来的每一块保留该类型的结构。
2. Knowledge Compilation,知识编译
把解析出来的内容先整理成结构化知识,再拿去检索。
这一层的作用是把「一堆文本」变成「有结构的知识」,检索的时候才能按字段命中,而不是靠语义相似度撞。
3. Agentic Retrieval,agent 驱动的检索
检索不再是固定流程里的一步,而是让 agent 决定搜几轮、往哪个方向搜。
RAGFlow 自己的定位是「RAG 引擎加上 agent 能力,给 LLM 做一个更好的上下文层」。
4. Grounded citations,带引用的回答
每段回答都挂上来源。这条现在几乎是硬要求了,没有出处的答案没法用。
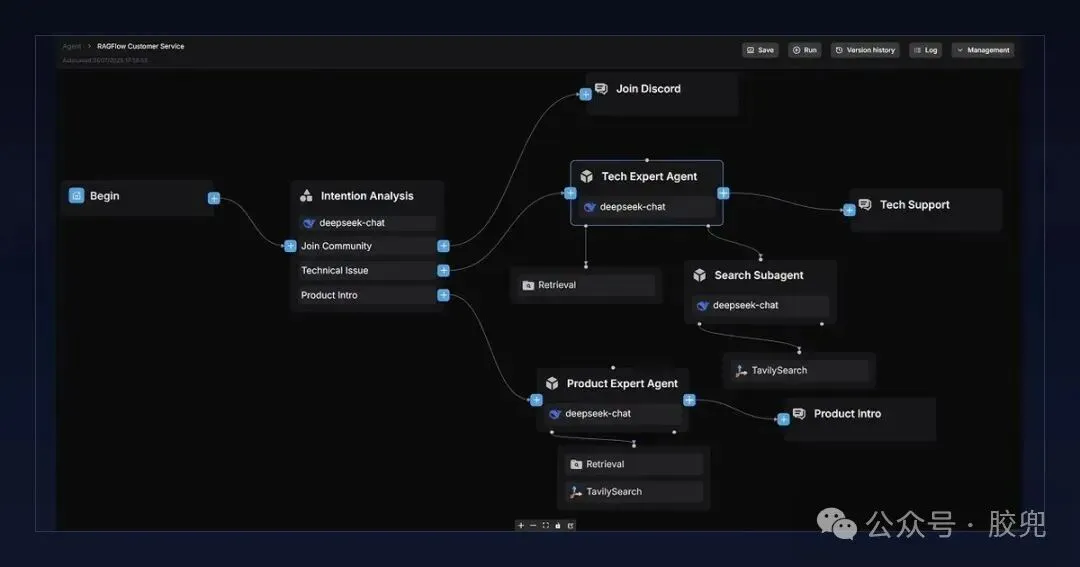
图:RAGFlow 的文档处理流程 来源:https://github.com/infiniflow/ragflow
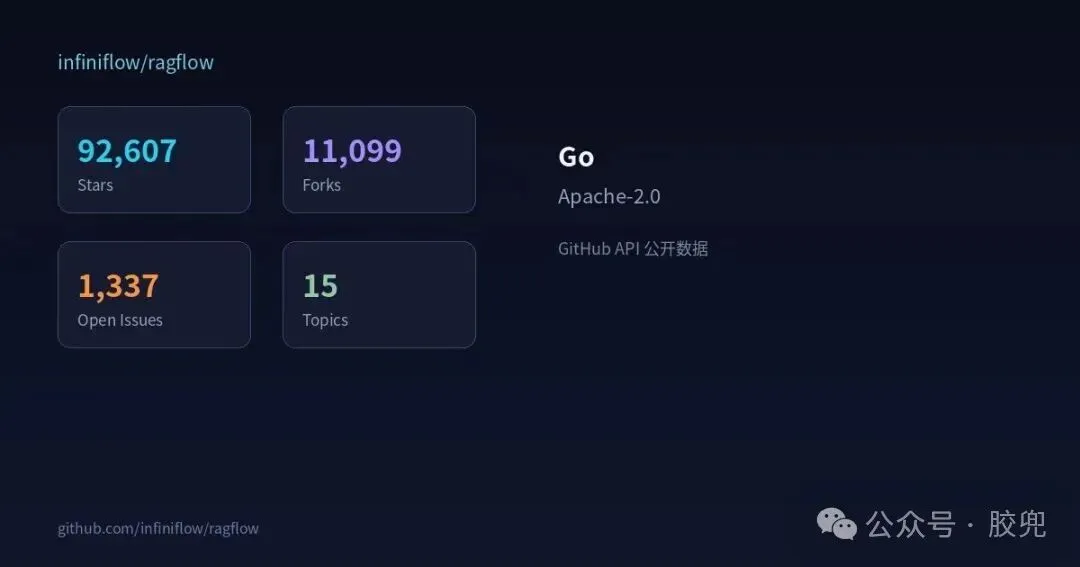
图:infiniflow/ragflow 的公开数据 来源:https://github.com/infiniflow/ragflow
值得看的地方
口号写在 README 标题里
进来什么质量,出去什么质量。这句话听着像套话,但它正好点出了 RAG 的本质:垃圾进垃圾出,模型再好也救不回来。
后端是 Go,不是 Python
一个做文档处理的工具,后端用 Go 写的。解析、索引这些 IO 密集的活儿,Go 的并发模型很合适。
这也解释了它 1.1 万 fork、9.3 万 star 的比例里,为什么 fork 相对少:真要自己改代码的人没那么多。
部署方式就一条 docker compose
bash
git clone https://github.com/infiniflow/ragflow.git docker compose -f docker-compose.yml up -d带解析、索引、模型这些依赖,docker compose 是省事的选择。
谁该看
几个数
GitHub topics:agent-harnessagentic-aiagentic-nagiveagentic-retrievalagentic-searchai
— — —
仓库:https://github.com/infiniflow/ragflow