ARTICLE · 1349726
【python实战案例】几十万行订单Excel打开就卡死,一个Python脚本出分析报告
这几天运营在群里喊:上个月的销售分析什么时候给?我打开她发来的文件,一个八十多兆的 CSV,三十多万行订单。双击用 Excel 打开,转了半分钟,弹窗说内存不足。
我换了个思路,想装 pandas 写两行。结果内网 pip 源不通,翻了半天镜像,装完还要现学 DataFrame 的语法。为了算三个数,先花一小时配环境,这账不划算。
最后我写了个一百来行的脚本,只用了 Python 自带的 csv 和 datetime 两个模块。它先把数据体检一遍,再按月汇总、算环比、排商品榜,输出一份 Markdown 报告,直接贴进周报。
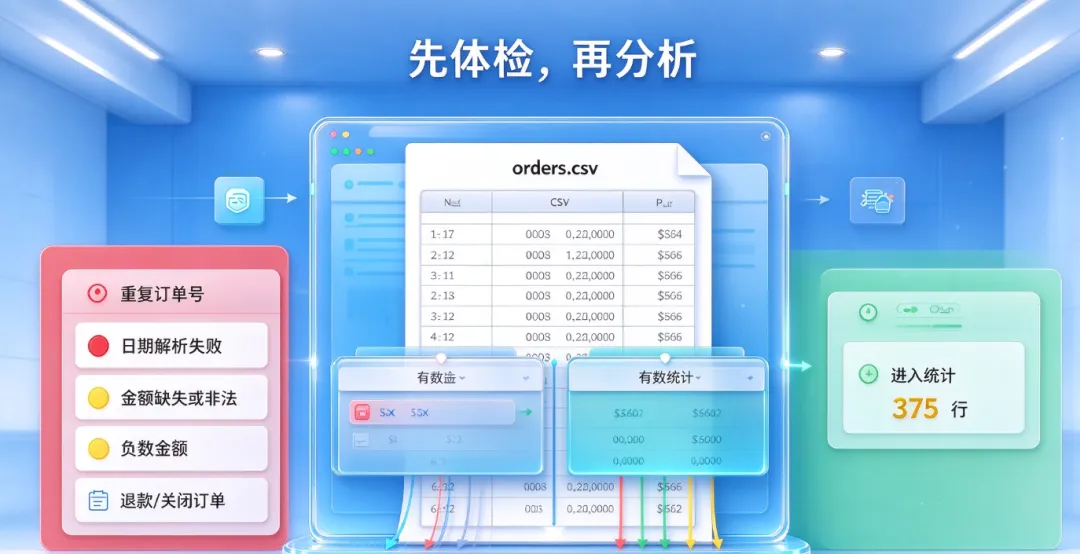
我先拿一份 404 行的测试数据跑了一遍,输出长这样:
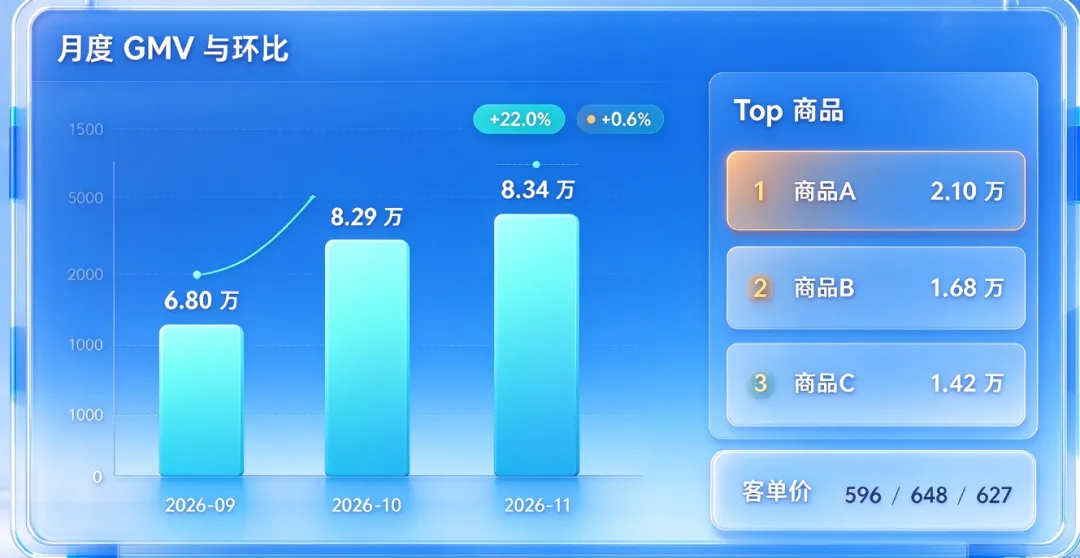
## 一、数据体检- 总行数:404- 重复订单号:1 行(已剔除)- 日期解析失败:1 行- 金额缺失或非法:1 行- 负数金额:1 行- 退款/关闭订单:25 行(已剔除)- 进入统计:375 行## 二、月度 GMV 与环比| 月份 | GMV | 订单数 | 客单价 | 环比 || --- | --- | --- | --- | --- || 2026-09 | 6.80 万 | 114 | 596.21 | — || 2026-10 | 8.29 万 | 128 | 647.85 | +22.0% || 2026-11 | 8.34 万 | 133 | 626.98 | +0.6% |## 四、单笔金额分布- 最大单笔:1298.94 最小单笔:40.35- P50:578.71 P90:1155.95这四百行是我造的样本,里面故意塞了四种脏数据:不存在的日期、空金额、负数、重复单号。脚本把 29 行问题数据全挑了出来,没有一行混进最终统计。
完整脚本
还是老规矩:默认预览,只在屏幕上打印,不写任何文件;确认输出没问题再加 --apply 出报告和日志。先看清楚,再动手。
#!/usr/bin/env python3# -*- coding: utf-8 -*-"""order_report.py — 订单 CSV 体检 + 月度经营分析报告(纯标准库,不装 pandas)用法: python3 order_report.py orders.csv # 预览,只打印 python3 order_report.py orders.csv --apply # 写报告 + 日志 python3 order_report.py orders.csv --top 10 --apply --out-dir ./reports列名可用参数改:--date-col --amount-col --item-col --id-col --status-col"""import argparseimport csvimport datetimeimport osimport sysfrom collections import defaultdictDATE_FMTS = ("%Y-%m-%d %H:%M:%S", "%Y-%m-%d", "%Y/%m/%d %H:%M:%S","%Y/%m/%d", "%Y-%m-%dT%H:%M:%S")REFUND_WORDS = ("退款", "已退款", "退货", "refund", "refunded", "closed", "取消")REPORT_NAME = "order_report.md"FALLBACK_DIR = "./order_logs"defparse_date(text):"""兼容几种常见导出格式,解析不了返回 None。""" text = (text or"").strip()ifnot text:returnNonefor fmt in DATE_FMTS:try:return datetime.datetime.strptime(text, fmt)except ValueError:continuereturnNonedefparse_amount(text):"""去掉千分位逗号、货币符号和空格后再转数字,失败返回 None。""" text = (text or"").strip().replace(",", "").replace("¥", "").replace("¥", "").replace(" ", "")ifnot text:returnNonetry:return float(text)except ValueError:returnNonedefpercentile(values, p):"""手算分位数:排序后按位置线性插值,不依赖 numpy。"""ifnot values:return0.0 data = sorted(values) pos = (len(data) - 1) * p low = int(pos) high = min(low + 1, len(data) - 1)return data[low] + (data[high] - data[low]) * (pos - low)defhuman(num):if abs(num) >= 10000:return"%.2f 万" % (num / 10000.0)return"%.2f" % numdefcollect(path, args):"""读 CSV 并做体检,返回 (统计信息, 有效记录)。""" stats = {"rows": 0, "dup": 0, "bad_date": 0, "bad_amount": 0,"negative": 0, "refund": 0, "valid": 0} records = [] seen_ids = set()with open(path, "r", encoding="utf-8-sig", newline="") as f: reader = csv.DictReader(f) missing = [c for c in (args.id_col, args.date_col, args.amount_col, args.item_col)if c and c notin (reader.fieldnames or [])]if missing:returnNone, missingfor row in reader: stats["rows"] += 1 oid = (row.get(args.id_col) or"").strip()if oid:if oid in seen_ids: stats["dup"] += 1continue seen_ids.add(oid) when = parse_date(row.get(args.date_col))if when isNone: stats["bad_date"] += 1continue amount = parse_amount(row.get(args.amount_col))if amount isNone: stats["bad_amount"] += 1continueif amount < 0: stats["negative"] += 1continue status = (row.get(args.status_col) or"").strip().lower()if any(w in status for w in REFUND_WORDS): stats["refund"] += 1continue records.append({"when": when, "amount": amount,"item": (row.get(args.item_col) or"").strip() or"(未填)"}) stats["valid"] += 1return stats, recordsdefbuild_report(stats, records, args): months = defaultdict(lambda: {"gmv": 0.0, "orders": 0}) items = defaultdict(lambda: {"gmv": 0.0, "qty": 0})for r in records: key = r["when"].strftime("%Y-%m") months[key]["gmv"] += r["amount"] months[key]["orders"] += 1 items[r["item"]]["gmv"] += r["amount"] items[r["item"]]["qty"] += 1 lines = ["# 订单数据体检与月度分析", ""] lines.append("## 一、数据体检") lines.append("") lines.append("- 总行数:%d" % stats["rows"]) lines.append("- 重复订单号:%d 行(已剔除)" % stats["dup"]) lines.append("- 日期解析失败:%d 行" % stats["bad_date"]) lines.append("- 金额缺失或非法:%d 行" % stats["bad_amount"]) lines.append("- 负数金额:%d 行" % stats["negative"]) lines.append("- 退款/关闭订单:%d 行(已剔除)" % stats["refund"]) lines.append("- **进入统计:%d 行**" % stats["valid"]) lines.append("") lines.append("## 二、月度 GMV 与环比") lines.append("") lines.append("| 月份 | GMV | 订单数 | 客单价 | 环比 |") lines.append("| --- | --- | --- | --- | --- |") prev = Nonefor key in sorted(months): m = months[key] avg = m["gmv"] / m["orders"] if m["orders"] else0if prev isNone: mom = "—"elif prev == 0: mom = "上期为 0"else: mom = "%+.1f%%" % ((m["gmv"] - prev) / prev * 100) lines.append("| %s | %s | %d | %s | %s |" % (key, human(m["gmv"]), m["orders"], human(avg), mom)) prev = m["gmv"] lines.append("") top = sorted(items.items(), key=lambda kv: kv[1]["gmv"], reverse=True)[:args.top] lines.append("## 三、Top %d 商品" % args.top) lines.append("") lines.append("| 排名 | 商品 | 销售额 | 销量 |") lines.append("| --- | --- | --- | --- |")for i, (name, v) in enumerate(top, 1): lines.append("| %d | %s | %s | %d |" % (i, name, human(v["gmv"]), v["qty"])) lines.append("") amounts = [r["amount"] for r in records] lines.append("## 四、单笔金额分布") lines.append("")if amounts: lines.append("- 最大单笔:%s 最小单笔:%s" % (human(max(amounts)), human(min(amounts)))) lines.append("- P50:%s P90:%s" % (human(percentile(amounts, 0.5)), human(percentile(amounts, 0.9))))else: lines.append("- 没有可统计的有效记录")return"\n".join(lines)defpick_dir(want):for d in (want, FALLBACK_DIR):try: os.makedirs(d, exist_ok=True) probe = os.path.join(d, ".probe") open(probe, "w").close() os.remove(probe)return dexcept OSError:continuereturnNonedefmain(): ap = argparse.ArgumentParser(description="订单 CSV 体检与月度分析") ap.add_argument("csvfile", help="订单 CSV 路径") ap.add_argument("--id-col", default="order_id") ap.add_argument("--date-col", default="create_time") ap.add_argument("--amount-col", default="amount") ap.add_argument("--item-col", default="item") ap.add_argument("--status-col", default="status") ap.add_argument("--top", type=int, default=10) ap.add_argument("--apply", action="store_true", help="写报告和日志;默认只预览") ap.add_argument("--out-dir", default=".") args = ap.parse_args()ifnot os.path.isfile(args.csvfile): print("[exit 2] 文件不存在:%s" % args.csvfile)return2try: stats, records = collect(args.csvfile, args)except UnicodeDecodeError: print("[exit 5] 编码不是 UTF-8,先用 iconv 转一下再跑")return5if stats isNone: print("[exit 4] CSV 缺少必要列:%s" % "、".join(records))return4if stats["rows"] == 0: print("[exit 3] 文件里没有数据行:%s" % args.csvfile)return3 report = build_report(stats, records, args) print(report)ifnot args.apply: print("\n[预览模式] 没写任何文件。加 --apply 出报告和日志。")return0 out_dir = pick_dir(args.out_dir)if out_dir isNone: print("[exit 6] 输出目录不可写")return6 stamp = datetime.datetime.now().strftime("%Y%m%d_%H%M%S") rp = os.path.join(out_dir, REPORT_NAME) lp = os.path.join(out_dir, "order_report_%s.log" % stamp)with open(rp, "w", encoding="utf-8") as f: f.write(report + "\n")with open(lp, "w", encoding="utf-8") as f: f.write("[%s] file=%s rows=%d valid=%d top=%d\n" % (stamp, args.csvfile, stats["rows"], stats["valid"], args.top))for k, v in stats.items(): f.write("%s=%s\n" % (k, v)) print("\n[已执行] 报告:%s" % rp) print("[已执行] 日志:%s" % lp)return0if __name__ == "__main__": sys.exit(main())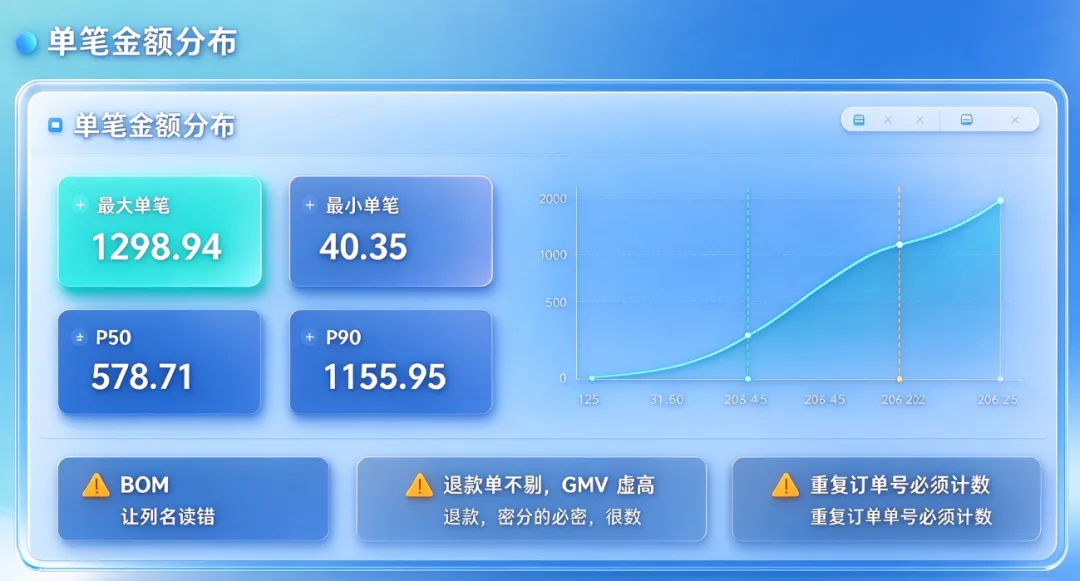
五步看懂它在干什么
**第一步,读文件用 utf-8-sig。**Excel 另存出来的 CSV 开头带一个看不见的 BOM 标记,用普通 utf-8 读,第一列列名会变成带乱码的 order_id,后面按列名取值全部落空。加 -sig 就是专门吃这个坑的。
**顺带说一句内存。**脚本用 DictReader 一行一行流式读,内存里只留统计要用的字段,八十兆的文件也不会把机器撑爆,这也是我没去折腾 pandas 的原因之一。
**第二步,体检比分析更重要。**脚本先看四种问题:订单号重复、日期解析不了、金额是空或非数字、金额为负。每种都计数并剔除,最后给出一个「进入统计多少行」。这一步决定后面的数字能不能信。
**第三步,金额先洗再算。**CSV 里的金额常带千分位逗号和货币符号,比如 1,298.94 或者 ¥299,直接 float() 立刻报错。脚本先去掉逗号、¥ 和空格再转数字,转不了的计入金额非法。
**第四步,按月分组算三个数。**用字典按 2026-09 这种键累加金额,同时数订单数,客单价就是当月 GMV 除以订单数。退款和关闭的订单在这一步之前就剔掉了,不然 GMV 会虚高。
**第五步,环比和分位别用平均值骗自己。**环比是本月减上月再除以上月,上月为 0 时单独标注;分位数用排序加线性插值手算,P90 告诉你最贵那一成订单大概多少钱,比平均数有用。
怎么用
1. 导出 CSV。**从后台把订单导出来,字段至少要有订单号、下单时间、金额、商品名,带上状态列更好。
2. 先跑预览。**python3 order_report.py orders.csv,先看清「进入统计」的行数对不对,再看榜。
3. 列名不一致就改参数。**后台导出的列名五花八门,用 --date-col、--amount-col、--item-col 指定一下,不用改代码。
4. 确认无误再落盘。**加 --apply --out-dir ./reports,生成 order_report.md 和一份带时间戳的日志,报告直接贴进周报。
5. 固定到每月一号。**挂个 crontab,每月 1 号早上自动把上个月报告生成好,上班第一件事就是看它。
三个坑,都是我踩过的
**坑一,BOM 让整张表读不出来。**第一次跑就卡在这,报错说找不到 order_id 列,可我明明看得见。用十六进制看文件头,才发现前面藏了三个字节。
**坑二,退款单不剔,数字全废。**我第一次算 GMV 忘了看状态列,算出来比实际高了两成,差点在周会上说错话。
**坑三,同一订单号重复导出。**后台分页导出时中途改过筛选条件,很容易出现重复行。脚本按订单号去重,先到先留,重复的单独计数,不静默吞掉,这样你能知道数据源有问题。
如果你只带走一句话
先体检,再做分析。脏数据不洗干净,越分析越离谱,而且错得特别有说服力——报告排版漂亮,数字全错,这种最要命。
你平时分析订单数据用什么?Excel、pandas 还是 BI 工具?想让脚本加个同比或者按品类汇总,评论区说一声,我下期加上。