ARTICLE · 1395529
PDF听书播放器电脑版V1.19(明月听书)
通过网盘分享的文件:PDF听书播放器电脑版V1.19.exe
链接: https://pan.baidu.com/s/1TiZQKutCMj7yCepcFgTdoA?pwd=1919 提取码: 1919
--来自百度网盘超级会员v3的分享
明月听书 · 电脑版使用说明
版本 V1.19(Windows 10 / 11,免安装)
==================================================
一、这是什么
--------------------------------------------------
把 PDF、TXT、Word 里的内容读给你听。
· 正常 PDF:直接读里面的文字,很快。
· 扫描版 / 图片版 PDF:本机自动识别文字(OCR)后再朗读,
不用联网,不用上传文件。
· 朗读音色有 8 个在线音色,加 1 个本地模型(断网也能用)。
· 图标是红底白字,写着 PDF / TO MP3 / 明月。
· V1.15 拿 D 盘 41 本真实电子书做过逐页基准测试:
识别得差的页自动摆原图、有文字层的页不再跑 OCR、
页眉水印和双栏串句都修了,整体识别约快 2 倍。
· V1.16 新增「以目录为界」:程序自动找到书里的「目录」页,
目录页和它之前的封面 / 彩页 / 扉页 / 前言一律不识别、不朗读,
只摆原页图片供翻看;只从目录后面那一页开始识别播放。
· V1.17 把「一页目录」改成「整段目录」:很多书只有第一页印着
「目录」两个字,后面好几页全是条目。现在会把整段目录量全,
用 D 盘真书校准后,倪海厦系列 7~14 页目录一次跳干净。
· V1.18 专治「目录又长、又排在封面前言后面」的扫描书:先用
版式把整段目录圈出来,再认「目录」和「第1章」双重确认;
目录实在认不出时,改按「第一章 / 绪论」这类提示定位。
左上角「明月听书」后面也标上了版本号,方便对照。
· V1.19 修掉「老书还从目录中间开始读」:早期版本记下的起点
没有记来源,被一直沿用,等于新目录规则永远没机会跑。
现在这类老进度一律重新按「目录 + 第一章」定位;带
「第X章」的书会精确从第一章那一页开始读。版本号只放在
窗口标题栏 / 任务栏的「明月听书」后面,页面里不显示。
· V1.19 再补两处(《针道·极简针灸视域下的生命秘密》暴露的):
第一,**第 1 页一律按原图摆放、一个字不识别**,封面艺术字
再也不会被念成「有象必有应 有病必有象」这种碎片;
第二,序言中间夹一页落款 / 插图时,不再把整段序言误判成
「封面 / 目录」而跳过。
· V1.19 再补一条(《刘政宪 金口诀八字上》暴露的):有一类书
**根本没有封面**,第 1 页第一行就印着「第一章 第一节」。
以前第 1 页一律当封面摆原图,起点又跳到后面某个「第X章」
(这本跳到了第 7 页=第二章),开头整章被跳过。现在首页认出
「第一章 / 第一节」就直接从第 1 页读;顺带修好了原图页上的
「从这页开始听」按钮——选第 1 页时以前会被自动起点覆盖,
点了像没反应,现在点哪页就从哪页开始。
二、第一次怎么用
--------------------------------------------------
1. 双击「PDF听书播放器电脑版V1.19.exe」。
注意:这一个文件有 260 多 MB,程序要先把内部资源解压出来,
第一次启动通常等 10~30 秒窗口才出现;机器慢、或双击时
直接带着一本书打开,可能要等 1 分钟以上,期间窗口是黑的,
都属正常。以后再开也要十几秒,同样是正常现象。
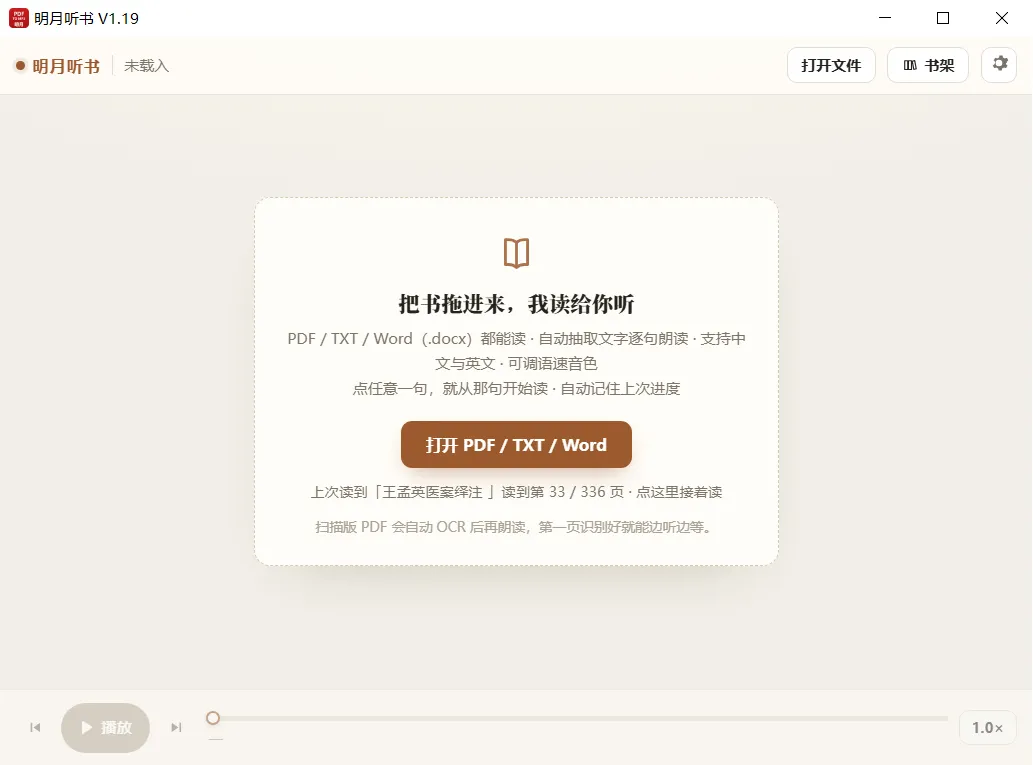
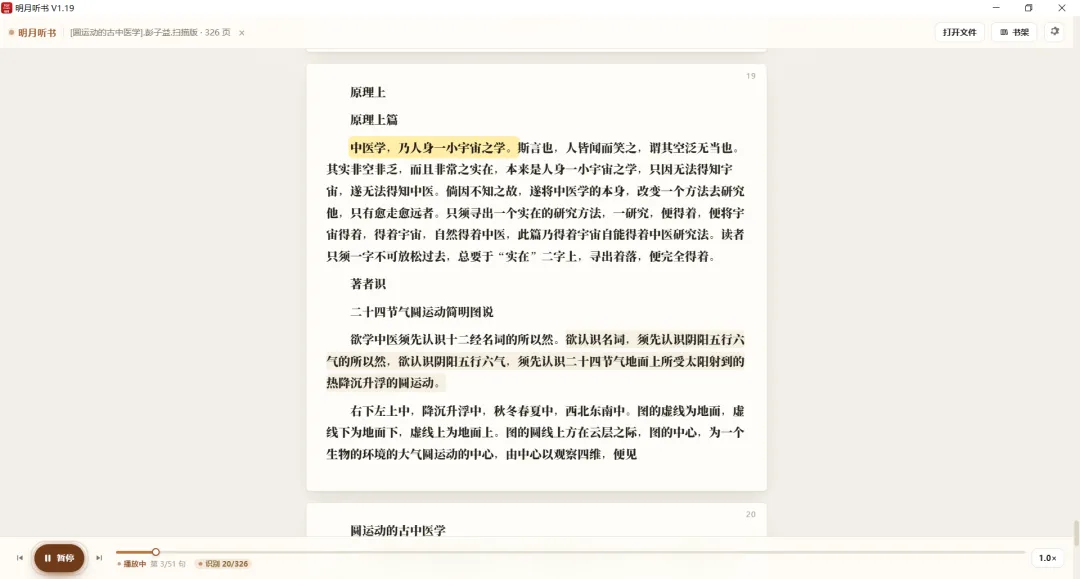
2. 窗口出来后,点左上角「打开文件」,选 PDF / TXT / Word。
3. 也可以直接把文件从资源管理器拖进窗口,会立刻载入。
4. 什么都不选的话,点画面中间那个「打开 PDF / TXT / Word」按钮。
三、以「目录」为界:整段目录之前的页一律不识别(V1.17~V1.19 重点)
--------------------------------------------------
以前打开一本电子书,封面、彩页、扉页、目录、前言这些页也会被
读出来(或拿去 OCR),认出来往往是一堆乱字,念也不是、看也不是。
现在按你说的做:**看到「目录」两个字,就以它为界**。
V1.17 的重点是:界不是「那一页目录」,而是「整段目录」。
很多书只有第一页印着「目录」两个字,后面七八页、十几页全是
「第 X 节 …………… 12」这种条目,一个「目录」字都没有。
V1.16 只跳过印着标题的那一页,剩下的目录页就被当正文念了
(《2倪海厦改良笔记《黄帝内经》》就是这样:目录其实有 10 页)。
现在用三层信息把整段目录量全,一层比一层便宜:
1)文字层找标题:认「目录」「目 录」「目 录」「目錄」「目次」
「总目录」「CONTENTS」,竖排把「目」「录」拆成两行也认。
只认独立成行的短标题,正文里写「同时完善了目录」不会误判。
2)PDF 自带书签:有些书正文里没排出「目录」二字,但 PDF 内部
书签第一条就叫「目录」,直接拿它给的页码当线索,零成本。
3)目录版式连续延伸:从目录首页往后,只要整页是点符引导的
条目行(末页只剩 4~7 行、引导符是特殊字体乱码也认),
就一直算目录;版式一断立刻停,绝不把正文吞进去。
还认得行尾带页码、每行「第 X 章 / 第 X 节」的目录。
判断一行算不算目录条目,看的是「引导点有多长」:
一行里连续 8 个点以上(句点「.」算 1 个点,省略号「…」
算 3 个点)就认,哪怕行尾没印页码;点少一点的,
行尾挂着页码也认。中文正文里的省略号只有 6 个点,
够不着这条线,所以正文里的「……」不会被误当目录。
目录再长也不会半路收手:连续目录页的上限放到 45 页,
真正收口的是「版式一断立刻停」。《针灸断病法则(注释版)》
有 27 页目录(第 4~30 页),旧版卡在 25 页,最后那半页
「案例十…………」就被当正文念了出来,这一版不会了。
· 目录首页到目录末页,连同之前的封面 / 彩页 / 扉页,
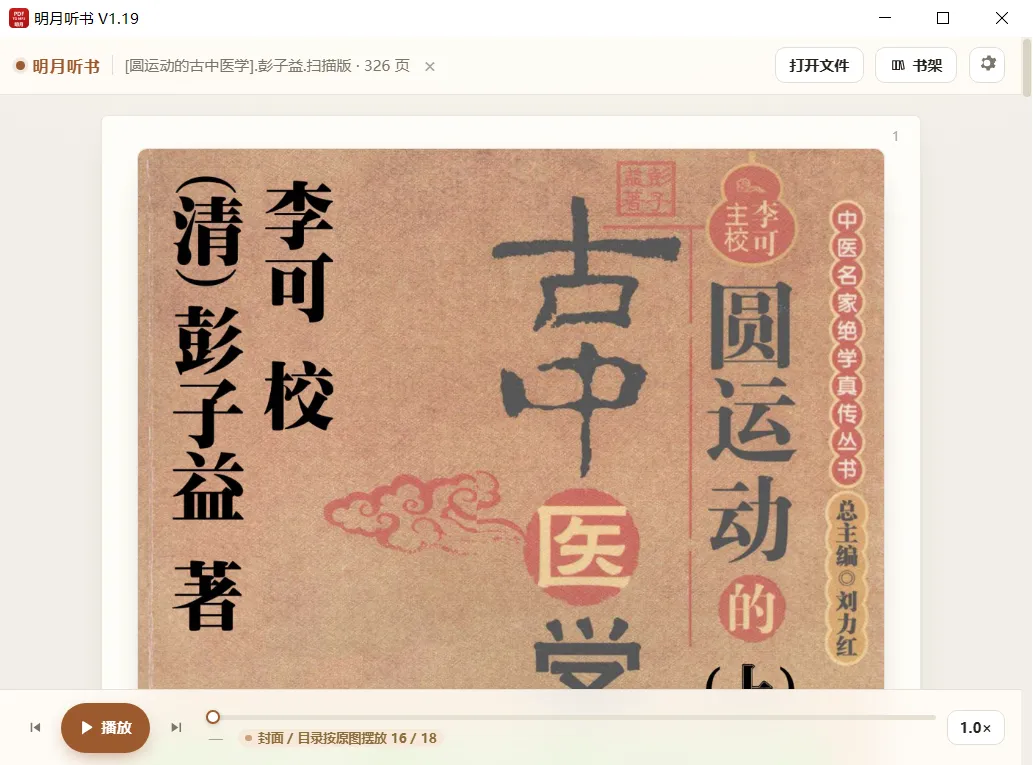
全部按原页图片摆进播放器 —— 能一页页翻着看,
但一个字都不识别、不朗读。质量门不用判,OCR 一次都不跑。
· 只从最后一页目录的下一页开始识别 / 朗读。
· 找不到明确目录页的书,退回下面的原页模式,不会乱跳。
· 打开时会在进度提示里写明「目录第 X~Y 页,共 N 页」。
还有两条兜底,专治「没有目录」的书:
· **第 1 页默认只摆原图,一个字都不识别。** 第一页几乎都是
封面 / 书名页 / 艺术字标语,认出来是「有象必有应 有病必有象
取应必有验」这种被拆碎的碎片,念着只有坏处。扫描书还顺带
省掉一次封面 OCR(实测省 5~8 秒)。真的把整页正文排在第 1 页
的书(讲义、单页文档)才照读,不丢内容。
**例外:首页第一行就印着「第一章 / 第一节」的书没有封面**,
第 1 页照常识别、从第 1 页读起(封面不会印章节号,所以
「第一节」也认;目录页因为满页「条目…页码」不会被认错)。
· **全书一页都没印「目录」的,绝不硬造一个假目录。** 比如
《针道:极简针灸视域下的生命秘密》是电子版直接进正文:
序言第 2 页就开始了。程序只在前面找「第一章 / 绪论」这类
正文提示,找不到就从第 2 页照常读起,不会把序言、导读
当成「封面 / 目录」跳掉。
序言中间夹一页作者落款、插图或篇章扉页,也不会打断判断。
有文字层的普通 PDF 走这条规则几乎不花时间(只读文字层,
不跑 OCR)。D 盘 41 本真书校准后命中 13 本,位置逐本核对过:
· 倪海厦系列:针灸 3~9 → 第 10 页、黄帝内经 3~12 → 第 13 页、
神农本草经 3~11 → 第 12 页、伤寒论 3~16 → 第 17 页、
金匮要略 3~10 → 第 11 页。
· 食养指南 5 本:单页目录 → 第 3 页(不会多跳)。
· 朱良春 16~18 → 第 19 页;名老中医之路 2~3 → 第 4 页;
基层中医适宜技术手册 6~9 → 第 10 页。
【V1.18 新增:目录又长又靠后的扫描书】
《心脏病医师中医处方手册》是个典型:目录排在封面、CIP、内容
提要、前言、编写说明、凡例之后,从第 10 页一直到第 22 页共 13 页,
正文第 23 页才印「第1章 充血性心力衰竭」。旧版逐页 OCR 只翻前
8 页、6 秒就放弃,所以根本找不到;就算找到了,也只会跳过一页。
现在换了个不靠盲猜的办法,分两步:
1)版式圈范围:用极低分辨率灰度投影数每页的「行内填充」,
目录页是「条目 ……… 页码」,中间大片空白;正文页墨迹连成行。
0.03 秒一页,前 40 页一秒多就量完,完全不用 OCR。
2)文字双重确认:只 OCR 圈出区段的第一页和段后第一页
(约 3~4 秒一页),必须认出「目录」+「第1章 / 第一章」
这类正文提示才采信。两边对不上就当没找到,绝不硬跳。
实测这本书:版式段 1 秒多 + 两次确认,共约 6 秒,
起点准确落在第 23 页;起点会记住,下次打开不再花这时间。
另外按你的提议加了「第一章」提示:文字层的书如果没找到目录,
会退而找第一张印着「第一章 / 第一节 / 绪论 / 总论」且有正文
段落的页,从那里开始读。目录条目里的「第一章…1」会被
目录版式判据挡掉,不会认错。41 本真书核对:原有 13 本
目录命中位置不变,只多认出 1 本,落点合理。
【V1.19 新增:认准「第一章」那页 + 老进度重新算】
有读者反馈《心脏病医师中医处方手册》目录中间还是被识别了。
查下来目录本身认得没错(第 10~22 页、正文第 23 页),
问题出在进度文件:早期版本只存了「从第 6 页开始」,
没记这个起点是谁定的,程序一直把它当成「用户确认过」,
于是新目录规则根本没跑,从第 6 页一路 OCR 到目录里。
V1.19 两点改动:
1)这种没记来源的老进度,只要起点还落在前 45 页,
一律重新按「目录 + 第一章」定位,并把新起点记下来;
已经翻到正文深处(45 页以后)的老进度仍沿用,
免得为了一个起点把整本书重新识别一遍。
2)带「第X章」的书,段后第一页要是印着「第1章 XXX」
就直接以那一页为起点;如果那一页是前言 / 过渡页,
会在预算内再往后找几页「第X章」。目录条目页里
也有「第一章…1」,但那种页顶有十几行短条目,
程序会认出来并跳过,不会把目录里的条目当第一章。
实测这本书:起点精确落在第 23 页「第1章 充血性心力衰竭」。
另外:用户手动选过的起点如果正好落在目录区间里,
也会被自动改到目录之后;但目录之后你自己选的起点照旧优先。
扫描版 / 图片版 PDF 的文字本来就是图,程序会在开头几页找
「目录」两个字(内部 6 秒硬预算,实测约 8~16 秒),
上面那种超长目录另走版式圈段路径,约 6 秒就定位好;
认到了就自动定起点、不再问你,认不到才弹下面那个选择框。
找到的起点会记下来,这本书以后打开不再重复找。
几个要点:
· 目录之前的页没有删,点底栏页码输 3 就能翻回第 3 页看原图,
页面上会标「按目录自动跳过」。
· 每张原图下面有「改成从这页开始」按钮:想改界限,
翻到那一页点一下,程序会记住你的选择并重新打开。
目录之后你自己选过的起点优先于程序自动找的目录;
但如果选中的那页本身就在目录里,V1.19 会自动改到目录之后。
· 也可以在书架里「忘记这本书」,再打开时会重新按目录判断。
· 想连作者序一起听:翻到序言那一页点「改成从这页开始」即可。
· 从 V1.16 升级后,旧版记下的「自动起点」会按新规则重算一次;
V1.19 连「没记来源的老起点」也一起重算,不用手动清进度。
四、扫描版 PDF 的原页模式(找不到目录时的老办法)
--------------------------------------------------
第一次打开一本程序没认出目录的扫描版书,会弹框让你选
「正文从第几页开始」:
1. 框里有前 40 页的缩略图,点「上一页 / 下一页」翻,
找到正文第一页(比如第 16 页)。
2. 也可以直接在页码框里输页码。
3. 点「从这页开始听」。
4. 程序猜了一个页码(按页面墨迹密度估的),不一定准,
以你翻到的实际正文页为准。
这个选择会被记住,同一本书下次打开直接沿用,不再问。
· 起点之前的页,一张 OCR 都不做,直接摆原页图片,不朗读。
· 起点之后逐页 OCR,识别完还要过第五节那道「质量门」,
认得不好照样摆原图,不念错字。
· 正文里夹着的插图页、彩页也会自动保留原图。
· 弹框里点「整本都识别」=从第 1 页开始 OCR,回到老办法。
五、识别质量与速度(V1.15 重点改进)
--------------------------------------------------
这一版不是凭感觉调参数,是把 D 盘 41 本真电子书拿来逐页对照,
先量出旧版的问题(单页 7~42 秒、页眉水印混进正文、双栏串句、
繁体彩图认成一堆错字),再一项一项改:
1)认得差的页摆原图,但不再把整本书判死(V1.19 修正)
· 从书库文字层里统计出 2304 个简体常用汉字。一页认出来的字里
常用字占比不到 94%,就判为识别失败,放原页图片。
· V1.19 起,繁体旧书不再被这条误杀:一页里出现 5 种以上不同
高频字(的 / 是 / 氣 / 經 / 於 / 為…)就按繁体正文正常朗读。
繁体书覆盖率天然只有 0.3~0.8,旧规则会把整本判成「错字太多」,
一句话都不念 —— 这正是《金针秘传》这类民国影印书的问题。
· 整页目录点符、数字表格、纯符号 / 纯拉丁字母、字数太少、
识别置信过低、低置信行太多,仍然摆原图。
· 目录页哪怕不到 150 字也会按点符占比拦下来,不会念成正文。
1-1)连续多页不合格会自动放宽(V1.19 新增)
· 从正文起点开始连续 8 页都判「念不了」,说明不是书的问题,
是这本字迹太旧 / 繁体 / 竖排,标准定得太严。程序自动切到
宽容标准继续念,并提示「这本字迹偏旧,按宽容标准朗读」。
· 宽容标准只拦真正的乱码(几乎没有汉字、纯符号页),
宁可念得糙一点,也不会让整本书变成一本只能翻看的图片集。
2)页眉、水印不再混进正文
· 跨页学习反复出现在页顶 / 页尾的短行,比如
"更多免费资料添加微信 LC365360…",第三页起自动剔除。
· 水印跟正文粘在同一行时,把重复的页首前缀切掉。
· 学到的黑名单随这本书的识别缓存一起存,下次打开直接干净。
3)双栏书不再左右串句
· 杂志、工具书那种左右两栏,先找中间的空白带,左右栏各自
成段,不会把两栏的字横着拼成一句。
4)有文字层的页不再跑 OCR(提速最明显)
· 扫描书里常混着带文字层的页,现在逐页检查,超过 200 字
直接读文字层。真书实测:原来一页 25~37 秒,现在约 0.01 秒。
5)插图页、空白页才跳过识别(V1.19 收窄)
· 先用低分辨率缩略图看一眼是不是「纯白空页」,是就摆原图。
· V1.19 起只认纯白:以前按「极黑的墨迹行分成几组」判,浅墨、
泛黄的影印老书整页字都压不到阈值,会被当成插图页跳过 OCR。
实测《针灸甲乙经校释》抽 10 页全被判空白,《中草药土单验方选编》
也是 8/10 —— 这一类书整本一句都不念。现在只认纯白,
漏判一个空白页只是多花几秒识别,绝不会把整本判死。
6)识别本身也提速了
· 送进 OCR 的图片最长边限到 1000 像素、关掉方向分类、
识别批次改成 1(短行不再被拉到最长行那么宽一起算)。
· 同一批真书页实测:合计 586.8 秒 → 268.8 秒,约快 2.2 倍。
7)老缓存也会重新体检
· 以前存下来的识别结果,打开时会再过一遍页眉黑名单和质量门;
上次认得乱七八糟的页,这次会自动改成原图。
8)整段目录之前的页连质量门都不用判(V1.16~V1.19)
· 按第三节的目录区间,前面几十页直接摆原图,既不读文字层
也不跑 OCR;原来最容易念错的封面、版权页、目录、前言
从根上不再进入朗读内容。V1.17 把「一页目录」改成
「整段目录」;V1.18 又解决了「目录十几页、还排在
前言之后」的扫描书,连目录带前言一次跳干净。
某页摆成原图不是出错,是"宁可不念,也不念错字"。原图照样能
翻看;确定那页是正文却被摆成原图,点图下面「改成从这页开始」
可以强制重新识别。
六、播放控制
--------------------------------------------------
· 点正文里任意一句,就从那一句开始读。
· 底栏 ▶ / ⏸ 播放暂停,左右箭头跳上一句 / 下一句。
· 拖动进度条可以在整本书里快进快退。
· 点底栏的页码「第 x / y 页」,输入页码直接跳过去。
· 右上角 ×(书名旁边)关闭当前书,回到首屏,
进度会留在书架里。
七、音色、语速、音量
--------------------------------------------------
· 点右上角「设置」,里面有音色、语速、音量、正文字号。
· 在线音色要联网;断网会自动用本地模型,声音略机械但能读。
· 设置会自动记住,下次打开还是上次的。
八、进度与书架
--------------------------------------------------
· 每本书读到哪一句、哪一页都会自动存下来,关掉程序也不丢。
· 点顶栏「书架」,能看到最近读过的书,点一下接着听。
· 页码按原书页序号算,重新识别、换个版本都能对得上。
· 书架里可以「忘记」某本书,连它的进度和起点设置一起清掉。
九、支持的格式
--------------------------------------------------
· PDF:有文字层直接读(先按第三节找目录,找不到再按
「第一章 / 绪论」这类提示定位);扫描版走原页模式。
· TXT / MD:按段落切分朗读。
· Word:.docx / .docm / .dotx 直接读正文,表格里的文字也读;
插图、页眉页脚、文本框装饰字不读。Word 没有固定页,
程序按约 900 字切一"页",底栏页码是程序切的页。
· 老版 .doc:如果本机装了 Word 或 WPS,程序会自动转一下再读;
没装就提示你用 Word「另存为」.docx 再打开。
· 整篇都是扫描图片的 Word 读不出字,建议另存成 PDF,
PDF 那条路会做 OCR。
十、OCR 识别结果会缓存
--------------------------------------------------
· 第二次打开同一本书,直接读缓存,几秒就开,不用重新识别。
· V1.16 起,改起点不再动不动把整本重跑一遍:
起点往后移(前面多摆几张原图)时,旧缓存按页接着用;
只有起点往前移、缺了前面几页的识别结果,才重新识别。
· 回放缓存时会再过一遍质量门和页眉黑名单,
旧版存下来的乱码页会自动改成原图,不会又把错字念一遍。
· 缓存放在 %APPDATA%\TingshuReader\cache 里。
十一、数据存在哪里 / 怎么清理
--------------------------------------------------
所有数据都在本机,不上传:
%APPDATA%\TingshuReader\
├─ library.json 书架
├─ *.json 每本书的进度、起点设置
├─ cache\ OCR 识别结果
└─ app.log 运行日志(排错用)
音频和临时书页图片放在系统临时目录,程序退出后由系统清理。
想彻底清干净:删掉 TingshuReader 这个文件夹即可
(书架和所有进度会一起没了)。
十二、常见问题
--------------------------------------------------
Q:能不能看到「目录」两个字就不识别,目录之前的都不读?
A:V1.16 已实现,V1.17 从「一页」改成「整段」,V1.18 又能
处理「目录十几页、还排在前言之后」的扫描书(见第三节),
V1.19 进一步认准「第一章」那一页、并修掉老进度停在目录
中间的问题。程序把整段目录连同封面按原图摆放、不识别、
不朗读,只从最后一页目录的下一页开始读。有文字层的书
瞬间完成;扫描书约花 6~16 秒定位一次,找到就自动、
记下来,找不到才让你翻缩略图选。
Q:怎么看我用的是哪个版本?
A:看窗口标题栏 / 任务栏:那里写着「明月听书 V1.19」,
页面左上角不显示版本号。打开文件后会跟程序里记录的
版本号核对一致。
Q:我已经升级了,怎么这本书还在念目录中间那几页?
A:多半是早期版本留下的老进度:只记了「从第几页开始」,
没记来源,以前被一直沿用。V1.19 会自动重算这类起点,
并把结果写回进度文件;关掉旧版、用 V1.19 重新打开
这本书即可,第一次会重新定位到第一章。也可以在书架里
「忘记这本书」再打开,效果一样。
Q:这本书的目录有十页,以前怎么只读了一页就开念了?
A:V1.16 要求每一页都得印着「目录」二字才算目录页,而多数
书只有第一页有标题,后面全是点符条目,所以被当成正文了。
V1.17 改为按目录版式连续延伸,倪海厦系列 7~14 页、
《黄帝内经》3~12 共 10 页,现在都能一次跳干净。
升级后旧起点会自动重算,不用手动清进度。
Q:目录特别长、还排在前言后面,能认出来吗?
A:V1.18 专门做了。《心脏病医师中医处方手册》目录在
第 10~22 页共 13 页,正文第 23 页才是「第1章」,
旧版只翻前 8 页、6 秒就放弃,完全找不到。现在先用
版式投影(不用 OCR,一秒多)把整段目录圈出来,再只
OCR 段首和段后两页,认出「目录」+「第1章」才采信,
实测约 6 秒、起点准确落在第 23 页。9 本扫描书核对过,
没有一本被这种版式段误跳。V1.19 又加了「第一章」精确
落点:段后第一页印着「第1章」就直接定在那里,并会
把早期版本留下的老起点一起重算,不会再停在目录中间。
Q:为什么这本书没有自动跳过目录?
A:可能是书里没有独立的「目录」标题页(只写「总目录」
但混在页眉里),也可能是纯扫描页上那两个字 OCR 没认出来,
或版式段的「目录 / 第一章」双重确认没对上。V1.18 会再试
按「第一章 / 第一节 / 绪论」定位文字层的书;都认不出才
退回原来的起点选择框,选一次就记住了,不影响使用。
Q:我不想跳过作者序 / 前言?
A:翻到那一页,点原图下面「改成从这页开始」,程序会以你的
选择为准并记住;或在弹框里点「整本都识别」。
Q:打开后一直转圈 / 黑屏 / 白屏?
A:第一次启动要解压 260 多 MB,等 20~60 秒界面才渲染出来
(带书打开、机器慢时可能更久),期间窗口可能是黑的,
属正常现象。如果 C 盘满了,
WebView2 也会起不来,先腾出几百 MB 空间再打开。
Q:扫描版为什么弹框让我选页码?
A:程序没在开头认出「目录」两个字。扫描书的封面、目录、
正文在图像上几乎一样,硬猜容易把目录当正文。选一次,
以后这本书记住,不再问也不再花时间找。
Q:某页明明是文字,却显示成原图?
A:两种情况:一是 V1.17~V1.18 判断它在整段目录之前(图上会标
「按目录自动跳过」);二是那页 OCR 出来的字太少、常用字
覆盖率低或置信度太低,被质量门拦下了。两种都可以点该页
下面「改成从这页开始」强制重新识别。
Q:好多内页识别错了,念一堆怪字?
A:V1.15 加了常用字覆盖率质量门;V1.16 把最容易认错的
封面 / 版权页 / 目录 / 前言整段跳过;V1.17 改成跳过整段
目录;V1.18 连「十几页目录排在前言后」的扫描书也能一次
跳干净,并加了「第一章」兜底 —— 这些页连识别都不做,
只摆原图。详见第三、五节。
如果还有具体某本书某一页念错,把书名和页码告诉我,
我拿那页对着调规则。
Q:识别得不好,我点「从这页开始听」怎么没反应?
A:V1.14 已修好。旧版在「重开书 / 命中识别缓存」时没有把
当前起点告诉界面,点按钮会调到一个没有人在等的接口。
现在无论哪种情况,点一下都会带着这页的新起点重新打开。
Q:正在听第一本,直接打开第二本会不会串?
A:V1.13 起已修好。换书那一刻会先把第一本的进度存下来、
停掉声音,并把第一本后台还在识别的页全部作废。
Q:朗读没声音?
A:先看设置里「测试语音」;在线音色要联网,断网会切本地模型。
另外检查系统音量、有没有别的程序独占音频设备。
Q:识别很慢?
A:V1.15 已明显提速(同一批真书页 586.8 秒 → 268.8 秒,
约快 2.2 倍);V1.16 省掉目录之前几十页的识别,
V1.17 把整段目录都省了,V1.18 又用版式投影(不用 OCR)
把超长目录的定位压到约 6 秒,且和原来的探针共用
14 秒总预算,不会两段等待叠加。有文字层的页直接读文字层、
插图空白页跳过、图片限幅到 1000 像素。起点会记住,
以后打开不再重复找目录。
扫描书第一次仍要逐页认,第一页出来就能边听边等;
认完一次就缓存了,下次秒开。
十三、两个小技巧
--------------------------------------------------
· 大部头扫描书:让它后台慢慢认,已认完的部分随时能听;
认完一次以后都是秒开。
· 想把某段反复听:点那句开头,再点 ▶,播完一句会继续往下,
按暂停就能停在那儿。