ARTICLE · 1397997
把客户 80 页需求文档喂给 AI,最怕漏的是这 3 处:版本、附件、附件里的附件
一、先看效果
客户发来 80 页需求文档,售前让 AI 做摘要,十分钟出了一页纸,条理比人读两小时还清楚。
写方案时客户问了一句:「这条是哪一页写的?」翻回去找不到。追下去才发现,摘要里有三条来自两天前被替换的 V2,还有一条出自「附件三」里嵌的另一份表格——那份附件根本没进切片范围。
销售方案里引错一条需求,轻则被客户当场纠正,重则报价按错的范围做,后面全要返工。
后来规矩改成:先按版本锁文件,正文和附件分开切片,每条结论强制带文件名和页码,没页码的一律不进方案。摘要还是十分钟出,但多了一份能点回原文的引文定位表。
整条链路三步,中间那步是重点:
docs/(按版本归档) → slice_rfp.py 正文与附件切片 → citations.md 每条带页码 → 售前核对后进入方案
text
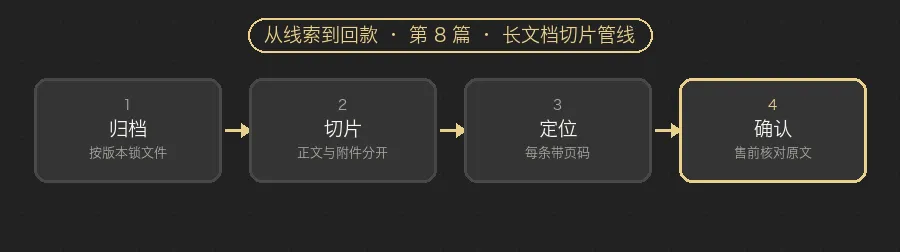
插图1 长文档切片管线
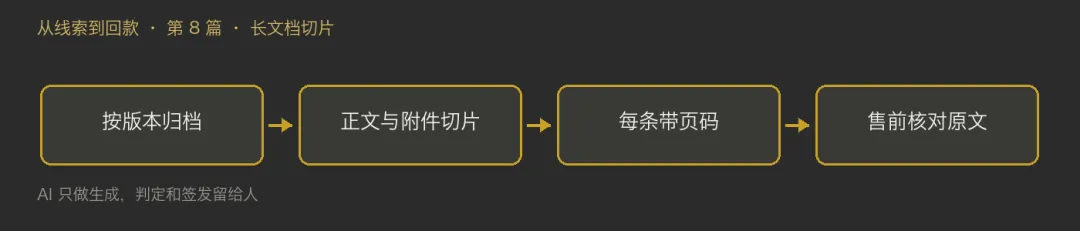
流程图
长文档的风险不是读不完,是读完了说不清哪句出自哪一页。 没有出处的摘要,写得越漂亮越危险。
二、它到底在干什么
三句话讲透。
第一句:模型会把多份文件的内容揉成一段连贯的话,不会主动告诉你哪句来自被废弃的版本。
第二句:附件、附表、嵌在附件里的表格,最容易在切片时被丢掉,偏偏关键约束常写在那里。
第三句:所以切片时把「出处」当成必填字段:文件名、版本号、页码,缺一样就不输出。
按版本切片 + 强制页码 = 能进方案的结论
运营assert 是故意的。素材格式不对,与其让脚本猜,不如当场停。第一次跑我少写了一个字段,直接炸掉,比对着一堆错误输出找源头快得多。
客户你引了一条他们已经删掉的需求,对方不会觉得「AI 总结得不错」,只会怀疑你到底有没有认真看文件。
销售算笔账:按旧版做一版报价,客户指出范围不对,方案、报价、排期三样一起改。这一轮返工,够把切片流程做三遍。
三、动手搭一遍
环境:Python 3.8+,不用装第三方库。建个空目录,放三个文件就能跑。
3.1 先把素材固定下来前置条件
别把一堆原始记录直接粘给模型。先落成 docs.json,把「能说什么」和「不能说什么」写清楚:
{ "project": "某供应链对账系统", "docs": [ {"file": "需求_V2.pdf", "version": "V2", "date": "2026-10-20", "active": false}, {"file": "需求_V3.pdf", "version": "V3", "date": "2026-10-22", "active": true}, {"file": "附件三_字段表.xlsx", "version": "V3", "date": "2026-10-22", "active": true} ], "require_cite": true}
json
docs.json 这段是整套东西的核心。口径一变,改这里就行,不用回头改两百条文案。
import jsonfrom pathlib import Pathdata = json.loads(Path("docs.json" ).read_text(encoding="utf-8"))for k in ["project", "docs", "require_cite"]: assert k in data, "素材缺字段 " + kprint("素材就绪", type(data).__name__, len(data))
python
运营assert 是故意的。素材格式不对,与其让脚本猜,不如当场停。第一次跑我少写了一个字段,直接炸掉,比对着一堆错误输出找源头快得多。
3.2 提示词模板(可直接抄)
你是需求文档抽取助手,只做定位,不做发挥。输入:我提供的某一页原文与 docs.json。输出结构:需求编号 / 原文摘录 / 文件名 / 页码。质量约束:- 每条必须带文件名与页码- 只写该页明示的内容- 不许合并不同版本的内容- 条件句要把"但书"一起抄上需澄清机制:页码缺失就标"待定位"。素材占位符:【粘贴某一页原文】
text
(注:最后两行别删。删了以后模型遇到缺字段会自己补一个,这是我最开始踩的坑。)
两个变体问法,换场景时改这两句:
变体 A:改成标书条款抽取,增加"废标项"一列,仍带页码。变体 B:改成合同审阅,只抽取金额、交期、违约三类。
text
3.3 写校验脚本
核心脚本不长,查的就是上面那几条硬规则。输出分「能发」和「不能发」,不允许出现「大概没问题」。
import jsonfrom pathlib import Pathcfg = json.loads(Path("docs.json" ).read_text(encoding="utf-8"))rows = Path("citations.tsv").read_text( encoding="utf-8").splitlines()issues, active = [], {d["file"] for d in cfg["docs"] if d["active"]}for i, r in enumerate(rows[1:], 2): cols = r.split("\t") if len(cols) < 4 or not cols[3].strip().isdigit(): issues.append((i, "引文无页码")) continue if cols[2] not in active: issues.append((i, "引用了失效版本"))for d in cfg["docs"]: if d["active"] and not any(d["file"] in r for r in rows): issues.append((0, "有效文件未切片:" + d["file"]))for i, why in issues: print("[FAIL] 第 %d 条 %s" % (i, why))print("结果:%d 处硬失败,摘要不可发" % len(issues))if issues: raise SystemExit(1)
python
销售有硬失败就让进程停住,内容不会流到下一步群发工具里,不用人去读日志判断。
3.4 跑一遍
$ python3 slice_rfp.py[FAIL] 第 12 条 引用了失效版本[FAIL] 第 41 条 引文无页码[FAIL] 第 0 条 有效文件未切片:附件三结果:3 处硬失败,摘要不可发
bash
进程返回 1,这批内容停在发送前。
来源:slice_rfp.txt 素材:docs.json规则:5 类[FAIL] 第 12 条 引用了失效版本[FAIL] 第 41 条 引文无页码[FAIL] 第 0 条 有效文件未切片:附件三结果:3 处硬失败,摘要不可发结论:不可发送。改完重跑,直到硬失败为 0。
text
四、成品长什么样
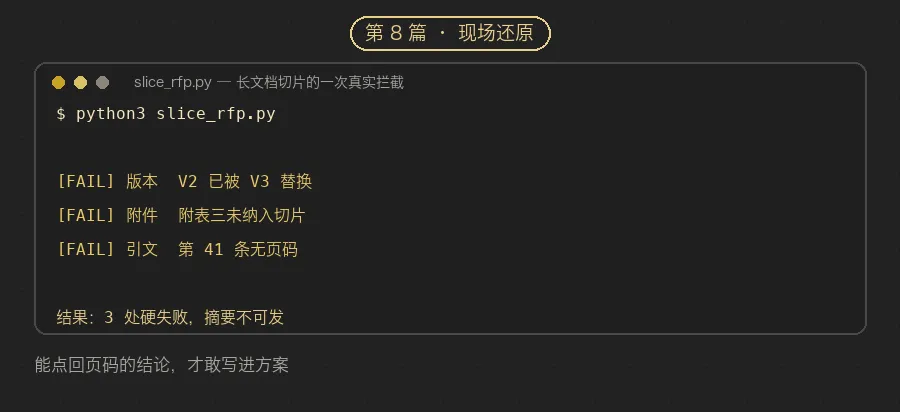
插图3 终端实跑:长文档切片现场还原
拿到的是一份验收单,不是一句「检查通过」。上面那几行就是当时那批真实草稿的结果,改完再跑:
$ python3 slice_rfp.py[FAIL] 第 41 条 引文无页码结果:1 处硬失败
bash
只剩一条误报。词表命中的是字面,不是语义;补一条白名单短语,再跑就干净了。
逐条点评这份输出哪里好、哪里还得改:
误报出在扫描件:PDF 第 3 页其实是正文第 1 页,脚本按物理页码报「无页码」。第一版天天报十几条,售前直接不看输出了。后来登记表加了「页码偏移」字段,物理页减 2 才是引用页。页码这事,规则得跟着文件走,不能跟着脚本走。
运营规则别一次写满。先上最硬的两条,跑一周看误报率,再决定加不加。一上来铺三十条,最后一定是全员关掉。
五、验收与风险
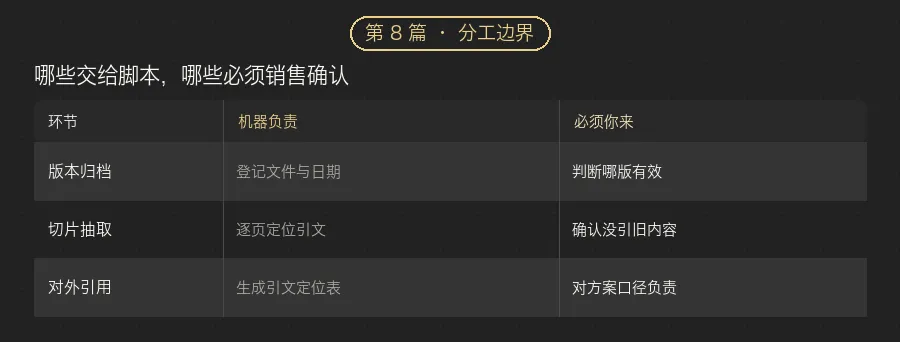
插图2 分工边界:哪些交给脚本,哪些必须销售确认
运营这篇的活干没干好,按这 5 条勾:
有效版本清单唯一且标了日期 正文、附件、嵌套附件全部切片 每条结论带文件名与页码 失效版本引用被硬拦 同一批文件反复跑结果一致
销售不能交给 AI 的部分,写清楚比写脚本更重要:
一是报价和折扣。数字一旦进了客户邮箱,就变成谈判起点,模型不会替你守价。
二是交期和功能承诺。「已支持」「下季度上线」「本周上门」,这三句我们对客户是要负责的,AI 天然倾向于写得更肯定。
三是客户隐私。别把 A 客户的预算、B 客户的排期混进同一批素材,也别把名单粘到外部工具里。
客户还有一层分寸:批量内容最容易被看出来的不是错别字,是「谁都能收到」的语气。脚本管不了这个,得销售自己读一遍开头两句。
5.1 一个真实的翻车
第一版我们把所有 PDF 合并成一个大文件再喂进去,图省事。客户后来发来 V3,运营忘了删 V2,两份一起躺在目录里,摘要自然混着引。
那天之后归档规则改成「一个版本一个目录、失效版本移出工作区」。技术上只是挪文件,口径上却解决了大半问题:模型不会替你判断哪份算数。
5.2 边界条件
规模再往上,瓶颈不在校验速度,在素材本身没洗干净。这时候该回头做去重和来源标注,别继续往正则里加补丁。
5.3 迁移到别的场景
同一套方法换到相邻环节,改两处就够:
标书条款:增加废标项一列,仍带页码 合同审阅:只抽金额、交期、违约三类 客户会议材料:把「谁说的」也加进出处字段
5.4 成本账别算得太漂亮
三样东西要分开算。
调用费用几乎可以忽略。 校验脚本纯本地正则,零成本;生成会调模型,按常见定价一个月下来不到一杯咖啡。真正花钱的是人工核稿那几小时。切片与校验本地零成本;按页数计费的解析大概几毛钱。
学习成本比想象中高。 第一版脚本写了约两小时,之后一周每天十来分钟看误报、改词表。售前要习惯「先看引文表再写方案」,否则会直接拿摘要用。
最贵的是维护责任。 口径会变、话术会变、新人会带来新说法。客户每发一版,登记表就得更新;没人认领,V4 来了还锁着 V3。
销售给老板的口径写「需求摘要每条能点回页码,避免按旧版范围返工一次」,比写「AI 十分钟读完 80 页」实在。
还有个反常识的结论:这套流程用得越久,省下的核稿时间越不值钱,值钱的是团队对「哪些话不能对客户说」达成了共识。脚本只是把共识写成了能执行的形式。第 18 篇讲 ROI 表时会展开。
六、写在最后
长文档最怕的不是漏读,是读完以后说不清依据。
AI 会把几份文件揉成一段很顺的话,顺到你忘了它可能揉进了已经被替换掉的那版。给每条结论留一个页码,是给方案、报价和后面的验收都留的退路。
明天第 9 篇讲让 AI 写方案建议书,只写事实层,判断和报价留给人。
⚠️ 免责提醒:文中脚本只做规则匹配,会漏判也会误报。AI 会错,发给客户的是你的名字,发送前那最后一眼别省。
如果这篇对你有用,点个赞、在看,转给那个总在加班核对材料的同事。关注「如何面对AI海啸」,21 天一起把 AI 用在获客和成单上,别用在给自己挖坑上。
本文客户信息与命令均为演示用,正式使用前请按自己的产品口径和客户名单调整词表。
📌 顺便说一句
这篇讲的方法,出自配套的微信小课:
- 17 类 AI+办公场景
:文案与纪要、长文档与 Excel、图片与音视频、自动化与工具链、动态落地页 - 每类按四步走
:选题方向 → 常用工具 → 实战项目 → 避坑验收 - 零基础可学,跟着做就能跑起来
👉 课程入口: