文档文本内容
关注公众号:陆陆高分冲刺  ~领取:最新版“中考/高考-总复习”、最新试卷下载
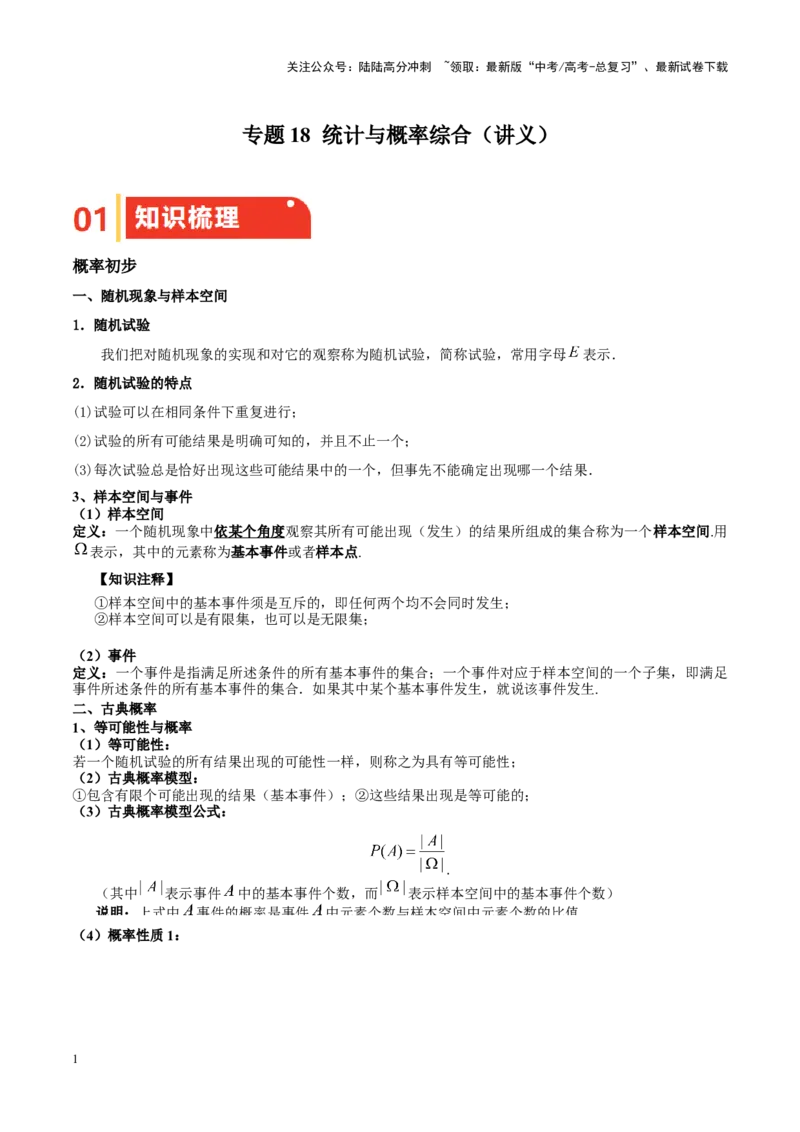
专题18 统计与概率综合(讲义)
概率初步
一、随机现象与样本空间
1.随机试验
我们把对随机现象的实现和对它的观察称为随机试验,简称试验,常用字母
表示.
2.随机试验的特点
(1)试验可以在相同条件下重复进行;
(2)试验的所有可能结果是明确可知的,并且不止一个;
(3)每次试验总是恰好出现这些可能结果中的一个,但事先不能确定出现哪一个结果.
3、样本空间与事件
(1)样本空间
定义:一个随机现象中依某个角度观察其所有可能出现(发生)的结果所组成的集合称为一个样本空间.用
表示,其中的元素称为基本事件或者样本点.
(2)事件
定义:一个事件是指满足所述条件的所有基本事件的集合;一个事件对应于样本空间的一个子集,即满足
事件所述条件的所有基本事件的集合.如果其中某个基本事件发生,就说该事件发生.
二、古典概率
1、等可能性与概率
(1)等可能性:
若一个随机试验的所有结果出现的可能性一样,则称之为具有等可能性;
(2)古典概率模型:
①包含有限个可能出现的结果(基本事件);②这些结果出现是等可能的;
(3)古典概率模型公式:
(4)概率性质1:
【知识注释】
①样本空间中的基本事件须是互斥的,即任何两个均不会同时发生;
②样本空间可以是有限集,也可以是无限集;
.
(其中
表示事件
中的基本事件个数,而
表示样本空间中的基本事件个数)
说明:上式中
事件的概率是事件
中元素个数与样本空间中元素个数的比值
1
关注公众号:陆陆高分冲刺  ~领取:最新版“中考/高考-总复习”、最新试卷下载
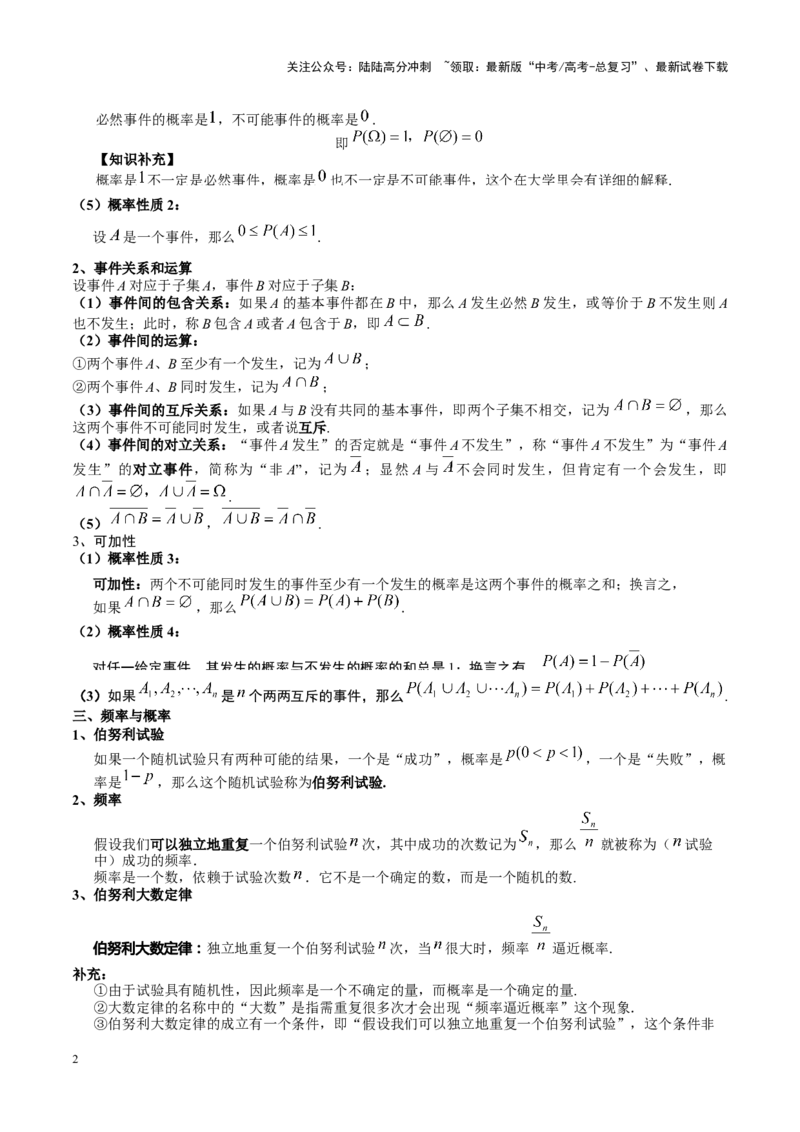
(5)概率性质2:
2、事件关系和运算
设事件A 对应于子集A,事件B 对应于子集B:
(1)事件间的包含关系:如果A 的基本事件都在B 中,那么A 发生必然B 发生,或等价于B 不发生则A
也不发生;此时,称B 包含A 或者A 包含于B,即
.
(2)事件间的运算:
①两个事件A、B 至少有一个发生,记为
;
②两个事件A、B 同时发生,记为
;
(3)事件间的互斥关系:如果A 与B 没有共同的基本事件,即两个子集不相交,记为
,那么
这两个事件不可能同时发生,或者说互斥.
(4)事件间的对立关系:“事件A 发生”的否定就是“事件A 不发生”,称“事件A 不发生”为“事件A
发生”的对立事件,简称为“非A”,记为
;显然A 与
不会同时发生,但肯定有一个会发生,即
.
(5)
,
.
3、可加性
(1)概率性质3:
(2)概率性质4:

(3)如果
是
个两两互斥的事件,那么
.
三、频率与概率
1、伯努利试验
如果一个随机试验只有两种可能的结果,一个是“成功”,概率是
,一个是“失败”,概
率是
,那么这个随机试验称为伯努利试验.
2、频率
假设我们可以独立地重复一个伯努利试验
次,其中成功的次数记为
,那么
就被称为(
试验
中)成功的频率.
频率是一个数,依赖于试验次数
.它不是一个确定的数,而是一个随机的数.
3、伯努利大数定律
补充:
①由于试验具有随机性,因此频率是一个不确定的量,而概率是一个确定的量.
②大数定律的名称中的“大数”是指需重复很多次才会出现“频率逼近概率”这个现象.
③伯努利大数定律的成立有一个条件,即“假设我们可以独立地重复一个伯努利试验”,这个条件非
必然事件的概率是,不可能事件的概率是
.
即
【知识补充】
概率是不一定是必然事件,概率是
也不一定是不可能事件,这个在大学里会有详细的解释.
设
是一个事件,那么
.
可加性:两个不可能同时发生的事件至少有一个发生的概率是这两个事件的概率之和;换言之,
如果
,那么
.
对任一给定事件
其发生的概率与不发生的概率的和总是1;换言之有
伯努利大数定律:独立地重复一个伯努利试验
次,当
很大时,频率
逼近概率.
2
关注公众号:陆陆高分冲刺  ~领取:最新版“中考/高考-总复习”、最新试卷下载
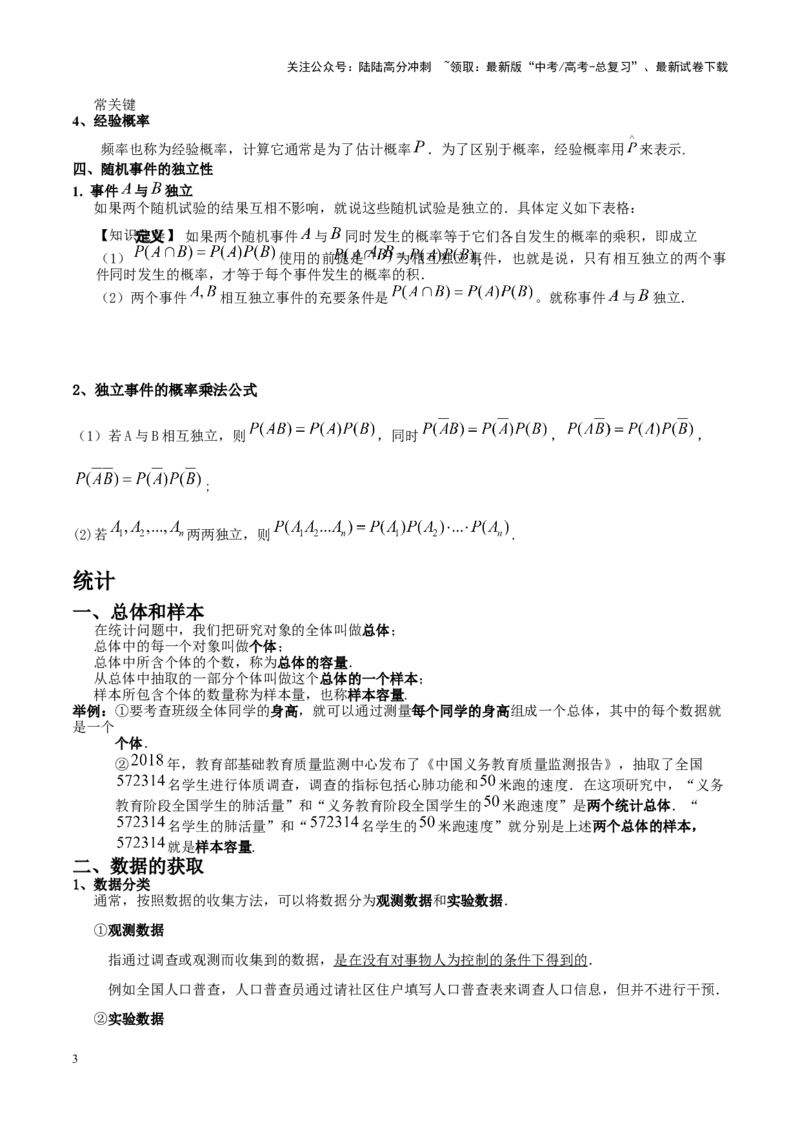
常关键
4、经验概率
频率也称为经验概率,计算它通常是为了估计概率
.为了区别于概率,经验概率用
来表示.
四、随机事件的独立性
1. 事件
与
独立
如果两个随机试验的结果互相不影响,就说这些随机试验是独立的.具体定义如下表格:
2、独立事件的概率乘法公式
(1)若A 与B 相互独立,则
,同时
,
,
;
(2)若
两两独立,则
.
统计
一、总体和样本
在统计问题中,我们把研究对象的全体叫做总体;
总体中的每一个对象叫做个体;
总体中所含个体的个数,称为总体的容量.
从总体中抽取的一部分个体叫做这个总体的一个样本;
样本所包含个体的数量称为样本量,也称样本容量.
举例:①要考查班级全体同学的身高,就可以通过测量每个同学的身高组成一个总体,其中的每个数据就
是一个
个体.
②
年,教育部基础教育质量监测中心发布了《中国义务教育质量监测报告》,抽取了全国
名学生进行体质调查,调查的指标包括心肺功能和
米跑的速度.在这项研究中,“义务
教育阶段全国学生的肺活量”和“义务教育阶段全国学生的
米跑速度”是两个统计总体.“
名学生的肺活量”和“
名学生的
米跑速度”就分别是上述两个总体的样本,
就是样本容量.
二、数据的获取
1、数据分类
通常,按照数据的收集方法,可以将数据分为观测数据和实验数据.
①观测数据
指通过调查或观测而收集到的数据,是在没有对事物人为控制的条件下得到的.
例如全国人口普查,人口普查员通过请社区住户填写人口普查表来调查人口信息,但并不进行干预.
②实验数据
定义   如果两个随机事件
与
同时发生的概率等于它们各自发生的概率的乘积,即成立
,
【知识注释】
(1)
使用的前提是
为相互独立事件,也就是说,只有相互独立的两个事
件同时发生的概率,才等于每个事件发生的概率的积.
(2)两个事件
相互独立事件的充要条件是
。就称事件
与
独立.
3
关注公众号:陆陆高分冲刺  ~领取:最新版“中考/高考-总复习”、最新试卷下载
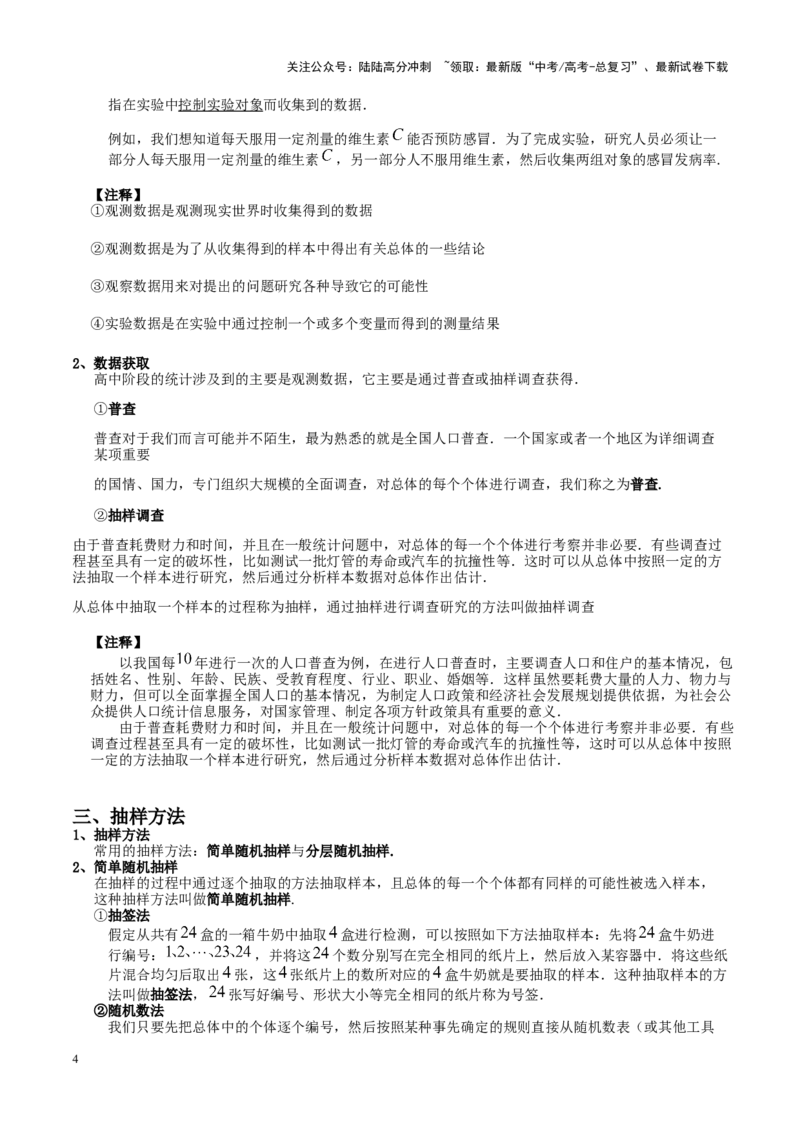
指在实验中控制实验对象而收集到的数据.
例如,我们想知道每天服用一定剂量的维生素
能否预防感冒.为了完成实验,研究人员必须让一
部分人每天服用一定剂量的维生素
,另一部分人不服用维生素,然后收集两组对象的感冒发病率.
2、数据获取
高中阶段的统计涉及到的主要是观测数据,它主要是通过普查或抽样调查获得.
①普查
普查对于我们而言可能并不陌生,最为熟悉的就是全国人口普查.一个国家或者一个地区为详细调查
某项重要
的国情、国力,专门组织大规模的全面调查,对总体的每个个体进行调查,我们称之为普查.
②抽样调查
由于普查耗费财力和时间,并且在一般统计问题中,对总体的每一个个体进行考察并非必要.有些调查过
程甚至具有一定的破坏性,比如测试一批灯管的寿命或汽车的抗撞性等.这时可以从总体中按照一定的方
法抽取一个样本进行研究,然后通过分析样本数据对总体作出估计.
从总体中抽取一个样本的过程称为抽样,通过抽样进行调查研究的方法叫做抽样调查
三、抽样方法
1、抽样方法
常用的抽样方法:简单随机抽样与分层随机抽样.
2、简单随机抽样
在抽样的过程中通过逐个抽取的方法抽取样本,且总体的每一个个体都有同样的可能性被选入样本,
这种抽样方法叫做简单随机抽样.
①抽签法
假定从共有
盒的一箱牛奶中抽取
盒进行检测,可以按照如下方法抽取样本:先将
盒牛奶进
行编号:
,并将这
个数分别写在完全相同的纸片上,然后放入某容器中.将这些纸
片混合均匀后取出
张,这
张纸片上的数所对应的
盒牛奶就是要抽取的样本.这种抽取样本的方
法叫做抽签法,
张写好编号、形状大小等完全相同的纸片称为号签.
②随机数法
我们只要先把总体中的个体逐个编号,然后按照某种事先确定的规则直接从随机数表(或其他工具
【注释】
①观测数据是观测现实世界时收集得到的数据
②观测数据是为了从收集得到的样本中得出有关总体的一些结论
③观察数据用来对提出的问题研究各种导致它的可能性
④实验数据是在实验中通过控制一个或多个变量而得到的测量结果
【注释】
以我国每
年进行一次的人口普查为例,在进行人口普查时,主要调查人口和住户的基本情况,包
括姓名、性别、年龄、民族、受教育程度、行业、职业、婚姻等.这样虽然要耗费大量的人力、物力与
财力,但可以全面掌握全国人口的基本情况,为制定人口政策和经济社会发展规划提供依据,为社会公
众提供人口统计信息服务,对国家管理、制定各项方针政策具有重要的意义.
由于普查耗费财力和时间,并且在一般统计问题中,对总体的每一个个体进行考察并非必要.有些
调查过程甚至具有一定的破坏性,比如测试一批灯管的寿命或汽车的抗撞性等,这时可以从总体中按照
一定的方法抽取一个样本进行研究,然后通过分析样本数据对总体作出估计.
4
关注公众号:陆陆高分冲刺  ~领取:最新版“中考/高考-总复习”、最新试卷下载
产生的随机数)中取一定量的随机数,这些随机数所对应的个体即组成一个样本.我们称这种抽样
方法为随机数法
③简单随机抽样的特点
抽签法和随机数法都属于简单随机抽样.一般地,简单随机抽样具有以下特点:
(1)总体个数
是有限的;
(2)是不放回抽样;
(3)总体中每个个体被选入样本的可能性相同
3、分层随机抽样
一般地,当总体由差异明显的几个部分组成时,先把总体分成若干个部分,然后从不同的部分中独立、
随机地抽取样本,这种抽样的方法称为分层随机抽样,简称分层抽样.
分层抽样的方法如下:先将总体个数
按要求分成
层,每层的个体数分别记作
;在每
层中分别随机抽取
个个体组成容量为
的样本,使得
,
,
.
显然,这里每个个体被抽到的概率均为
.
分层随机抽样的特点:
分层随机抽样利用辅助信息分层,使得各层间的差异较大,各层内的差异较小,这样的分层抽样能够
提高样本的代表性及抽样的效率.一般地,分层随机抽样适用于总体是由差异明显的几部分组成的情
况,且在每一层进行抽样时,常常采用简单随机抽样或其他随机抽样方法.
四、统计图表
Ⅰ、频率分布表和频率分布直方图
Ⅰ样本数据的频率分布表和频率分布直方图和频率分布折线图的步骤:
①求极差:
找出这一组数据的最大值和最小值,最大值与最小值的差称为极差,又称全距;
②确定组距与组数:
取组距,用
决定组数;
【注释】
抽签法简单易行,适用于总体容量不大的情形.但当总体容量很大时,制作号签比较费时,且不易混
合均匀,这时我们可以利用随机数表法.随机数表(见课本附录)就是一种现成的号签,它是由一连串的
之间的数字构成的,且满足以下两个条件:
(1)对表中任何一个给定位置的数字,其为0~9中任何一个数字的概率都相等;
(2)不同位置数字的取值是相互独立的.
什么时候选择分层抽样?
比如:某高中为了解高一年级新生的身高情况,计划抽取
名学生测量身高.由于不同性别的学生
身高差异较大,人数也可能不一样,因此不适合用前面介绍的简单随机抽样.我们希望抽取的样本中男
女生的比例与全部高一年级新生的男女比例大致相同,这样得到的样本才具有代表性.这就要求在抽样
的过程中,不仅要使得总体中每个个体被抽到的可能性相同,而且应注意总体中个体的某些分类属性,
使得所抽取的样本能更明确地反映出总体的特征.那么这个时候就可以采用分层抽样.
极差表示数据的波动范围;
当数据在
个以内时,通常按数据的多少分为
组
5
关注公众号:陆陆高分冲刺  ~领取:最新版“中考/高考-总复习”、最新试卷下载
③统计每组的频数及频率;
④绘制频率分布表;
⑤绘制频率分布直方图:
在直角坐标系中把横轴分成若干段,每一段对应一个组距,,然后以组距形成的线段为底作一矩形,矩
形的高
为小组的
,知小长方形的面积=组距×
=频率.
⑥绘制频率分布折线图:
在频率分布直方图中,按照分组原则,再在左边和右边各加一个区间.这两个组的频率取值为
,然后
从所加
的左边的区间的中点(称为组中值)开始,从左至右依次连接各矩形上底边的中点,直至右边所加区间
的中点
,再将矩形的边去除,就可以得到一条折线,这条折线就是频率分布折线图.
Ⅱ、茎叶图
制作茎叶图茎叶图的步骤:
①将数据分为“茎”、“叶”两部分;
②将最大茎与最小茎之间的数字按由小到大、从上往下排成一列,并画上竖线作为分隔线;
③将各个数据的“叶”在分界线的一侧对应茎处同行列出.
Ⅲ、散点图
在考虑两组数据时,为了对两组数据之间的关系形成大致的了解,通常将这两组数据所对应的点描在
平面直角坐标系内,这些点组成的统计图称为散点图.
五、统计估计
Ⅰ、统计估计——估计总体的分布
总体是指考察对象的全体,个体是总体中的每一个考察的对象,总体的分布指的是总体中不同范围或
类型的个体所占的比例.
如果将样本容量取得足够大,且分组的组距取得足够小,那么相应的频率分布折线图将趋于一条光滑
的曲线,称为总体分布密度曲线.
事实上,尽管总体分布密度曲线是客观存在的,但由于在实际中往往无法获得总体的数据,因此无法
精确地得到它的密度曲线,只能通过样本的频率分布折线图来对总体分布的密度曲线进行估计.一般来说,
样本容量越接近总体容量,样本的频率分布折线图与总体分布密度曲线的贴近程度越高
Ⅱ、统计估计——估计总体的数字特征
统计数据的数字特征
把能反映一组数据某种特征的量称为这组数据的数字特征.
※如果组数太少,所有数据就会落在少数几个组里,导致这几个组的柱形太高;如果组数太多,大部分
的组中只有少数的数据或者没有数据,均无法有效呈现数据的分布;
※一般地,第一组的下限应低于最小值,最后一组的上限应高于最大值.
将样本数据分好组以后,每个小组内的数据个数称为频数,频数与样本容量的比值叫做这一小组的频率.
统计每个小组的频数,再计算各组的频率.
频率分布直方图比频率分布表更能直观形象地反映样本数据的分布规律.
在绘制统计图时还应注意以下几点:
(1)标题:统计图一般要有标题,用以说明统计图的内容. 如果可能的话,列出数据来源.
(2)坐标的刻度和名称:一般纵轴和横轴也需要有名称,纵轴应清楚地标明刻度,横轴应标明类别或
刻度.
(3)标注:如果要在一张图中呈现多元数据,应使用一些标注来识别单个数据.
茎叶图既可以用于呈现单组数据,也可以用于对两组同类数据的比较分析
6
关注公众号:陆陆高分冲刺  ~领取:最新版“中考/高考-总复习”、最新试卷下载
在初中阶段学习过的平均数、中位数和众数等,就是用来刻画一组数据集中趋势的数字特征,而方差
和标准差则是用来刻画一组数据离散程度的数字特征.
①通过样本估计总体的集中趋势
利用初中阶段学习过的平均数、中位数和众数,我们可以描述有限样本的集中趋势.
例如,设样本数据为
,由公式
就得到样本平均数,它描述了样本
数据的平均水平.
如果
个数据中不同的数据
的频数分别为
,那么样本平均数为
.
②通过样本估计总体的离散程度
在初中阶段我们已学习过用样本数据的方差
来衡量一组数据的
波动大小.一组数据的方差越大,表明这组数据波动越大.
我们把方差的算术平方根
叫做样本数据的标准差,它同样是一
个用来衡量样本数据波动大小的统计量
注:在实验中,为了消除系统性偏差,标准差公式中往往以
代替
,用
来作为总体标准差的估计值.
Ⅲ、统计估计——估计百分位数
百分位数
当样本容量很大时,还可以将数据分为
个部分,每一部分包含
的数据.第
百分位数(
为
到
之间的整数,记作
)即是将一组数据从小到大排列后,将数据分成两部分:小于或等于第
百
分位数的数据占
,大于或等于第
百分位数的数据占
.
条件概率与全概率公式
1.条件概率
(1)概念:一般地,当事件B 发生的概率大于

 0(
  即
   P  ( B  )>0)
  时
  ,已知事件B 发生的条件下事件A
发生的概率,称为条件概率,记作P(A|B),而且P(A|B)=.
(2)两个公式
①利用古典概型,P(B|A)=;
②概率的乘法公式:P(AB)=P  ( A  ) P  ( B  | A  ) .
2.全概率公式
平均数反映的是平均水平,中位数反应的是中等水平,众数反应的是概率最大.它们都是用来刻画一组数
据的集中趋势.
方差和标准差都反映了一组数据围绕平均数波动的大小,方差的单位是观测数据的单位的平方,而标准
差的单位与观测数据的单位一致,因此我们常常用标准差来描述数据的离散程度.
计算第
百分位数时,首先将数据从小到大排列,然后计算指数
.
①若是整数,则第
百分位数是第项与第
项的数据的平均值;
②若不是整数,则将向上取整,得到的数即为第
百分位数的位置.
7
关注公众号:陆陆高分冲刺  ~领取:最新版“中考/高考-总复习”、最新试卷下载
一般地,如果样本空间为Ω,A,B 为事件,则BA 与BA是互斥的,且B=BΩ=B(A+A)=BA
+BA,从而P(B)=P(BA+BA)=P(BA)+P(BA),当P(A)>0 且P(A)>0 时,有P(B)=P  ( A  ) P  ( B  | A  )
+
  P  ( A  )P(B|

 A  ) .
Ⅱ、随机变量及其分布列的数字特征
1.离散型随机变量
一般地,如果随机试验的样本空间为Ω,而且对于Ω 中的每一个样本点,变量X 都对应有唯
一确定的实数值,就称X 为一个随机变量.其所有可能的取值都是可以一一列举的随机变量称
为离散型随机变量.
2.离散型随机变量的分布列
一般地,若离散型随机变量X 的取值范围是{x1,x2,…,xn},如果对任意k∈{1,2,…,
n},概率P(X=xk)=pk都是已知的,则称X 的概率分布是已知的,离散型随机变量X 的概率分
布可以用如下形式的表格表示,这个表格称为X 的概率分布或分布列.
X
x1
x2
…
xk
…
xn
P
p1
p2
…
pk
…
pn
3.离散型随机变量的分布列的性质
(1)pk≥0,k=1,2,…,n;
(2)∑pk=p1+p2+…+pn=1.
4.离散型随机变量的数学期望与方差、标准差
一般地,如果离散型随机变量X 的分布列如下表所示
X
x1
x2
…
xk
…
xn
P
p1
p2
…
pk
…
pn
(1)均值
称E(X)=x1p1+
  x 2p2+
  …
  +
  x npn=∑  x  ipi为离散型随机变量X 的均值或数学期望(简称为期望).
(2)方差
D(X)=[x1-E(X)]2p1+[x2-E(X)]2p2+…+[xn-E(X)]2pn=∑  [ x  i-
  E  ( X  )]  2 p i,能够刻画X 相对于均
值的离散程度(或波动大小),这称为离散型随机变量X 的方差.
(3)标准差
称称为离散型随机变量 X 的标准差,它也可以刻画一个离散型随机变量的离散程度(或波动大
小).
5.均值与方差的性质
(1)E(aX+b)=aE
  ( X  ) +
  b  .
(2)D(aX+b)=a  2 D  ( X  ) (a,b 为常数).
8
关注公众号:陆陆高分冲刺  ~领取:最新版“中考/高考-总复习”、最新试卷下载
分布列
1.n 次独立试验与二项分布
(1)n 次独立重复试验
在相同条件下重复n 次伯努利试验时,人们总是约定这n 次试验是相互独立的,此时这n 次
伯努利试验也常称为n 次独立重复试验.
(2)二项分布
一般地,如果一次伯努利试验中,出现“成功”的概率为p,记q=1  -
  p  ,且n 次独立重复试
验中出现“成功”的次数为X,则X 的取值范围是{0,1,…,k,…,n},而且P(X=k)=
C  p  k q  n -  k ,k=0,1,…,n,
因此X 的分布列如下表所示
X
0
1
…
k
…
n
P
Cp0qn
Cp1qn-1
…
C  p  k q  n -  k
…
Cpnq0
注意到上述X 的分布列第二行中的概率值都是二项展开式(q+p)n=Cp0qn+Cp1qn-1+…+Cpkqn
-k+…+Cpnq0中对应项的值,因此称X 服从参数为n,p 的二项分布,记作X~B(n,p).
2.两点分布与二项分布的均值、方差
(1)若随机变量X 服从两点分布,则E(X)=p,D(X)=p  (1
  -
  p  ) .
(2)若X~B(n,p),则E(X)=np,D(X)=np
  (1
  -
  p  ) .
3.超几何分布
一般地,若有总数为N 件的甲、乙两类物品,其中甲类有M 件(M<N),从所有物品中随机取
出n 件(n≤N),则这n 件中所含甲类物品数X 是一个离散型随机变量,X 能取不小于t 且不大
于s 的所有自然数,其中s 为M 与n 中的较小者,t 在n 不大于乙类物品件数(即n≤N-M)时
取0,否则t 取n 减乙类物品件数之差(即t=n-(N-M)),而且
P(X=k)=,k=t,t+1,…,s,
这里的X 称为服从参数为N,n,M 的超几何分布,记作X~H(N,n,M).
4.正态分布
(1)正态曲线
φ(x)=e-,φ(x)的解析式中含有μ 和σ 两个参数,其中:μ=E  ( X  ) ,即X 的均值;σ=,即 X 的
标准差.φ(x)也常常记为φμ,σ(x).
(2)正态曲线的一些性质
①正态曲线关于x  =
  μ  对称(即μ 决定正态曲线对称轴的位置),具有中间高、两边低的特点;
②正态曲线与x 轴所围成的图形面积为1;
③σ 决定正态曲线的“胖瘦”;σ 越大,说明标准差越大,数据的集中程度越弱,所以曲线越
9
关注公众号:陆陆高分冲刺  ~领取:最新版“中考/高考-总复习”、最新试卷下载
“
  胖
  ”
  ;σ 越小,说明标准差越小,数据的集中程度越强,所以曲线越“
  瘦
  ”
  .
(3)正态总体在三个特殊区间内取值的概率值
P(μ-σ≤X≤μ+σ)≈68.3%;
P(μ-2σ≤X≤μ+2σ)≈95.4%;
P(μ-3σ≤X≤μ+3σ)≈99.7%.
(4)正态分布的均值与方差
若X~N(μ,σ2),则E(X)=μ,D(X)=σ  2 .
统计模型
1.变量的相关关系
(1)相关关系:两个变量有关系,但又没有确切到可由其中的一个去精确地决定另一个的程度,
这种关系称为相关关系.
(2)相关关系的分类:正相关和负相关.
(3)线性相关:如果变量x 与变量y 之间的关系可以近似地用一次函数来刻画,则称x 与y 线性
相关.
2.相关系数
(1)r=xyxy
=xyx.
(2)当r>0 时,成对样本数据正相关;当r<0 时,成对样本数据负相关.
(3)|r|≤1;当|r|越接近1 时,成对样本数据的线性相关程度越强;当|r|越接近0 时,成对样本
数据的线性相关程度越弱.
3.一元线性回归模型
(1)我们将y=bx+a称为y 关于x 的回归直线方程,其中
xyxxyxx
(2)残差:观测值减去预测值,称为残差.
4.2×2 列联表和χ2
如果随机事件A 与B 的样本数据的2×2 列联表如下.
A
A
总计
B
a
b
a+b
B
c
d
c+d
总计
a+c
b+d
a+b+c+d
记n=a+b+c+d,则
χ2=.
10
关注公众号:陆陆高分冲刺  ~领取:最新版“中考/高考-总复习”、最新试卷下载
5.独立性检验
统计学中,常用的显著性水平α 以及对应的分位数k 如下表所示.
α=P(χ2≥k)
0.1
0.05
0.01
0.005
0.001
K
2.706
3.841
6.635
7.879
10.828
要推断“A 与B 有关系”可按下面的步骤
(1)作2×2 列联表.
(2)根据2×2 列联表计算χ  2   的值.
(3)查对分位数k,作出判断.如果根据样本数据算出χ2的值后,发现χ2≥k 成立,就称在犯错
误的概率不超过α 的前提下,可以认为A 与B 不独立(也称为A 与B 有关);或说有1  -
  α  的把
握认为A 与B 有关.若χ2<k 成立,就称不能得到前述结论.这一过程通常称为独立性检验.
11