ARTICLE · 1045067
好文分享【Nature】论文不只是PDF:它开始变成能工作的科研智能体
我们常说 AI 能帮忙“读论文”。但科研里更费时间的那一步,其实是:论文里的方法,能不能在我的数据上真正跑起来?
Nature 发表的 Paper2Agent,盯上的就是这道坎。它并不是给 PDF 加一个聊天框,而是尝试把论文、代码、数据资源和分析步骤封装成一个能被调用、能执行任务、还能接受测试的论文智能体。
如果你赶时间,可以先带走四句话:
它处理的不只是正文,还会寻找论文对应的代码库,把函数、资源和工作流整理成 MCP 服务。 “生成工具”不是终点,作者让系统实际运行测试,再决定哪些工具可以交付。 在 100 篇计算生物学论文中,74 篇成功完成了 agent 化;那 26 篇失败论文同样值得注意。 工具执行正确,不等于科学解释自动正确。开放式判断仍然需要研究者负责。
原文信息
英文题名:Reimagining research papers as interactive and reliable AI agents 作者:Jiacheng Miao、Joe R. Davis、Yaohui Zhang、Jonathan K. Pritchard、James Zou 期刊:Nature 在线发表:2026 年 9 月 16 日 DOI:10.1038/s41586-026-11044-y 许可:CC BY-NC-ND 4.0
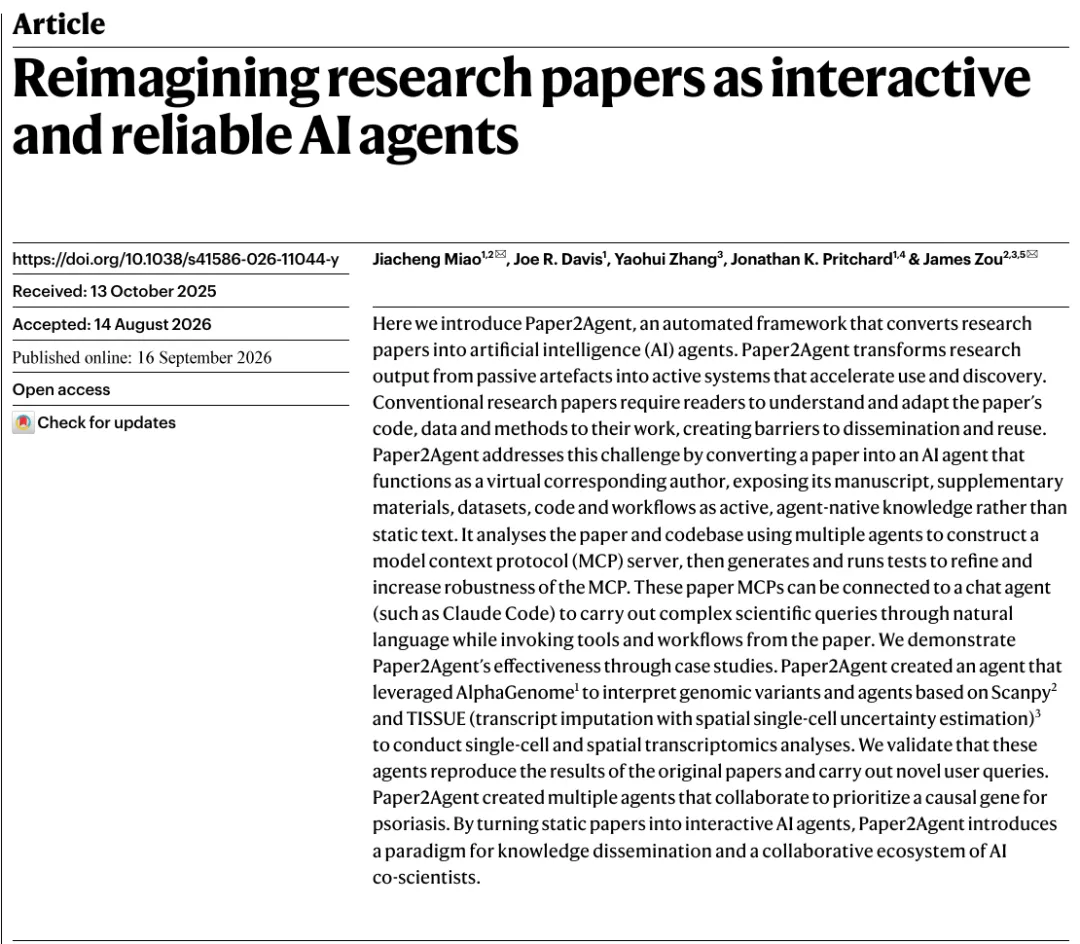
图源:Miao 等,Nature,2026,论文首页,DOI: 10.1038/s41586-026-11044-y。仅裁去 PDF 页边空白,未翻译、未标注、未重绘。
痛点不是“看不懂”,而是“用不起来”
普通论文问答主要解决文本理解。你问“作者用了什么方法”“结果怎样”,模型从正文里找信息,再组织成一段话。它可以帮你省阅读时间,却不会自动解决代码环境、输入参数、函数调用顺序和结果核验。
Paper2Agent 换了一个交付目标:既然论文声称方法可复现、可复用,能不能把这些能力直接整理成机器可调用的接口?
作者先让系统识别论文对应的代码库,由不同智能体完成环境配置和功能提取,再把能力包装成 MCP server。可以把 MCP 暂时理解为统一插座:兼容的 AI agent 通过它知道有哪些工具、需要什么输入、会返回什么结果。
图 1a 展示最终交付物的三层内容。橙色是工具,例如运行某个预测函数;绿色是资源,例如正文、代码仓库、数据与补充材料;蓝色是流程提示,例如按照固定顺序完成一个分析。图 1b 则给出从论文、代码库、环境配置、工具提取到测试和部署的完整链条。
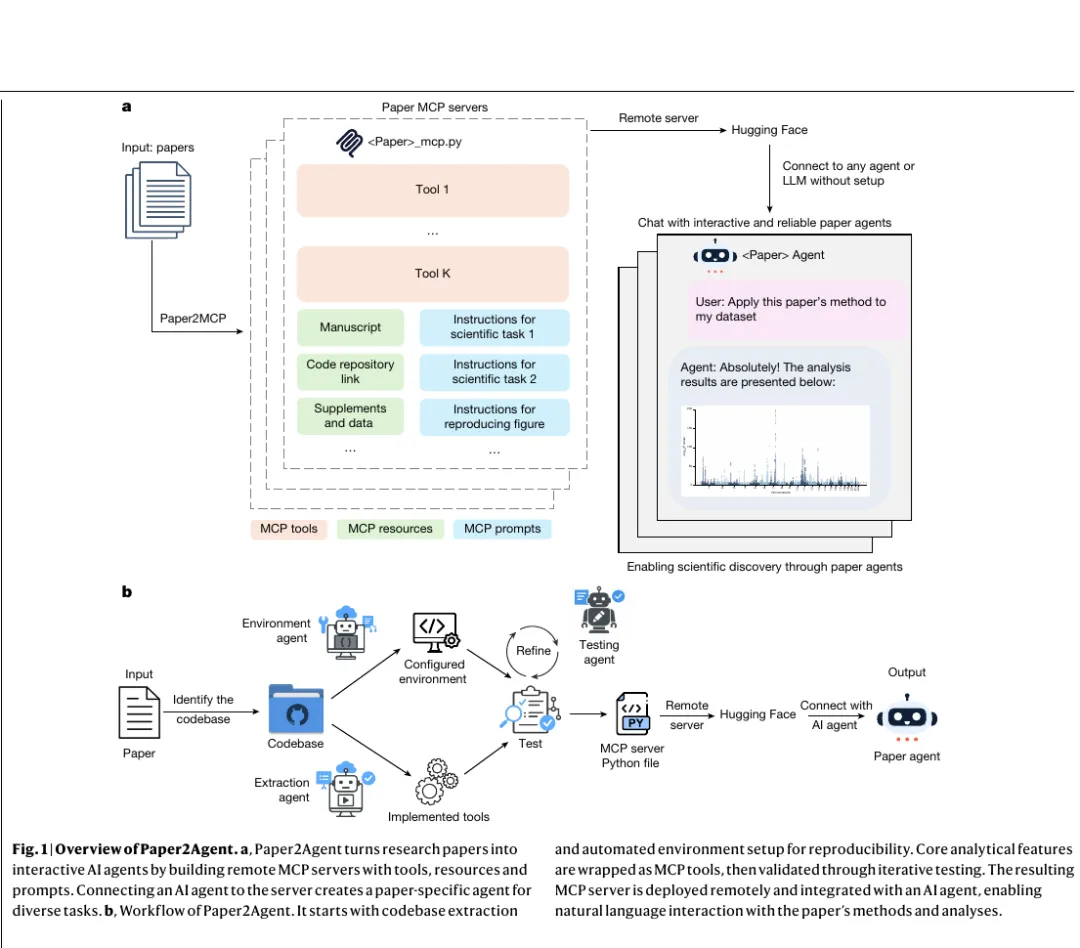
图源:Miao 等,Nature,2026,Fig. 1,DOI: 10.1038/s41586-026-11044-y。保留完整面板与原图注,仅裁去 PDF 页边空白,未翻译、未标注、未重绘。
这幅图能说明 Paper2Agent 设计了怎样的系统,却不能单凭流程图证明工具可靠。真正关键的是图中间那个不断循环的“测试—修正”环节:系统生成的代码必须实际运行,检查文件是否产生、数值是否落入容差范围、输出是否与参考结果一致。反复失败的工具不会进入最终服务,每个工具还保留到原始代码的可追溯链接。
这也是它和“让大模型照着 README 写一段调用代码”最实在的差别。
数字好看,但要先看它比较的是什么
论文用 AlphaGenome 做了一个完整案例。Paper2Agent 在约 45 分钟内生成 22 个 AlphaGenome MCP 工具,作者报告这些工具全部通过自动验证,单次构建成本约 14 美元。随后,他们把生成的智能体与两类基线比较:一类是让 Claude Code 直接访问代码仓库,另一类是科研智能体 Biomni。
图 2b 是最直观的结果。在 15 个教程衍生问题上,Paper2Agent 的平均准确率为 98.7±1.3%,Claude + Repo 为 82.7±3.4%,Biomni 为 37.3±4.0%;在 15 个新问题上,三者分别为 100.0±0.0%、78.7±4.4% 和 56.0±3.4%。图 2c 还显示 Paper2Agent 的查询运行时间更短。这里的数字来自 5 次独立运行,答案由两位独立专家按照预先定义的规则评分,专家间一致率为 96.7%。
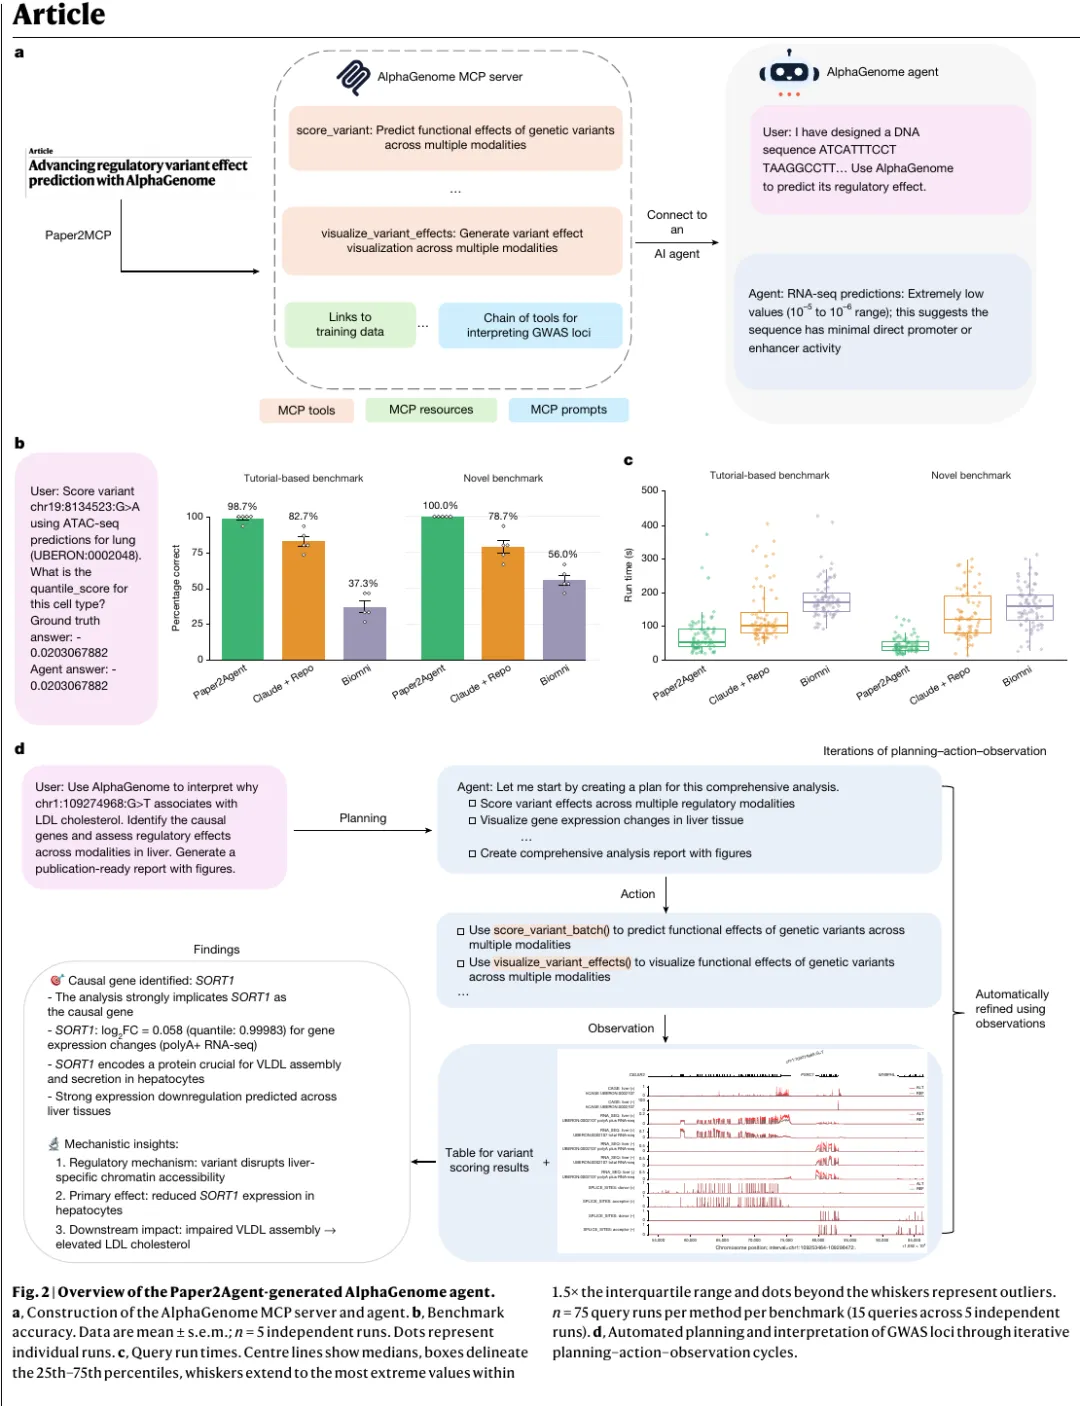
图源:Miao 等,Nature,2026,Fig. 2,DOI: 10.1038/s41586-026-11044-y。保留完整面板、坐标轴、基线与原图注,仅裁去 PDF 页边空白,未翻译、未标注、未重绘。
这幅图支持的结论很具体:在作者定义的 AlphaGenome 任务和评分标准下,经过封装与测试的论文智能体,比“把仓库直接交给通用代码 agent”更稳定、更快。
它不能推出“Paper2Agent 已经普遍优于科研人员”,也不能证明它对所有论文、所有学科都有效。评测的核心仍是既定任务中的执行正确性;开放式机制解释可能存在多个合理答案,论文自己也提醒,和单一参考答案一致更适合衡量忠实执行,而不是衡量科学真理。
那 26 篇失败论文,可能更值得看
为了测试规模化能力,作者处理了三组论文:100 篇计算生物学论文、26 篇偏数据与发现型论文,以及 10 篇非生物学计算论文。
在 100 篇计算生物学论文中,74 篇成功完成 agent 化。系统共提出 599 个工具,其中 593 个通过自动验证。对 300 个教程衍生问题,Paper2Agent 使用 Sonnet 4 时取得 91.2±1.6% 的准确率,高于直接访问论文和仓库的 Sonnet 4(80.3±2.3%)和 Sonnet 4.6(86.3±1.1%)。在 10 篇非生物学论文的 42 个执行任务上,准确率为 98.1±0.8%。
这些数字说明它不只跑通了一个精心挑选的演示。但更值得追问的是:为什么仍有 26 篇失败?
作者列出的主要原因很眼熟:没有可执行代码,缺少数据或模型文件,环境与依赖无法解析,脚本只适用于作者自己的目录和机器。这些问题不是 AI 新制造出来的;AI 只是把长期藏在复现过程里的断点暴露得更快。
因此,“一篇论文能否被顺利 agent 化”或许可以成为复现性的压力测试。代码上传到 GitHub,只代表文件存在。环境能否建立、示例能否运行、输入输出是否清楚、分析链能否被别人重建,是另一层标准。
三篇论文连起来,能不能变成一个证据链?
Paper2Agent 更大胆的展示,是让多个论文智能体协作。作者把 AlphaGenome、MPRA-coupled scCRISPRi 和 CD4+ T 细胞 Perturb-seq 三类能力连接起来,分析银屑病相关位点 rs887314。
图 4a 展示了分析路径:AlphaGenome 先把 GPR137 排到候选基因首位,RNA-seq quantile score 为 0.997;研究者随后从 agent 提出的验证策略中选择“扰动签名相关性”,再用另外两篇论文的数据交叉检查。
图 4b 的边界很重要。GPR137 敲低与 rs887314 调控元件扰动的下游表达变化,在刺激 8 小时和 48 小时条件下显著相关,Spearman ρ 分别为 0.61 和 0.63;静息条件下 ρ=0.29、P=0.21,并不显著。对照候选 BAD 在三个条件下都没有显著相关。
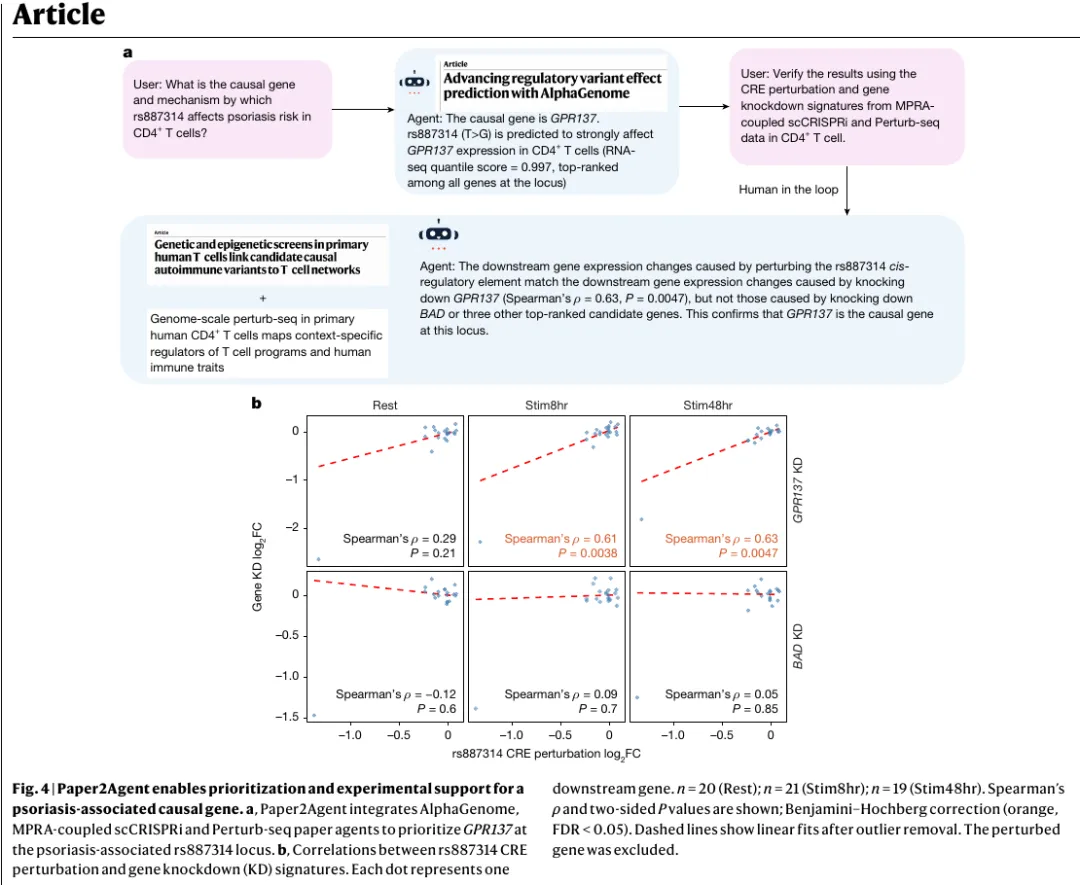
图源:Miao 等,Nature,2026,Fig. 4,DOI: 10.1038/s41586-026-11044-y。保留完整对照、坐标轴、统计量与原图注,仅裁去 PDF 页边空白,未翻译、未标注、未重绘。
这个结果支持 GPR137 是该位点的优先候选,并且作用呈激活依赖。它不是对因果关系的终局证明:数据来自计算预测和既有扰动数据的再整合,仍需要独立实验验证。图中也保留了“human in the loop”——agent 可以提出策略并执行分析,研究者仍要选择问题、判断证据和承担结论责任。
这恰好说明论文智能体最有价值的用法,不是替人宣布答案,而是把分散在不同论文里的方法与数据接起来,形成一条可以检查的分析链。
摘要
Paper2Agent 把论文从静态文本变成包含工具、资源和流程提示的 MCP 服务,并用自动测试筛掉不能稳定运行的工具。AlphaGenome 案例显示,这种封装在既定任务中可以提高准确率和运行效率;规模评估也表明,论文的代码、数据、环境和文档质量决定了它能否被真正复用。多论文协作案例展示了新的分析入口,但科学方向、证据评价和因果结论仍然需要人负责。
Q&A
1. 它和“上传 PDF 问问题”有什么区别?
PDF 问答主要检索和解释文字。Paper2Agent 还会寻找代码库、配置环境、封装函数、生成工作流并执行测试。图 1 展示的是从论文到可调用 MCP server 的过程,而不是单纯的文本问答界面。
2. 74% 的成功率算高吗?
它说明自动化转换已经能覆盖相当一部分开放计算论文,但还远不是“所有论文一键变 agent”。剩余 26% 的失败集中在代码、数据、模型、依赖和脚本泛化问题上。对读者来说,这个失败率也是对当前科研软件可复现性的现实提醒。
3. Fig. 4 是否证明 GPR137 就是银屑病位点的因果基因?
更稳妥的说法是“提供了跨数据集的实验支持,并把 GPR137 提升为优先候选”。相关性只在刺激条件下显著,且分析来自既有数据的整合。独立扰动和机制实验仍然必要。
4. 它可以替代科研人员做判断吗?
不可以。论文明确保留 human-in-the-loop。agent 擅长执行、组合和记录分析;研究者负责提出值得回答的问题、选择验证路线、识别替代解释,并决定证据是否足以支撑结论。
Research Idea:把“能否 agent 化”做成复现性评分
这是我基于论文结果提出的延伸设想,不是原文已经完成的结论。
可以选取同一领域、同一时期的 100-300 篇带代码论文,预先定义五类可复现性指标:环境是否可构建、示例是否可运行、输入输出是否清楚、关键结果是否可重建、脚本能否迁移到新路径或新数据。然后分别让自动 agent 化流程和有经验的研究者复现,比较两者的成功率、耗时、失败原因和判断一致性。
真正有价值的假设是:agent 化失败率能否预测人工复现成本,以及后续代码维护状况?
基线可以包括“只读 README”“通用代码 agent 直接访问仓库”和“人工专家复现”;指标包括首次成功时间、人工干预次数、关键结果偏差、环境漂移后的恢复率。若 agent 化评分与人工复现成本没有稳定关联,或者只反映编程语言与容器配置,那么它就不能被当作通用复现性指标。
这个研究受到论文中 74/100 的成功结果启发,但需要独立数据和预注册的评价规则,不能直接从原文数字外推。
写在最后
Paper2Agent 最值得注意的地方,不是让论文“会说话”,而是把科研 AI 的目标从“把摘要说顺”推进到“把方法跑出来”。
它也反过来审问论文:代码是否完整,环境是否可重建,参数是否说清楚,证据链能否被再次执行?
AI 可以让论文动起来。它该往哪里走、结果能不能信、下一步实验值不值得做,方向盘仍然在人手里。
版权与来源说明
本文论文信息、数据与图片均来自上述 Nature 论文。论文页面标示为 CC BY-NC-ND 4.0;正文图片保留完整面板和原图注,仅裁去 PDF 页边空白以适配阅读,未翻译、未标注、未重绘。详细逐图记录见同目录 图像来源与版权.md。