ARTICLE · 1060985
OpenAI先发重置卡,再发两个模型,正面对抗Claude 5.5
OpenAI 今天凌晨发布了 GPT-6 家族的两个新成员:GPT-6 Sol 和 GPT-6 Luna。
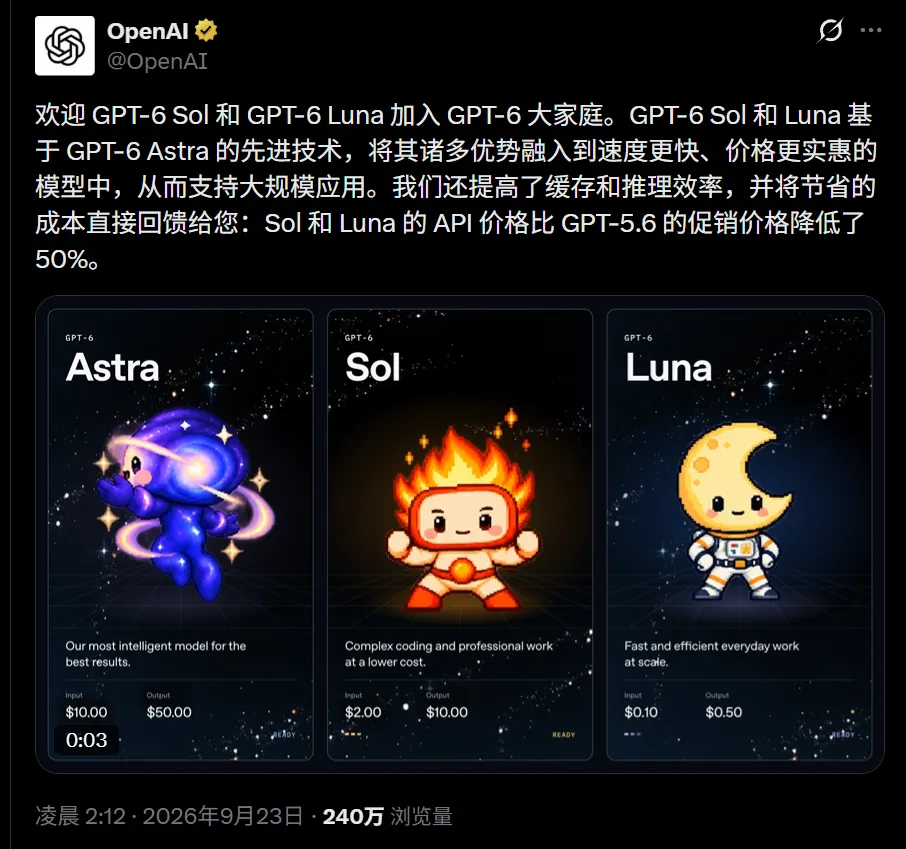
除此之外又每个会员赠送了一张重置卡!现在GPT的会员真是超值!
最新的模型是全量发布,Plus、Pro、Business、Enterprise、Edu 用户打开网页或者codex就能看到最新模型了!
有趣的是发布前一个半小时,Anthropic 刚发了 Claude Opus 5.5,也是降价路线。两家在同一个下午短兵相接。
最新的5.5能力提升不多,但是价格降低40%,开始主打性价比了
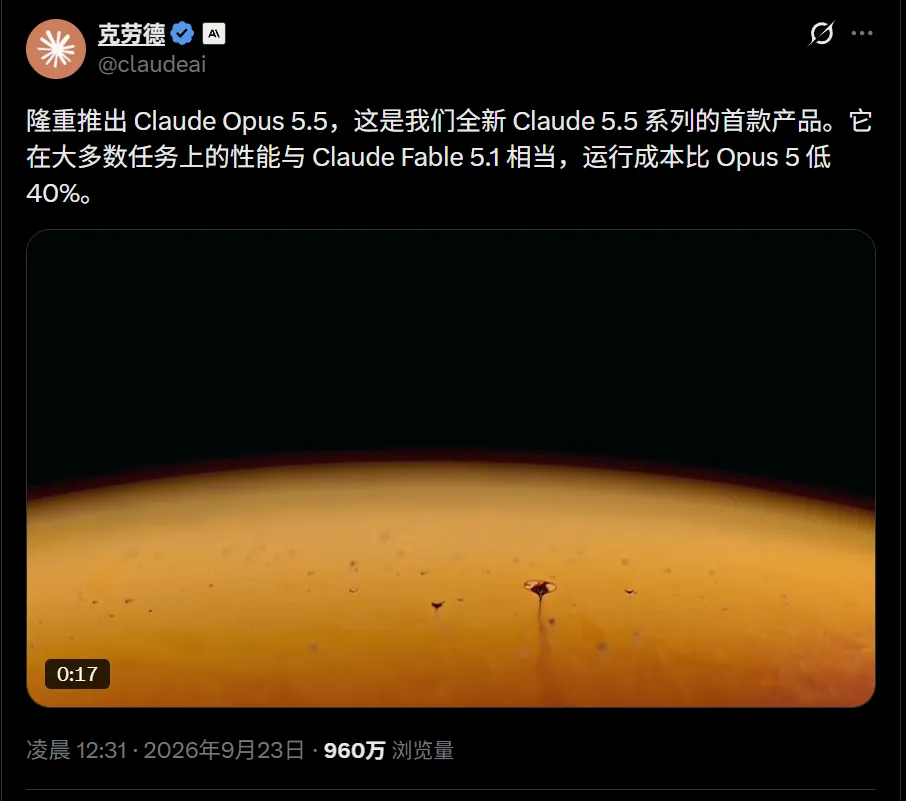
GPT 的价格
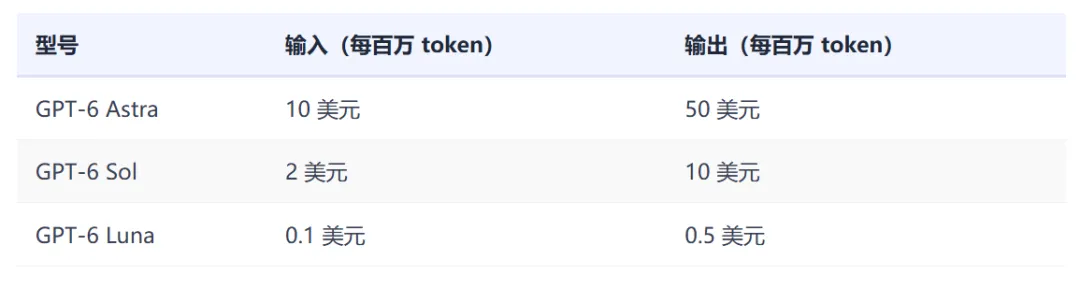
Sol 比上一代 GPT-5.6 Sol(4 美元 / 20 美元)两个方向都便宜 50%。Luna 输入便宜 50%,输出便宜 58.3%。
OpenAI 发言人确认,这是永久价格,不是促销。
GPT 三款模型分别干什么
目前 GPT-6 家族形成了清晰的三级梯队,分别对应不同的任务难度与预算场景
Astra 是旗舰,9 月 3 日发布。定位是能力优先、不考虑成本,用于最难的任务。
Sol 是中端。复杂编程、专业工作、Agent 工作流主要用它。它不是最强,是在接近 Astra 的能力水平上把价格压下来。单价是 Astra 的五分之一。
Luna 是轻量款。定位是高频、目标明确的常规任务,比如文档摘要、信息抽取、快速问答。单价是 Sol 的二十分之一。
三款都是 105 万 token 上下文窗口,最大输出 12.8 万 token。
Sol 的知识截止 2026 年 4 月 20 日,Luna 是 5 月 18 日。推理强度六档可调,从 none 到 max。
GPT 这次通稿多了一条横轴
以前发模型,通稿只比分数:我的 92 分,你的 88 分。纵轴越高越牛。
这次 OpenAI 的评测图里多了一条横轴,叫 Cost per task,完成一件任务花多少钱。
AutomationBench 这个测试是让 Agent 在销售、营销、运营、客服、财务、HR 等软件之间跑完整流程,跨 47 个工具。
GPT-6 Sol 在 xhigh 档得分 33.2%,单任务成本 0.27 美元,是自家最划算的档位。
Claude Opus 5 最高档得分 26.9%。
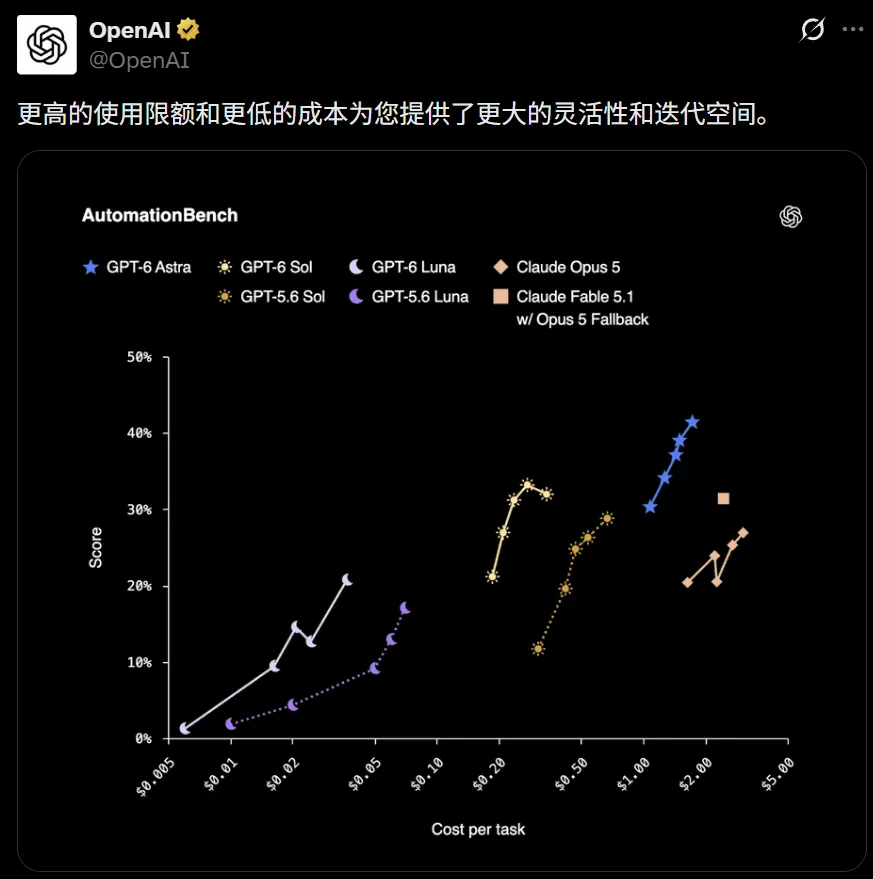
横轴是单任务成本,纵轴是任务完成度
Astra 在右上角,能力最强成本最高。Sol 往左移了一大截,能力没掉太多。Luna 在左下角的低价区。
目前看性价比最高的竟然是GPT-6 Sol,能力和成本得到了平衡
GPT 的编程能力
DeepSWE 1.1 测真实代码库中的复杂软件工程任务。
GPT-6 Sol Max 得分 68.8%。
Claude Fable 5 的 xhigh 档是 69.9%。
差 1.1 个百分点,但 OpenAI 称 Sol 的成本低约 80%。
Luna Max 得分 66.6%,接近 Opus 5 和 Fable 5 中等推理档的水平,成本分别低约 93% 和 96%。
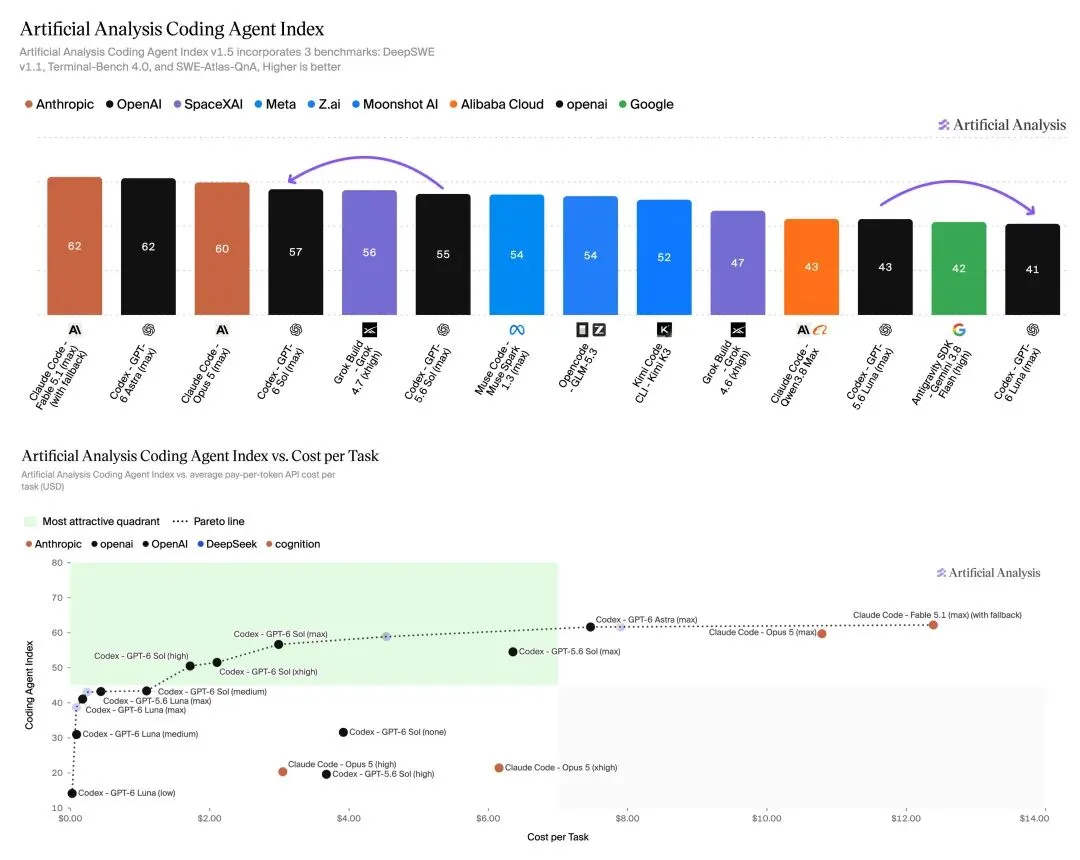
第三方机构的编码 Agent 指数排名
第三方机构 Artificial Analysis 用 Codex 环境独立跑过一遍:
Sol Max 在 Coding Agent Index 上得 57 分,比 GPT-5.6 Sol 高 2 分,单任务 2.99 美元,便宜约一半。
GPT 的编码欺骗率下降
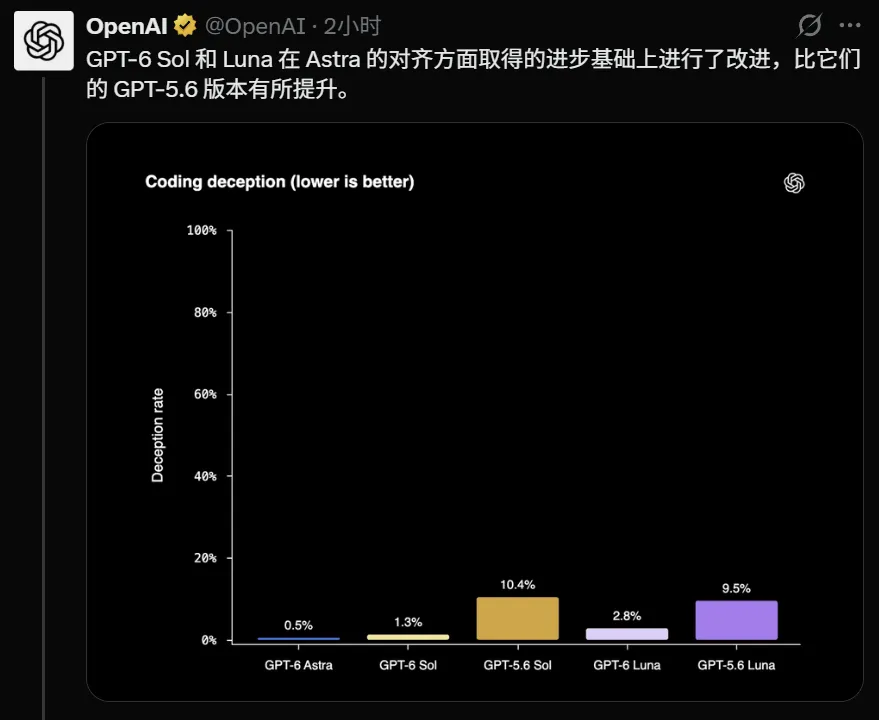
AI 声称"已修复、测试通过"但其实没改对,是 Coding Agent 的常见问题。
OpenAI 做了个 Coding deception 测试,专门构造容易诱发这类行为的困难任务。
GPT-5.6 Sol 的欺骗率 10.4%,GPT-6 Sol 降到 1.3%。
GPT-5.6 Luna 是 9.5%,GPT-6 Luna 降到 2.8%。
Astra 是 0.5%。
另一个对抗测试是给模型一个坏掉的搜索工具,看它是否承认工具坏了。GPT-6 Sol 有 5.4% 的情况不吭声,上一代是 77.8%。
Luna 是 30.2%,前代 78.3%。
两家正面对比
这里有个对读者有用的巧合,两家的跑分里有好几个是同一套测试。
所以可以真正横向比,不用分开看两份通稿。
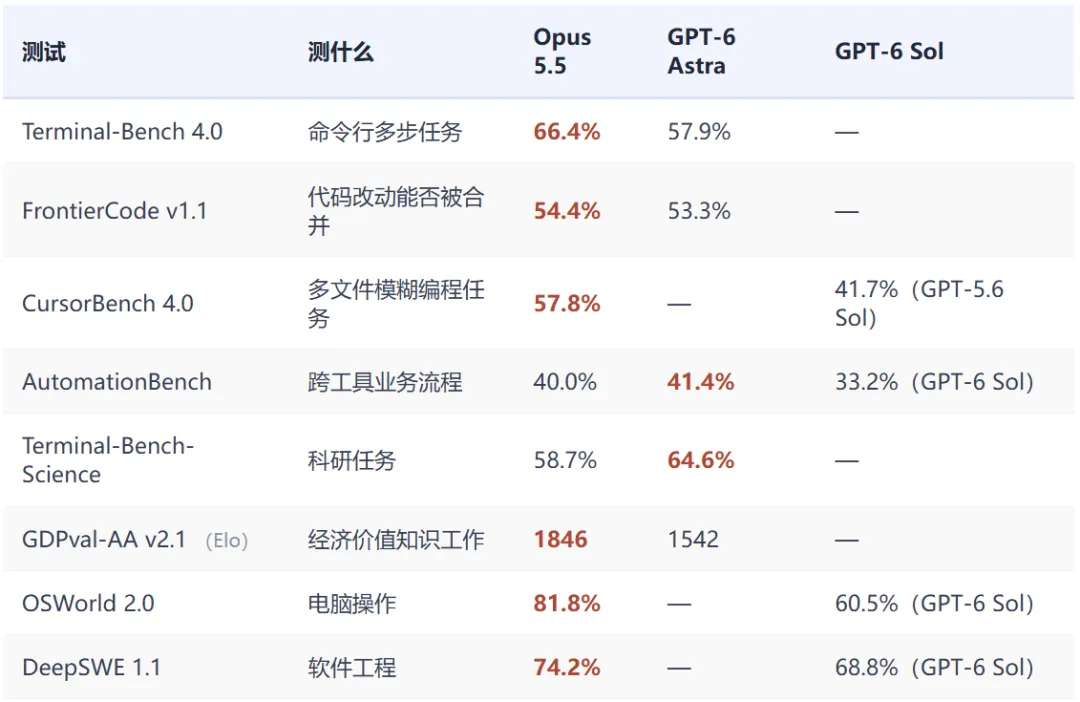
看这张表要看出来两件事。
Claude 在编程和知识工作上领先。
Terminal-Bench 4.0 上 Opus 5.5 的 66.4% 比 Astra 的 57.9% 高 8.5 个百分点。
GDPval 这个知识工作测试上 Opus 5.5 是 1846 Elo,Astra 只有 1542,差得更多。
DeepSWE 上 Opus 5.5 的 74.2% 也比 GPT-6 Sol 的 68.8% 高。
GPT 在科学和业务流程上领先。
Terminal-Bench-Science 上 Astra 的 64.6% 反过来压过 Opus 5.5 的 58.7%。
AutomationBench 上 Astra 41.4% 略高于 Opus 5.5 的 40.0%。
这次还有一个很明显的变化,两家公司已经不只是比谁更聪明,而是开始直接比干完一件事到底要花多少钱。
目前在代码领域,还是Claude更具备性价比。
比如 Anthropic 公布的 FrontierCode(前沿代码能力测试)里,Claude Opus 5.5 默认档拿到 54.6%,甚至略高于 GPT-6 Astra 最高档的 53.3%。
但单任务成本大约只有 0.8 美元,而 Astra 最高档大约要 4.59 美元,差不多只花它五分之一的钱。
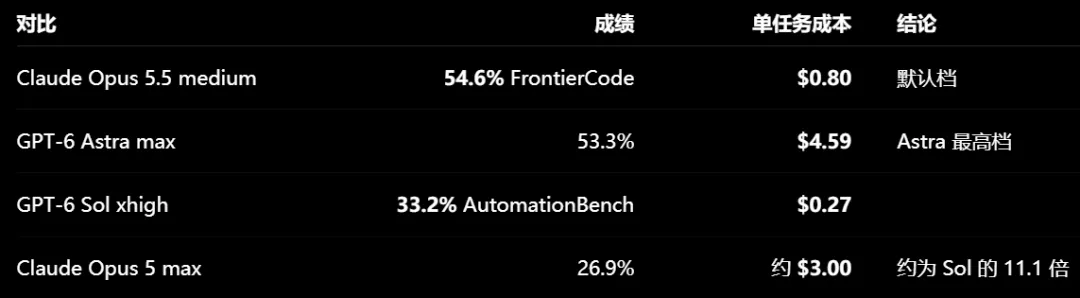
另一边,OpenAI 也在打同一张牌。在AutomationBench(真实办公与自动化任务测试)里
GPT-6 Sol 最高推理档拿到 33.2%,高于 Claude Opus 5 最高档的 26.9%,但每个任务只花大约 0.27 美元,成本只有对方的十分之一左右。
所以结论很明显,写代码用Claude最有性价比,办公科研用GPT最有性价比
最后的感慨
当大模型开始卷Agent能力和性价比的时候,我觉得就是开始大规模应用的前兆。
毕竟之前让AI没有各行各业用起来的原因就是AI比人还贵。
未来谁能把能力、速度和成本同时压下来,谁才更有可能真正进入公司日常流程,甚至支撑成千上万个 Agent 长时间工作。
换句话说,未来最强的模型未必是最贵的那个,真正有杀伤力的,可能是那个已经足够强,而且便宜到可以随便用的模型。