ARTICLE · 1062445
建立属于自己的PDF格式的知识库
前言
通过前面的学习可以发现,我们的目标向量库是由一个在程序中写死的文字片段,如下:
texts = ["阳光洒在脸上,我忍不住笑出声,今天真是美好的一天。","和你一起奔跑在草地上,风都带着甜甜的味道。","放声歌唱吧,让全世界都听见我此刻的快乐。" ]
这在我们日常使用中非常不灵活,一旦文本发生了变动,得将文本重新粘贴到代码当中,再运行程序。有没有一种可能,那就是我们的文本内容非常多,在一个PDF文档中,每次去翻阅这个文档时,都需要手工打开然后查阅,能不能将这个PDF中的文本信息直接向量化,这样我们就可以通过查询关键词的方式检索PDF文档中相关的内容。这个过程我们简化为以下形式:
PDF 文件 ↓ pypdf 提取文字原始长文本 ↓ 按长度切分成 chunk(带重叠)文本块列表 ↓ Ollama 生成向量embeddings ↓ 存入 ChromaDB(带来源元数据)向量库 ↓ 用户查询检索相关 chunk → 拼接 context → 交给大模型回答
读取PDF文件
在读取PDF文件前,我们需要安装名为pypdf的python库:
pipinstallpypdf该库是最轻量的PDF文档读取库,如果PDF文档中是图片形式,在需要寻找其他库以支持,如 pdfplumber 或 pymupdf 。
首先我们定义一个函数,用来读取PDF文件,将文件中所有文本拼接起来:
defextract_text_from_pdf(pdf_path):"""从 PDF 提取所有页的文字,返回拼接后的完整字符串。"""reader = PdfReader(pdf_path)pages = []fori, pageinenumerate(reader.pages):text = page.extract_text() or""iftext.strip():pages.append(text)return"\n".join(pages)
该函数接收PDF路径的参数,为了验证读取效果,我们调用该函数:
if__name__ == '__main__':pdf_text = extract_text_from_pdf("./test.pdf")print(pdf_text)
这里的test.pdf文档是我们的测试文本,运行结果如下所示:
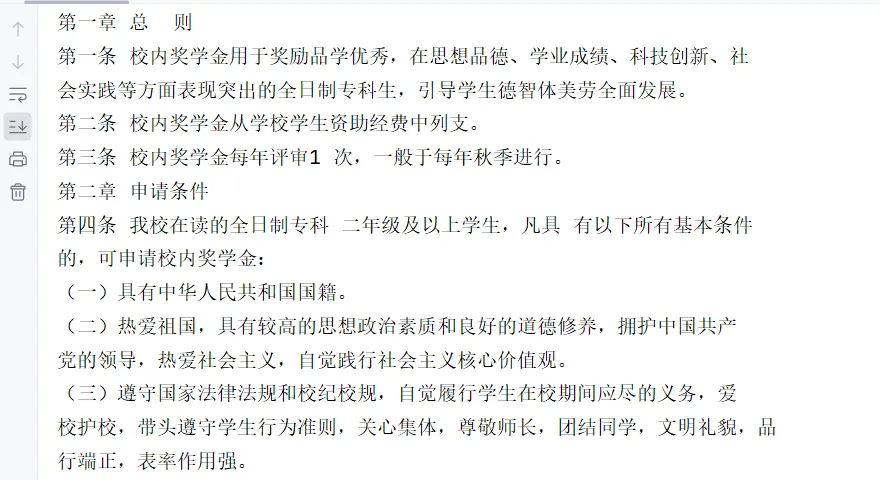
可以发现,我们将PDF文档中的所有文本拼接出来了。如果这些文本都是在一个字符串变量中,那这个字符串会非常大,因此接下来我们对这些文本切片。
文本切片(chunk)
什么是文本切片呢,如何切比较好呢。接下来我们以下面一句话为例:
...我觉得今天天气特别好,适合出去散步...这句话如何切割,既可以保证语义的完整性,又能恰到好处的切片呢。
如果切片大小( chunk_size) 刚好切在"天气"和"特别"之间:
无重叠:chunk1 结尾是"……我觉得今天天气",chunk2 开头是"特别好,适合出去散步……"——两段都缺了关键上下文
有重叠:chunk1 结尾是"……我觉得今天天气特别",chunk2 开头是"今天天气特别好,适合……"——"天气特别好"这个完整语义在两段里都能被检索到
这个时候我们就需要考虑两个切片之间要有一部分的重叠(overlap),这样可以在一定的概率上保持语义的完整性,这就是重叠的意义-- 用少量冗余换取语义完整性 。切片代码如下:
defsplit_text(text, chunk_size=300, overlap=50):""" 按字符数切分文本,带重叠以避免句子被切断后丢失上下文。 Args: chunk_size: 每个 chunk 的目标字符数 overlap: 相邻 chunk 重叠的字符数 Returns: chunk 列表 """# 用来收集切好的所有文本片段,最后作为返回值chunks = []# 当前切片的起始位置(在 text 中的下标),从 0 开始start = 0# 整段文本的总长度,缓存起来避免在循环中反复调用 len()text_len = len(text)# 只要起始位置还没走到文本末尾,就继续切whilestart<text_len:# 计算本次切片的结束位置:# - 正常情况下是 start + chunk_size# - 但如果快接近文本末尾了,就用 text_len,避免越界# min() 保证 end 永远不超过文本实际长度end = min(start+chunk_size, text_len)# 用切片取出 [start, end) 区间的文本# .strip() 去掉首尾空白字符(空格、换行、制表符等)# 这一步很关键:PDF 提取的文本往往带很多换行和空格chunk = text[start:end].strip()# 只有当 chunk 不是空字符串时才加入结果列表# (比如全是空白的片段就没必要存了)ifchunk:chunks.append(chunk)# 如果本次切片已经切到文本末尾(end 等于总长度)# 说明后面没有内容了,直接跳出循环,避免死循环ifend == text_len:break# 计算下一次切片的起始位置:# 从本次 end 往左退 overlap 个字符,形成"重叠区"# 这样相邻两个 chunk 会有 overlap 个字符是重复的# 好处:即使一个句子刚好跨在两个 chunk 边界上,# 两个 chunk 里都能看到这个句子的部分内容,不至于语义丢失start = end-overlap# 返回所有切好的片段returnchunks
接下来同样调用该函数验证效果:
if__name__ == '__main__':pdf_text = extract_text_from_pdf("./test.pdf")print("pdf文本的总长度:", len(pdf_text))chunks=split_text(pdf_text)print("切片之后的长度:", len(chunks))
运行结果如下:
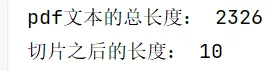
那这个10是怎么得到的呢,公式如下:
chunk 数量 = ceil((text_len - overlap) / (chunk_size - overlap))文本已经切成了10分,接下来就是将这些文本向量化即可
文本向量化
这个步骤其实在前面的教程中已经做过了,这些直接贴出代码:
# ============================================================# 3. 构建 / 更新知识库# ============================================================defbuild_knowledge_base(pdf_path, chunks, collection_name="pdf_kb"):# 3.1 生成向量(Ollama 批量)print("🔢 正在生成向量...")embeddings = ollama.embed(model=embed_model, input=chunks)["embeddings"]# 3.2 存入 ChromaDBchroma_client = chromadb.PersistentClient(path="./db_chroma")# 每次重建:先删掉旧集合,避免 ID 冲突 / 旧数据残留try:chroma_client.delete_collection(collection_name)print(" 已清除旧集合")exceptException:passcollection = chroma_client.get_or_create_collection(name=collection_name,metadata={"hnsw:space": "cosine"} )# ID 用 文件名 + 序号,且带上来源元数据,方便溯源source_name = os.path.basename(pdf_path)collection.add(ids=[f"{source_name}_chunk_{i}"foriinrange(len(chunks))],documents=chunks,embeddings=embeddings,metadatas=[{"source": source_name, "chunk_index": i}foriinrange(len(chunks))] )print(f"✅ 已存入 {len(chunks)} 个 chunk 到集合 [{collection_name}]")returncollection
文本检索,AI回答
前面已经将我们的目标文本向量化了,接下来是将用户输入的文本向量化,然后计算夹角,最后交给AI回答,这个步骤在前面的教程中也已讲过,接下来我们将他封装成一个函数:
# ============================================================# 4. 检索 + 生成回答# ============================================================defask(collection, question, n_results=3):"""检索知识库并让大模型回答。"""# 4.1 查询向量query_embedding = ollama.embed(model=embed_model, input=question )["embeddings"][0]# 4.2 检索results = collection.query(query_embeddings=[query_embedding],n_results=n_results )docs = results["documents"][0]distances = results["distances"][0]# 4.3 距离阈值过滤(余弦距离,越小越相似)filtered = [(d, dist) ford, distinzip(docs, distances) ifdist<0.6]ifnotfiltered:return"没有在知识库中找到相关内容。", []context = "\n\n".join(dford, _infiltered)# 4.4 构建 promptmessages = [ {"role": "system", "content": RAG_PROMPT_TEMPLATE.format(context=context, question=question )}, {"role": "user", "content": question} ]answer = call_AI(messages)returnanswer, filtered
其中的call_AI函数在前面的教程中已定义过,这里不再重复。以上便是以PDF文档为知识库,用户通过输入查询关键词,交给大模型、向量模型、知识库交互的完整过程。
完整代码
importosimportollamaimportchromadbfrompypdfimportPdfReaderfromopenaiimportOpenAI# ---------- 模型配置 ----------model_name = "modelscope.cn/unsloth/Qwen3.5-2B-GGUF"model_url = "http://localhost:11434/v1"model_api_key = "ollama"client = OpenAI(base_url=model_url, api_key=model_api_key)embed_model = "modelscope.cn/raintreasure/nomic-embed-text-v1-GGUF"# ---------- 系统提示词(修掉了原来的引号笔误) ----------RAG_PROMPT_TEMPLATE = """你是一个严谨的问答助手。请严格基于以下文档内容回答问题,禁止编造文档中没有的信息。如果文档中没有相关内容,请回答"根据提供的文档,无法回答该问题"。文档内容:{context}用户问题:{question}"""defcall_AI(messages, model=model_name,temperature=0.3, max_tokens=500):response = client.chat.completions.create(model=model,messages=messages,temperature=temperature,max_tokens=max_tokens,stream=False )returnresponse.choices[0].message.contentdefextract_text_from_pdf(pdf_path):"""从 PDF 提取所有页的文字,返回拼接后的完整字符串。"""reader = PdfReader(pdf_path)pages = []fori, pageinenumerate(reader.pages):text = page.extract_text() or""iftext.strip():pages.append(text)return"\n".join(pages)# ============================================================# 2. 文本切分(chunk)# ============================================================defsplit_text(text, chunk_size=300, overlap=50):""" 按字符数切分文本,带重叠以避免句子被切断后丢失上下文。 Args: chunk_size: 每个 chunk 的目标字符数 overlap: 相邻 chunk 重叠的字符数 Returns: chunk 列表 """chunks = []start = 0text_len = len(text)whilestart<text_len:end = min(start+chunk_size, text_len)chunk = text[start:end].strip()ifchunk:chunks.append(chunk)# 如果已经到末尾就退出,避免死循环ifend == text_len:breakstart = end-overlapreturnchunks# ============================================================# 3. 构建 / 更新知识库# ============================================================defbuild_knowledge_base(pdf_path, chunks, collection_name="pdf_kb"):# 3.1 生成向量(Ollama 批量)print("🔢 正在生成向量...")embeddings = ollama.embed(model=embed_model, input=chunks)["embeddings"]# 3.2 存入 ChromaDBchroma_client = chromadb.PersistentClient(path="./db_chroma")# 每次重建:先删掉旧集合,避免 ID 冲突 / 旧数据残留try:chroma_client.delete_collection(collection_name)print(" 已清除旧集合")exceptException:passcollection = chroma_client.get_or_create_collection(name=collection_name,metadata={"hnsw:space": "cosine"} )# ID 用 文件名 + 序号,且带上来源元数据,方便溯源source_name = os.path.basename(pdf_path)collection.add(ids=[f"{source_name}_chunk_{i}"foriinrange(len(chunks))],documents=chunks,embeddings=embeddings,metadatas=[{"source": source_name, "chunk_index": i}foriinrange(len(chunks))] )print(f"✅ 已存入 {len(chunks)} 个 chunk 到集合 [{collection_name}]")returncollection# ============================================================# 4. 检索 + 生成回答# ============================================================defask(collection, question, n_results=3):"""检索知识库并让大模型回答。"""# 4.1 查询向量query_embedding = ollama.embed(model=embed_model, input=question )["embeddings"][0]# 4.2 检索results = collection.query(query_embeddings=[query_embedding],n_results=n_results )docs = results["documents"][0]distances = results["distances"][0]# 4.3 距离阈值过滤(余弦距离,越小越相似)filtered = [(d, dist) ford, distinzip(docs, distances) ifdist<0.6]ifnotfiltered:return"没有在知识库中找到相关内容。", []context = "\n\n".join(dford, _infiltered)# 4.4 构建 promptmessages = [ {"role": "system", "content": RAG_PROMPT_TEMPLATE.format(context=context, question=question )}, {"role": "user", "content": question} ]answer = call_AI(messages)returnanswer, filteredif__name__ == '__main__':pdf_path = "./test.pdf"pdf_text = extract_text_from_pdf(pdf_path)chunks=split_text(pdf_text)collections = build_knowledge_base(pdf_path,chunks)query="我的综合测评分是92分,请问我能获得几等奖学金"answer, used = ask(collections, query)print(f"\n--- 检索到的 {len(used)} 个片段 ---")fori, (doc, dist) inenumerate(used, 1):print(f"[{i}] (距离 {dist:.3f}) {doc[:80]}...")print(f"\n🤖 回答:\n{answer}")
运行结果如下:
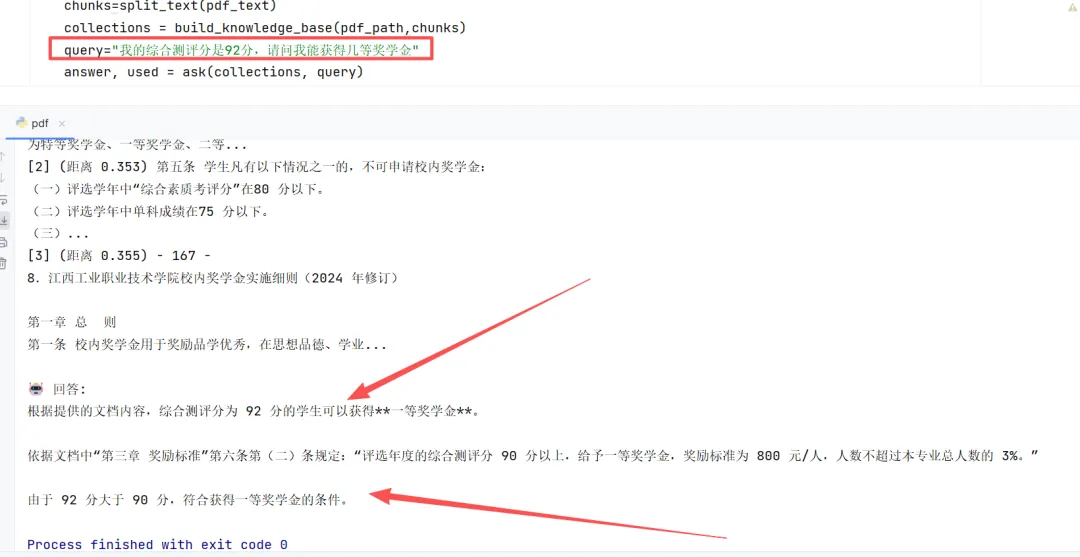
这里我给出的问题是"我的综合测评分是92分,请问我能获得几等奖学金",最终给我的答案如上图所示,与文档中的规定是一致的。不过这里还是有个缺陷的,那就是PDF文档我们在这里是写死的,能不能让用户自己选择PDF文档,然后再进行检索等操作?这个问题交给大家去完成了。
到此为止,我们完成了一个简单的知识库,也就是RAG,这个应用非常广泛,比如智能客服,智能助理这些。不过我们这里只是作为一个demo,离工程化还有距离,但有了这个demo,其实我们已经掌握了人工智能开发的基本思路,在未来的软件开发中,想法,思路更重要,更注重业务流程的熟悉度。接下来你想看什么教程,可以在评论区留言。