ARTICLE · 1069350
AI系列 | 快速理解:三大维度区分预训练与训练模型
将水木上岸设为“星标⭐”
掌握第一手top院校信息
水木上岸自2017年开始辅导清华347应用心理,近年上岸率高达67%-88%,团队的讲师均来自清华大学,本硕博都有,覆盖考研体系中所有课程,我们是心理学领域唯一专业人工智能的团队。
2026考研中,水木上岸21位学员被录取(共29人),占总录取人数72.4%,前五名均为水木上岸学员。
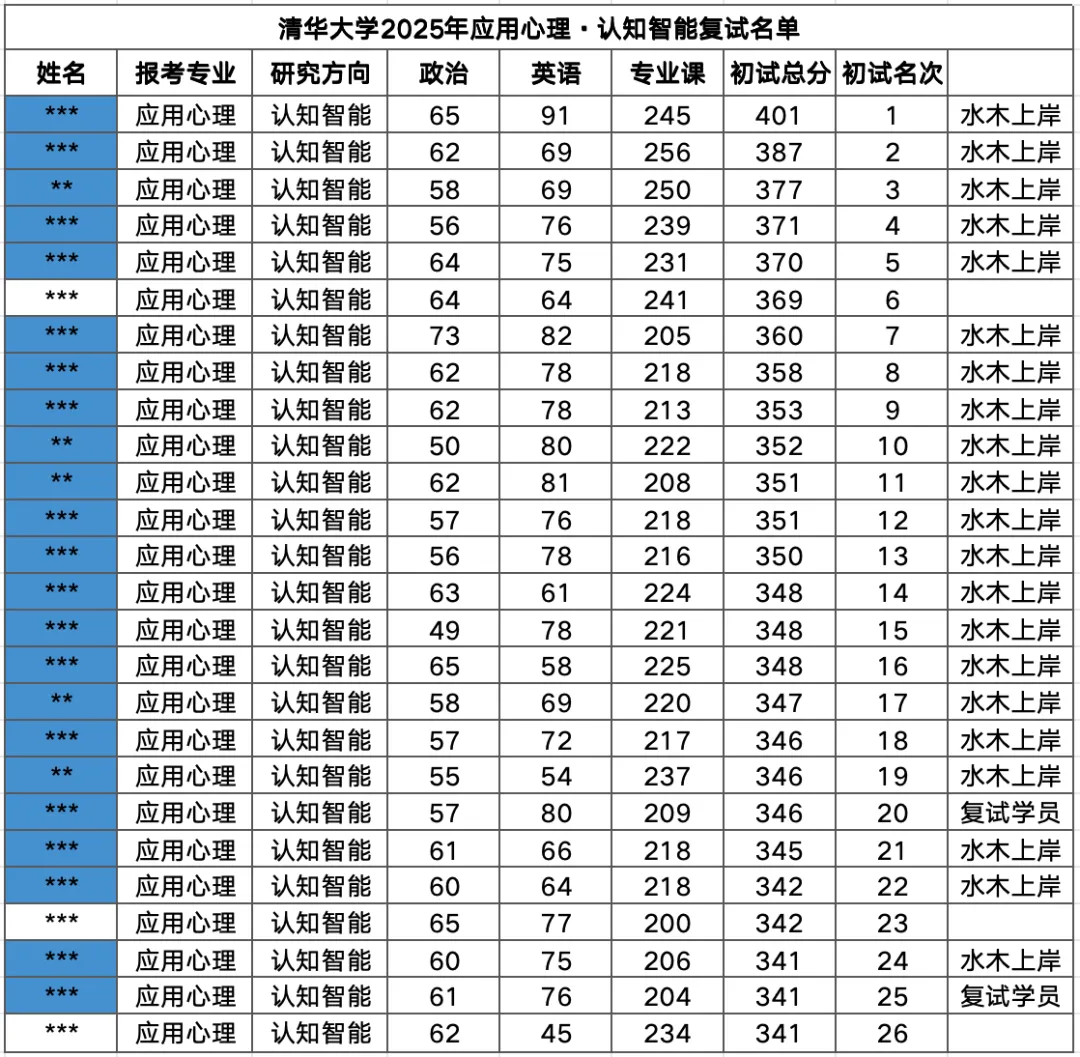
2025考研中,水木上岸21位学员被录取(共录取 24人),占总录取人数88%,前五名均为水木上岸学员(包含总分第一和专业第一)。2024考研中,水木上岸学员录取率67%,其中包含专业第一。
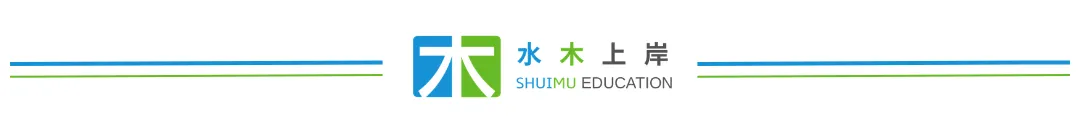
预训练模型与训练模型的本质区别
预训练模型与训练模型的本质区别体现在目标、数据集以及特征侧重等多个方面。
预训练阶段的主要目标是学习通用的特征表示,这一阶段通常使用大规模的无标签数据集,通过捕捉数据中的一般模式和结构,为模型在多种任务上的应用奠定基础,增强其泛化能力。这种通用性使预训练模型在后续的任务中具备初步的知识储备和理解能力。
相对而言,训练阶段则专注于特定任务的优化。此时,模型利用有标签的数据集,根据具体任务的目标函数(如分类准确率或回归误差)进行参数调整。通过监督学习方法,训练阶段将预训练中获得的通用知识具体化,以满足目标任务的需求。
在数据集使用上,预训练阶段主要依赖于大规模无标签数据,如数百万张图像或互联网海量文本,这些数据为模型提供了丰富的信息以学习普遍特征。而训练阶段则使用明确标注的任务数据,每个样本都附有标签,用于引导模型学习输入与输出目标之间的关系。
在特征侧重方面,预训练模型通过无监督或自监督学习,提取出数据的通用特征,为后续任务提供良好的初始化参数。在训练阶段,这些参数通过进一步调整,使模型更适应具体任务的需求。预训练阶段提供了广泛的基础能力,而训练阶段则是将这些能力应用于特定任务,从而完成模型的精细优化。
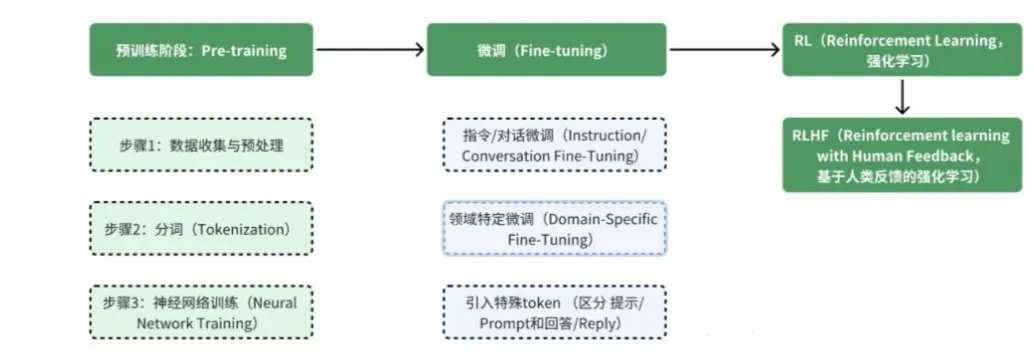
迁移学习
预训练模型的一个主要目标是支持迁移学习。迁移学习是一种机器学习策略,通过将一个任务中学到的知识迁移到另一个相关任务中,来提高新任务的学习效率和性能。然而,这种策略通常基于一个前提假设:训练数据和迁移数据的分布相同。如果这一假设不成立,则训练集上学到的模型在迁移数据集上的表现可能会大打折扣。在许多实际应用场景中,标注数据的获取成本非常高,往往难以为目标任务准备足够多、与其分布完全一致的训练数据。
为解决这一问题,迁移学习提出了一种新的思路:如果一个相关任务已经拥有大量的训练数据,即使这些数据的分布与目标任务有所不同,由于其规模较大,也可以假设其中包含某些能够泛化的知识。这些知识在目标任务中可能仍然具有一定的帮助。迁移学习的核心目标就是探索如何将相关任务中的可泛化知识迁移到目标任务上,使得模型能够在目标任务上表现更为优异。
迁移学习不仅有效解决了数据不足问题,还在多个应用场景中展现了强大的适应性。例如,在自然语言处理和计算机视觉中,预训练模型通过在大规模数据集上的训练,学习到广泛适用的特征表示,这些表示随后可以迁移到许多下游任务上,通过微调迅速达到良好的性能。迁移学习的成功显著降低了对标注数据的依赖,为机器学习在实际应用中的广泛普及提供了重要支持。
2026清华复试名单与所报水木上岸班型
2025清华复试名单
往期精选
【26水木上岸40位学员进入清华复试】
【26水木上岸20位学长学姐经验分享】
对话清华347高分学姐:从暑期迷茫到复试通关,如何逆袭上岸?
工作一年再战清华347,423分学姐五个月极限上岸经验全公开
(持续更新中)
【清华录取通知书】
【26喜报】
公众号安利
水木上岸官方总号
由水木上岸学术团队打造的"智能心理测量"公众号,是心理学与人工智能深度交融的先锋平台。我们以"用算法解析心智,以科技赋能心灵"为使命,聚焦AI+心理学的跨学科创新,持续追踪全球顶尖实验室的科研动态,为读者搭建认知升级的智识桥梁。
水木上岸联合清华计算机系AI团队
推出了
心理学考研版 AI 助教
24 小时答疑