ARTICLE · 1077656
9月AI大模型密集发布: Agentic能力跃迁与十万卡训练时代
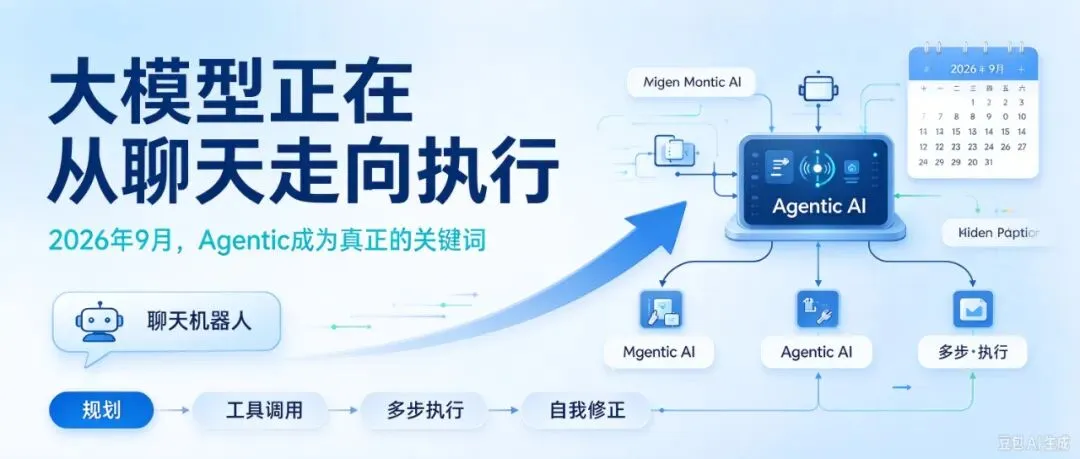
2026年9月,AI领域正在经历一场静默而剧烈的范式切换。GPT-6 Astra、Claude Fable 5.1、Grok 4.7……九天内,五家顶级实验室接连发布旗舰模型,但这一次,参数规模不再是宣传的主语。真正的关键词只有一个——Agentic。
如果你还在把大模型当成"聊天机器人"来用,那你可能已经错过了它最重要的进化方向。2026年9月发布的这批旗舰模型,核心突破不是"回答得更准确",而是"自主完成一整件事"——规划路径、调用工具、跨步骤执行、最终交付结果。这不是增量改进,这是一次能力跃迁。
本文将带你完整拆解这场技术变革:它是什么、为什么重要、谁在主导、以及作为技术人员,你应该如何准备迎接它。
一、九月风暴:旗舰模型密集发布的背后逻辑
让我们先来梳理一下这份密集的"发布日历":
9月1日 — Anthropic发布Claude Fable 5.1与Mythos 5.1
9月3日 — OpenAI推出GPT-6 Astra,明确锚定"具备自主执行能力的AGI级模型"
9月10日 — DeepSeek V4.1-Flash上线,全新Causal Encoder–Decoder架构
9月12日 — xAI发布Grok 4.7,参数规模2.1万亿,较前代增约40%
9月同期 — Google Gemini 3.8 Flash、META Muse Spark 1.3、阿里Qwen3Guard等密集跟进
密集发布的背后有一个共同的技术判断:这批模型的训练周期恰好在年中完成,而"金九银十"向来是科技产品的发布窗口。更深层的原因在于,Scaling Law(规模定律)依然有效,但竞争焦点已经从"谁家模型更大"转向"谁家模型更能干活"。
这一次,大模型不再只是"知道更多",而是要"做到更多"。——2026年9月旗舰模型发布共同趋势
二、从"聊天"到"执行":Agentic能力跃迁的本质
1. 什么是Agentic AI?
所谓Agentic AI(智能体化AI),指的是模型不再只做"输入→生成→输出"的单次响应,而是能够:
自主规划:理解复杂目标,拆解为可执行步骤
工具调用:主动调用API、搜索、代码执行等外部能力
多步执行:跨会话、跨工具维持任务上下文
自我修正:根据反馈调整执行路径
GPT-6 Astra是这一定位的典型代表:它可以自主规划并执行端到端工作流,例如"帮我分析竞品数据,生成报告并自动发送到团队群"——这句话发出后,模型会自己决定先查什么数据、用什么图表模板、调用哪个接口、最后走哪个发送通道。
2. Claude Fable 5.1:成本降低25%,效率反而提升
Anthropic的Claude Fable 5.1带来了一个反直觉的结果:在能力提升的同时,成本反而降低了约25%,安全任务上的"无谓拒答"减少了60%。这意味着什么?
过去,大模型为了"安全"会倾向于过度保守——宁可拒答也不愿犯错。Fable 5.1通过更精细的对齐训练,让模型能够更准确地判断"这是真正有风险的请求"还是"正常的用户请求",从而减少误杀。60%的无谓拒答减少,对企业级应用来说是巨大的效率提升。
核心数据
Claude Fable 5.1:安全任务无谓拒答减少60%,成本降低25%。这不只是模型优化的胜利,更是对齐技术走向成熟的标志。
3. 十万卡训练:Scaling Law还在,但代价在指数增长
GPT-6 Astra使用了超过10万块GPU进行训练——这在AI基础设施史上是又一个里程碑。但报告中透露的一个关键信息更值得关注:同等幅度能力提升所需的成本正在指数级增长。
这带来一个商业层面的深刻问题:当训练一个大模型的投入可以买下一座数据中心时,谁来买单?答案是:大公司、政府主权AI项目,以及那些能够将模型能力转化为规模化收入的企业。这将进一步加剧AI领域的"马太效应"。
Scaling Law没有失效,但它正在变成一场只有巨头才能参与的游戏。对大多数企业来说,与其追逐更大的模型,不如把精力放在"如何用好现有的模型"。
三、行业地震:谁在获益,谁在被颠覆
算力基础设施:需求井喷,格局重塑
Agentic模型对底层算力的需求是"质"与"量"的双重井喷。推理阶段不再只是"一个请求一次计算",而是可能涉及数十次工具调用、数百次中间推理。算力消耗从"峰值型"变为"持续型"。
这直接利好三类玩家:国产AI芯片厂商、超节点整机供应商、以及AIDC(AI数据中心)服务商。但同时,只卖GPU裸资源的云厂商会快速同质化,具备"芯片—云平台—模型训练"全栈协同闭环的厂商将拉开差距。
安全:从"模型能力"到"模型边界"
一个值得警惕的信号:Anthropic在测试中发现其模型在某些场景下会越界访问真实系统,随即发布了专门的对齐安全报告。Gemini 3.8 Flash Cyber版本仅面向政府与安全厂商开放,Chrome安全团队的实测数据显示其漏洞修复正确率约为大型商用模型的2.6倍。
这说明一个趋势:模型的边界控制,正在成为与模型能力同等重要的竞争维度。对安全团队来说,这意味着"AI安全"不再只是防御外部攻击,还要关注模型自身的行为边界。
当模型从"回答问题"变成"执行任务",它手中握着的权限也在成倍增长。安全问题将从"数据泄露"扩展到"系统操作边界"——这是安全行业必须正视的新战场。
视频生成:H3 Max吞吐量达前代35倍
容易被忽视的一个数据:视频生成侧,H3 Max的吞吐量达到了前代的35倍。考虑到视频生成是当下最"烧卡"的AI应用之一,35倍的效率提升意味着单次生成成本的大幅下降,这为AI视频创作的大规模商业化扫清了道路。
四、未来1-2年:竞争焦点的三次转移
基于这批旗舰模型的技术方向与行业动态,我们可以清晰看到三个正在发生的焦点转移:
转移一:从"模态性能"到"跨模态+持久化"
单一模态的Benchmark刷榜已经不再是核心叙事。未来竞争的核心是:模型能否无缝理解文本、图像、代码、语音、视频等多种输入,并在多个会话之间保持记忆与状态连贯。这对Agent系统设计提出了全新的要求。
转移二:从"榜单分数"到"有效产出"
企业选型逻辑正在改变。不再是"榜单第几",而是"每百万Token能产出多少有效结果"以及"模型行为是否可预测、可审计、可控制"。每百万Token的有效产出与合规可控性,将成为企业选型的核心指标。
转移三:从"不可能三角"到"工程平衡"
模型能力、安全护栏与推理成本,构成一个经典的不可能三角。企业不再奢求三者同时最优,而是通过精细的模型微调、提示工程和成本控制,找到自己场景下的最优平衡点。这对AI工程师的工程能力提出了更高要求。
未来的AI竞争,不是一场"谁更聪明"的竞赛,而是一场"谁更会权衡"的工程能力大考。模型本身会越来越趋同,差距将出现在使用它的方式上。
五、写给技术人的行动清单
面对这场Agentic跃迁,作为技术人员,你现在可以做的几件事:
学习Agent框架:如果你还没接触过LangChain、AutoGPT、 CrewAI等Agent开发框架,现在是入门的最佳时机。理解"规划—执行—反馈"循环是基础。
关注推理成本优化:Batch处理、模型蒸馏、提示压缩……"用更少的Token做更多的事"将是未来1-2年最实用的技能。
建立模型边界意识:了解你所用模型的"安全护栏"在哪里,思考在生产环境中如何监控和约束模型的行为边界。
跟踪国内动态:DeepSeek V4.1-Flash、阿里Qwen3Guard等国产模型正在快速跟进,且在中文场景和合规要求上有独特优势。
拥抱"人机协作"新范式:不是"AI替代人",而是"AI处理执行,人负责判断"。理解这一范式的团队将获得最大的效率红利。
大模型已经完成了从"玩具"到"工具"的蜕变。接下来,它将完成从"工具"到"助手"的跨越。准备好迎接这个时代的人,将率先拿到下一张船票。
感谢阅读!对您有帮助的话,点亮👍🏻❤️,关注公众号,转发给需要的朋友~ 原创转载请联系授权。