ARTICLE · 1085636
4亿人在用的 AI App,到底哪个值得用?我用Python画了张"性价比图"
你的手机里,装了几个 AI?
9 月的科技圈格外热闹:OpenAI 发了 GPT-6 Astra,Claude 出了 Fable 5.1,DeepSeek 一边涨价一边推 V4.1 Flash,通义千问的 Qwen3.8 号称"训练成本降了 90%";字节的豆包更夸张,6 月月活冲到 3.82 亿,同比涨了 172%,稳坐国内 AI App 第一。
每次这种新闻下面,评论区都在吵同一个问题:到底哪个好用?吵是吵不出结果的。这一篇,我们把 9 月公开发布的第三方数据抓进 DataFrame,画两张图:一张看"谁用的人最多",一张看"谁最划算"。图看完,答案你自己就有。
数据来源文中均已标注,为 QuestMobile、易观千帆及公开报道口径,仅作教学演示,各家数据机构统计方法不同,绝对值会有出入。
第一张图:AI App 月活排行榜
先看用户规模。易观千帆 7 月数据里,国内 AI 原生 App 的月活格局大致是这样:
import pandas as pdimport matplotlib.pyplot as pltplt.rcParams['font.sans-serif'] = ['SimHei']plt.rcParams['axes.unicode_minus'] = False# 易观千帆2026年7月数据(单位:万)apps = pd.DataFrame({'App': ['豆包', '千问', 'DeepSeek', '元宝', '文小言', 'Kimi'],'月活': [33800, 14500, 9417, 8870, 5200, 4100],})apps = apps.sort_values('月活')apps['份额'] = (apps['月活'] / apps['月活'].sum()).round(3)plt.figure(figsize=(8, 4))plt.barh(apps['App'], apps['月活'], color='steelblue')for i, (v, s) in enumerate(zip(apps['月活'], apps['份额'])):plt.text(v + 300, i, f'{v/10000:.2f}亿 ({s:.1%})', va='center')plt.title('国内 AI 原生 App 月活(2026年7月,易观千帆)')plt.xlabel('月活(万)')plt.xlim(0, 42000)plt.show()
运行结果:
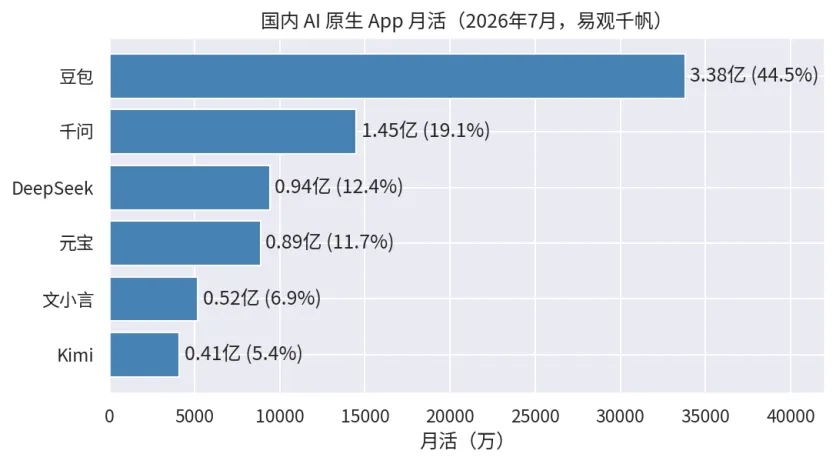
三个直观结论:豆包一家占了前五名总和的一半左右,是真·断层;DeepSeek 一个靠技术出圈的选手硬挤进前三,证明"模型强"本身就能拉用户;整个 AI 原生 App 行业月活 5.77 亿、渗透率 52.6%——也就是说,每两个手机网民里就有一个在用 AI。两年前这个数字还几乎可以忽略。
但注意一个细节:有规模不等于有粘性。数据里千问的人均单日启动次数是 2.58 次,而一些 AI 陪伴类 App 能到 8 次以上。看 App 数据只看月活,就像看公众号只看清一色的阅读量——第 13 篇讲的"看量再看率",在这里变成"看规模再看粘性"。
第二张图:大模型的"能力-价格"性价比
普通用户看 App,想进阶的人早晚会碰到 API 定价。9 月这波新模型里,有两组公开数据特别值得放在一起看:
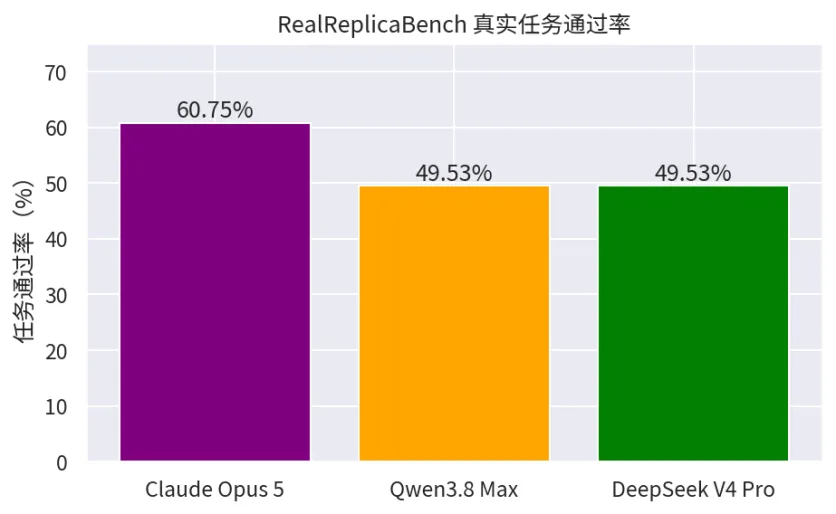
能力侧,第三方真实电商任务榜单 RealReplicaBench 的通过率:
# RealReplicaBench 真实电商任务通过率(2026年9月公开榜单)bench = pd.DataFrame({'模型': ['Claude Opus 5', 'Qwen3.8 Max', 'DeepSeek V4 Pro'],'通过率': [60.75, 49.53, 49.53],})plt.figure(figsize=(7, 4))plt.bar(bench['模型'], bench['通过率'], color=['purple', 'orange', 'green'])for i, v in enumerate(bench['通过率']):plt.text(i, v + 1, f'{v}%', ha='center')plt.ylim(0, 75)plt.ylabel('任务通过率(%)')plt.title('RealReplicaBench 真实任务通过率')plt.show()
运行结果:
价格侧,按 9 月各家官方定价(输入侧,人民币元/百万 token,美元按汇率约算):
price = pd.DataFrame({'模型': ['Qwen3.8-Flash', 'DeepSeek V4.1', 'GPT-6 Astra', 'Claude Opus 系'],'输入价格': [1, 4, 71, 107], # 元/百万token,约数})print(price.assign(倍差=(price['输入价格'] / price['输入价格'].min()).round(0)))
运行结果:
模型 输入价格 倍差0 Qwen3.8-Flash 1 1.01 DeepSeek V4.1 4 4.02 GPT-6 Astra 71 71.03 Claude Opus 系 107 107.0
最贵的和最便宜的,输入价格差了约 100 倍——而通过率的差距远没有 100 倍。国产模型的策略很清楚:Qwen3.8-Flash 把价格打到对手的 3%,用"够用 + 极便宜"抢市场。这和手机行业当年的剧情如出一辙:旗舰机秀肌肉,走量的永远是中端机。
给普通用户的翻译版本:日常问答、写文案、改代码,排行榜 50% 通过率的模型和 60% 的,你大概率用不出区别;但账单上 100 倍的差价是实实在在的。学数据分析的意义就在这里——广告给你看的是"最强",数据给你看的是"够用且便宜"。
用数据的眼光,再看一遍 9 月的 AI 新闻
把三张图连起来,9 月的 AI 行业其实只讲了一件事:用户规模战打完上半场,价格战开始打下半场。豆包靠抖音的流量池把月活做到近 4 亿;DeepSeek 一边涨价(8 月刚调过价、搞峰谷计费)一边发新款,说明算力成本压力真实存在;Qwen 把成本砍 90% 再打价格牌。每一步动作,在数据里都留有痕迹。
以后再看科技新闻,建议你养成这个反射:先问"数字是谁发的、口径是什么、跟谁比",再决定要不要激动。这是这个 18 篇系列真正想交给你的东西,比任何一个函数都值钱。
小结与练习
这一篇蹭着 AI 热点,练了这些内容:
sort_values排序 + 横向条形图 barh,做排行榜;新增"份额"派生列,把绝对值换算成占比; 分组对比"能力 vs 价格",用倍差( 列 / 列.min())代替形容词;最重要的思维习惯:问口径、问基线、问跟谁比。
小练习:QuestMobile 口径里豆包 6 月月活 3.823 亿,同比 +172.1%。反推一下去年 6 月豆包的月活大约是多少?提示:3.823 / (1 + 1.721),想一想为什么不是直接乘。
数据来源:QuestMobile、易观千帆 2026 年 7 月报告、RealReplicaBench 公开榜单及各家官方定价,截至 2026 年 9 月。关注公众号,开启零基础学习python数据分析!