ARTICLE · 1098079
十四、RAG 入门与文档加载给大模型装外挂知识库
LANGCHAIN 30 篇精讲 · 第 14 篇
RAG 入门与文档加载给大模型装外挂知识库
RAG 五步流程 · 文档加载器 · Document 对象
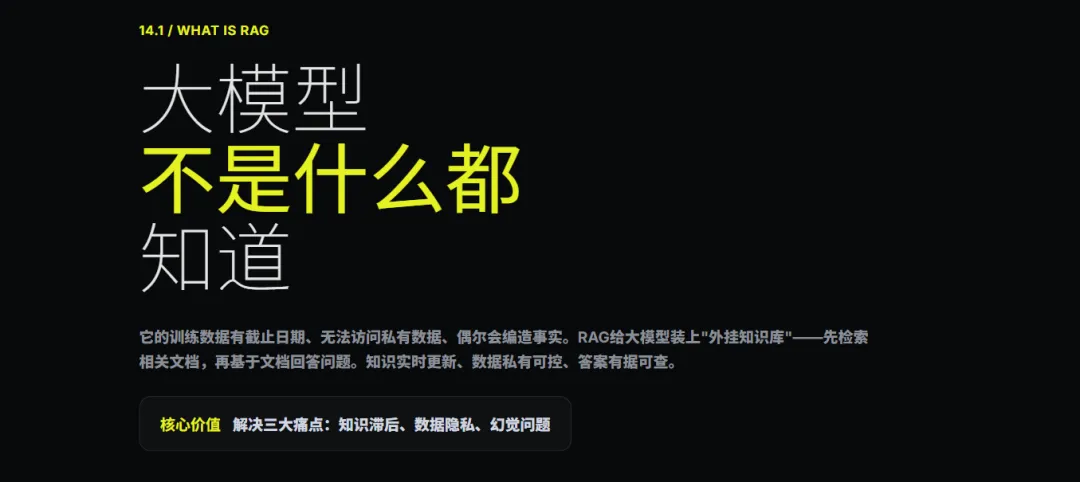
问 ChatGPT 你们公司上周发布的产品手册里写了什么,它答不上来。这不是它的错——它压根没见过那份文件。
大模型有三个绕不过去的坎:训练数据有截止日期、看不到你的私有数据、偶尔还会一本正经地编造事实。
RAG 的思路很朴素:既然模型不知道,那就先去把相关资料找出来,连同问题一起交给它,让它"看着材料答题"。知识能实时更新,数据留在自己手里,答案有据可查。
1
五步流程,两个阶段
整个 RAG 系统可以理解成两个阶段:前面三步是"建库",后两步是"用库"。建库只做一次,用库每次都跑:
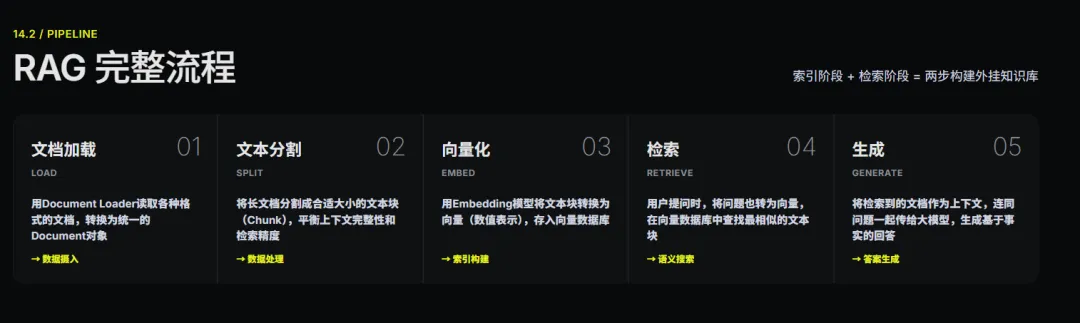
01 文档加载 · 数据摄入
用加载器读取各种格式的文档,统一转换成 Document 对象。这一步是整条链路的地基。
02 文本分割 · 数据处理
长文档切成合适大小的文本块,在上下文完整性和检索精度之间找平衡。这一步决定 RAG 的上限。
03 向量化 · 索引构建
用 Embedding 模型把每个文本块转成向量,存进向量数据库。到这里"外挂知识库"就建好了。
04 检索 · 语义搜索
用户提问时,把问题也转成向量,在库里找最相似的几个文本块。注意是"找意思相近的",不是"找字面相同的"。
05 生成 · 答案产出
检索到的文档作为上下文,连同问题一起交给大模型,生成有依据的回答。
2
先搞懂 Document 这个统一格式
不管你的资料原来是 PDF、Word 还是网页,加载完之后都会变成同一种东西——Document 对象。它只有两个核心字段:
page_content · 文本内容
文档的正文字符串,后面所有处理都在这个字段上做。
metadata · 元数据字典
文件名、页码、作者、时间等信息。别小看它,后面做检索过滤全靠这些字段。
统一成 Document 的好处是:后续的分割、向量化、检索代码完全不用关心原始格式。你的知识库里可以同时躺着 PDF、Markdown 和网页,下游处理逻辑一模一样。
3
四个加载器,覆盖常见场景
不用记太多,这四个能应付绝大多数情况:
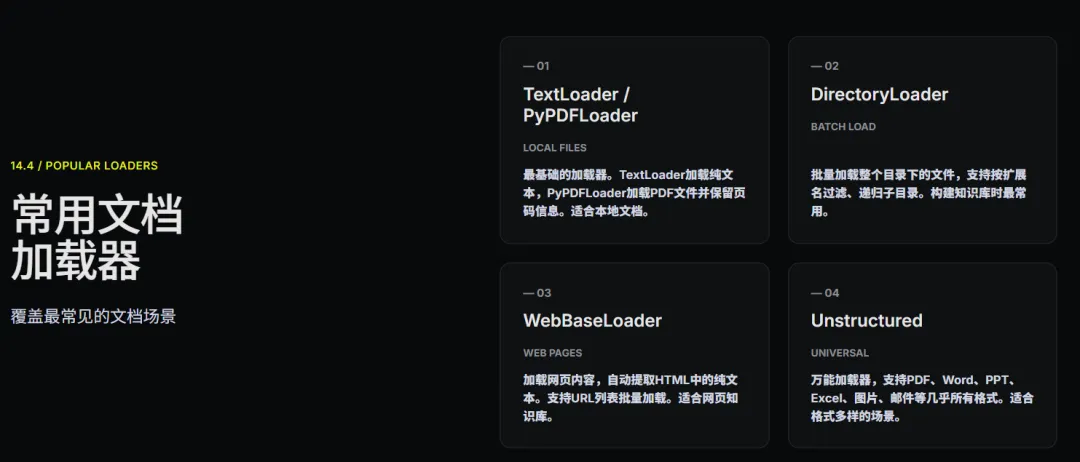
TextLoader / PyPDFLoader 最基础的两个,分别加载纯文本和 PDF,PDF 会保留页码信息
DirectoryLoader 批量加载整个目录,支持按扩展名过滤和递归子目录,建知识库最常用
WebBaseLoader 加载网页,自动提取 HTML 里的纯文本,支持批量 URL
Unstructured 万能选手,PDF、Word、PPT、Excel、邮件几乎通吃,适合格式五花八门的场景
from langchain_community.document_loaders import (PyPDFLoader, DirectoryLoader, TextLoader)# 加载单个 PDFloader = PyPDFLoader("./docs/manual.pdf")pages = loader.load()print(f"共 {len(pages)} 页")print(pages[0].metadata) # {'source': 'manual.pdf', 'page': 0}# 批量加载目录下所有 Markdownloader = DirectoryLoader("./docs/kb/", glob="**/*.md",loader_cls=TextLoader, show_progress=True,)docs = loader.load()
加载阶段最常翻车的三件事 一、扫描版 PDF 其实是图片,必须上 OCR,直连加载器出来是空的;二、PDF 表格容易丢格式,建议优先喂 Markdown 或 HTML;三、中文文档务必确认 UTF-8 编码,否则整库乱码。另外,加载完一定要抽检几份,看看内容完整不完整——这一步偷懒,后面调检索会调到怀疑人生。
下篇预告
文档加载进来了,但整本书塞不进模型,得切开。下篇讲文本分割与向量化——切多大、留多少重叠、用什么模型转向量,这些细节直接决定 RAG 好不好用。
本篇要点回顾
解决三痛|知识滞后、数据隐私、事实幻觉
五步流程|加载 → 分割 → 向量化 → 检索 → 生成
统一格式|page_content + metadata
四个加载器|Text/PyPDF、Directory、Web、Unstructured
这是「LangChain 30 篇精讲」系列的第 14 篇后续 16 篇将持续更新,欢迎关注