ARTICLE · 1104531
AI 时代的可信测量:从生成变量到有效推断
论文解读:Melissa Dell 与 Ashesh Rambachan,The Measurement Revolution? Credible Measurement and Inference in the Age of AI
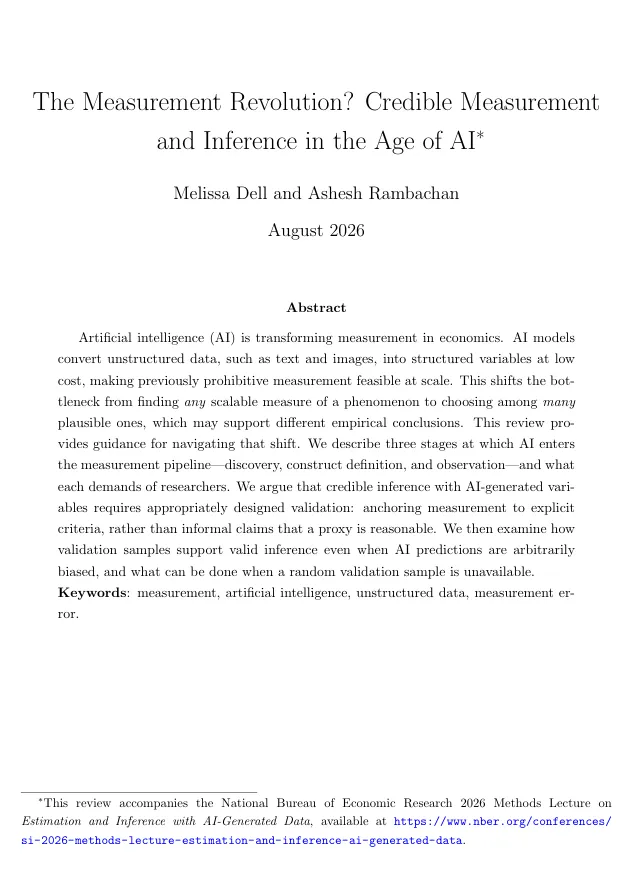 论文首页:标题、作者与摘要
当 AI 能把海量文本、图片和音频迅速变成变量,研究的瓶颈就从“没有数据”变成了“凭什么相信这个测量”。
过去,实证研究常常卡在一个朴素的问题上:想研究的东西,没有可用的变量。
一份历史报纸有多“悲观”?一张卫星图像反映了多少贫困或污染?一段政策文本表达了多强的不确定性?材料并不少,但它们以文本、图片、音频和视频等非结构化形式存在,很难低成本地转成可分析的数据。
大模型和计算机视觉改变了这件事。研究者只需设计提示词或分类规则,就能为成千上万篇文档打标签,把海量图像压缩成连续指标。
但 Melissa Dell 与 Ashesh Rambachan 在 2026 年的综述论文《The Measurement Revolution?》中提醒:
AI 降低的是规模化测量的成本,却把可信度问题推到了研究流程的更前端。
当同一个概念可以由不同模型、提示词、训练数据和聚合方式生成许多“看起来合理”的变量,真正的问题就变成了:为什么选择这个指标?它究竟测到了什么?换一个模型或提示词,结论会不会改变?
这篇论文试图回答的正是:AI 生成的变量,怎样才能进入可信的实证推断?
01AI 让测量从稀缺走向过剩
测量不是从现实中直接抄下一个客观数字。经济与社会世界复杂而高维,研究者必须选择保留哪些信息,再把现实压缩成一个可解释、可分析的变量。
过去,建立一套能够大规模执行的测量规则很昂贵。研究者常常只能接受现成的代理变量,即使它与真正关心的理论概念并不完全一致。
AI 改变了成本结构。它可以低成本编码问卷、新闻和历史档案,也能从卫星影像中提取贫困、植被或污染等指标。研究者还可以近乎零成本地更换模型、提示词、示例和标签体系。
候选测量因此从稀缺变成过剩。
风险也随之变化。过去,研究者可能通过不断更换控制变量和样本来挑选有利结果;现在,还可以先尝试许多变量生成方法,再选择结果最“漂亮”的一种。
论文把这类风险类比为测量选择式 p-hacking:不必改回归,只需换一种提示词或模型,估计的幅度、显著性甚至符号都可能改变。
所以,AI 时代最重要的问题不只是模型准不准,而是研究者如何约束测量选择,并说明这个变量为什么值得相信。
02一项 AI 测量要过三道关
论文把测量拆成三个阶段:发现、构念定义和观测。
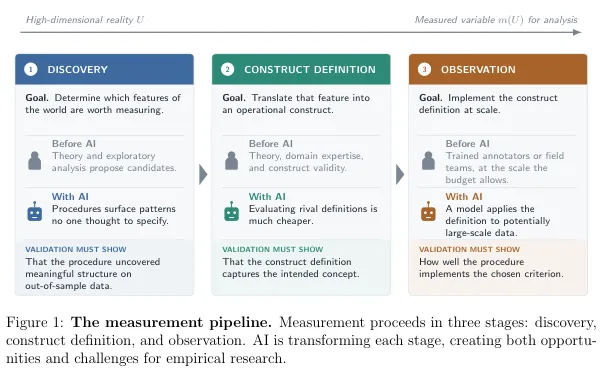 论文 Figure 1:测量流水线
三个阶段面对不同的不确定性,不能只靠一个 accuracy 指标统一验证。
2.1发现与定义
发现要回答的是:究竟值得测什么?
AI 能从文本、图像和其他高维材料中发现研究者没有事先命名的模式,帮助生成新的研究假设。但这些模式必须在留出样本中重新检验。发现出来的结构只是候选概念,不能直接当成成熟变量。
构念定义要回答的是:这个概念到底指什么?
信任、制度质量、政策不确定性等概念无法直接观察。研究者必须先写清楚什么算、什么不算,它应与哪些变量相关,又必须与哪些相邻概念区分。
AI 可以快速生成许多貌似合理的定义,却不能替研究者决定哪一种定义真正回答了研究问题。一个模型也可能非常稳定地执行一套错误定义,因此“输出稳定”不等于“测量正确”。
2.2观测与验证
定义明确后,AI 才真正成为一种可扩展的测量工具:把同一套规则应用到大量文本或图像上,生成进入分析的变量。
这时需要区分两个问题:
- 构念效度:尺子的刻度代表的是不是我们真正想研究的东西;
- 观测效度:这把尺子在重复使用时,是否忠实执行既定标准。
验证的目的不是证明某个指标代表“终极真理”,也不是认定人类标签天然正确,而是把模型输出锚定到一套明确、可审计、可重复的标准。
多个模型给出相似答案,也不能替代验证。前沿模型可能共享架构、训练语料和对齐方式,因此可能在同一批样本上犯同一种错误。模型一致既可能因为它们都测对了,也可能因为它们具有相关偏误。
03可信推断的关键是验证样本
论文在统计方法上最有启发的一步,是把 AI 变量重新理解为一个缺失数据问题。
假设研究者拥有全体样本的原始文本或图像,但真正想使用的结构化变量,只在一小部分样本中经过高质量人工或仪器测量。AI 对其余样本的预测,本质上是一种插补。
关键是:插补值不能直接当成真实值。
更稳妥的做法是:先用全体样本的 AI 预测获得规模和效率,再用随机验证样本中“高质量标签与 AI 预测的差异”修正系统偏误。
只要验证设计满足相应条件,AI 预测可以存在偏差,校正后的估计仍然能够有效。但必须同时满足三项要求:
- 验证标签来自研究者愿意捍卫的测量规则;
- 验证样本能够代表目标总体,或在控制抽样变量后具有可比性;
- 各类观察都有机会进入验证样本,不能把某些类型永久排除。
论文因此并不是说“模型准确度不重要”。更准确的表述是:
在验证和纠偏设计正确时,准确度主要决定估计有多精确,而不是估计是否有效。
模型越准,验证误差的波动越小,置信区间通常越窄。模型很差时,AI 带来的效率增益会缩小,研究最终仍主要依赖高质量验证数据。
这也说明,accuracy、F1 和 AUC 只是预测指标,不能直接回答下游回归系数是否可信。
3.1三种验证条件,三种结论强度
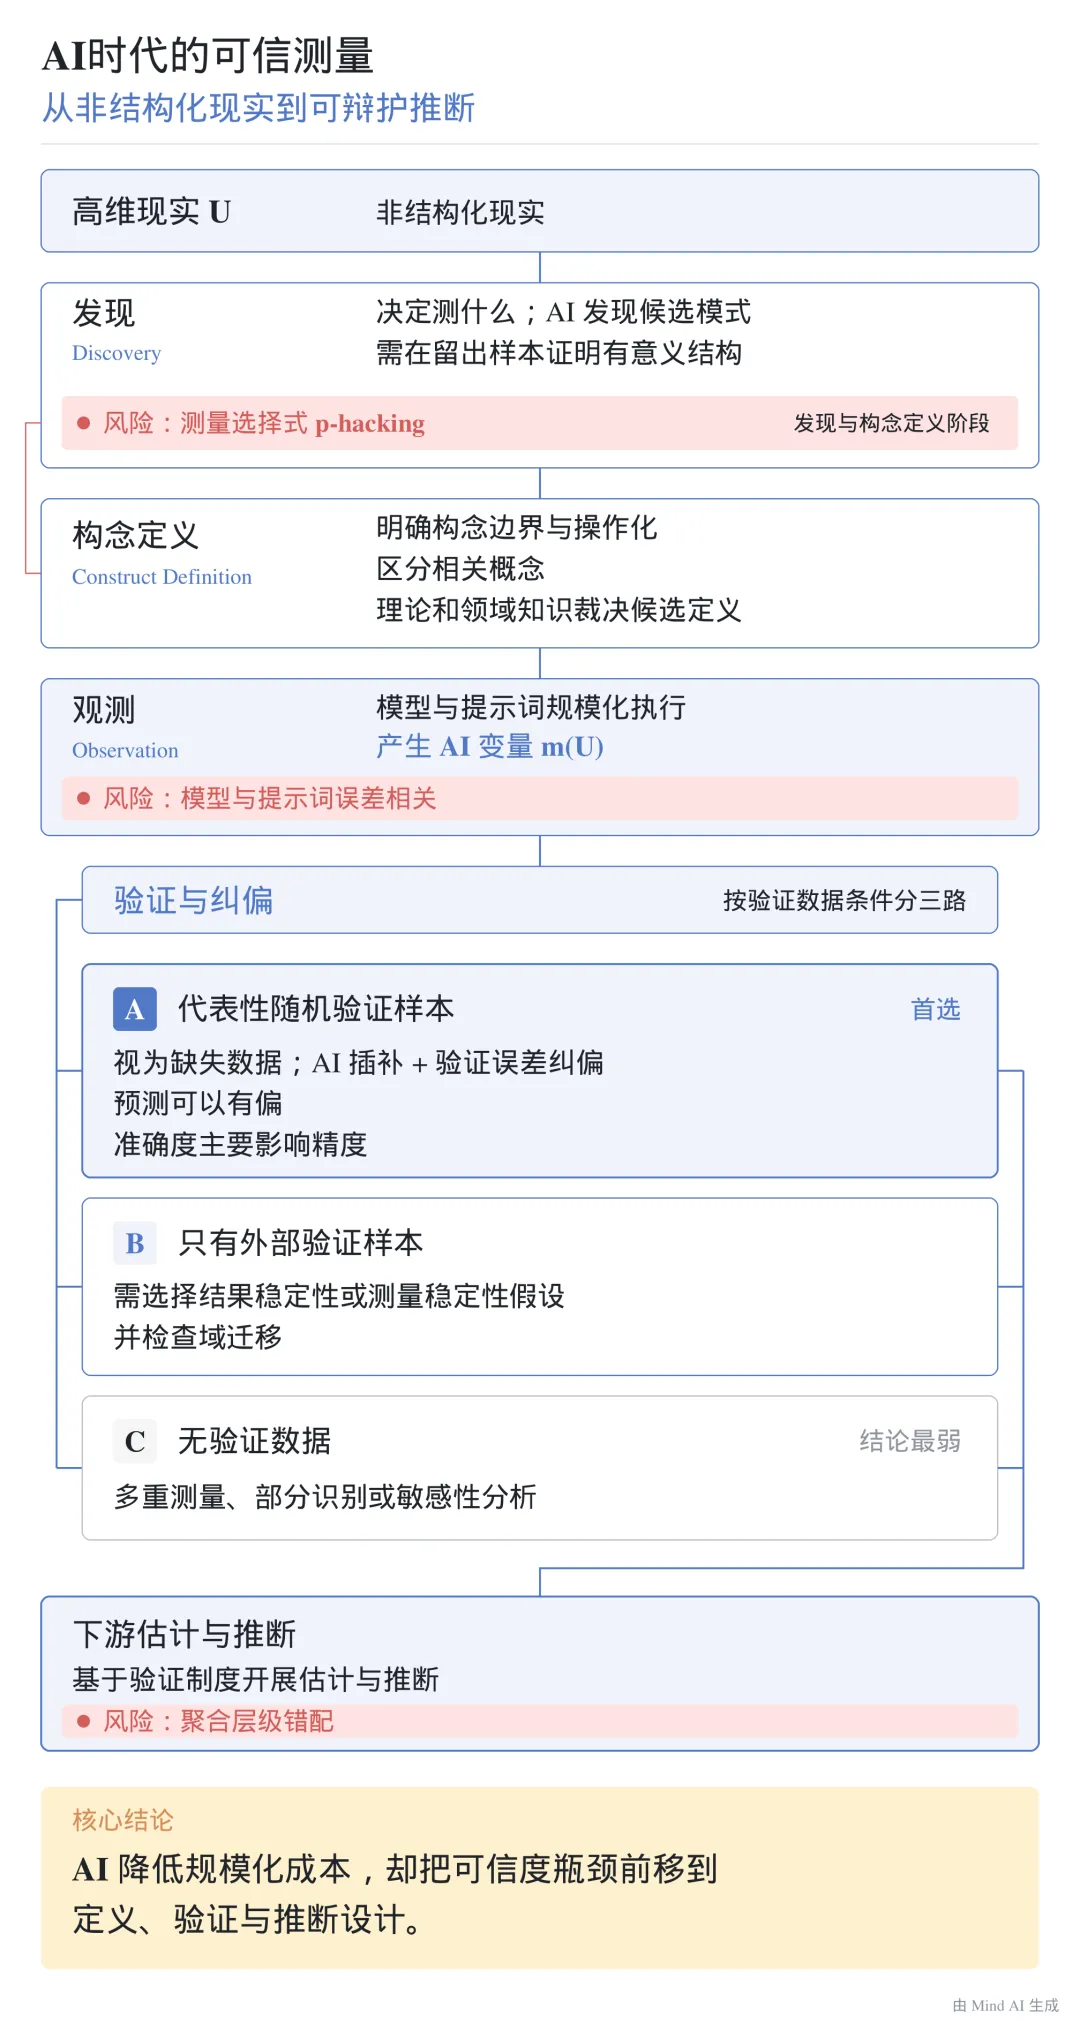 AI 时代可信测量路线图
AI 扩大测量规模,结论的可信度则取决于定义、验证制度与推断方法。图由 MindAI 根据论文框架生成。
有代表性验证样本是最理想的情形。研究者可以直接从当前分析总体中学习模型如何出错,再把误差校正到最终估计中。这条路径最少依赖对黑箱模型内部机制的猜测。
只有外部验证样本时,例如标签来自另一个地区、时期或人群,就必须额外说明什么关系能够跨样本保持稳定:是真实标签与预测之间的关系稳定,还是模型错误率稳定?地区差异、传感器变化和模型升级都可能破坏这些假设。
完全没有验证数据时,只能依赖更强的识别假设、部分识别或敏感性分析。多个模型并不天然等于多份独立信息,因为它们的错误可能高度相关。此时,AI 测量更适合探索和生成假设,不应包装成与随机验证设计同等强度的确认性证据。
聚合也不会自动解决问题。若模型对某类文本、地区或时期存在系统偏误,把逐条预测平均成年份或地区指标,仍可能保留偏差。研究者需要说明验证发生在哪一层,变量最终又在哪一层进入估计。
04这篇论文真正留下了什么
这是一篇综述,价值不在于提出一个万能估计量,而在于建立了一套判断 AI 测量是否可信的共同语言。
对正在使用大模型构造变量的研究者,最值得带走的是五条原则:
- 先定义,再调用模型。 不要让模型输出反过来定义研究对象。
- 把模型与提示词选择当成研究设计。 保存模型版本、完整提示词、参数和原始输出。
- 让验证集服务于下游估计。 不只报告准确率,还要说明抽样方式和覆盖范围。
- 让测量误差进入推断。 AI 变量在模型中扮演什么角色,会影响所需的校正方法。
- 让结论强度匹配证据。 当前样本有代表性验证数据、只有外部数据、完全无验证数据,是三个不同的可信度等级。
论文也留下了明确边界。现有统计方法主要集中在“观测”阶段;发现与构念定义仍高度依赖理论和领域知识。高质量验证标准本身可能有争议,模型误差如何跨地区和时期迁移,也仍是开放问题。
如果说上一轮信息技术革命让研究者学会约束“回归规格的自由度”,那么这一轮 AI 测量革命要求我们进一步约束“变量生成的自由度”。
AI 可以替我们规模化地读材料、看图像和打标签,却不能替我们决定什么值得测、什么算测对,以及一个结论究竟凭什么可信。
05参考文献
- 论文:Melissa Dell and Ashesh Rambachan, The Measurement Revolution? Credible Measurement and Inference in the Age of AI, August 2026,arXiv:2608.23524。