ARTICLE · 1144128
关于安卓微信小微解读图片功能的 Bug 分析
关于安卓微信小微解读图片功能的 Bug 分析
微信小微最近推出了一系列和图片相关的功能。 我简单做了以下测试。 图片来源 公园自拍 测试结果 正常图片可以解读,没问题。 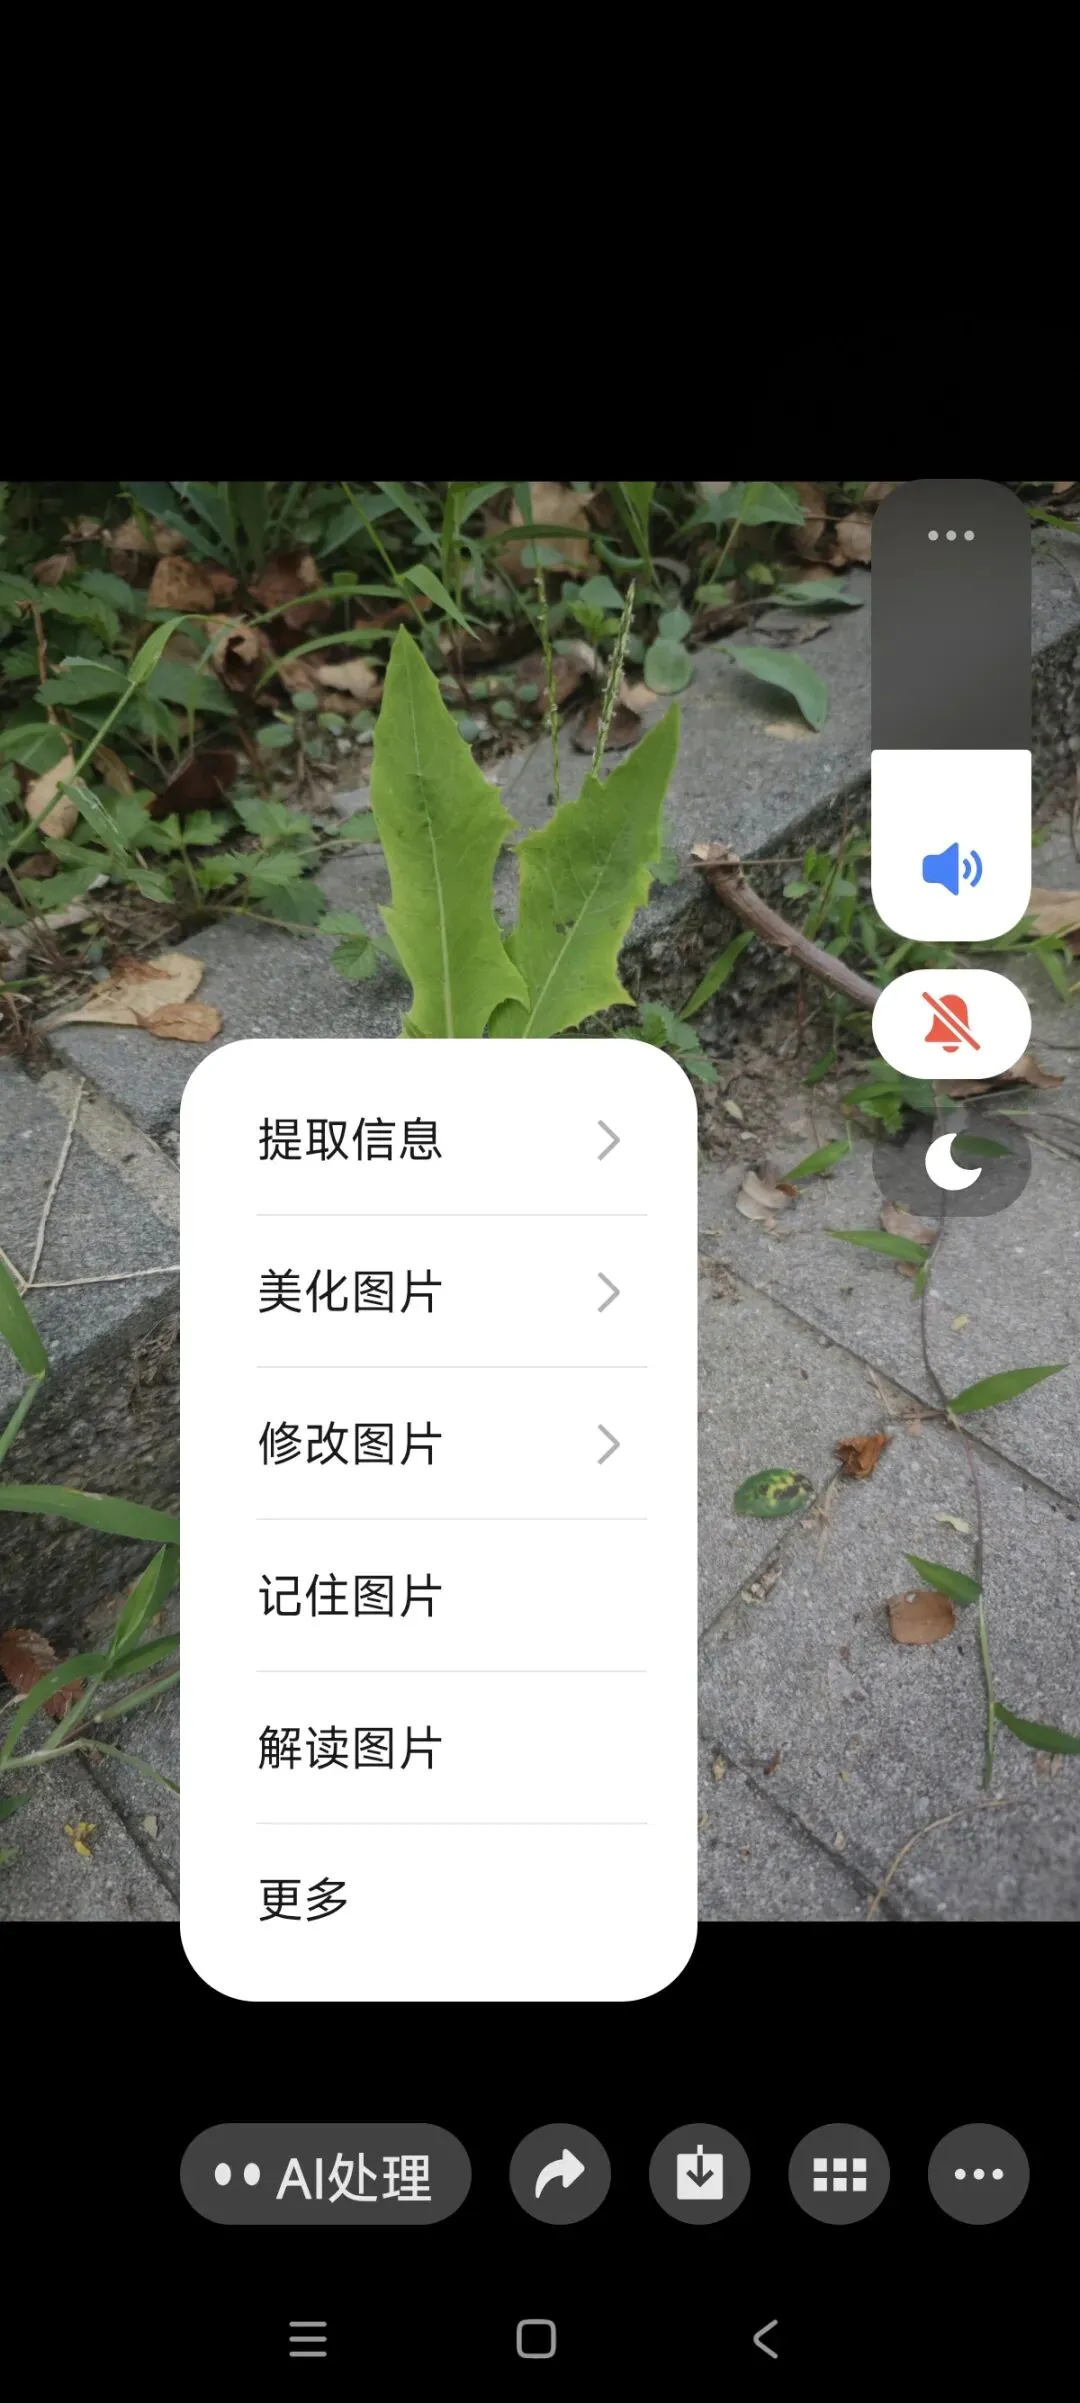
解读结果如下 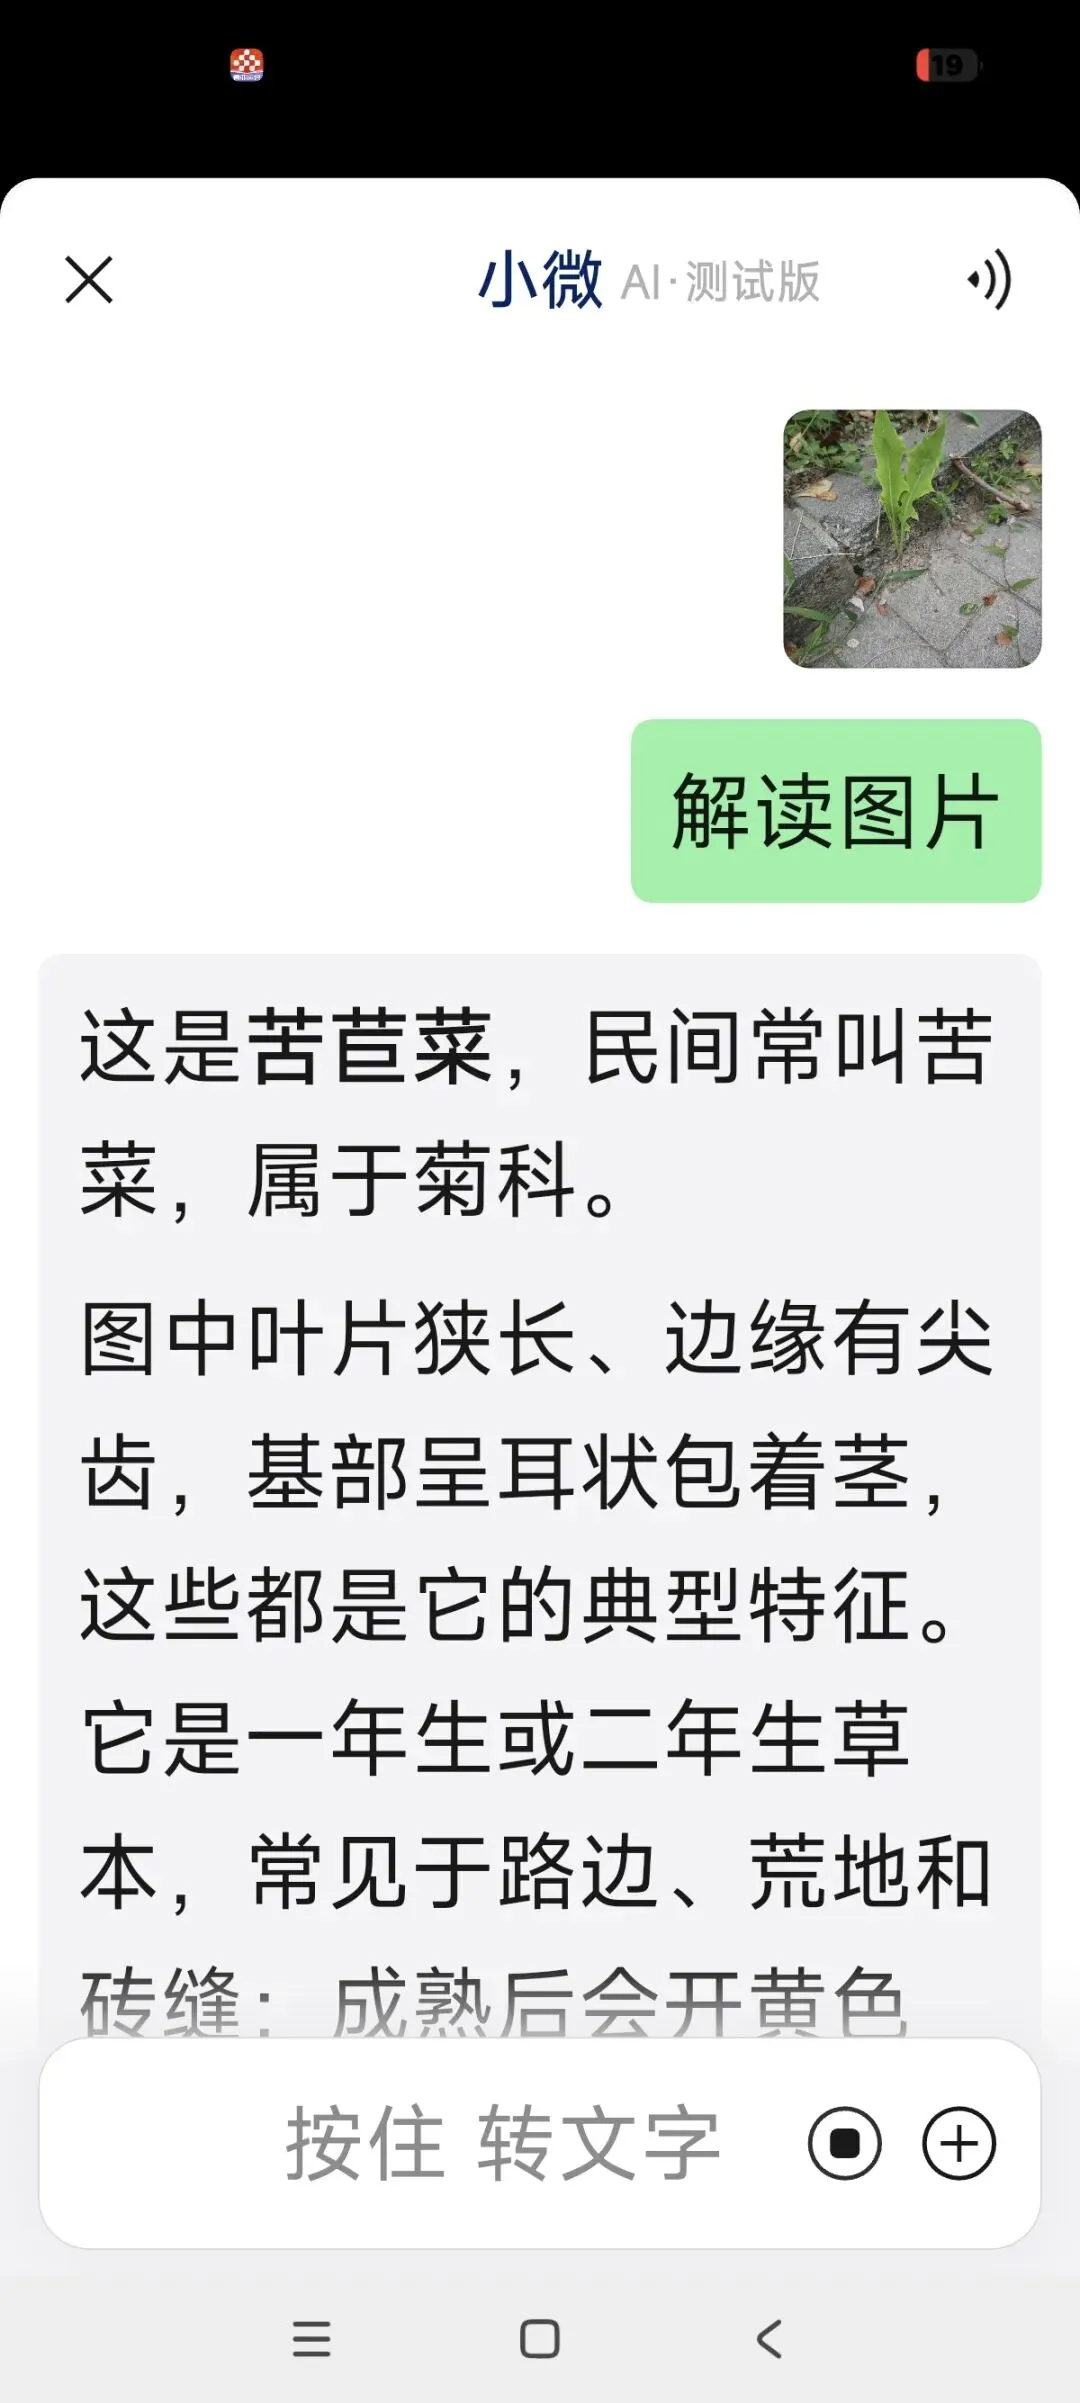
图片来源 手机截屏 测试结果 失败 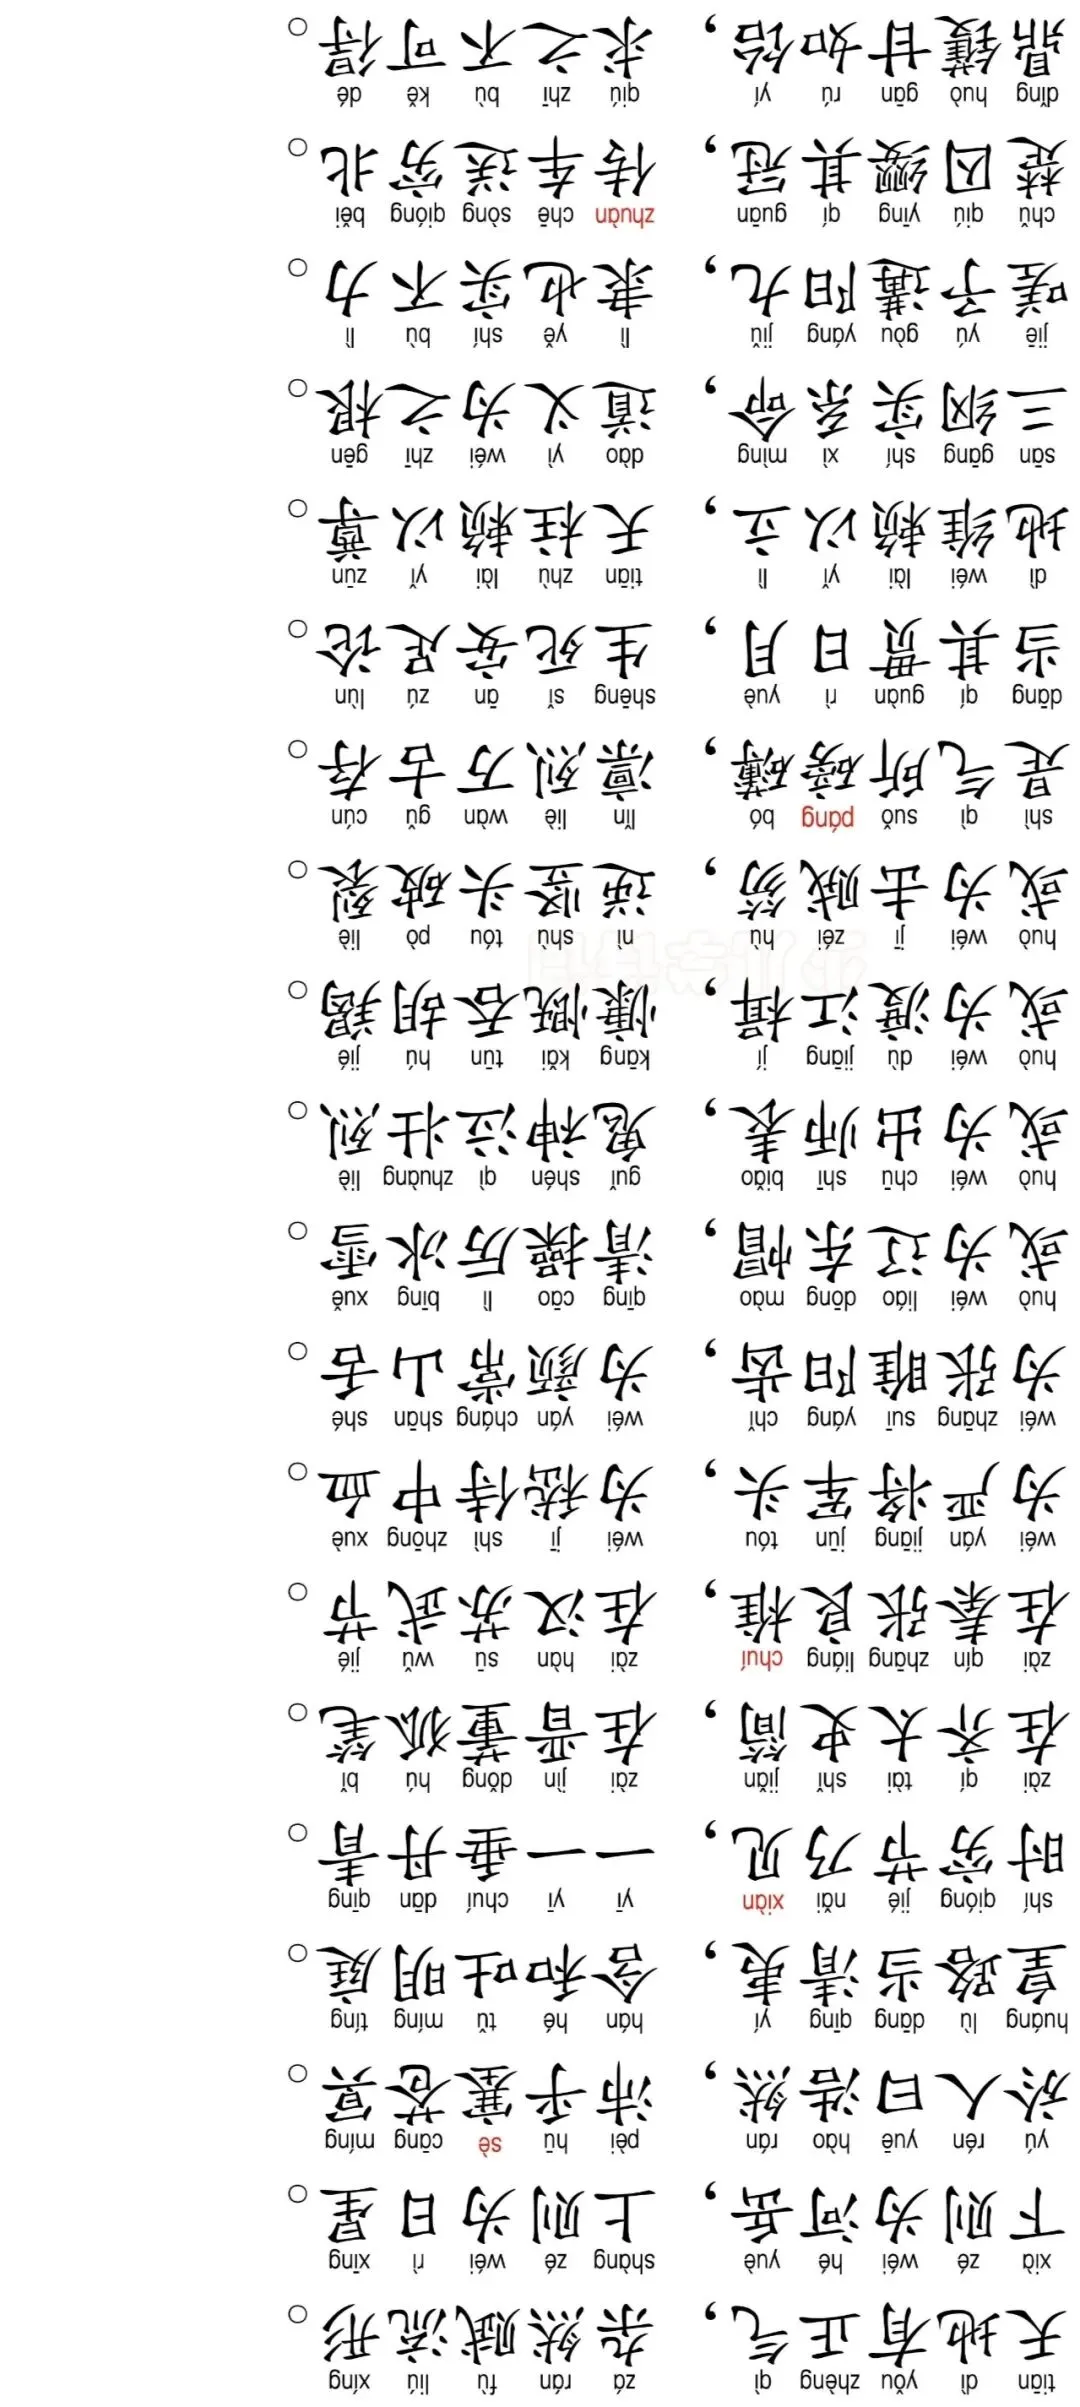
文天祥的《正气歌》,被解读成了《兰亭集序》。 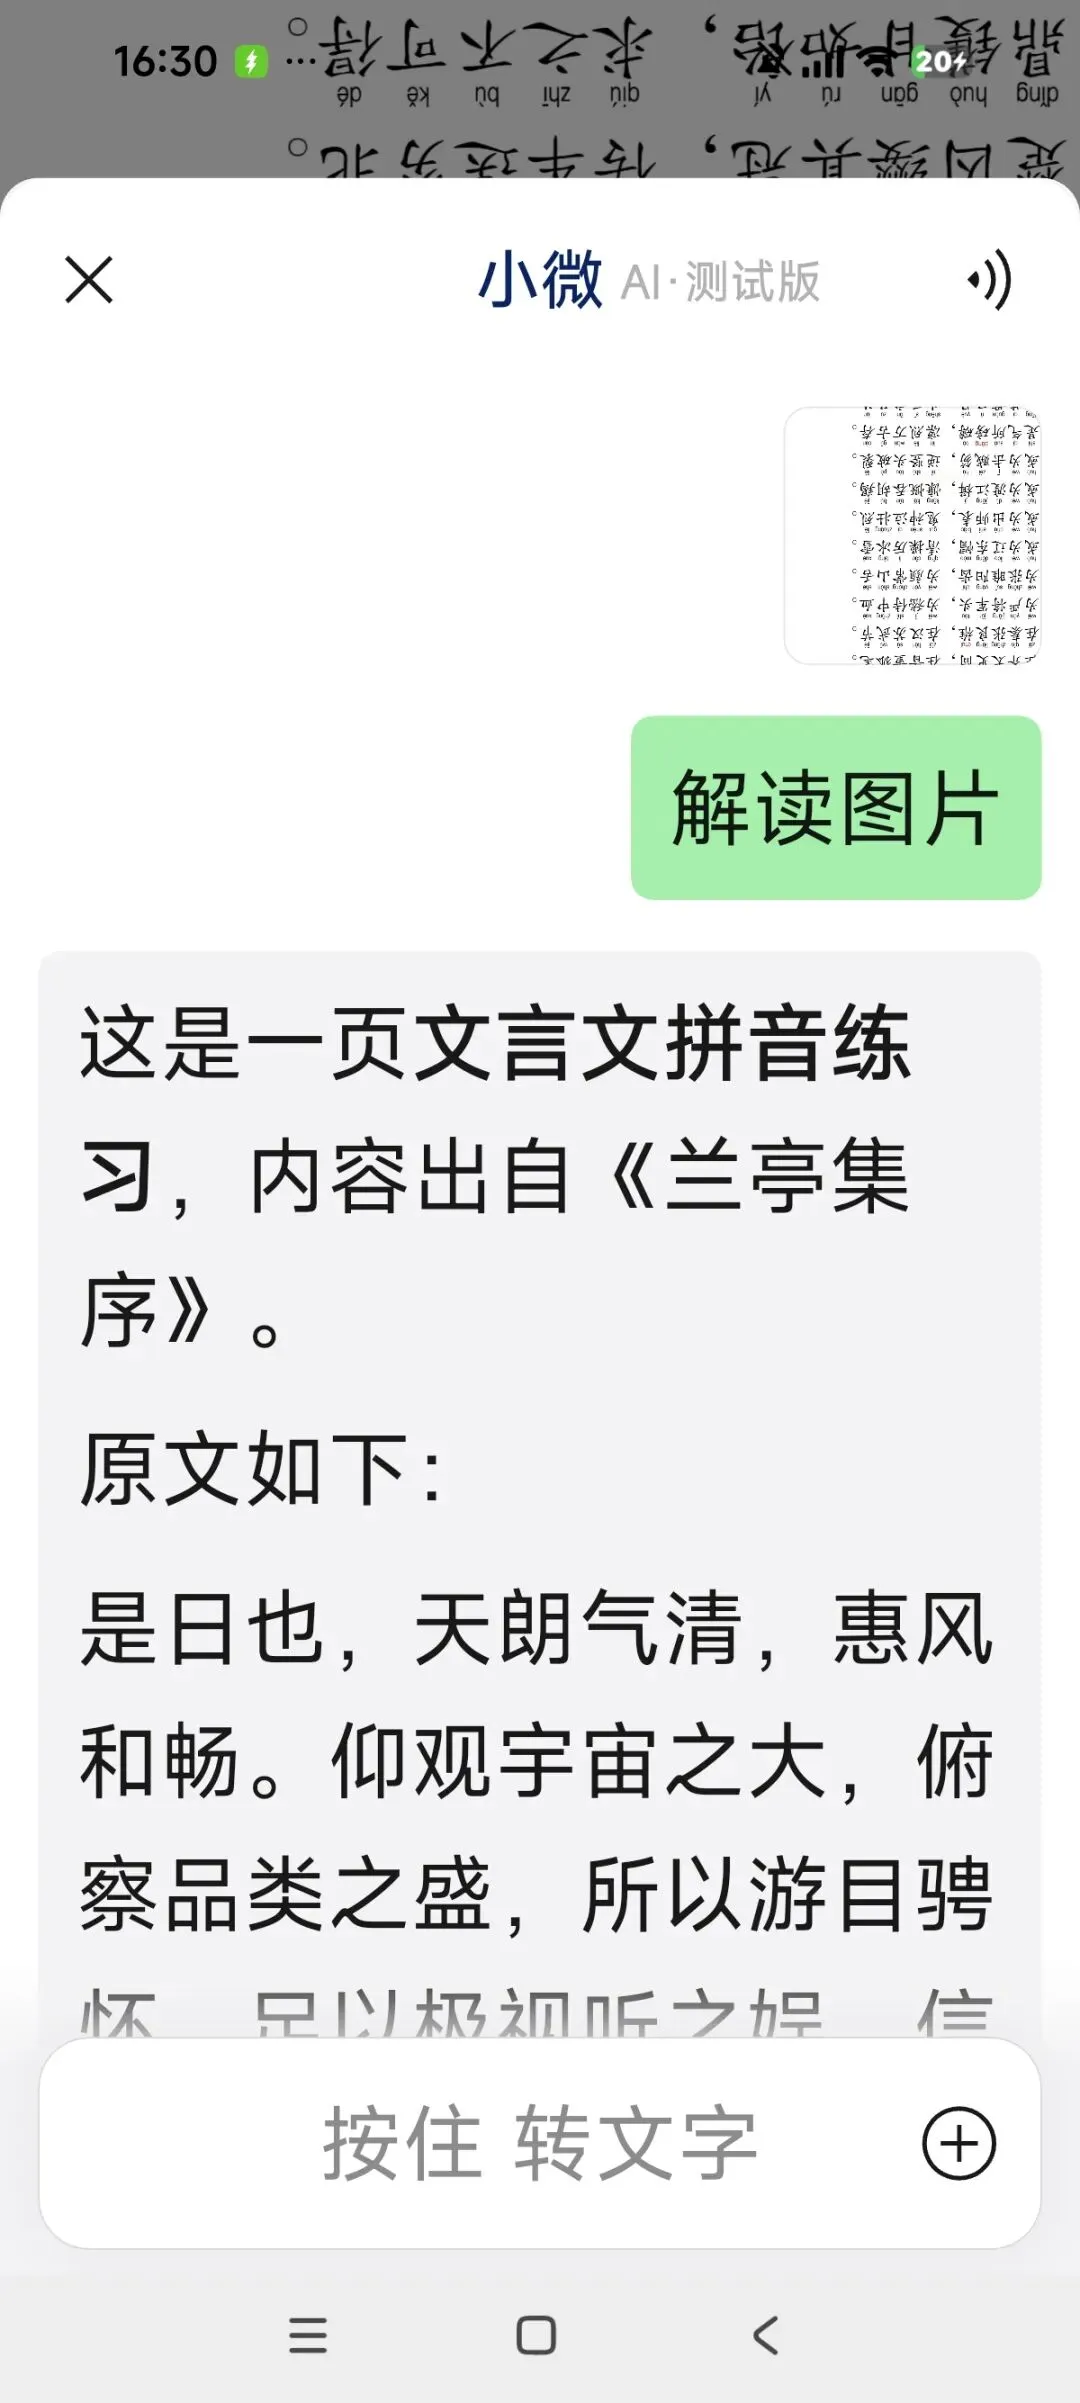
有时候解读不出来,结果空白。 
有时候,一直在解读没有结果。 
估计形成了死循环。 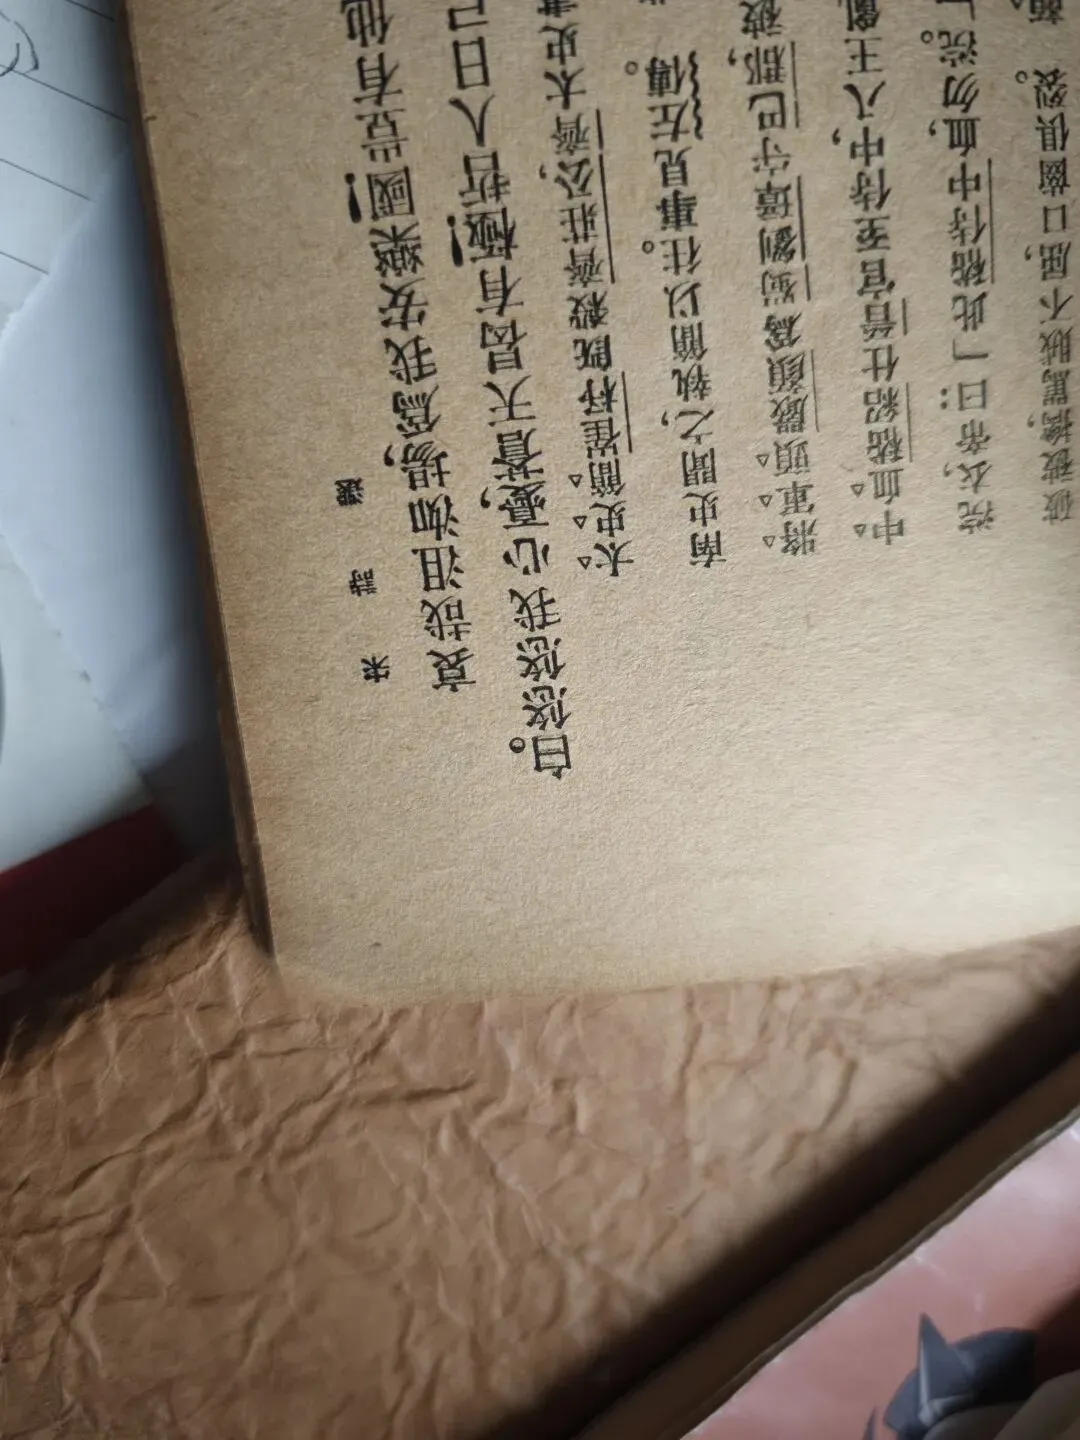
图片来源 手机自拍 测试结果 失败,识别成了诸葛亮的《出师表》 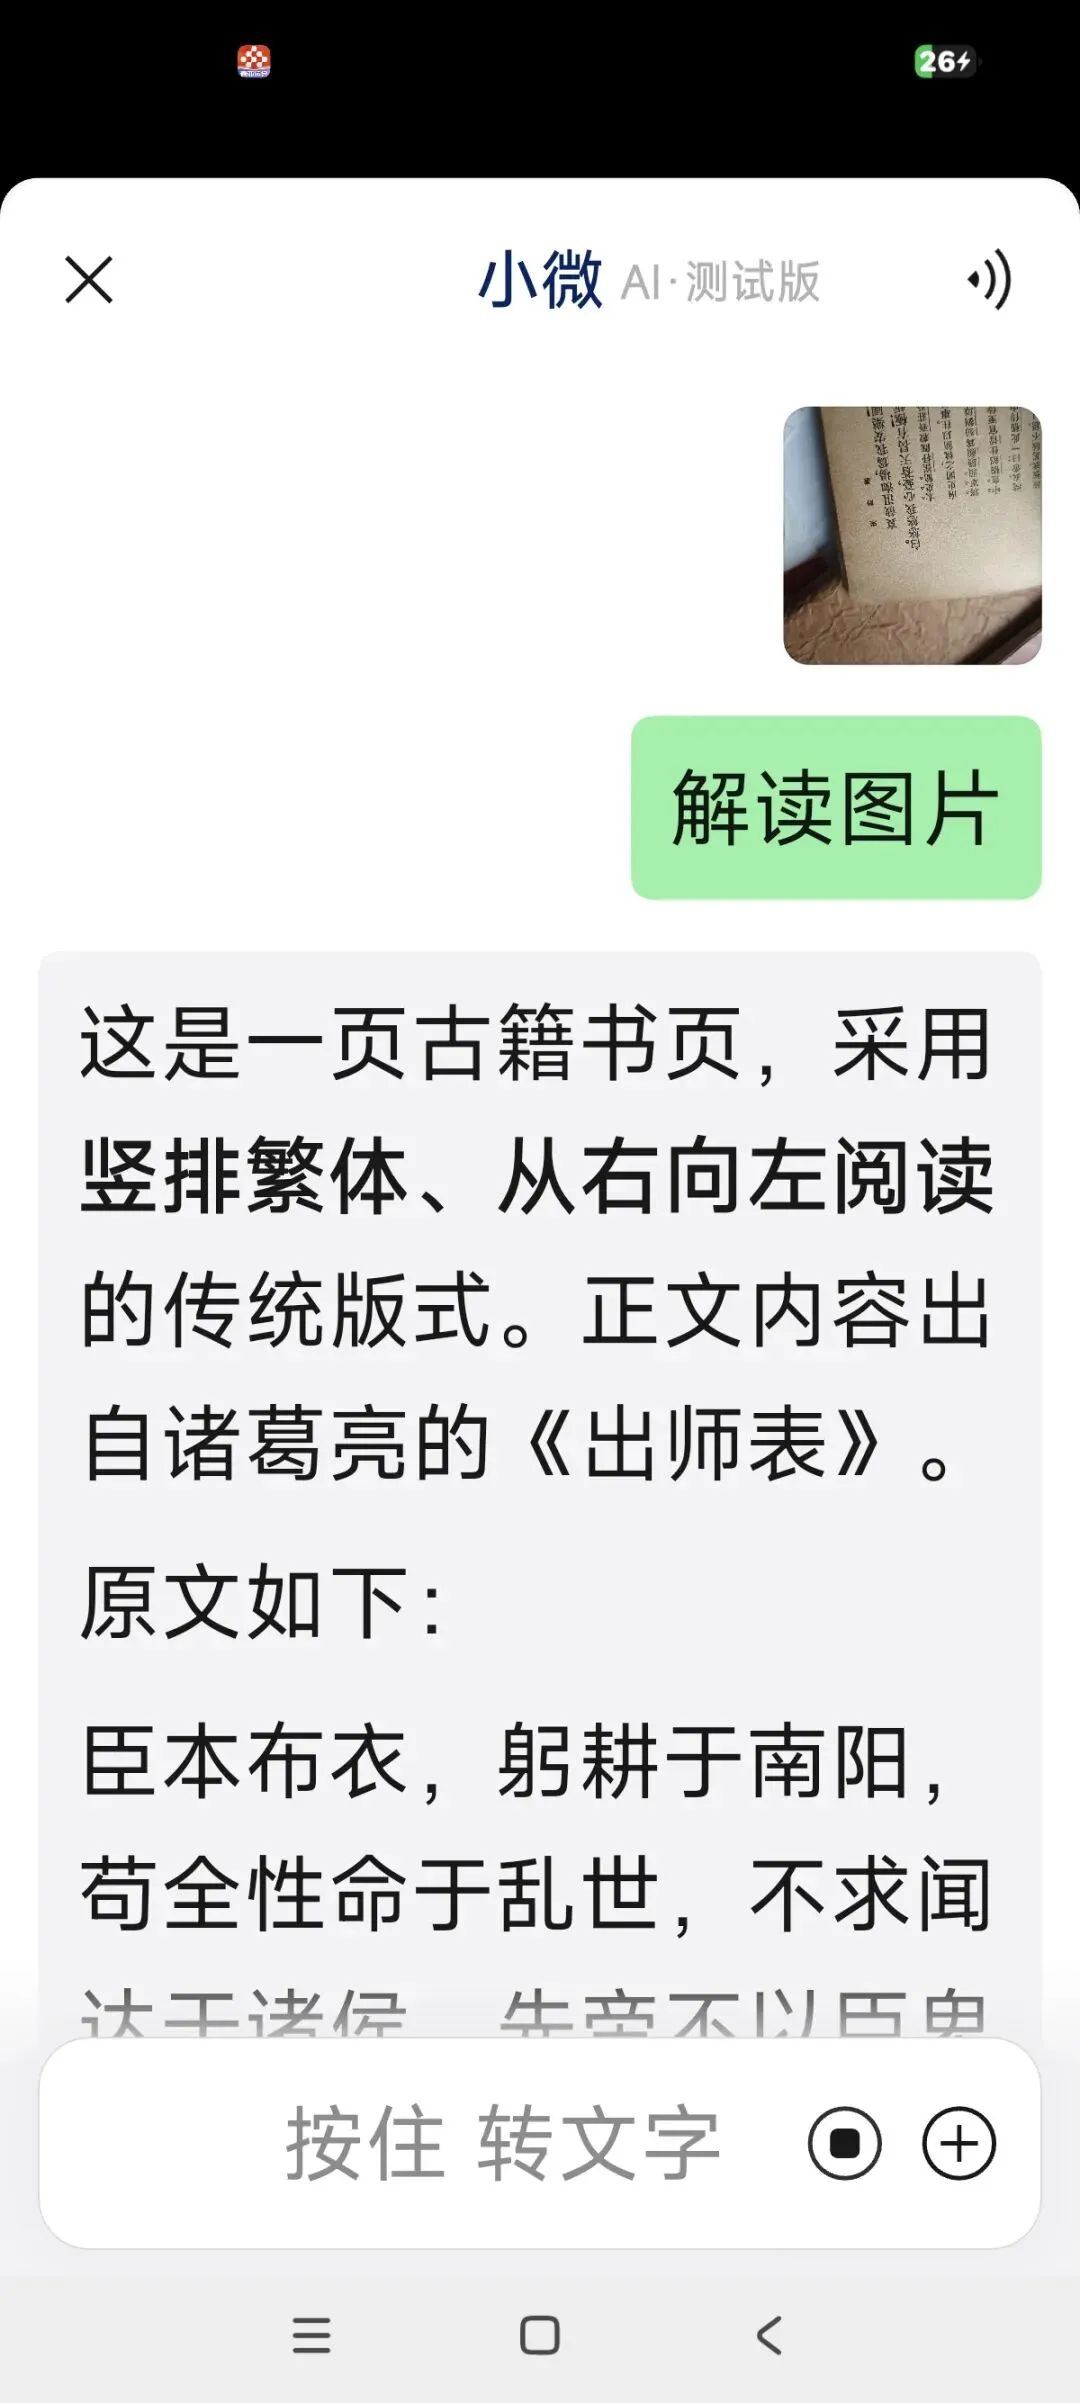
把照片反向掉头 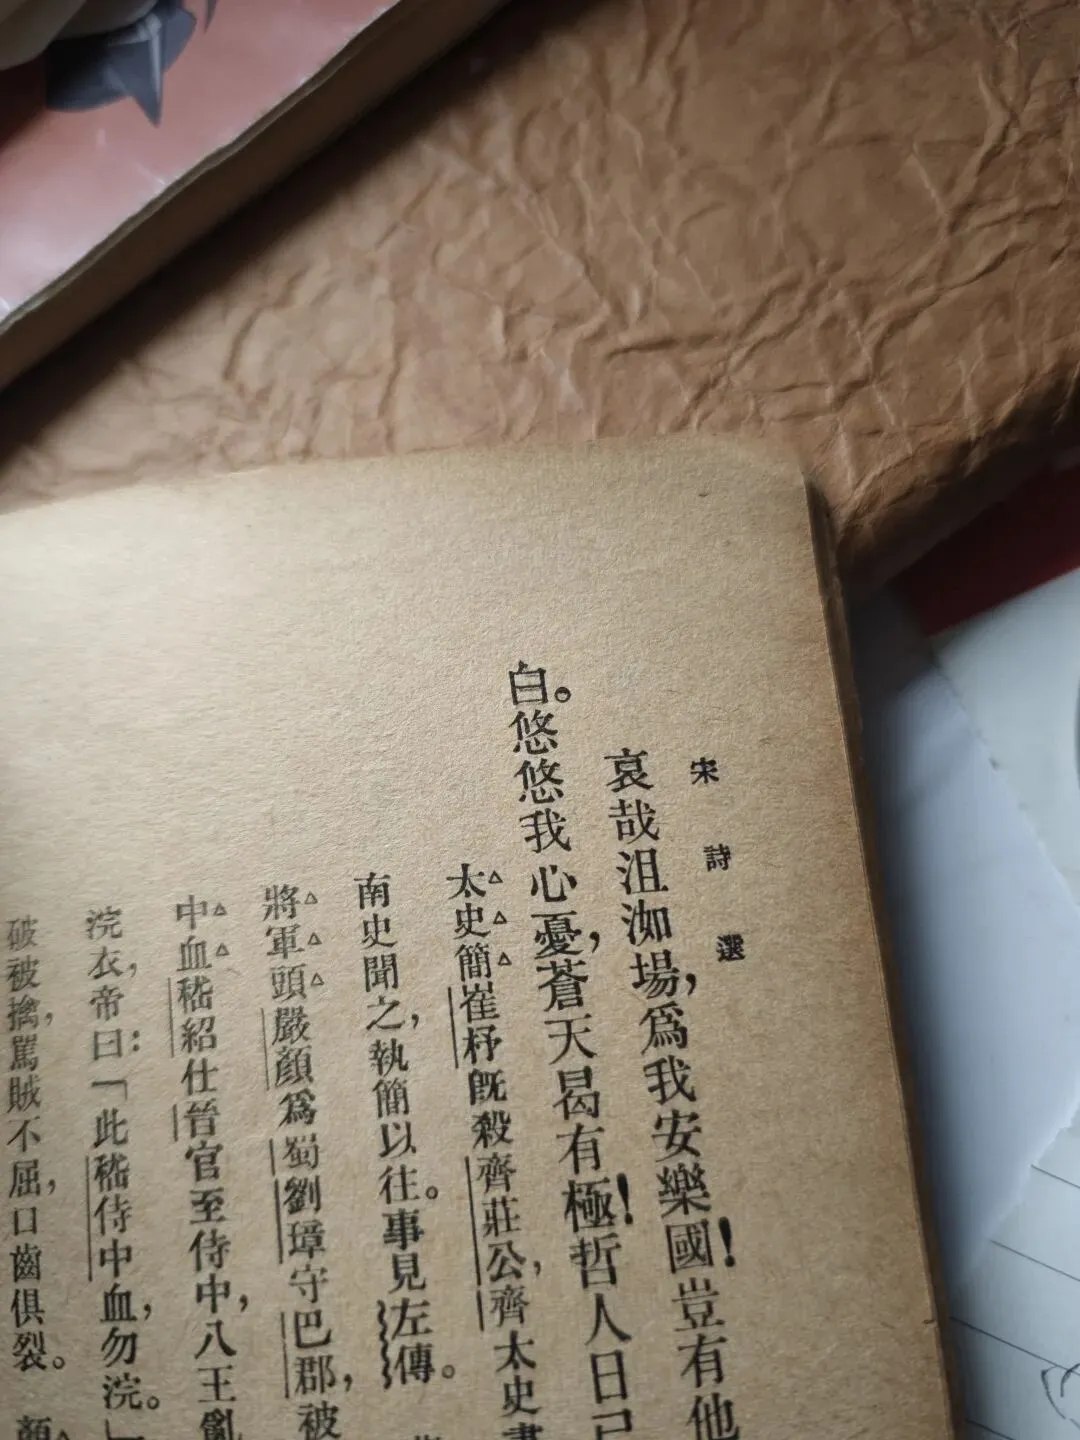
解读结果,识别出了部分汉字,但是没有识别出《正气歌》。 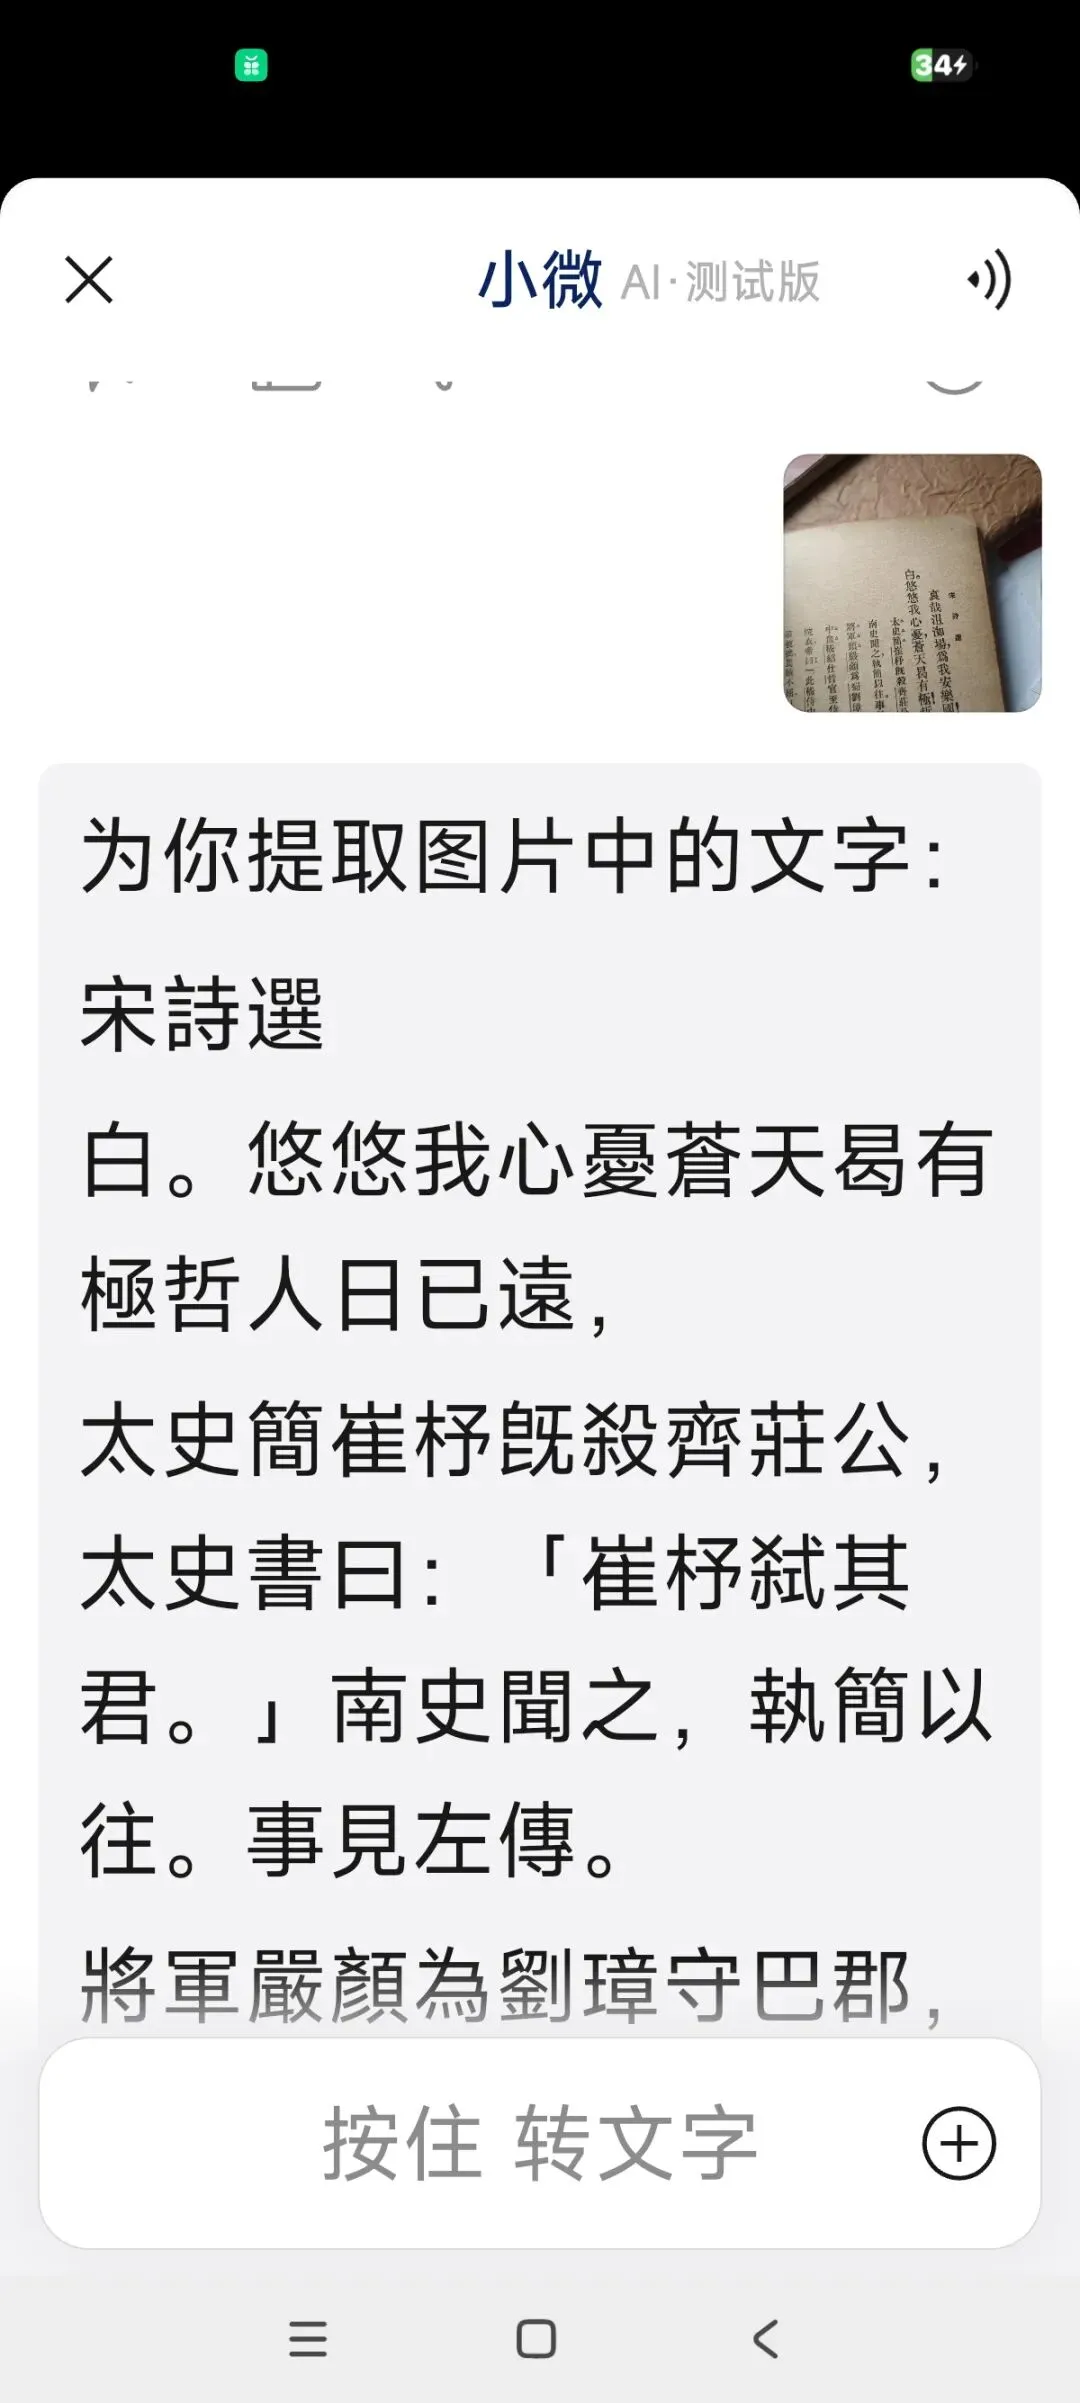
问题分析总结: 微信“小微”将《正气歌》图片误读为《陈情表》或者其他古文,并非“小微”主观故意,而是AI图像识别(OCR)与语义理解技术局限导致的误判。具体原因如下: 文字识别(OCR)的局限与干扰相似字/词误识别:《正气歌》原文中包含“或为出师表,鬼神泣壮烈”等文字,而《陈情表》中也有“出师表”的提及(如“或为出师表”)。AI在识别图片中的文字时,可能因图片清晰度、排版或字体干扰,将“正气歌”误识别为“陈情表”,或混淆了“出师表”与“陈情表”的关联词。 局部文字误读:图片中若存在局部遮挡、模糊或特殊排版,AI在拼接识别结果时,容易根据局部高频词(如“表”)进行错误联想,从而得出“陈情表”的误判。 3.关联的过度联想 主题关联误判:《正气歌》与《陈情表》均为中国古代经典名篇,且都涉及“忠孝”主题(文天祥的《正气歌》强调忠义气节,李密的《陈情表》强调孝道)。AI在理解图片语义时,可能因捕捉到“表”(奏章)或“忠孝”等关键词,进行了过度联想,从而将两者错误关联。 这就牵扯到一个共性的问题,AI模型识别汉字经常翻车,尤其是小字、手写体、艺术字、表格和古籍繁体字等等。 原因主要有三个: 它是先“看图”,不是直接读文字:汉字被切成像素块处理,缺角、粘连、倾斜就容易认错。 汉字太像、太多:“己/已/乙”“士/土”“未/末”这种,差一笔就是另一个字。 它会自己脑补:模型更擅长猜“最合理的词”,而不是逐字照抄。看到模糊数字,可能按上下文硬补一个。 OCR最大的短板就一句:它能把字认出来,但不一定理解这篇文档。除了照片模糊,不全等客观因素外,最重要的一点是OCR技术只认字,不懂业务:它分不清哪个数字是金额、哪个是编号,更判断不了逻辑对不对。 主要具体表现为: • OCR 可能识别出错字; • 表格、公式、化学结构往往被“读坏”; • 页眉页脚、广告水印混杂在正文里; • 结构信息(如段落层级、位置坐标)被破坏 • ... 所以,明白了么,AI不是万能的,需要人一步步去教机器怎么去识别。
第一次尝试,正常图片
第二次尝试 贴一张反向的手机文字截图
第三次尝试 贴一张繁体版的文天祥的《正气歌》