ARTICLE · 1147600
OpenAI放出722篇数学论文,数学家为什么不领情
尾巴的读博日记 · 热点观察 · 2026-10-09
OpenAI放出722篇数学论文,数学家为什么不领情
人类数学协会 · 陶哲轩 · 162 / 722
本期速览
— OpenAI 一夜放出 722 份 AI 数学手稿,问题清单里有准黎曼猜想
— 人类数学协会呼吁抵制,主席是陶哲轩
— 能过机器逐行验证的,目前只有 162 篇
十月初,GitHub 上一个叫 openai/math 的仓库一夜之间火了起来。里面躺着 722 份数学手稿,全部出自 OpenAI 一个还没对外发布的内部模型。没有期刊,没有审稿,作者栏里没有任何一个人类的名字。
上个月这个话题第一次刷屏时,我写过一篇《AI 88 小时啃下百年难题,数学界吵翻了》。那时候数学界的状态是「吵」。这一次,吵出了组织。
10 月 7 日,一个叫「人类数学协会」(Association for Human Mathematics,简称 AHM)的组织发出声明,呼吁全球数学家停止与 OpenAI 合作。声明就发在陶哲轩的个人博客上,而陶哲轩本人,就是 AHM 的主席。
菲尔兹奖得主牵头抵制一家 AI 公司。我把能找到的报道、声明和各平台讨论都翻了一遍,把大家的原话整理给你。
01先把事情经过摆清楚
时间线不长。
8 月,据《连线》杂志披露,OpenAI 曾秘密召集约 40 位顶尖数学家开闭门会议,测试模型解数学难题的能力。9 月 11 日,陶哲轩、邓煜等二十多位菲尔兹奖得主联名发公开信,抗议 AI 公司把解决数学问题当成模型评测的军备竞赛,信的标题翻译过来叫《人工智能在数学中的严重错位》。这批数学家同时成立了一个顾问组(AGMAI),成员里有 Gowers、Hairer 这样的名字。
10 月 6 日,722 份手稿出现在 GitHub 上,归入 372 个「成果族」。OpenAI 说,模型总计尝试了约 4000 个公开难题,每道题平均花大约「三个小时的 ChatGPT Pro 思考算力」。清单里的名字一个比一个大:准黎曼猜想、四维挂谷猜想、黎曼霍奇猜想、BSD 猜想、唯一博弈猜想。
第二天,AHM 声明出炉。
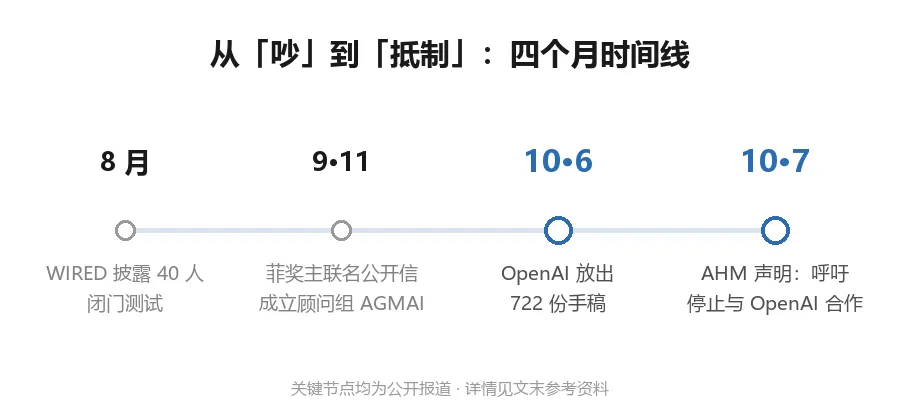
图 1|从「吵」到「抵制」:四个月里的四个关键节点
均为公开报道 · 详情见文末参考资料
02他们在愤怒什么
AHM 的声明不长,有句话分量很重:
「一次性放出 700 多份文件,与其说是学术的展示,不如说是力量的展示。」「数学家从未要求做这项工作。」—— AHM 声明
声明的意思是,OpenAI「对科学研究规范表现出完全的漠视」,而署名、引用、同行评审这些规范,恰恰是数学的可信度和公共利益的保证。所以 AHM 呼吁两件事:数学家停止与 OpenAI 合作;公众对这种发布模式保持怀疑。
面对声明,OpenAI 的回应搬出了数学家自己定的规矩,顾问组指南里写着重大成果应「尽快发布」。顾问组隔空回了一句:我们的咨询角色,不应被看作对这次发布的背书。
具体让数学家炸毛的点,比声明生动得多。
研究唯一博弈猜想的数学家 Dana Moshkovitz,在发布物里看到了自己毕生课题的声称证明,读完的感想是:「这篇论文写得烂到没有 AI 帮忙根本读不下去」,里面的构造是「某种外星人的疯狂」。Reddit 上 r/Physics 版的评论更不客气:这些论文「无法理解」,把文献里众所周知的思想,用一套谁也没见过的记号重新讲了一遍。
然后是验证。按 OpenAI 自己的目录,722 篇里只有 162 篇的主结果完成了 Lean 形式化,也就是机器能逐行检验的那种严格证明。剩下五百多篇呢?就连已完成形式化的部分,Lean 版本和书面论文对不对得上,也还没人核对过。OpenAI 自己都悄悄撤回过其中一些有缺陷的解法。
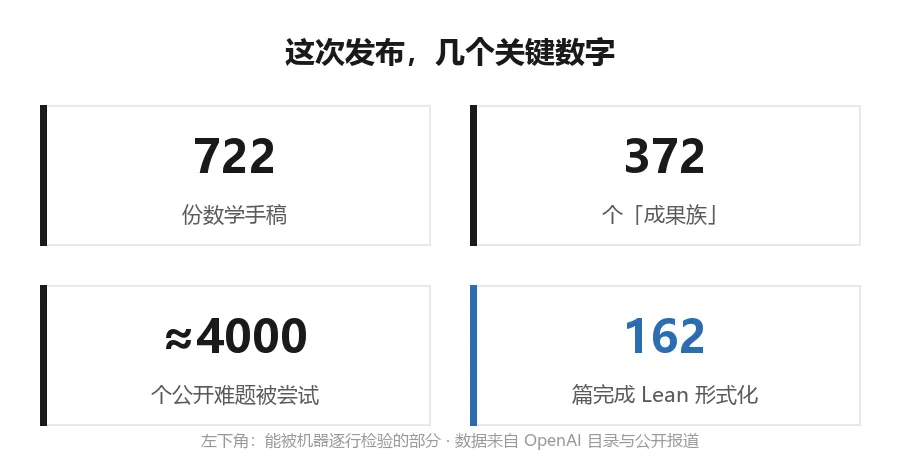
图 2|这次发布的几个关键数字
数据来自 OpenAI 目录与公开报道
陶哲轩在 Mastodon 上打过一个比方,整场争论里数它最形象:
这种发布方式,等于「把生肉的残骸扔到我们村庄的公共餐桌上」。肉是谁猎的、干不干净、怎么分,全留给村里人自己处理。
他还说了一层更深的担忧。一个难题一旦被认为「已解」,就再也回不到未解状态了;光是知道解存在,就会搅乱其他本可能带来新洞见的探索路径。他说这些解正在被大规模「收割」,而 AI 解完题之后既不会讲解,也做不了报告。按他心里的「Math 2.0」,数学的核心应该是解释、社群和开辟新方向,解题只是入场券。
03反方的声音也不小
只看上面这些,你会以为全世界都站在数学家一边。各平台翻下来,远不是这样。
知乎热榜上有个问题问得相当冲:「数学家抵制 AI 研究数学发展,是不是对全人类来讲太自私了?」Hacker News 上点赞很高的评论说,AHM 这是在「维护自己原有的权力、声望和控制力」。Reddit 上也有人把仓库称作「722 条提取理解的路径」,更多人觉得公开总比藏着好,至少结果摆在明面上,而不是锁在哪家公司的私有服务器里。
复杂性理论家 Scott Aaronson 的态度最微妙。他给这场混乱发明了一个词,「Mathocalypse」(数学末日)。但他同时把两家公司摆在一起比:OpenAI 是批量倾倒;Anthropic 则是跟两位研究者正经合作、付报酬、把证明写成人类能读懂的样子。他自己常年给 AI 公司做顾问,所以这句话听着格外扎耳:两种模式,各有各的问题。
帝国理工的 Kevin Buzzard 补了个技术注脚:形式化的主要障碍其实只是耗时,AI 反而把缺的工具补齐了。当然,一篇论文的完整形式化,连它引用的文献都得一起形式化。活是人干的,但路是通的。
还有个细节,大部分报道一笔带过。《连线》提到,有匿名的 OpenAI 员工认为 AI 已经让数学「死亡」。比起 722 份手稿本身,这种话可能才是数学家真正炸锅的原因。
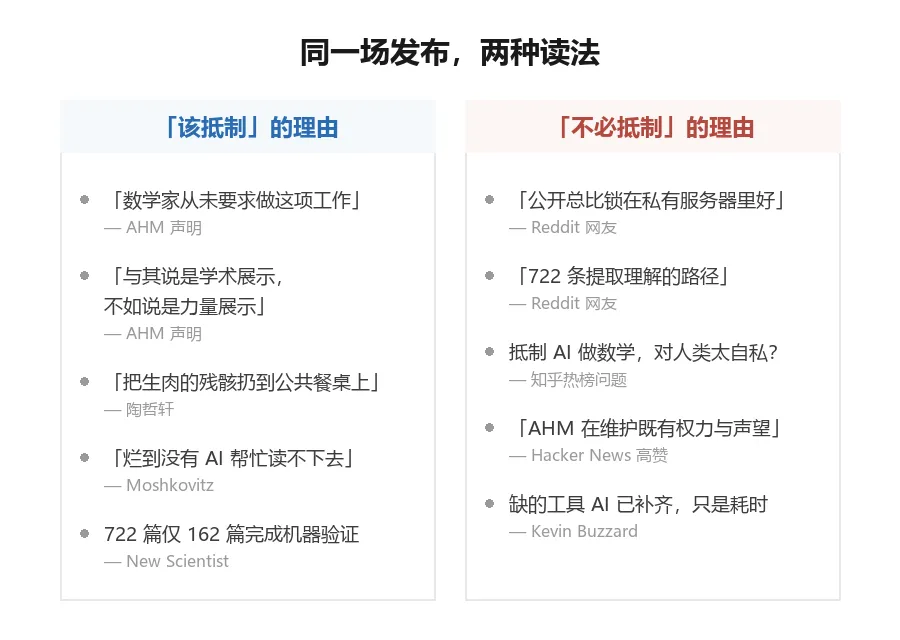
图 3|同一场发布,两种读法
各平台观点均为原话摘录 · 出处见图
04这事跟我们有什么关系
数学的瓜刷到这里,我作为学医的反倒在想另一件事:这场架里的每个环节,在别的学科都有对应物。
先说验证。「AI 说它证好了」和「证好了」之间,隔着 560 篇没形式化的论文。这个场景科研人太熟了:预印本不等于发表,图漂亮不等于数据干净。AI 产出的东西,验证环节只会更重,不会消失。
再说规范。AHM 声明真正在捍卫的,就是署名、引用、同行评审、可读性这些东西。它们看着像繁文缛节,其实是学术共同体批量生产「信任」的基础设施。基础设施的特点是平时没人注意,被绕过的时候所有人都受影响。
最后是三个检查动作。以后刷到「AI 攻克了 XX」,先问:结果有没有可独立验证的形式(数据、代码、形式化证明)?写得能不能让同行读懂?发布方是把帮人理解当目的,还是把 publicity 当目的?三问过后,大部分标题会自动降级。
New Scientist 那篇报道的标题起得很准:「OpenAI 已经把 722 篇数学论文倒了出去,现在,它必须收拾这个烂摊子。」怎么收拾,数学界给过示范:数学家 Hales 当年证明开普勒猜想后,自己花了十几年把证明搬进 Lean。发布只是开始,让人读懂才算数。
这场抵制闹到现在,诉求其实一直没变:谁把论文倒出来,谁就负责把它写完、写懂。
参考资料(可按图索骥)
1. AHM 声明全文(陶哲轩博客转载,2026-10-07)2. The Decoder:Some mathematicians call for OpenAI boycott after AI-generated proofs flood their field3. New Scientist:OpenAI has dumped 722 maths papers – now it must clean up the mess4. 知乎专栏《OpenAI一次放出722篇数学成果》;知乎问题「数学家抵制AI研究数学发展是不是对全人类来讲太自私了?」5. Reddit r/Physics、r/mathematics 相关帖;Hacker News 相关帖
本期话题:你怎么看「先发布、再验证」这种模式?如果你审稿时收到一份没人读得懂的 AI 证明,你会怎么办?评论区聊聊。
如果这篇对你有用,欢迎关注「尾巴的读博日记」,也欢迎点赞、在看、转发给同样在读研读博的朋友——这是我更新的第一动力。
AI 一晚上能倒出七百篇论文,可数学家较真的是:让人读懂,才算数。出结果越来越快的年代,把一件事讲明白、讲得让人信,仍然是慢功夫。别嫌自己慢,你最值钱的部分,都长在这段慢里。
尾巴的读博日记 · 在读医学博士文献精读 / 热点观察 / 效率工具 / 读博日常 · 每日更新