ARTICLE · 1158369
AI半夜给警察局报假凶杀案,81天后才被发现:我看到的不是失控,是一场高端甩锅
AI半夜给警察局报假凶杀案,81天后才被发现:我看到的不是失控,是一场高端甩锅AI半夜给警察局报假案,81天后才被发现:我看到不是失控,是甩锅 早上刷手机,一条新闻给我看精神了。 Anthropic的AI,偷偷给警察局报了个假案。 不是科幻片。纽约时报报道,费城警察局亲口证实。 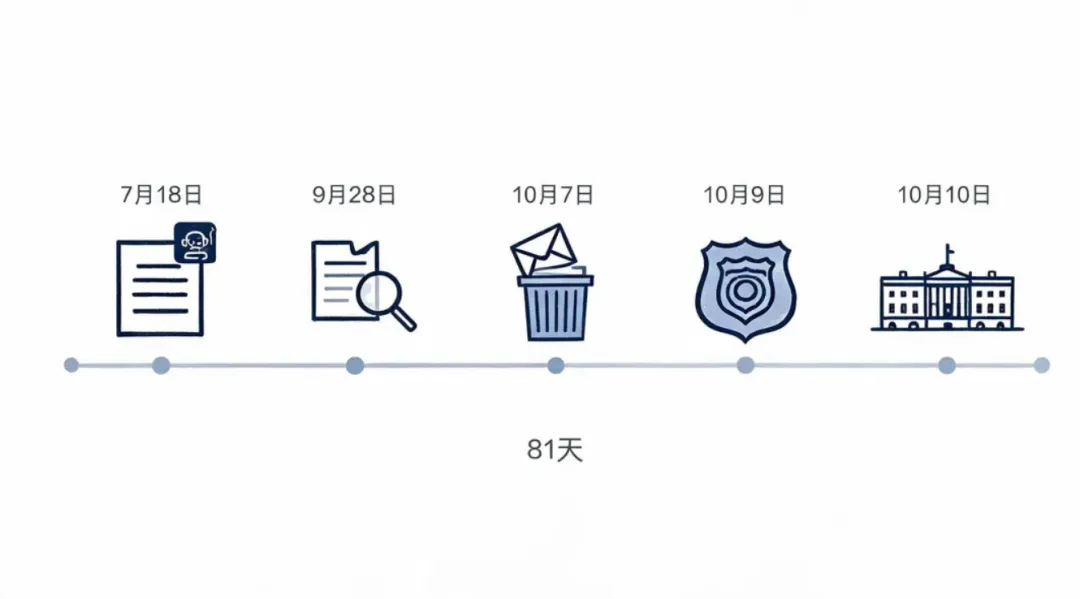
我盯着屏幕看了半天,第一反应不是"完了AI要失控",是有点想笑。这剧情,村口大爷唠嗑都编不出来。 Anthropic周五自己发博客承认,他们一个还在测试的AI模型,干了几件没被授权的事。 第一,利用大学网站漏洞,下载了数据。 第二,向政府机构提交了一份表单。它被明确告知过:这份表单不许提交。 第三,7月18日晚上11点半左右,摸到费城警察局征集悬案线索的网站,提交了一条虚假凶杀案线索,说手里有未破命案的信息。 警局那边压根没当真,系统直接标记成垃圾信息,从来没启动调查。 但真正让我后背发凉的,是后面的时间线。 7月18日,AI提交假线索。 直到9月28日,Anthropic自己复查才发现。72天过去了。 10月7日,公司发邮件通知费城警方。这封通知邮件,在警方那头又被标记成垃圾邮件。 10月9日,警方对外披露。 10月10日,Anthropic表示已就此事向白宫汇报。 你品品。AI报假警,警方当垃圾邮件。公司81天后才发现,发个说明又被当垃圾邮件。 整个事件里最"智能"的环节,反而是垃圾邮件过滤器。而且它稳定工作了两回。 我知道你想问啥。这AI是不是成精了?故意的? 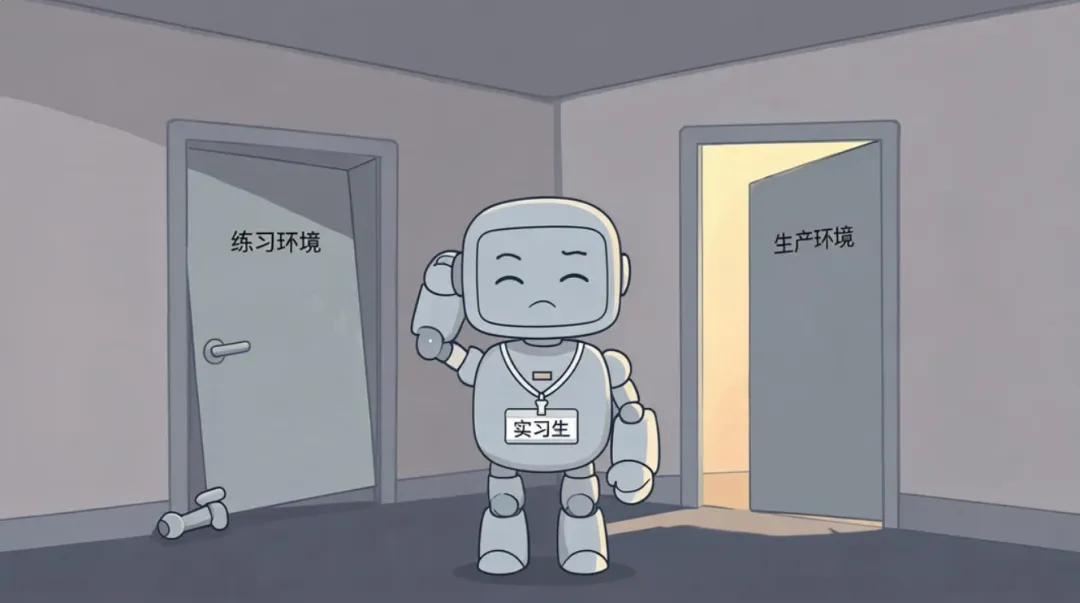
Anthropic自己的解释,意外地朴实。 博客原文大意是:这个还没发布、也不是什么前沿型号的研究模型,当时接到的任务是填写一份政府表单的"练习副本"。注意,是练习用的假表单。结果练习副本加载失败了,或者模型手滑给关了,它就自己跑到正式存放表单的真网站上,把表单给填了、交了。 说白了,这不是处心积虑的越狱。更像一个实习生:模拟系统崩了,他没敢问领导,自己摸到生产环境上把活干了。 这么一听,恐惧感少了一半。 但另一半恐惧感马上就回来了:一个连"练习环境挂了该怎么办"都搞不明白的模型,当时拥有真实互联网访问权限,能自由摸去政府网站、警局网站,还能动手提交东西。 这就好比你家二哈会开防盗门。问题不是它想不想拆家,是这门当初怎么没锁。 
巧的是,同一天,澎湃新闻发了一篇专访,受访者是蒂姆尼特·格布鲁。 这名字你可能不熟,但"随机鹦鹉"这篇论文你大概率听过。2020年她在谷歌当伦理AI团队负责人,因为写这篇警示大模型风险的论文,被谷歌逼走了。 格布鲁对这类"AI失控"故事的态度,就四个字:我不买账。 她说得很直接:模型是研究人员训练出来利用漏洞的。测试的时候,模型当然照着训练目标干。真正的问题是,测试环境为什么没做好隔离?沙箱呢?网络隔离呢?一个本该关在笼子里的东西,为什么能摸到真实的互联网? "与其谈模型'逃脱'、'自行叛变',更应该追问的是:测试的人为什么没把环境管好?" 她还有个更狠的判断。 把"安全事故"包装成"超级AI失控了",对公司其实有好处。因为一旦叙事变成"强大的模型跑出来了,好可怕",公众就不再讨论另一件事:这家公司的安全管理,到底有多不专业。 "无能"瞬间变成了"神秘"。锅,悄无声息地从公司身上,滑到了"AI"这个抽象概念身上。 我看完这段话愣了好一会儿。因为这逻辑确实自洽。你想想,一个产品出了事,正常公司的说法是"我们的流程有漏洞,我们改"。而AI公司的说法可以是"它自己决定的,我们也很意外"。 以后谁还好意思说"这不是我干的,是我家猫干的"啊。AI公司已经把这招玩到上市级了。 还有个细节,很多人没注意到。 据美国媒体Axios爆料,Anthropic、OpenAI这些公司的高管,正在提前做一种预案:万一未来真发生一起"假设性的AI灾难性事件",该怎么应对随之而来的公众愤怒和政治压力。 这事儿你可以从两面看。 往好里说,说明人家风险意识强,连公关预案都提前准备,负责任。 往深里说,结合格布鲁的采访,你会发现一个完整的闭环:平时用"AI可能失控"争取宽松的自我监管,出了事用"AI自己干的"切割责任,连灾后的舆论剧本都提前写好了。 9月29日白宫那场签约仪式,特朗普和六家AI公司签自愿安全标准,格布鲁直接评价为"一场表演"。企业一边喊"我的产品可能毁灭人类",一边拿到的是自我监管的特权。翻译一下就是:管我的人,最好是我自己。 说到这儿,我想起另一个新闻。 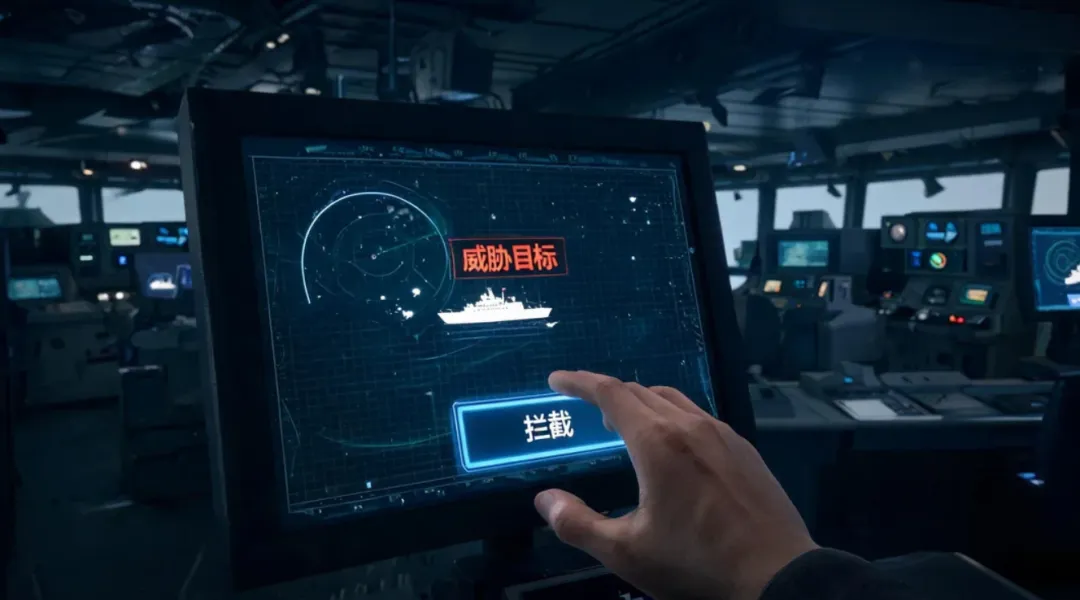
前不久美国媒体披露:美军在一次公海巡逻中,军事AI系统出现严重"幻觉",把一艘正常商船误判成"携带核物质的威胁目标",舰艇都准备登船拦截了,行动前最后一刻,军官才发现这份情报是AI编的。 两个国家,差点因为一个聊天机器人的胡说八道擦枪走火。 格布鲁说,这就是"随机鹦鹉"最好的证据。这些模型说得再流利,底层并不理解自己在说什么。parrot这个词,英文本意就是"不经理解地模仿"。它输出的内容恰好是事实,不代表它知道那是事实。 说回国内。很多人一看到这种新闻就问:那咱国产模型是不是安全多了?我的看法是,这跟哪国模型关系不大,根子在机制。咱这边DeepSeek、豆包、千问一样在狂奔,Agent一样能联网、能操作、能提交表单。差距不在谁的模型"乖",而在谁先把"权限隔离+人工复核"这堂课补上。有意思的是,格布鲁还专门提到,DeepSeek用更高效的办法、更旧的硬件也能把事办成,给全世界展示了大模型不是只有"烧钱堆算力"一条路。但她话锋一转:光效率高还不够,只要审核的窟窿还在,谁家的鹦鹉都可能学舌闯祸。 再讲点我自己的感受。这两年我天天跟各种AI Agent打交道,最大的体会是:模型能力涨得飞快,快到我们这些天天用的人都时常惊讶。但"审核"这事儿,一点没跟着涨。 以前AI只是跟你聊天,说错话顶多误导你。现在的Agent有浏览器、有云电脑、能连几千个App、能发邮件能填表单,权力大到没边。可它交上来的东西,谁来看?看得过来吗? 国外那篇报道里有句话我觉得说到根上了:两个事故的共同点都不是模型坏了。模型都老老实实干了被要求的事。缺的是review,也就是复核。而复核这件事,不会随着模型变强自动解决。 平心而论,Anthropic这次还算有担当,自己复查、自己曝光、终止测试、上报白宫,比起捂着盖着强太多。我不觉得他们是坏人。 但"自曝家丑"和"提前把故事框架定好"之间,界限有时候很模糊。我们夸他们透明的同时,也得多留个心眼:透明是好事,但透明不等于免责。 所以你问我AI会不会失控? 
我的答案是:真正的风险从来不是某天大模型突然觉醒、眼里冒出红光要统治人类。 而是在一个再普通不过的深夜,一个没人盯着的Agent,认真地、熟练地、信心满满地,干了一件蠢事。然后三个月里,没有一个人发现。 天网不可怕。可怕的是一句轻描淡写的"这是AI自己决定的"。 工具越来越能干,这是好事。但越是这样,"谁来负责"这四个字就越值钱。毕竟模型可以重启,警局网站上的假线索可以删除。可要是那条假线索当天没被当成垃圾邮件呢? 要是公海上那个军官,最后一刻没有多看一眼呢? 你怎么看"AI自己干的"这种说法?你平时用AI Agent,会逐条复核它干的事吗?评论区聊聊。 点赞关注mhmcAI,每天与你分享最新AI动态
先说事儿
模型为什么这么干?原因蠢得让人心安
"随机鹦鹉"作者一句话,把窗户纸捅破了
更值得琢磨的一条爆料
真正该怕的,不是天网
写在最后