夜雨聆风学习资料网

ARTICLE · 1163034

LightLLM 调度源码分析与实践:基于历史请求长度分布的调度优化

LightLLM 调度源码分析与实践:基于历史请求长度分布的调度优化

LightLLM 请求调度策略实验基本信息

1.1 研究的问题及步骤

LightLLM中使用了请求长度预测的方法,来为请求提前分配内存,再根据内存使用情况来控制请求的准入。这个请求长度的预测是通过历史请求的输入长度和输入长度来估计得到的。虽然大部分论文都提出相同请求的输出长度是随机变化的,但是本人还是想通过实验探究一下利用这个输出长度的信息,能否通过改变请求进入的时间,进而提升部分请求的延迟。也就是说优化请求的SLO(Service Level Objective)

请求的延迟也就是下面实验中的Latency包含:请求在队列中排队的时间和请求执行的时间(Prefill的时间和Decode的时间)

本实验会从下面几个方面探讨:

  • 1. 请求的输入和输出是否存在某种关系
  • 2. 请求输出长度的分布
  • 3. 改变调度策略是否会提升部分请求的延迟,以及恶化部分请求的延迟
  • 4. 不同输出长度区间的平均延迟

实验结果并没有太大意义,效果基本没有,仅供参考。目前没有在稍大一点的模型上进行实验。

1.2 实验环境与配置

  • • 硬件: NVIDIA RTX 4060 8GB
  • • 模型: Llama-3.2-1B-Instruct
  • • 数据集: ShareGPT_V3_unfiltered_cleaned_split,每次实验使用 4000 条请求
  • • 并行配置: TP=1,DP=1
  • • 推理参数:mem_fraction=0.7,max_req_total_len=4096,running_max_req_size=16,batch_max_tokens=1024

1.3 实验代码

实验代码维护在个人 Fork 仓库 whhren/LightLLM-exp 中。针对不同调度策略,分别建立独立的 Git 分支,便于管理代码版本、追踪修改记录以及进行策略间的对照实验。

调度策略
策略
代码链接
FCFS
先来先服务
查看代码
SJF
短作业优先
查看代码
LJF
长作业优先
查看代码
BUB
遍历一遍列表,相邻的把短的放前面
查看代码

不同调度策略的主要代码改动集中在以下位置:

  • • 调度逻辑:lightllm/server/router/req_queue/chunked_prefill/impl.py,主要用于调整等待队列中请求的排序方式。
  • • 基准测试:test/benchmark/service/benchmark_sharegpt.py,用于执行 ShareGPT 请求负载测试,并通过结果文件命名区分不同调度策略。

LightLLM 采用多进程架构,本实验主要在 Router 调度侧进行修改,不直接调整模型执行端的核心推理逻辑。这种设计能够减少对执行端代码的侵入,并便于独立分析调度策略的影响。

需要注意的是,调度策略仍可能通过改变请求进入批次的顺序、批次构建过程及请求准入时机,间接影响执行端的负载和整体推理性能。因此,实验将通过吞吐量、延迟、TTFT 和 ITL 等指标,评估不同调度策略对系统性能的实际影响。

2.实验部分

2.1 请求输入和输出长度的相关性、输出长度的分布

请求输出长度的分布
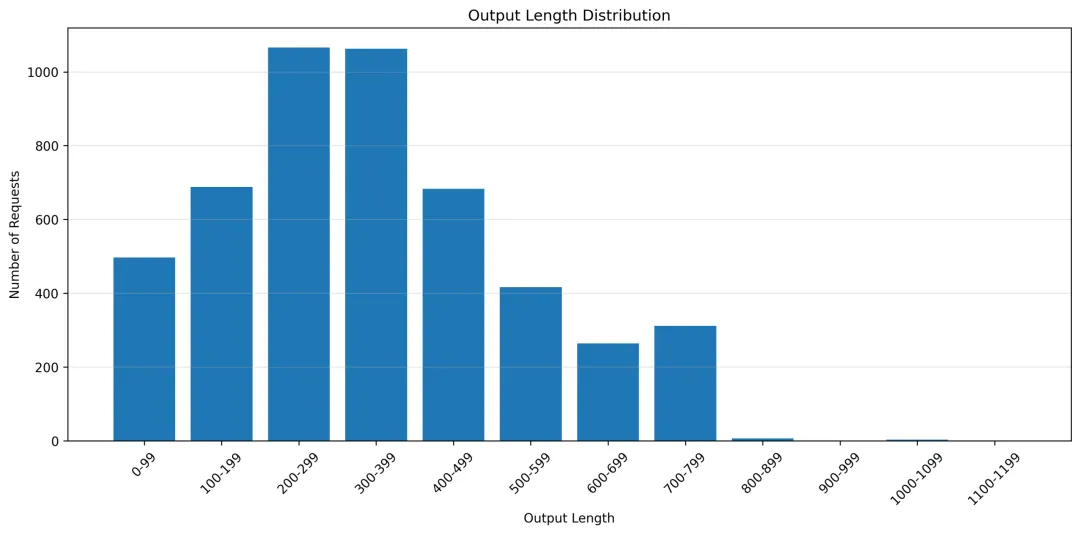
不同请求的输出长度存在明显差异,说明请求的生成负载并不均匀,为研究基于请求长度的调度策略提供了依据。

请求输入和输出长度的相关性
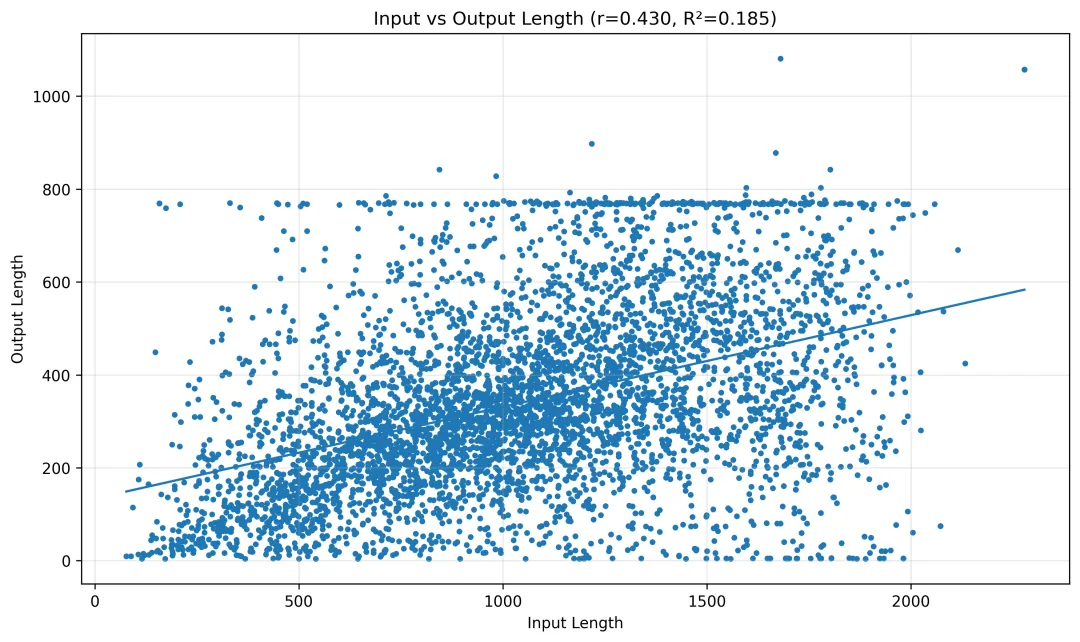
Pearson 相关系数()用于衡量两个变量之间的线性相关程度,取值范围为 。其中,正值表示正相关,负值表示负相关,绝对值越大,线性相关程度通常越强。

共 5000 条请求的实验中,输入长度与输出长度的 Pearson 相关系数为 0.43,呈正相关,但相关性较为有限。输入较长的请求可能倾向于产生较长的输出,但仅凭输入长度仍难以准确预测实际输出长度。

这一结果说明,请求输入长度虽然不是输出长度的准确预测指标,但仍然包含一定的长度信息,可作为短作业优先(SJF)等调度策略的参考依据。 因此,基于请求长度进行排序具有一定的合理性,但实际效果仍需通过对比实验验证。

2.2 不同策略对请求延迟是否有影响

说明:针对不同的rate只测试了一次,rate是每秒发送请求的数量。设备运行时平均处理时长是2-3请求每秒。在3的时候基本上就会有排队的现象。

参数说明:

指标
含义
实际吞吐量
系统实际完成请求的速率(req/s),用于衡量请求处理能力
平均延迟
所有请求从发起到完成的平均耗时(ms)
平均 TTFT
平均首 Token 生成时间(Time To First Token),反映用户等待模型首次响应的时间
平均 ITL
平均相邻输出 Token 之间的时间间隔(Inter-Token Latency),反映生成阶段的逐 Token 响应速度
Latency P10~P90
延迟的第 10~90 百分位数。例如,P90 表示 90% 的请求延迟不超过该值
Latency P99
延迟的第 99 百分位数,用于观察长尾延迟表现

Rate
策略
实际吞吐量 (req/s)
平均延迟 (ms)
平均 TTFT (ms)
平均 ITL (ms)
Latency P10 (ms)
Latency P20 (ms)
Latency P30 (ms)
Latency P40 (ms)
Latency P50 (ms)
Latency P60 (ms)
Latency P70 (ms)
Latency P80 (ms)
Latency P90 (ms)
Latency P99 (ms)
2
FCFS
1.962
5689.24
467.89
15.15
1675.81
2809.09
3656.17
4396.00
5074.44
5844.88
6867.18
8222.10
10363.26
16392.43
2
SJF
1.961
5753.22
484.75
15.32
1697.46
2821.02
3661.00
4416.36
5089.00
5884.42
6922.81
8346.96
10518.98
17421.81

Rate
策略
实际吞吐量 (req/s)
平均延迟 (ms)
平均 TTFT (ms)
平均 ITL (ms)
Latency P10 (ms)
Latency P20 (ms)
Latency P30 (ms)
Latency P40 (ms)
Latency P50 (ms)
Latency P60 (ms)
Latency P70 (ms)
Latency P80 (ms)
Latency P90 (ms)
Latency P99 (ms)
3
FCFS
2.595
90434.48
84510.27
17.26
5803.63
8892.63
13115.67
20893.35
35282.48
53194.03
84223.77
137144.00
236254.25
684349.35
3
SJF
2.601
92552.99
86658.34
17.18
5823.45
9184.40
13773.98
22233.78
36390.48
57618.47
88972.66
143775.05
253229.77
663657.30
3
LJF
2.610
90424.33
84536.41
17.15
5595.43
8760.78
13049.98
21041.94
34368.79
54368.29
84990.97
141334.78
255885.76
654270.37
3
BUB
2.608
91011.45
85120.72
17.16
5815.99
8752.81
12810.93
19629.97
33753.30
55221.26
91207.27
152368.43
258025.14
613166.70

平均吞吐量基本一样,说明基本都是满负载运行。这个表格中这些不同的策略并没有很好提升Latency,相反反而会恶化延迟,除了BUB方法,会优化p60之前请求的延迟。这些改变排队顺序策略反而优化了尾延迟p99。


Rate
策略
实际吞吐量 (req/s)
平均延迟 (ms)
平均 TTFT (ms)
平均 ITL (ms)
Latency P10 (ms)
Latency P20 (ms)
Latency P30 (ms)
Latency P40 (ms)
Latency P50 (ms)
Latency P60 (ms)
Latency P70 (ms)
Latency P80 (ms)
Latency P90 (ms)
Latency P99 (ms)
4
FCFS
2.568
265240.71
259332.19
17.33
8131.17
15470.33
33879.41
68348.08
125532.00
221284.02
355873.27
523015.33
738333.45
1178982.28
4
SJF
2.576
268726.63
262815.78
17.34
8211.10
16795.94
37686.66
70840.27
125325.22
209987.36
342263.94
555369.94
767835.81
1155200.21
4
LJF
2.546
264917.15
258946.48
17.38
7964.26
15584.19
33975.90
65262.49
116229.61
198275.35
351071.42
547269.21
763438.62
1162242.85
4
BUB
2.604
256327.82
250448.94
17.16
8102.20
15040.95
33037.76
60384.74
109227.37
189437.39
323867.72
524065.53
765819.56
1185082.69

Rate
策略
实际吞吐量 (req/s)
平均延迟 (ms)
平均 TTFT (ms)
平均 ITL (ms)
Latency P10 (ms)
Latency P20 (ms)
Latency P30 (ms)
Latency P40 (ms)
Latency P50 (ms)
Latency P60 (ms)
Latency P70 (ms)
Latency P80 (ms)
Latency P90 (ms)
Latency P99 (ms)
5
FCFS
2.566
355536.11
349663.35
17.26
8995.95
22177.63
51991.28
103498.96
194404.01
332326.22
561958.73
732128.67
918831.03
1311367.43
5
SJF
2.531
373929.35
367982.26
17.50
10049.17
24091.86
53197.99
112252.45
229615.71
390907.88
597623.19
767692.23
952842.00
1317920.96
5
LJF
2.571
363028.73
357173.05
17.02
9212.63
21317.18
49453.26
101350.07
203159.67
375003.41
579592.78
734032.20
935097.92
1301782.15
5
BUB
2.554
365813.87
359922.48
17.30
9526.15
21532.93
50553.17
102751.22
192587.46
370977.88
589285.30
735910.30
936079.35
1348900.41

Rate
策略
实际吞吐量 (req/s)
平均延迟 (ms)
平均 TTFT (ms)
平均 ITL (ms)
Latency P10 (ms)
Latency P20 (ms)
Latency P30 (ms)
Latency P40 (ms)
Latency P50 (ms)
Latency P60 (ms)
Latency P70 (ms)
Latency P80 (ms)
Latency P90 (ms)
Latency P99 (ms)
6
FCFS
2.593
417319.19
411529.83
16.94
9903.69
26225.42
61555.28
135743.28
271605.20
451902.37
696198.58
867969.22
1043364.56
1289630.72
6
SJF
2.556
439919.79
434063.50
17.32
11425.74
32767.10
78318.35
175012.97
332386.90
490613.52
671092.53
894860.63
1047859.60
1347216.35
6
LJF
2.567
427084.83
421248.46
16.92
10787.82
28604.22
69572.80
161128.17
324642.93
491367.58
645347.47
792390.93
1097130.89
1371739.92
6
BUB
2.553
431434.55
425572.26
17.28
10232.33
25623.43
63695.07
138493.76
284709.27
541612.37
713199.41
871301.19
1026720.21
1288246.93

Rate
策略
实际吞吐量 (req/s)
平均延迟 (ms)
平均 TTFT (ms)
平均 ITL (ms)
Latency P10 (ms)
Latency P20 (ms)
Latency P30 (ms)
Latency P40 (ms)
Latency P50 (ms)
Latency P60 (ms)
Latency P70 (ms)
Latency P80 (ms)
Latency P90 (ms)
Latency P99 (ms)
7
FCFS
2.586
474680.23
468898.90
16.96
12139.72
39409.49
98132.77
206217.19
374089.94
591257.17
782667.59
910345.75
1092569.72
1317929.00
7
SJF
2.552
482062.08
476206.06
17.25
11107.51
35944.48
87148.75
187361.00
377197.56
584500.12
850379.12
960721.33
1070491.84
1317077.25
7
LJF
2.557
478258.62
472430.57
16.92
11678.59
33315.88
86233.03
182467.39
423818.71
619668.11
774204.34
963478.11
1088382.89
1316910.82
7
BUB
2.555
478904.21
473088.54
17.17
10770.97
33640.67
85061.65
190021.33
394326.85
629092.85
754492.80
945576.68
1116481.87
1328659.99

随着请求到达速率提高,平均延迟明显增加,说明当前系统的处理能力已接近饱和。与 FCFS 相比,SJF、LJF 和 BUB 均未表现出稳定的性能优势。部分策略能够改善特定延迟分位数,但效果会随请求到达速率变化,甚至出现反转。

2.3 不同输出长度区间的平均延迟

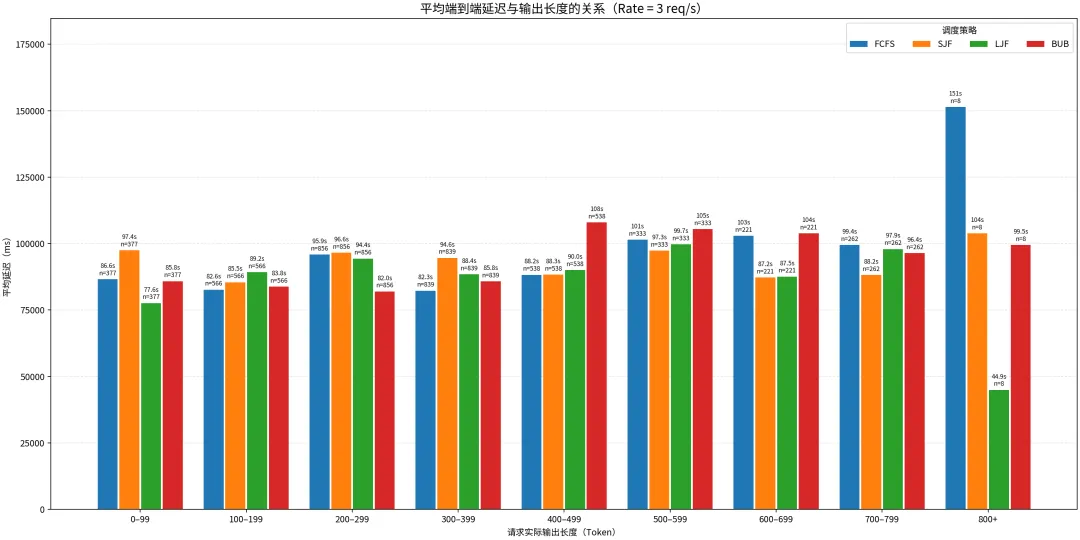
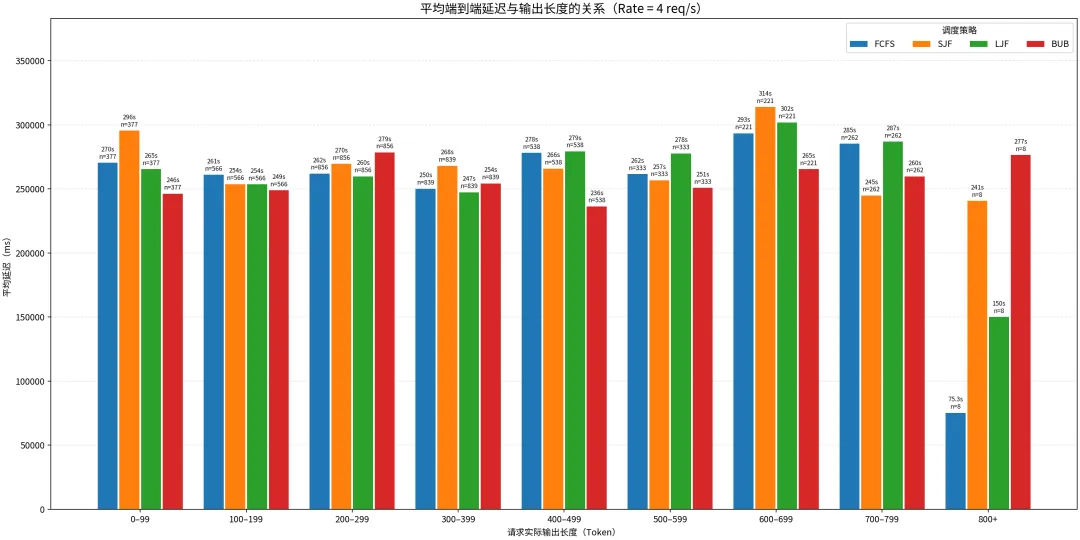
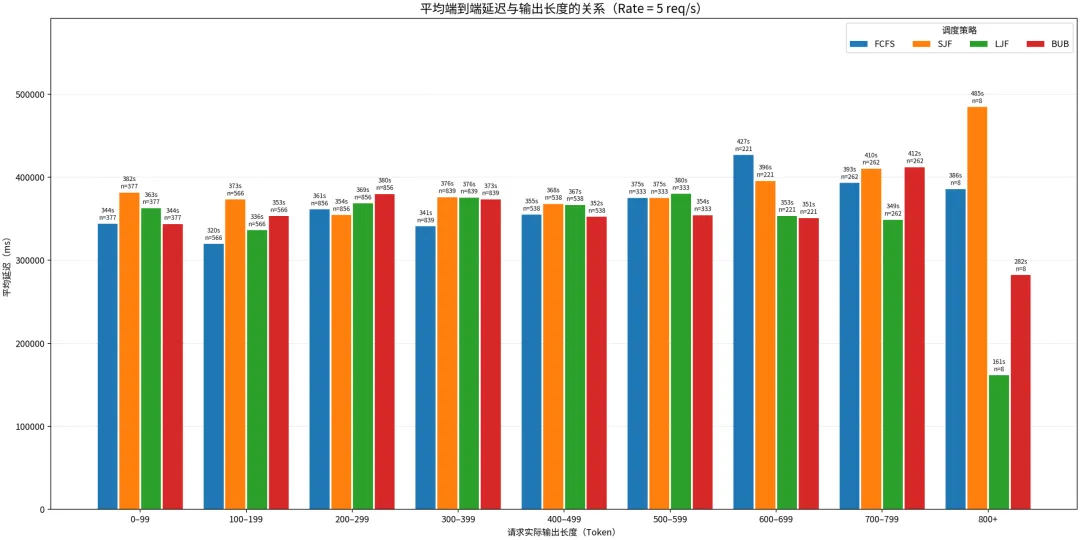
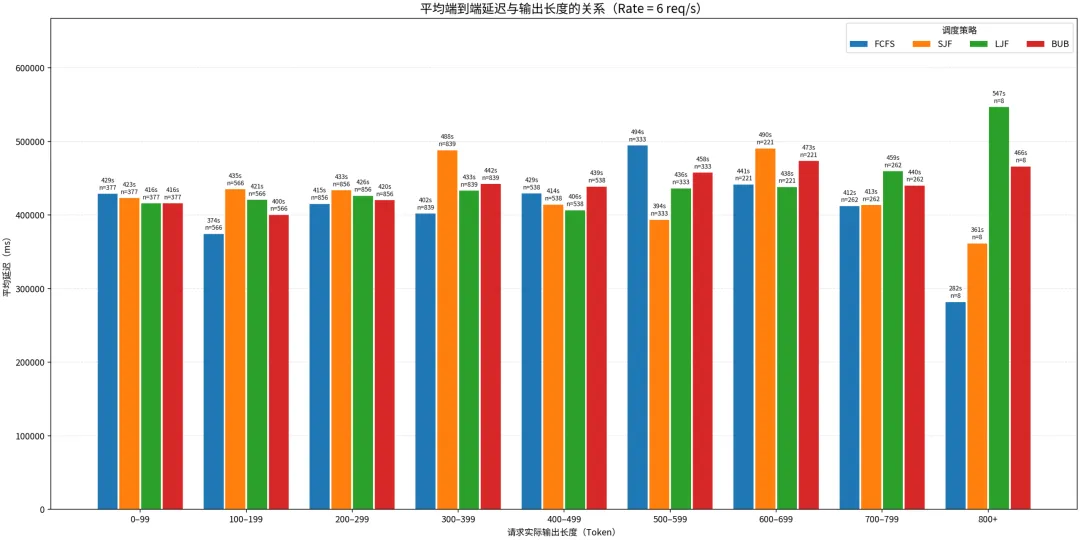
为分析不同调度策略对不同长度请求的影响,根据请求的实际输出 Token 数划分长度区间,并分别统计各区间内请求的平均延迟。下图展示了不同 Request Rate 下,FCFS、SJF、LJF 和 BUB 四种策略的对比结果。

Rate = 3
Rate = 4
Rate = 5
Rate = 6
Rate = 7
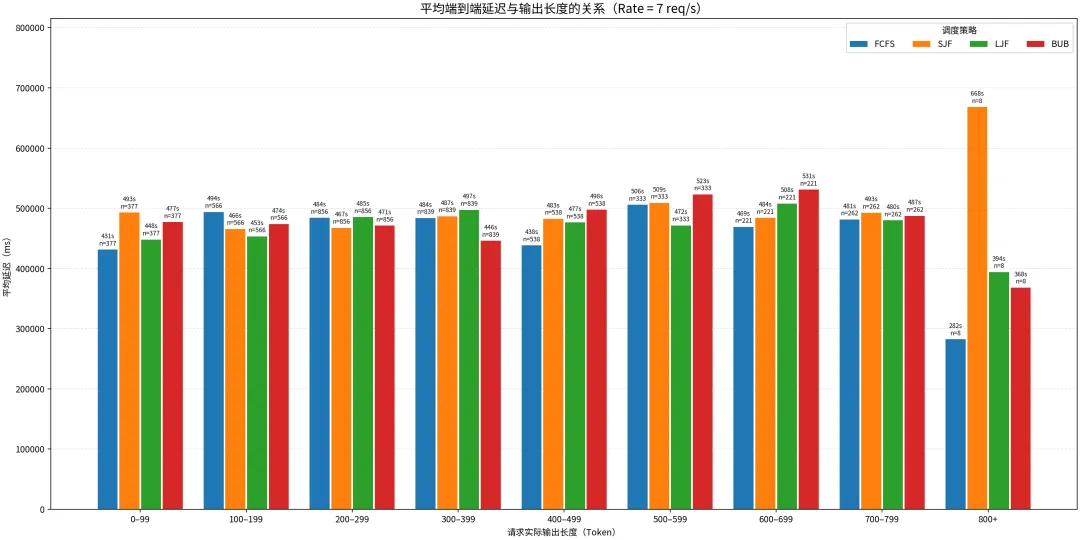
通过按输出长度分组,可以进一步观察不同策略在各长度区间内的表现。表现和之前表格中显示的结果一致。并没有明显的优化,整体上比不过FCFS。

3. 结果分析

本次实验表明,在当前模型、硬件及测试配置下,简单的请求排序策略尚未展现出稳定的整体性能提升。不过,这并不意味着这些策略在其他模型或负载条件下同样无效。不同模型的 Prefill、Decode 计算开销及资源占用可能存在差异,调度策略的实际收益仍需进一步验证。

后续需要在更大规模的模型上开展实验,并结合不同负载下的延迟分布,进一步分析各调度策略的适用条件。

如果你对这方面感兴趣可以看看这些论文:

  • • Past-Future Scheduler for LLM Serving under SLA Guarantees(ASPLOS 2025,CCF A):ligthllm就是这篇文章提出来的。结合历史输出长度分布与未来时刻的显存需求估计,优化请求准入,减少请求驱逐和排队等待。论文链接
  • • Beyond Prediction: Tail-Aware Scheduling for LLM Inference(ICML 2026,CCF A):提出无需显式预测输出长度的调度方法,通过动态优先级调整与缓存感知抢占,优化 LLM 推理的尾延迟。论文链接
  • • Scheduling LLM Inference with Uncertainty-Aware Output Length Predictions(ICML 2026,CCF A):针对输出长度预测存在的不确定性,采用概率分布描述请求输出长度,为短作业优先调度提供更合理的依据。论文链接

相关学习资料