ARTICLE · 1207870
大语言模型基于常规临床文档预测踝关节骨折分型与管理决策
往期推荐:
姜黄素与顺铂对乳腺癌细胞协同效应的AgNOR 染色机器学习评价
Instant3D:基于 TotalSegmentator 的医学图像分割与三维重建轻量级开源图形界面前端
基于影像组学与临床指标的多模态模型早期预测熊去氧胆酸应答不足
高回声环(Echogenic Rind)作为乳腺恶性病变独立诊断与预后标志物的价值
大语言模型基于常规临床文档预测踝关节骨折分型与管理决策
Large Language Models for Ankle Fracture Classification and Management Prediction from Routine Clinical Documentation: A Single-Center Exploratory Study
期刊:Journal of Imaging Informatics in Medicine(2026) DOI:10.1007/s10278-026-02311-5
作者:Benjamin Schwarberg、Conrad Ketzer、Bosse Thiel、Andreas Sauter、Marcus R. Makowski、Daniel Spitzl、Markus Mergen、Florian T. Gassert
单位:慕尼黑工业大学(TUM)医学院与健康学院、TUM 大学医院 Rechts der Isar 院区放射科/创伤外科/消化科;Markus Mergen 与 Florian T. Gassert 为共同资深作者
投稿 2026-05-28 修回 2026-09-09 接受 2026-09-09 开放获取(CC BY 4.0)
文章类型:原创研究——单中心、回顾性、探索性方法学性能评价
文献汇报整理:2026-10-18
一、研究背景与意义
踝关节骨折是创伤外科最常见的损伤之一,文献报道的年发病率约为每 10 万人 180 例,累及人群年龄与活动水平跨度很大,并与显著的致残负担和医疗资源消耗相关联。正因如此,准确的骨折分型与前后一致的病历记录,在医患沟通、治疗方案制定与结局评估三个环节上都具备直接的操作意义:分型决定了医生之间如何谈论同一个骨折,记录决定了下一位接诊者能继承多少信息,而结局评估则依赖前两者是否可被回溯与统计。
在众多分型体系中,Danis-Weber 分型(下称 Weber 分型)仍是国际上广泛接受的标准。它以腓骨骨折线相对于下胫腓联合(syndesmosis)的水平为唯一判据,把骨折平面与下胫腓联合损伤联系起来,因而可以直接指向治疗指征与手术规划:骨折位于联合以下(Weber A)通常稳定,位于联合水平(Weber B)需结合内侧结构与联合稳定性判断,位于联合以上(Weber C)则高度提示联合损伤与手术需要。这一体系的优点在于判据单一、可复述,缺点也在于判据单一——当影像描述本身对"骨折线是否位于联合水平"含糊其辞时,分型就失去了可靠落点。
尽管分型体系成熟,踝关节骨折的评估与管理在真实临床中依然复杂而高度异质。判断所需的信息分散在四个来源:影像学所见、体格检查、患者个体因素,以及放射报告与医师病程记录中的自由文本。这些信息彼此不冗余,且常常只在文本里留下痕迹——例如"内侧间隙增宽""下胫腓联合可疑""后踝骨块累及关节面超过四分之一"这类描述,往往既不在结构化字段中,也难以用关键词穷举。
常规放射报告与临床文档确实承载了相关的诊断与情境信息,但其自由文本格式、措辞异质、结构多变、详略程度不一致的特点,妨碍了可重复的解读与自动化分析。在骨科与创伤外科,人工智能研究长期集中于基于影像的机器学习模型,而常规临床文本用于支撑结构化骨折评估的潜力则研究不足。与此同时,大语言模型(large language model,LLM)已成为处理非结构化临床文本的强力工具,在放射学、临床文档与决策支持任务中的应用不断扩展,提示工程(prompt engineering)更使模型行为可以针对特定的分类与推理任务做定向适配。
然而,LLM 在骨科创伤诊疗中的角色仍未获充分界定。已有研究多集中于通用文档任务、合成或经人工整理的策展数据集、或彼此孤立的单一分类问题,对模型在常规创伤文档中表现的证据相当有限。具体到踝关节骨折,一个关键问题尚不清楚:异质的文本信息能否被 LLM 用于在同一工作流内同时生成结构化的 Weber 分型与初步的管理相关预测。作者据此提出本研究——这也是本文的立论起点,即不再追问"LLM 是否聪明",而追问"在真实书写习惯的文档上,LLM 能稳定交出什么样的结构化结果"。
二、研究目的与研究定位
本研究评价大语言模型 Llama 3.1(70B Instruct)在踝关节骨折中基于文本完成三项任务的表现:Weber 骨折分型(A/B/C)、初步的手术与非手术管理预测、以及探索性的术式类别预测。作者明确把这一定位界定为"方法学性能评价(methodological performance evaluation)",而非对自主临床决策的验证。这一句话限定非常重要,它决定了后文所有数字应当被解读为"模型能从既有文本中复现多少已记录的信息",而不是"模型能否替代医师判断"。
三项任务被赋予不同的证据地位:Weber 分型是主要终点,因此在结果部分最先、最详尽地呈现;手术与非手术管理预测是次要终点;术式类别预测因类别间异质性更高、类别不平衡更严重,被预先定义为探索性分析。四个提示策略在同一管线上被系统比较,每个任务另设"多数类基线"(majority-class baseline,即始终预测金标准分布中最常见的类别)作为参照,用以衡量模型是否只是学到了患病率。
三、研究方法
3.1 研究设计与研究对象
这是一项回顾性、探索性的计算研究,遵循所有适用的伦理与数据保护规范,并经本地机构伦理委员会批准(正文中批准号以"盲审隐藏"占位,文末声明部分给出为 2024–590-S-CB)。所有数据在分析前已完全去标识,推理与评价过程中不可访问任何可识别患者身份的信息;因研究为回顾性设计且使用完全匿名的临床数据,伦理委员会豁免了个别知情同意。
研究数据为 54 例患者在日常临床实践中产生的放射报告、临床病史与基线人口学资料,并以"待诊断评估"的形式呈现给模型。病例从单一中心机构数据库于 2020 年 2 月至 2025 年 10 月间回顾性检索,该时段内所有急性踝关节骨折记录均被筛查;作者如实说明,应用纳入排除标准之前到底筛查了多少份记录已经无法回溯。
纳入标准为仅描述首诊、孤立性急性踝关节骨折的报告;随访检查、术后报告、多发伤以及既往有踝部手术史的病例均被排除。全部病例最初均以常规 X 线摄影作为主要影像手段;当 X 线被认为不足以支持临床评估时,另有 35/54 例在术前加做 CT 并纳入评估。输入还包括术前医师记录,其中含体格检查所见与患者病史。为保留报告原有的语言特征,作者未做任何结构化预处理或人工特征提取——这一选择保证了输入贴近真实文本,但也意味着输入长度、字段顺序与表述完整度在病例之间并不一致。
需要特别说明的是,原始 X 线片与 CT 图像在推理时并未提供给模型,模型面对的只有文字。这一限制在讨论部分被反复提及,也是术式预测表现最差的结构性原因之一。
3.2 去泄漏处理与参考标准定义
为防止信息泄漏与分类偏倚,作者在分析前把所有对 Weber 或 ABC 分型的显式提及、以及所有明确的治疗或术式推荐,从自由文本输入字段(放射与 CT 报告、临床病史、查体所见)中人工删除。删除由一名研究者执行,并由第二名研究者独立核验。骨折本身的解剖学描述被刻意保留,理由是它构成分型的临床依据——作者在这一处的判断是诚实的,但也正是这条保留,构成了后文讨论中第一类"残余泄漏"的来源。
Weber 分型(A/B/C)作为主要结局变量的参考标准,取自各患者原始诊疗过程中、且至少早于本研究1 个月所记录的常规临床文档。这些分型由肌骨放射学与骨科创伤外科的执业专科医师在标准工作流中、依据原始影像与临床文档作出。由于该文档的形成早于本研究,它天然地对任何语言模型输出设盲;但也因为反映的是常规诊疗而非研究性复核,个别读片者编号与观察者间一致性数据无法获得。换句话说,金标准是"当时诊疗团队写下的结论",其可靠性未被独立量测。
手术管理与术式的参考标准来自术后 X 线、手术记录与医师出院小结。术式被归为三个更高层级的类别,以反映临床上可辨识的治疗通路而非植入物级别的细节:带下胫腓螺钉固定的腓骨切开复位内固定(Fibula ORIF + SS)、不带下胫腓螺钉固定的腓骨切开复位内固定(Fibula ORIF − SS)、以及临时固定(temporary stabilization,指不考虑后续确定性手术的临时性固定操作)。作者说明,虽然多数病例在文档中可获得诊断与治疗建议,但这些内容仅用于定义金标准,一律排除于模型输入之外。
3.3 模型推理与四种提示策略
Llama 3.1(70B Instruct)以院内安全部署的方式离线运行,符合机构的数据保护与安全政策;未做任何微调或额外训练。解码为确定性设置(temperature = 0、top_p = 0.9、关闭采样),最大输出 3000 个 token;由于解码确定,每一病例只推理一次。提示策略、输出模式与解析规则在评价开始前即已确定,此后未再修改。
研究队列共 64 例,其中 10 例按 Weber 类别与管理类别分层抽样作为少样本(few-shot)示例,抽样使用固定随机种子(42)以保证可复现;其余 54 例构成评价集,全部报告指标均在其上计算。示例集与评价集互斥,因此没有任何一个被评价病例曾以示例形式展示给模型。模型行为完全通过提示控制,共系统评价四种策略:零样本提示、进阶零样本提示(advanced zero-shot)、少样本提示,以及要求逐步推理的思维链式(chain-of-thought)提示——后者只评价最终答案,不评价推理过程。
一个统一的提示框架在同一次推理调用内完成三项独立任务,任务特异的行为通过显式指令块与任务特异文本片段实现;所有提示都约束模型对每项任务只返回一个离散输出。任务之间彼此独立、分别保存与评价,唯一的例外是:当模型预测非手术管理时,术式类别被置为"not classified",因为在建议不做手术的同时推荐具体技术,在临床上是不自洽的。
除既定类别外,模型还可以返回不表态的输出,标记为"UNK",适用于 Weber 分型与手术管理预测;术式类别对应的不表态值为"not classified"。UNK 在准确率中计为错误;宏平均 F1 在三个 Weber 类别(A、B、C)上计算,不把 UNK 当作第四个零支持类别;UNK 频次单独报告。混淆矩阵被限制在已定义的临床类别内,因此剔除了 UNK 预测,其分母会略低于该类别在全集中的真实例数。整套工作流如图 1 所示。
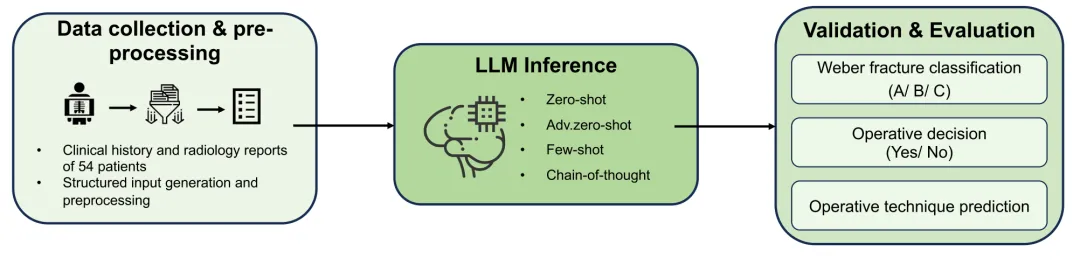
图1(原文Fig. 1)研究流程与LLM推理管线示意图。在对临床文档完成数据采集与预处理之后,以零样本、进阶零样本、少样本与思维链四种提示方式应用Llama 3.1(70B),为Weber骨折分型、手术管理决策预测与探索性术式类别预测生成结构化输出。
Fig. 1Schematic overview of the study workflow and LLM inference pipeline. Following data acquisition and preprocessing of clinical documentation, Llama 3.1 (70B) was applied using zero-shot, advanced zero-shot, few-shot, and chain-of-thought prompting to generate structured outputs for Weber fracture classification, operative management prediction, and exploratory procedure category prediction.
3.4 结局指标与统计分析
三项任务分别评价。多分类结局(Weber 分型与探索性术式类别预测)使用准确率、精确率、召回率与 F1 得分,并同时报告微平均(micro-averaged)与宏平均(macro-averaged)两种口径:微平均先在全样本上合计真阳性、假阳性与假阴性再计算指标,强调总体分类表现;宏平均先对每个类别独立计算再等权平均,从而不论患病率高低都给各类别相同的重要性。手术与非手术管理预测按二分类结局处理,使用敏感度、特异度、精确率、召回率与准确率。术式类别预测仅在确认实施了手术的病例上评价。
由于只有在模型预测手术管理时才会请求术式类别,作者设计了两个互补的终点:分层通路准确率(hierarchical pathway accuracy)以全部 47 例手术病例为分母,凡是模型预测为非手术(因而不返回术式类别)者一律计为错误;术式选择准确率(procedure selection accuracy)只在模型确实返回了术式类别的病例中计算,从而把"术式选择"与前置的"是否手术"决策分离开来。
统计分析在 Python 中完成(pandas 2.3.3、scikit-learn 1.4.0)。95% 置信区间用非参数 bootstrap 重抽样 10 000 次估计。为在考虑配对设计的前提下比较四种提示策略,先以 Cochran Q 检验作总检验,在总检验显著时再行成对 McNemar 检验,并以 Holm 法校正多重比较。每个任务另与多数类基线比较,基线定义为始终预测该任务金标准分布中最常见的类别。
四、研究结果
4.1 Weber 分型的总体性能
Weber 分型是本文的主要分析焦点,因此最先并以最详尽的方式呈现。四种提示策略下总体准确率在 0.759 至 0.815 之间,微平均 F1 与准确率完全相同(表 1)。少样本提示取得数值最高的准确率 0.815,零样本最低,为 0.759;但两者的 95% 置信区间大幅重叠,Cochran Q 检验对逐例正确性的比较未发现策略间差异(Q = 2.31,df = 3,P = 0.51)。因此可以认为,Weber 分型的准确率在四种提示策略之间是可比的,提示方式并没有系统性地改变模型的分型能力。
表1(原文 Table 1)不同提示策略下 Weber 分型的总体性能。准确率与宏平均 F1 及 95% 置信区间。微平均 F1 与准确率数值相同,故未单独列出。
Table 1Weber classification overall performance across prompting strategies. Accuracy and macro-averaged F1 with 95% confidence intervals. Micro-averaged F1 equals accuracy and is therefore not shown separately.
指标 | 零样本 | 进阶零样本 | 少样本 | 思维链 |
准确率 | 0.759(95% CI 0.648–0.870) | 0.796(95% CI 0.685–0.907) | 0.815(95% CI 0.704–0.907) | 0.778(95% CI 0.667–0.889) |
宏平均F1 | 0.744(95% CI 0.582–0.867) | 0.790(95% CI 0.628–0.904) | 0.822(95% CI 0.641–0.928) | 0.755(95% CI 0.596–0.875) |
注:宏平均 F1 在 Weber A、B、C 三类上等权平均,不把 UNK 计为零支持类别;置信区间为 10 000 次非参数 bootstrap 估计。
所有策略都显著超过了多数类基线 0.556,该基线由始终预测最常见类别(Weber B,54 例中 30 例)得到。宏平均 F1 在 0.744 至 0.822 之间,与准确率相差不大,这一细节值得停留:如果少数类(A 与 C)的表现明显劣于 B,宏平均 F1 就会被拉低并明显低于准确率;两者接近,说明 Weber A 与 C 的表现只是"中等程度"地低于 B,而不是崩塌。换一个角度说,模型并非仅靠预测患病率最高的类别来刷高准确率。
4.2 各类别性能
三个 Weber 类别之间的性能差异是清楚的。在全部提示策略下,Weber B 的类内表现最高,F1 值分别为零样本 0.852、进阶零样本 0.888、少样本 0.867、思维链 0.881,不仅数值高,而且策略之间的波动极小。Weber A 的表现较低且对策略敏感,F1 依次为 0.667、0.769、0.800 与 0.625,跨度接近 0.18。Weber C 处于中间位置,零样本与进阶零样本均为 0.714,少样本升至 0.800,思维链为 0.759。
这些类内差异在 F1 雷达图上一目了然(图 2)。作者据此提出一个值得注意的解释:提示策略改变的是误分类在类别之间的分布,而不是类别之间的性能排序;Weber B 的优势在四种配置下都保持稳定,A 与 C 的波动则随策略而变。逐类别的完整数字见表 2(由原文表 2 至表 5 合并)。
表2(原文 Table 2–Table 5 合并)四种提示策略下 Weber 骨折分型的逐类别性能。末行为各策略的总体准确率与总例数。
Table 2 (Tables 2–5 combined)Class-wise performance of zero-shot, advanced zero-shot, few-shot, and chain-of-thought prompting for Weber fracture classification; the last row of each block gives overall accuracy and total n.
提示策略 | Weber类别 | 精确率 | 召回率 | F1得分 | 例数n |
零样本 | A | 0.556 | 0.833 | 0.667 | 6 |
B | 0.839 | 0.867 | 0.852 | 30 | |
C | 1.000 | 0.556 | 0.714 | 18 | |
准确率 | — | — | 0.759 | 54 | |
进阶零样本 | A | 0.714 | 0.833 | 0.769 | 6 |
B | 0.848 | 0.933 | 0.888 | 30 | |
C | 1.000 | 0.556 | 0.714 | 18 | |
准确率 | — | — | 0.796 | 54 | |
少样本 | A | 1.000 | 0.667 | 0.800 | 6 |
B | 0.867 | 0.867 | 0.867 | 30 | |
C | 0.823 | 0.778 | 0.800 | 18 | |
准确率 | — | — | 0.815 | 54 | |
思维链 | A | 0.500 | 0.833 | 0.625 | 6 |
B | 0.897 | 0.867 | 0.881 | 30 | |
C | 1.000 | 0.611 | 0.759 | 18 | |
准确率 | — | — | 0.778 | 54 |
注:原文将四种提示策略分别列为表 2、表 3、表 4、表 5,此处按策略纵向合并以便对照;各单元格数值与原表逐字一致(原表 Weber C 的精确率为"1"者此处统一写作 1.000)。原文正文称进阶零样本 Weber B 的 F1 为 0.889,而表 3 给出 0.888,属排版层面的末位差异,本表从原表取 0.888。
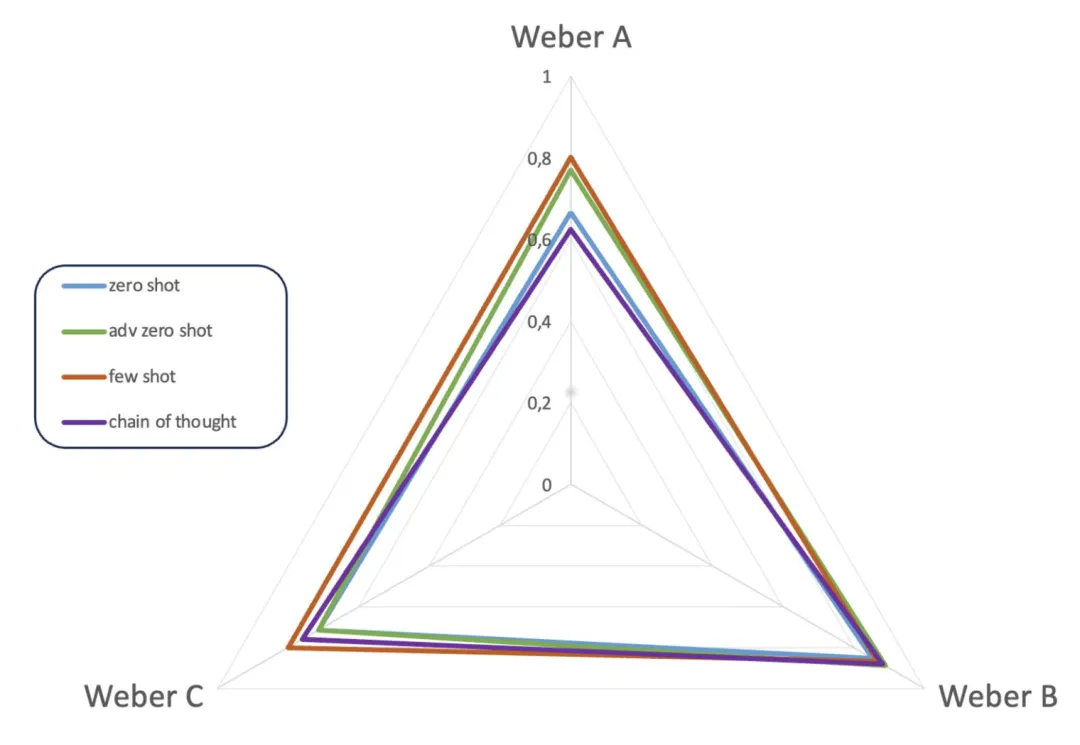
图2(原文Fig. 2)不同提示策略下Weber骨折分型的各类别F1得分。雷达图显示Weber A、B、C三类骨折的F1值:零样本(A=0.67、B=0.85、C=0.71)、进阶零样本(A=0.77、B=0.89、C=0.71)、少样本(A=0.80、B=0.87、C=0.80)与思维链(A=0.63、B=0.88、C=0.76)。
Fig. 2Class-wise F1 scores for Weber fracture classification across prompting strategies. Radar chart illustrating F1 values for Weber A, B, and C fractures: zero-shot (A = 0.67, B = 0.85, C = 0.71), advanced zero-shot (A = 0.77, B = 0.89, C = 0.71), few-shot (A = 0.80, B = 0.87, C = 0.80), and chain-of-thought (A = 0.63, B = 0.88, C = 0.76).
4.3 混淆矩阵与错误模式
混淆矩阵分析显示,四种提示策略下的误分类模式高度一致(图 3)。剔除 UNK 后,进入矩阵的 Weber B病例在各策略下均为 28 例;Weber C 在三种策略下为 17 例、在少样本下为 18 例;Weber A 为 5 例。以零样本为例,矩阵逐格为:真实 A 行 5/0/0,真实 B 行 2/26/0,真实 C 行 2/5/10;进阶零样本为 A 5/0/0、B 0/28/0、C 2/5/10;少样本为 A 4/0/1、B 0/26/2、C 0/4/14;思维链为 A 5/0/0、B 2/26/0、C 3/3/11。
从这些格子可以直接读出结论。Weber A 的分类高度一致,仅有罕见且非系统性的误判(少样本中 1 例A 被误判为 C)。Weber B 在所有配置下最可靠,28 例中正确 26 至 28 例。残余错误几乎全部落在 Weber C,其正确例数随策略在 10 至 14 例之间变动——这是四种策略之间唯一的实质性差别所在。零样本与思维链的错误分布几乎相同,B 类识别稳定、残余混淆集中在 C;进阶零样本减少了 B 类的误判,C 类的模式基本不变;少样本则把更多 C 类判对,代价是 A 与 B 出现了少量新增误判。
更宏观地看,误分类主要发生在相邻类别之间,以 Weber C 与 B 之间的混淆最多,A 与 C 之间相对较少。提示策略主要影响这些错误的频次而非其结构,因此四种配置的混淆图样极为相似。UNK 出现的频次很低且各策略相近(零样本 4、进阶零样本 4、少样本 3、思维链 4),对应确定性 Weber 判断的覆盖率为 92.6% 至 94.4%。作者强调,宏平均 F1 是在三个 Weber 类别上计算的,UNK 频次在此单独报告,而不作为额外的零支持类别参与平均。
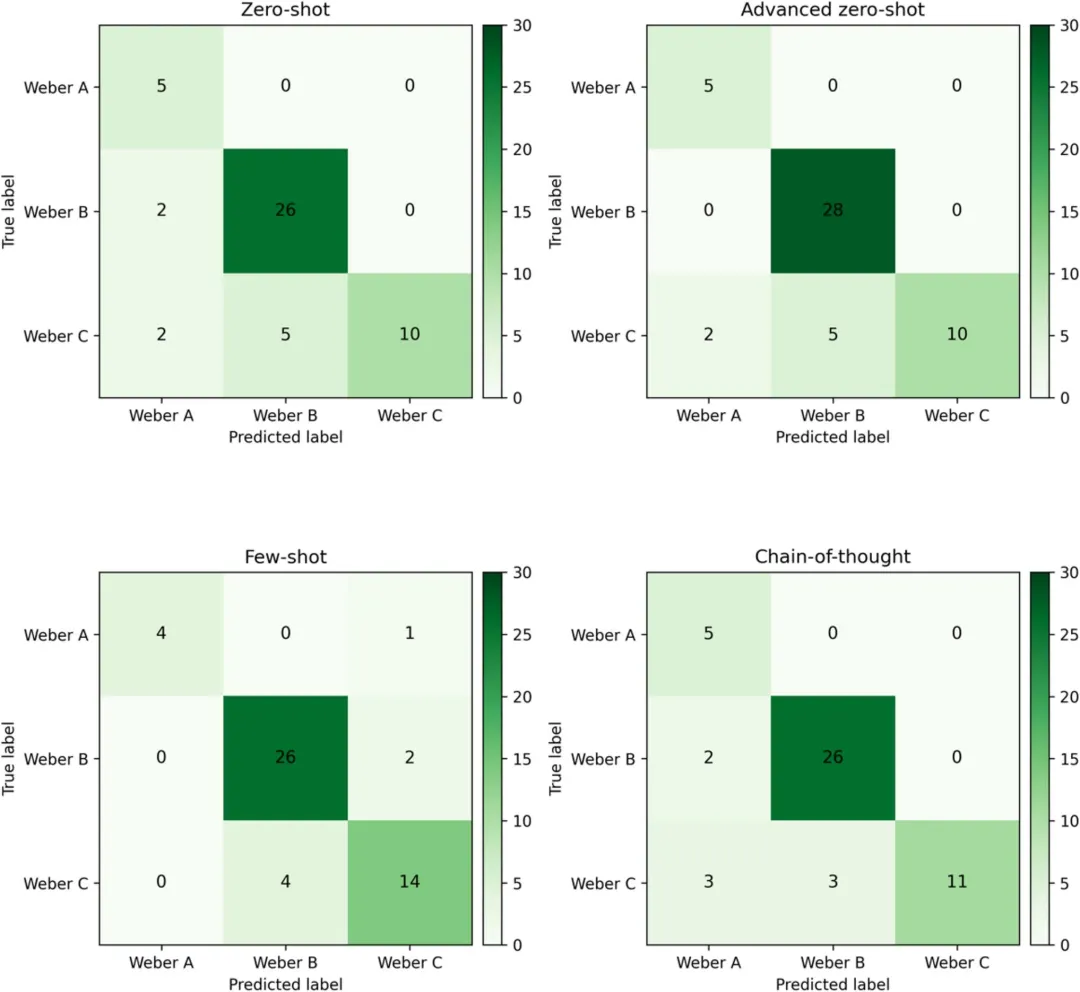
图3(原文Fig. 3)不同提示策略下Weber骨折分型的混淆矩阵。行为真实Weber类别,列为预测类别。分别展示零样本、进阶零样本、少样本与思维链提示的结果,说明Weber A、B、C骨折的正确分类与误分类分布。
Fig. 3Confusion matrices for Weber fracture classification across prompting strategies. Rows represent the true Weber class and columns the predicted class. Results are shown for zero-shot, advanced zero-shot, few-shot, and chain-of-thought prompting, illustrating the distribution of correct classifications and misclassifications across Weber A, B, and C fractures.
4.4 手术与非手术管理预测
手术与非手术管理预测的性能汇总于表 3 与图 4。四种策略的准确率为 0.833 至 0.963,敏感度 0.872 至 1.000,特异度 0.571 至 0.714。逐例正确性的 Cochran Q 检验提示四策略之间存在总体差异(Q = 13.39,df = 3,P = 0.004)。最大的成对差异出现在少样本与思维链之间,精确 McNemar 检验 P = 0.016,但在 Holm 校正后不再显著(所有校正后 P > 0.09)。作者因此明确提示,少样本在数值上更高的准确率(0.963)应当谨慎解读。
表3(原文 Table 6)不同提示策略下 Weber 骨折手术与非手术管理预测的性能指标。含使用零样本、进阶零样本、少样本与思维链提示预测手术与非手术管理的准确率、敏感度、特异度与精确率。
Table 6Performance metrics for operative versus nonoperative management predictions in Weber fractures across prompting strategies. Accuracy, sensitivity, specificity, and precision for predicting operative versus nonoperative management using zero-shot, advanced zero-shot, few-shot, and chain-of-thought prompting.
提示策略 | 准确率 | 敏感度 | 特异度 | 精确率 | 平衡准确率 |
零样本 | 0.852 | 0.894 | 0.571 | 0.933 | 0.733 |
进阶零样本 | 0.870 | 0.915 | 0.571 | 0.935 | 0.743 |
少样本 | 0.963 | 1.000 | 0.714 | 0.959 | 0.857 |
思维链 | 0.833 | 0.872 | 0.571 | 0.932 | 0.722 |
注:最右列"平衡准确率"原文未列表,系按(敏感度 + 特异度)/2 由表中数值推算,结果为 0.733、0.743、0.857 与 0.722,与正文所述"平衡准确率 0.722–0.857"的区间端点完全吻合。
这一节的数字必须与样本构成一起读。非手术病例只有 7 例,因此特异度的每一次变动都是 1/7 ≈ 0.143,精确二项 95% 置信区间宽达约 0.18–0.90(少样本为 0.29–0.96)。换言之,"特异度 0.714"实际上就是 7 例中的 5 例,与零样本的 4/7 只差一例,而这一例的差别正是 Cochran Q 检验得出 P = 0.004 的主要驱动力。等权处理两个类别的平衡准确率在 0.722 至 0.857 之间,这一口径下策略间的差距更接近真实情况。
少样本提示在手术治疗病例中未产生任何"非手术"的矛盾预测(敏感度 1.000),其余策略则出现了少量此类矛盾预测。这类输出在真实应用中具有直接的临床相关性——把一个需要手术的患者判为非手术,其代价远高于反向错误——因此作者特意将其单列,而未将其混入总体准确率中一笔带过。
与基线的对照最能说明问题的性质。始终预测"手术"的多数类基线可达 0.870 的准确率,却一个非手术病例也识别不出,特异度为零;而在成对精确 McNemar 检验中,少样本提示相对该基线并未显著更优(P = 0.063)。反过来说,四种策略都达到了 0.571 至 0.714 的特异度,说明模型确实捕捉到了支持非手术判断的临床信号,而不只是默认了占优类别——尽管手术病例构成了队列的绝大多数(54 例中 47 例)。
混淆矩阵显示各策略的分类模式高度一致(图 5)。手术病例在所有配置下都被高准确率地识别,错误主要集中在非手术组;策略之间的差异主要由非手术病例假阳性与假阴性数目的不同驱动,手术组的判读则保持稳定。手术病例中出现矛盾"非手术"预测的例数在不同策略下为 0 至 6 例。作者据此指出,提示设计影响的是误分类的分布而非其总体结构;同时认为手术决策预测优于术式预测,很可能反映二分类管理任务本身更结构化,而术式规划是多分类、且复杂得多的任务。
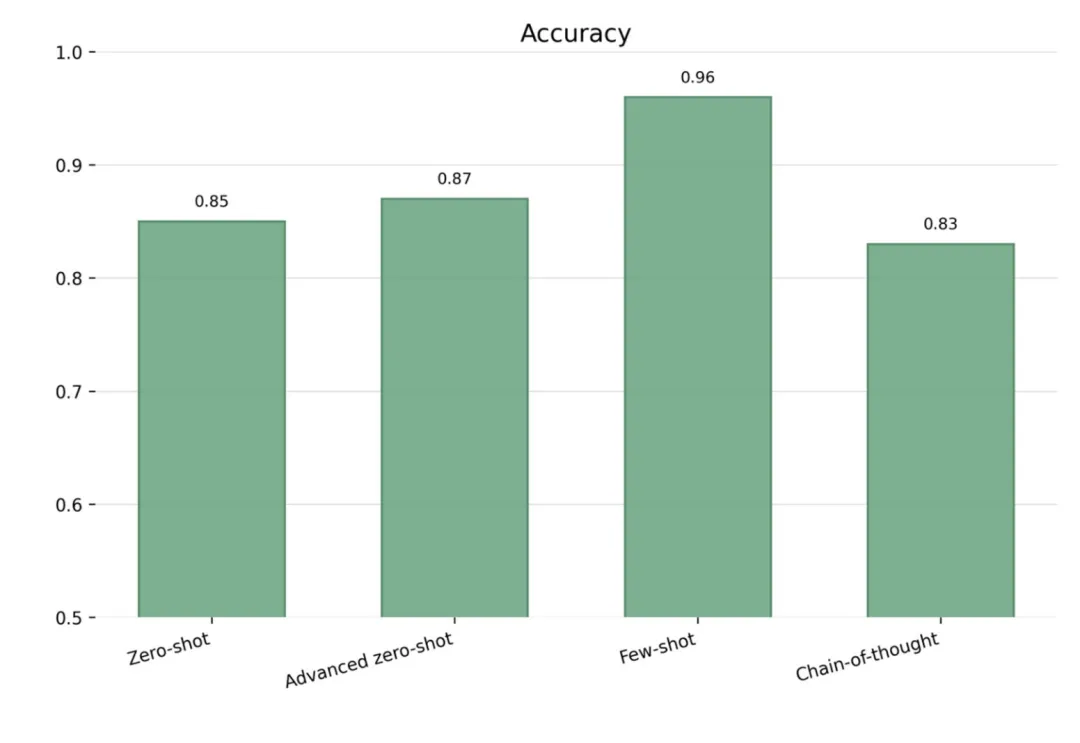
图4(原文Fig. 4)不同提示策略下手术管理决策预测的准确率。使用零样本、进阶零样本、少样本与思维链提示预测手术与非手术管理的总体准确率。
Fig. 4Accuracy of operative management prediction across prompting strategies. Overall accuracy for predicting operative versus nonoperative management using zero-shot, advanced zero-shot, few-shot, and chain-of-thought prompting.
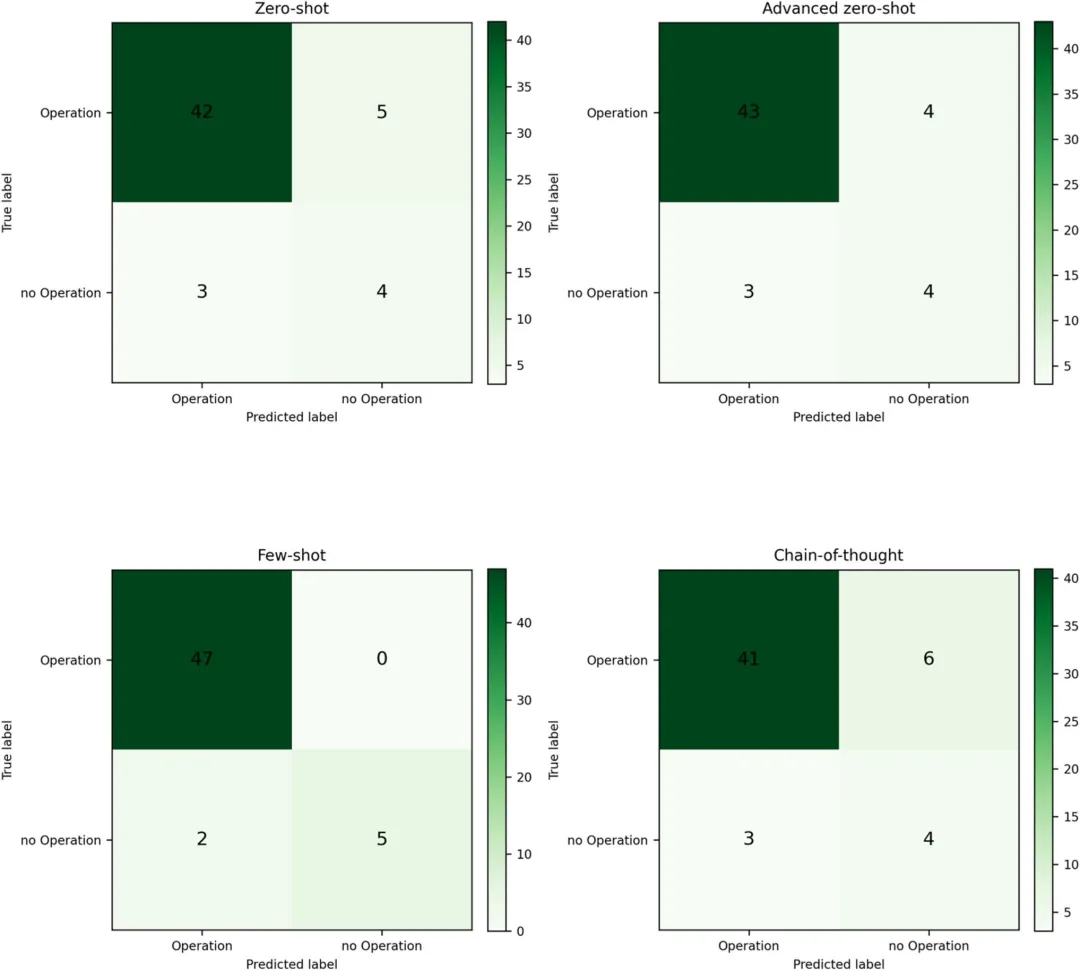
图5(原文Fig. 5)不同提示策略下手术管理决策预测的混淆矩阵。行为真实标签(手术与非手术),列为预测标签。分别展示零样本、进阶零样本、少样本与思维链提示的结果,说明治疗指征判断的正确分类与误分类。
Fig. 5Confusion matrices for operative management prediction across prompting strategies. Rows represent the true label (operative vs. nonoperative) and columns the predicted label. Results are shown for zero-shot, advanced zero-shot, few-shot, and chain-of-thought prompting, illustrating correct classifications and misclassifications for treatment indication.
4.5 术式类别预测(探索性分析)
术式类别预测只在有手术金标准的病例中进行(54 例中的 47 例),并按探索性结局处理。术式分布为:带下胫腓螺钉固定的腓骨 ORIF 26 例、不带下胫腓螺钉固定的腓骨 ORIF 19 例、临时固定 2 例,类别不平衡相当严重。
以全部 47 例手术病例为分母的分层通路准确率为 0.426 至 0.532,等于或低于 0.553 的多数类基线(基线由始终预测最常见类别 ORIF + SS 得到)。只在模型确实返回了术式类别的病例中计算的术式选择准确率(各策略 41 至 47 例)为 0.426 至 0.610,其中只有思维链提示超过了多数类基线。类内表现随技术而异:ORIF + SS 的 F1 为 0.468 至 0.691,ORIF − SS 为 0.222 至 0.457,而临时固定在任何提示配置下都从未被正确识别(精确率 = 召回率 = F1 = 0.000);模型偶尔会把病例判入该类别,但与两个真实病例都不匹配。逐例正确性的 Cochran Q 检验显示四种策略之间无显著差异(Q = 3.40,df = 3,P = 0.33)。作者据此得出结论:仅凭常规文本无法可靠地推导出具体的术式类别;考虑到手术病例数很少、任务本身为探索性质,策略之间的差异尤应谨慎解读。各类别 F1 的对比见图 6。
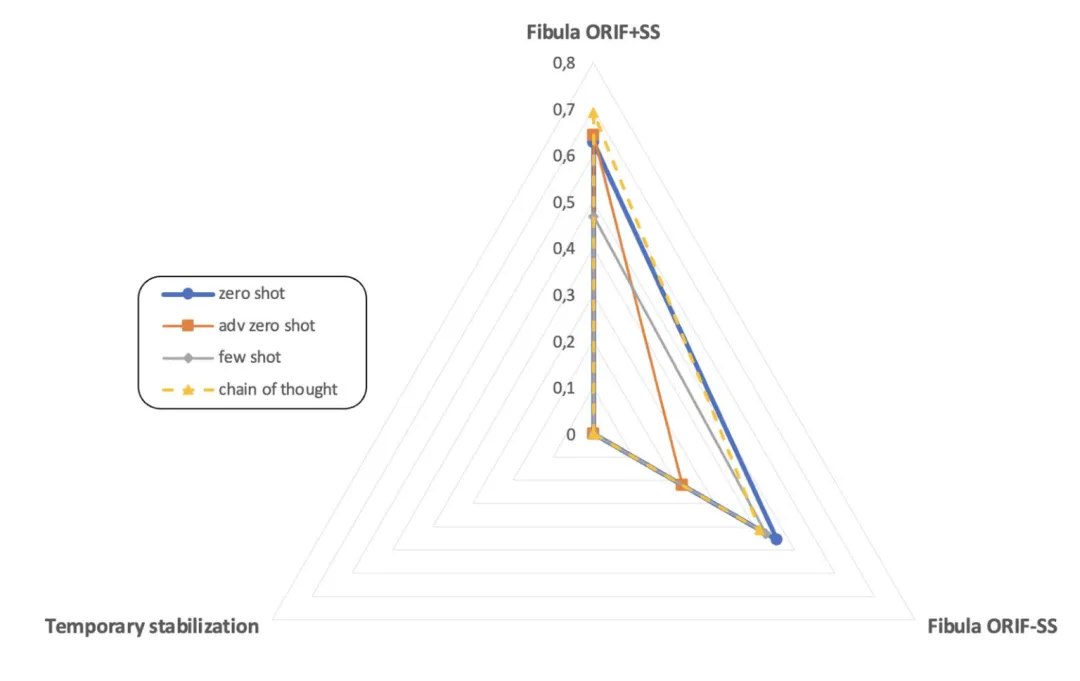
图6(原文Fig. 6)分层术式类别分析在不同提示策略下的各类别F1得分。雷达图显示带下胫腓螺钉固定的腓骨切开复位内固定(ORIF+SS)、不带下胫腓螺钉固定的腓骨切开复位内固定(ORIF−SS)与临时固定三类,在零样本、进阶零样本、少样本与思维链提示下的F1得分。
Fig. 6Class-wise F1 scores for the hierarchical procedure category analysis across prompting strategies. Radar chart illustrating F1 scores for fibula ORIF with syndesmotic screw fixation (ORIF + SS), fibula ORIF without syndesmotic screw fixation (ORIF − SS), and temporary stabilization using zero-shot, advanced zero-shot, few-shot, and chain-of-thought prompting.
4.6 结果的自洽性核验
在整理上述数字时,本文对原文给出的一系列结果做了交叉复算,总体一致性良好,这提高了对其余数字的信任度。Weber 分型的准确率与混淆矩阵逐格吻合:四策略正确例数分别为 5 + 26 + 10 = 41、5 + 28 + 10 = 43、4 + 26 + 14 = 44、5 + 26 + 11 = 42,除以 54 分别得到 0.759、0.796、0.815 与 0.778,与表 1 及正文完全一致;各策略 UNK 数为 4/4/3/4,与"进入矩阵的 B 类 28 例(真实 30 例)"及"C 类 17 或 18 例(真实 18 例)"的差额也相互对应。
手术管理预测同样自洽:零样本矩阵为 42 + 5 / 3 + 4,正确 46 例,46/54 = 0.852;进阶零样本 43 + 4 = 47 例,47/54 = 0.870;少样本 47 + 5 = 52 例,52/54 = 0.963;思维链 41 + 4 = 45 例,45/54 = 0.833,与表 3 和图 4 上的标注逐一对应。由矩阵反推的敏感度(42/47 = 0.894、43/47 = 0.915、47/47 = 1.000、41/47 = 0.872)、特异度(4/7 = 0.571、4/7、5/7 = 0.714、4/7)与精确率(42/45 = 0.933、43/46 = 0.935、47/49 = 0.959、41/44 = 0.932)亦完全吻合。
宏平均 F1 也可由逐类 F1 复算:零样本 (0.667 + 0.852 + 0.714)/3 = 0.744,进阶零样本 (0.769 + 0.888 + 0.714)/3 = 0.790,少样本 (0.800 + 0.867 + 0.800)/3 = 0.822,思维链 (0.625 + 0.881 + 0.759)/3 = 0.755,与表 1 的 0.744/0.790/0.822/0.755 一致。唯一明显的瑕疵是正文把进阶零样本 Weber B 的 F1 写作 0.889,而原表 3 为 0.888,属末位舍入层面的排版差异,不影响任何结论。此外,术式选择准确率的上限 0.610 按 41 例分母反推约为 25 例正确,与分层通路准确率上限 0.532(47 例中约 25 例)同量级,提示思维链策略下模型对手术病例几乎都给出了类别,两个终点的差距主要来自分母而非能力差异。
五、讨论
本研究最核心的结论是一个任务依赖的分层:当任务由标准化判据与明确记录的特征定义时,LLM 能从常规非结构化文档中较可靠地抽取结构化信息;当任务需要整合更广泛的临床情境、影像信息与术中因素时,表现迅速跌落。Weber 分型准确率 0.759–0.815、手术管理预测 0.833–0.963,而术式类别预测的分层通路准确率仅 0.426–0.532、术式选择准确率 0.426–0.610,大体处于或低于多数类基线 0.553。这一"标准化任务好、程序性任务差"的对比,比任何单一数字都更能定义该技术当前的能力边界。
Weber 分型为何表现最好,作者给出的解释具有解剖学基础,也顺带解释了错误的分布。分型错误主要发生在类别边界,即 Weber B 与 C 之间,以及较少见的 Weber A 与 C 之间;这些恰是"骨折线与下胫腓联合的确切关系无法仅凭文本描述确定"的边界性骨折形态。反之,在形态明确的病例中,腓骨骨折相对下胫腓联合的解剖水平往往在放射报告中被显式写出。由于 Weber 体系本质上由这一条解剖判据决定,模型在多数病例中只需依赖相对直接的文本线索——这既解释了为何表现高于基线,也提示高分的性质是"提取已记录的特征"而非"独立推断"。
手术管理预测的表现需要拆开看。由于手术病例占绝大多数,高准确率部分反映的是类别不平衡,而不完全是任务难度;真正有临床信息量的观察是模型的零特异度被打破了,它识别出了一部分非手术的少数派,但这一能力在配对检验中并未获得统计学确立,且置信区间很宽,可靠性受限。作者在此处没有把 0.963 当作卖点的做法值得肯定,这是本文在表述上相对克制的地方。
术式类别预测的变异性最大,反映其复杂度确实高于骨折分型与二分类管理决策。作者对此的解释是双向的:一方面,三个术式类别是策略层面的宽泛治疗通路定义,并不捕捉手术管理的全部程序学细节(例如螺钉数量与构型、是否同时固定后踝);另一方面,把术式选择与前置的手术决策分离后,性能只是略有提升,而超过多数类基线的仅有一个策略,最小的类别(临时固定)从未被正确识别。因此"具体术式无法仅凭常规文本可靠推导"这一结论是稳固的。
本文在转化定位上的表述是清楚且值得援引的。研究直接以常规放射报告与医师文档为输入,模型必须解读异质、部分非结构化的临床信息,这贴近真实文档条件,也因此增强了结果的可迁移性;与依赖策展数据集或孤立影像输入的做法不同,本文评价的是临床相关信息嵌在叙述性报告中而非结构化数据中的场景。从这类文本源导出结构化输出的能力,可能支持分类工作流、提高文档一致性、并促成初步的管理相关分层,尤其适用于文档标准化、研究数据抽取、登记库流程与质量保证。但作者同时明确:这些输出是"复述已记录的分类与已观察到的管理通路",而非独立的影像阅片,因此它们展示的是结构化抽取的可行性,而不是临床就绪度,其恰当定位是支持而非替代直接阅片或外科层面的决策。
在文献脉络上,作者把本研究定位在两条既有工作之间。其一是 LLM 在临床自然语言处理中的广泛应用(报告摘要、信息抽取、临床问答),但多数研究集中于通用文档工作流或狭义诊断问题,常用策展数据集、模拟病例或基准场景,而非真实临床决策情境;其二是骨科创伤的人工智能研究,长期偏重基于影像的骨折检测与分类,基于文本的临床自然语言处理仍属薄弱环节,早期研究虽已探索从放射报告自动抽取骨折信息、以及用机器学习推断手术指征,但多针对孤立任务,而非把骨折分型、初步管理预测与术式类别评估整合进同一分析框架。本研究的增量因此有三点:在单一纯文本工作流内同时评价三项任务;在真实文档条件下系统比较提示策略;并给出各任务的能力分级。
六、研究局限
作者自述的局限可以归为五类。其一是样本与场景:54 例的较小队列与单中心设置限制了统计功效与可推广性,常规自由文本在内容与详略程度上的变异也可能影响模型表现。其二是输入的信息覆盖:原始 X 线与 CT 图像未提供给模型,而后踝累及、下胫腓不稳、软组织状态、合并症与患者个体风险因素这些临床上相关的因素,可能在可得文本中被不完整地捕捉。其三是设计层面:回顾性设计无法评估临床影响、安全性与工作流整合。其四是缺乏校准用的比较组:模型输出未与"从同一份文本中抽取同样信息的临床医师"对照,因此无法判断该准确率相对于人类表现处于何种位置;同时只评价了单一开源模型,既无前沿闭源模型,也无传统自然语言处理基线,因而无法区分错误究竟来自模型能力的局限,还是来自源文本中本就缺失所需信息。其五是少样本示例的稳健性:示例由单一固定种子选出,未考察 few-shot 性能对示例选择的敏感性。
除上述之外,作者还专门披露了两类残余泄漏,这一点在同类研究中并不常见。第一类与分型的定义方式直接相关:由于 Weber 分型本身就由腓骨骨折相对下胫腓联合的水平定义,即便显式的 Weber 标签被删去,这段解剖学描述也必然保留在放射报告中,因此高分部分反映的是"抽取已记录的解剖特征"而非完全独立的推断。第二类来自医师记录:病程记录中可能仍含指向后续管理通路的间接线索,例如对不稳定的描述、对下胫腓联合的顾虑、或术前计划的痕迹,这些线索的贡献在本数据中无法与真正的推断完全分离。
在作者自述之外,本文整理时还注意到三处报告层面的缺口。第一,报告的语言与书写模板未在正文说明:单中心德语区医院的报告语种、是否经自动模板生成、字段顺序是否统一,都会显著影响 LLM 的抽取表现,缺少这一信息使外部复现的难度上升。第二,代码与详细基础设施说明(服务框架及版本、量化方式、tokenizer 配置、硬件)声明因机构限制不公开;对 70B 参数模型而言,4-bit 量化与全精度在细粒度分类上的差异可达数个百分点,这一缺失直接影响结果的可比性。第三,方法部分把伦理批准号写作"盲审隐藏",而文末声明给出的批准号为 2024–590-S-CB,前后不一致;同时"应用纳入排除标准前筛查记录数无法回溯"也意味着缺少一张标准的病例筛选流程图,读者无法核对排除过程。
七、结论
作者给出的结论与其结果匹配:在这项探索性研究中,大语言模型能够从踝关节骨折诊疗的常规非结构化文档中抽取结构化信息,但在三项任务上的表现差异显著。Weber 分型最强,提示基于文本的 LLM 未来可能支持文档标准化、结构化骨折评估与二次数据抽取;手术管理预测在多数病例中与已记录的治疗通路一致,但在配对检验中未超过多数类基线,因此应被视为探索性结果,不能当作对自主临床决策的验证;术式类别预测的表现大体停留在多数类基线附近或以下,凸显了纯文本路径在手术规划上的约束。作者提出,在考虑临床落地之前,需要在更大规模、多中心的队列中验证,并采用融合影像与更广泛患者个体情境的多模态模型。
八、可改进点与延伸思考
8.1 参考标准与"抽取"之间的混淆,是全文最关键的方法学问题
Weber 分型的金标准取自同一批放射报告与临床文档,作者虽然删去了所有显式的 Weber/ABC 标签,但按定义必须保留的解剖描述(腓骨骨折线相对下胫腓联合的水平)恰恰就是分型的判据本身。这意味着 0.759–0.815 这个数字更准确的解读是"模型从文本中复现已记录解剖判据的准确率",而不是"模型具备独立的影像分型能力"。作者在讨论中把这一点作为残余泄漏坦然写出,态度可取,但由此产生的后果没有被充分推到结论层面:报告中"well above majority-class baseline"的比较,实际上是与一个几乎不含信息的基线相比,说服力有限。若要真正评估分型能力,应以独立的影像复核(两名肌骨放射医师对原始 X 线/CT 盲法判读,并报告观察者间一致性)作为金标准,同时把输入限制为不含解剖结论的文本,或直接改为影像输入。
8.2 缺少规则基线与人工基线,使"高于基线"的说服力不足
Weber 体系由单一解剖判据决定,而放射报告中该判据常被显式写出,因此在补一个正则表达式或关键词加简单规则的基线之前,无法判断 0.81 究竟接近信息上限还是远低于更朴素的方案。一个以"外踝骨折线是否达到/超过下胫腓联合水平"为规则的传统自然语言处理基线很可能达到相近水平,而成本低几个数量级。同理,作者已把"未与临床医师头对头比较"列为局限,但这个比较恰恰是本类研究最需要的:让两名不同年资的骨科医师在相同文本(且同样看不到影像)条件下完成同样的三项任务,即可同时回答"模型的错误是否是人类也会犯的错误"与"模型是否能减少人的疏漏"两个问题。此外,Weber 任务未做与多数类基线的正式统计检验(手术决策任务做了),这一不对称应当补齐。
8.3 样本量与统计功效:很多"差异"是 1 至 2 例的位移
非手术病例只有 7 例,特异度的每一格都是 1/7 ≈ 0.143;少样本的 5/7 与零样本的 4/7 差一例,就足以让 Cochran Q 检验给出 P = 0.004,而 Holm 校正后所有成对比较均不显著(校正后 P > 0.09)。这清楚说明总体检验的信号由极少数不一致病例驱动。类似地,Weber A 仅 6 例,在宏平均 F1 中占 1/3 权重,一例错判即可令宏平均变动约 0.04 至 0.05,而作者只给总体置信区间、未给逐类置信区间,读者容易把 0.625 与 0.800 之间的差距误当作真实的能力差异。建议补充逐类 bootstrap 置信区间、Cohen κ 或 Krippendorff α 之类的一致性指标,并按目标精度做样本量估算(例如要把特异度估计到 ±0.15,约需 30 例非手术病例)。
8.4 三个指标的定义域不一致,容易让读者高估性能
UNK 在准确率中计为错误,但在宏平均 F1 与混淆矩阵中被剔除,于是同一批 54 例数据在三种口径下的分母分别落在 54、50 至 51、以及 28 与 17–18 之间;覆盖率 92.6% 至 94.4% 只在正文出现一次,未与表格并列。结果是混淆矩阵看上去比准确率"更干净",读者很容易把矩阵的高对角误读为更高的分类能力。建议统一报告"覆盖率校正后"的指标并显式并列弃答率,同时披露 UNK 具体落在哪些病例。如果 UNK 集中于 Weber B/C 的边界病例——这很可能——那么弃答其实是合理行为,此时更恰当的评价框架是选择性预测(selective prediction):给出 risk–coverage 曲线,用"在 90% 覆盖率下的准确率"取代单一阈值下的准确率。
8.5 两个术式终点的分母随策略变动,差值不可直接解释为"能力增益"
分层通路准确率以固定 47 例为分母,术式选择准确率的分母则随策略在 41 至 47 例之间浮动,因为模型有时不返回类别。把两者的差解释为"分离术式选择带来的提升",在逻辑上混入了弃答率的差异:弃答越多的策略,其选择准确率的分母越小、越容易被抬高。正确的做法是在共同分母上做配对比较,并明确报告每策略的"not classified"比例。另外,临时固定只有 2 例且从未被正确识别,F1 = 0.000 是数学上的必然而非模型缺陷,把它写进结果段会引导读者误判;更合适的处理是标注"不可估计(not estimable)"或直接从三分类改为两分类后另行讨论。
8.6 少样本示例与评价集同源,few-shot 的优势可能部分来自文风匹配
10 个示例与 54 例评价集来自同一中心、同一时段、同一批医师书写,且同一套报告模板,因此 few-shot 的增益中可能有一部分并非来自"任务学习",而是来自"文风与模板匹配"——模型只需识别出"这类文本的结论通常写在哪一句",就能提高抽取命中率。作者已承认未评估示例选择的敏感性(单一 seed 42),但更关键的是缺少"跨机构示例"或"示例与评价集文风刻意不同"的对照组。建议报告示例的类别构成与长度分布,并对示例集做 ≥20 次 bootstrap 重抽,给出 few-shot 性能的分布而非单点值。
8.7 确定性解码不等于无不确定性,单次推理掩盖了生成端方差
temperature = 0、关闭采样确实消除了采样随机性,但并不保证输出在浮点累加顺序、批处理组成、服务端实现版本变化下完全可复现;而对边界病例,模型的首个 token 选择往往只由极小的 logit 差距决定。每例只推理一次意味着研究无法估计生成端方差,也无法区分"稳定的错误"与"摇摆的正确"。成本允许的话,宜对每例做 3 至 5 次重复(或固定随机种子)并报告一致率,对不一致病例单独分析——这些病例往往正是临床最需要人工复核的那一部分。
8.8 可复现性与报告规范仍需加强
语言与模板未交代、量化方式与服务框架不公开、伦理号前后不一致、缺少筛选流程图,这四点共同削弱了本研究的可复现性。建议按 TRIPOD + AI 或 DECIDE-AI 清单报告:模型确切版本与量化位宽、完整提示文本(本文已放在补充材料,值得肯定)、随机种子、硬件与每例推理耗时及成本、以及数据预处理的确切步骤。尤其是成本——70B 模型院内离线部署的硬件门槛,是决定此类方案能否在中小机构推广的现实约束,而全文没有任何时间或资源数据。
8.9 延伸方向:从"复述结论"走向"补充判断"
第一是多模态融合:术式选择本质上依赖后踝骨块大小与移位、下胫腓联合的动态不稳、软组织条件与骨质量,这些几乎都在影像与查体中而不在文本里,纯文本路线的天花板因此很低。第二是重构任务:与其预测"最终术式"(深受外科医师偏好、器械可得性与排班影响,本质上不是一个可由患者状态唯一决定的量),不如预测可操作的中间变量,例如是否存在下胫腓不稳、后踝是否需要固定、是否需要加做 CT——这些才是决策链条上真正可被辅助的节点。第三是把终点从"分型准确率"换成"字段级抽取质量":位置、类型、移位程度、关节面累及、软组织状态等结构化字段的逐字段 F1,配合人工校对所需时间,更贴近登记库、质控与回顾性研究的真实需求,也更能体现 LLM 相对于规则抽取的价值。第四是前瞻性人机协作研究,以文档一致性、编码错误率、医师校对时间与遗漏率为终点,这类研究才可能回答"临床影响"这一本文明确无法回答的问题。第五是跨语言与跨机构的外部验证,以及提示鲁棒性测试(同义改写、字段缺失、缩写、中英混杂),因为真实世界文本的噪声远高于单中心数据集。第六是把弃答机制设计成工作流的一部分:在覆盖率与准确率之间显式取舍,并把低置信病例路由给人工,比追求单一阈值下的最高准确率更接近可用产品。第七是与小模型蒸馏或规则方案的性价比比较:若规则基线已接近 0.80,70B 模型的部署成本便难以论证,这一比较本是审稿人最可能追问的问题。