ARTICLE · 1224509
《从源码搭建嵌入式软件框架》02|代码怎么分层,才不会越写越乱
最让人头疼的代码,往往不是某个函数太长,而是:
你只想改一件事,却不知道会碰到多少地方。
换一种线程实现,任务模块要改,连接模块也要改;调整一条选择规则,公共流程里多了几个判断;一个内部结构改了字段,原本看起来无关的模块也编译不过了。
最后,每次修改前,都要先问一句:
“这个地方,应该没有其他模块偷偷在用吧?”😅
上一篇,我们把框架里的主要拼图摆了出来。这一篇往前走一步:这些拼图应该放在哪里,彼此又应该隔开什么?
先把答案放在前面:
分层不是多建几个目录,而是让每一类代码知道:自己负责什么,应该通过什么入口使用别人,以及哪些细节不该伸手去管。
一、先别急着建目录,先分清三类问题
假设现在需要让一项工作在另一个线程里执行。
表面上看,只是“创建线程,再运行函数”。但往下拆,会遇到三类不同的问题:
- 为什么做?
什么时候发起这项工作,要使用哪些服务。 - 怎样组织?
工作怎样排队,通知怎样送达,流程怎样向前走。 - 怎样落地?
具体系统怎样创建线程、申请内存、操作硬件。
它们会合作,但不应该混成一团。
就像餐厅里,决定菜单、安排出餐和操作炉灶,是相关的三件事,却不是同一种职责。🍳
把这些问题按职责展开,可以得到下面这张图:
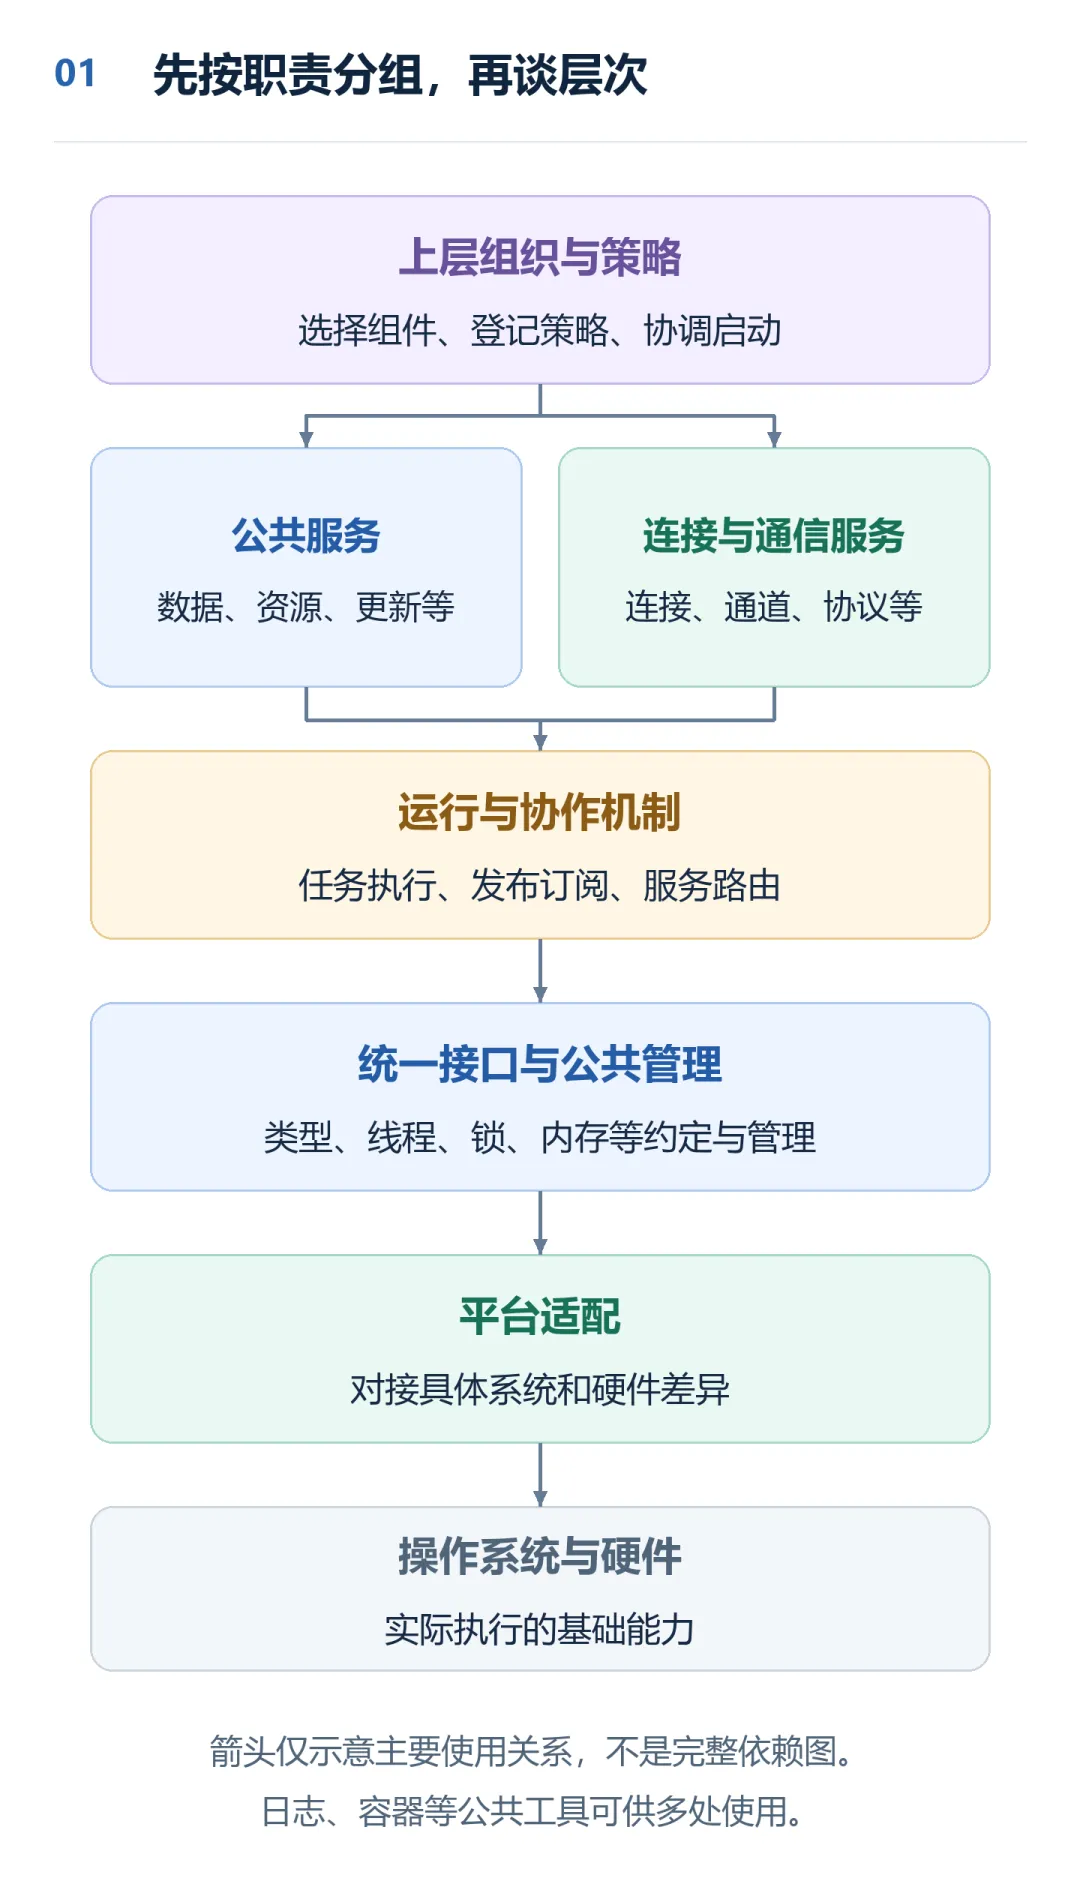
图1:职责视图。箭头表示主要的使用关系,不是所有组件都必须逐层经过的完整依赖图。
这里有两个容易误解的地方。
第一,公共服务与连接服务,是按职责分组,不代表前者必须经过后者,或后者一定比前者更“底层”。
数据管理负责读写组织,连接管理负责连接相关能力。它们之间有没有依赖,要看实际使用关系,不能只看图上的位置。
第二,运行与协作机制,也不是操作系统内核本身。
任务执行、发布订阅、服务路由,是建立在基础能力之上的协作方式。它们帮助模块一起工作,并不负责重新实现操作系统的调度器。
因此,看分层时,先问“它解决什么问题”,再看“它放在哪个目录”。
二、接口和实现,为什么要分开?
从最常见的线程说起。
上层希望表达的是:
“请帮我创建一个线程,入口是这个函数,参数放在这里,名称和运行属性按这份配置来。”
而具体平台还要处理:
线程句柄是什么类型?底层创建接口怎么调用?是否需要指定运行核心?创建失败后,刚申请的内部数据由谁释放?
前者是使用约定,后者是实现细节。
把它们分开的直接办法,是先提供公共头文件,声明调用方式;再由具体实现接住这些调用。
下面只保留接口形状,名称采用通用写法;它是帮助理解的简化示例,不是可直接编译的完整实现:
intthread_create(thread_handle_t *out,thread_entry_t entry,void *arg,const thread_attr_t *attr);
调用方需要知道参数和返回值的约定,不必跟着知道底层任务控制块的全部字段。
平台实现则需要知道:怎样把这份请求,变成底层能够执行的操作。
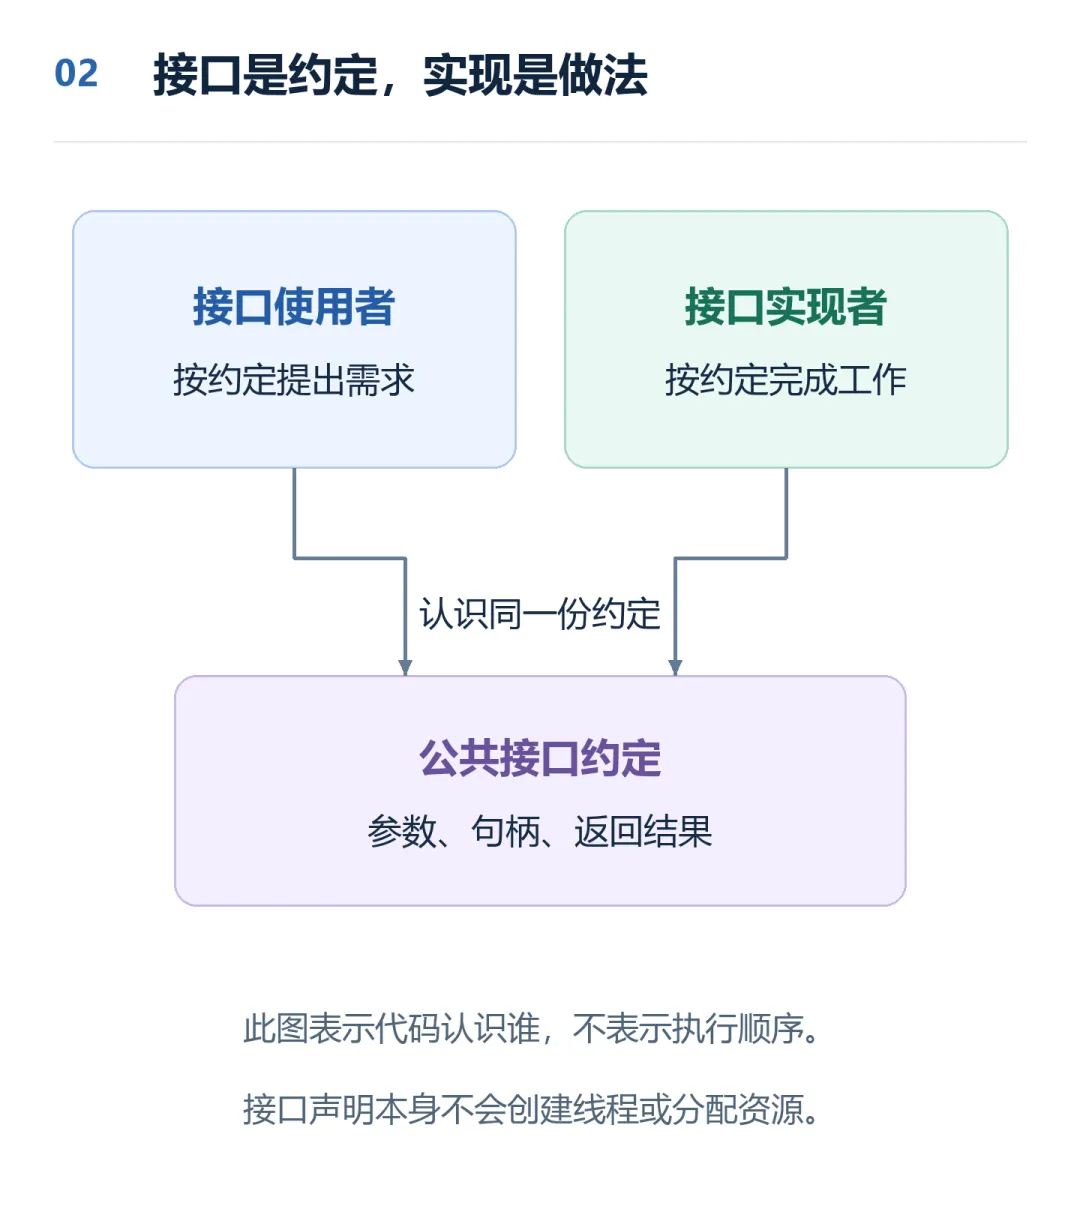
图2:双方认识同一份接口约定。这张图表示代码之间的认识关系,不表示函数执行顺序。
可以把公共接口理解成一张申请表:使用者按表格填写,实现者按表格办理。
不过,申请表本身不会办事。
只有声明,没有对应实现,线程不会凭空出现;底层能创建线程,也不意味着上层就可以绕开约定,随意操作它的内部句柄。
接口分离的价值,不是多绕一次,而是把变化收拢起来:
底层做法调整时,尽量让影响停留在实现侧;调用约定变化时,再明确检查所有使用者。
这里说的是“尽量”,不是承诺换个平台就能零修改。
三、沿一次线程创建,看清每一段负责什么 🔍
只画“上层 → 接口 → 平台”,很容易让人以为:公共接口和底层函数是一对一的简单转发。
实际调用链里,还可以夹着公共管理工作。
以任务执行器创建自己的线程为例,主要路径可以这样理解:
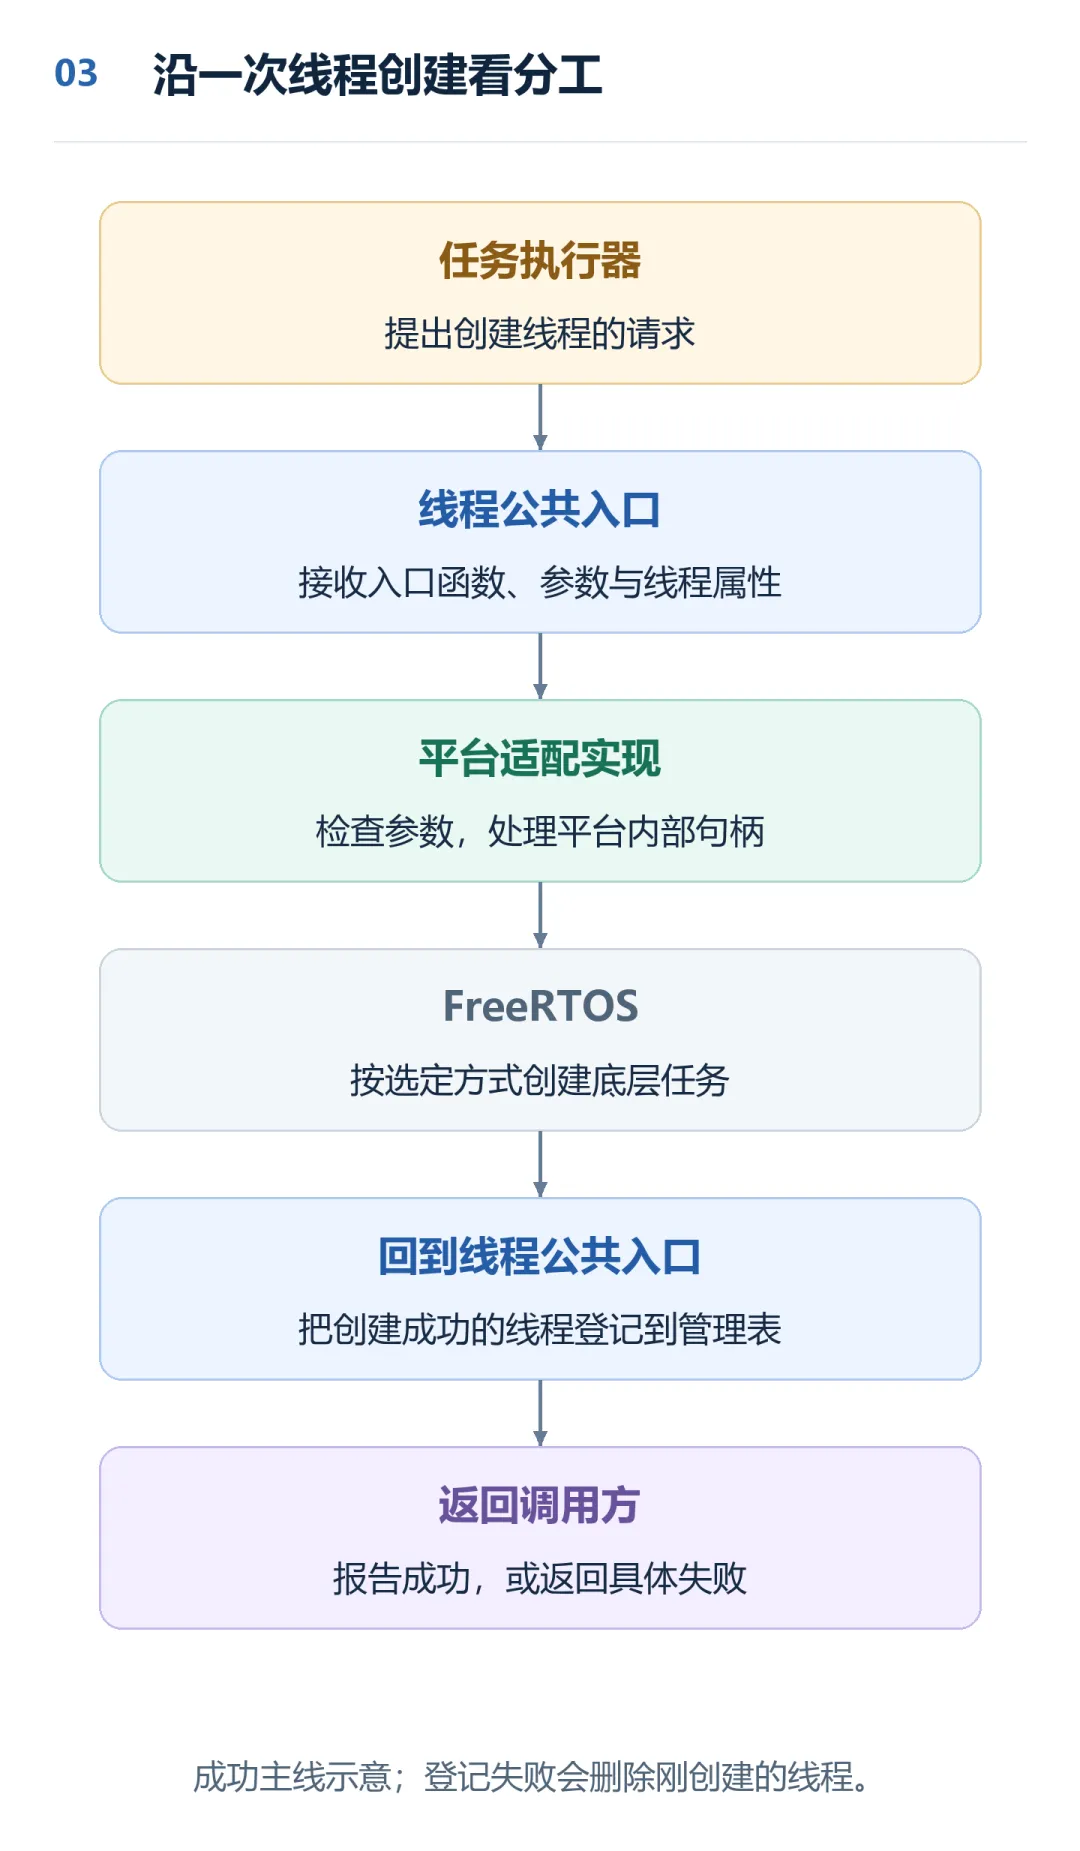
图3:线程创建的成功主线。图中保留了“创建成功后登记线程”这一步,未展开所有内部处理和失败分支。
沿着这条线,可以分清三份责任。
1. 任务执行器:我需要一个执行工作的环境
它关心的是:运行哪个入口、使用哪些线程属性,以及创建结果是否成功。
它不应该自己复制一套底层任务创建逻辑。
2. 线程公共入口:创建之外,还要纳入管理
公共入口调用平台创建接口后,还会把线程登记到公共管理表里。
这里就出现一个很有代表性的情况:
底层创建成功,不代表整个公共操作已经成功。
如果后面的登记失败,还需要清理刚创建的线程,并把错误返回。
把这段处理改成通用名称,可以看得更清楚:
/* 简化伪代码:省略完整参数,只展示处理顺序。 */result = platform_thread_create(&handle, ...);if (result != 0) {return result;}result = thread_registry_add(handle);if (result != 0) {platform_thread_delete(handle);return result;}return 0;
这段处理承担的是底层创建函数不负责的事:让线程进入统一管理,并在后续失败时调用删除接口收尾。
3. 平台适配:把公共请求接到底层
平台适配负责检查和处理线程属性、准备内部句柄,并调用 FreeRTOS 的任务创建接口。
是否绑定运行核心、采用哪种创建方式,属于这一侧需要面对的细节。
因此,不必要求“一个目录只能对应一层调用”。更重要的是:
创建请求由谁接收,公共管理由谁承担,平台细节由谁处理,要能分别说清楚。
四、机制和服务,别因为都很“公共”就装进同一个抽屉
再看两个听起来都很基础的能力:
发布订阅:登记谁关心某个事件,并把通知分发出去。 连接管理:组织连接相关的状态与操作。
它们都能被多个模块使用,但负责的事情不同。
发布订阅解决“变化怎样传出去”,连接管理解决“提供怎样的连接能力”。
任务执行器则继续回答:通知对应的工作,在哪里执行?
它们可以组合:
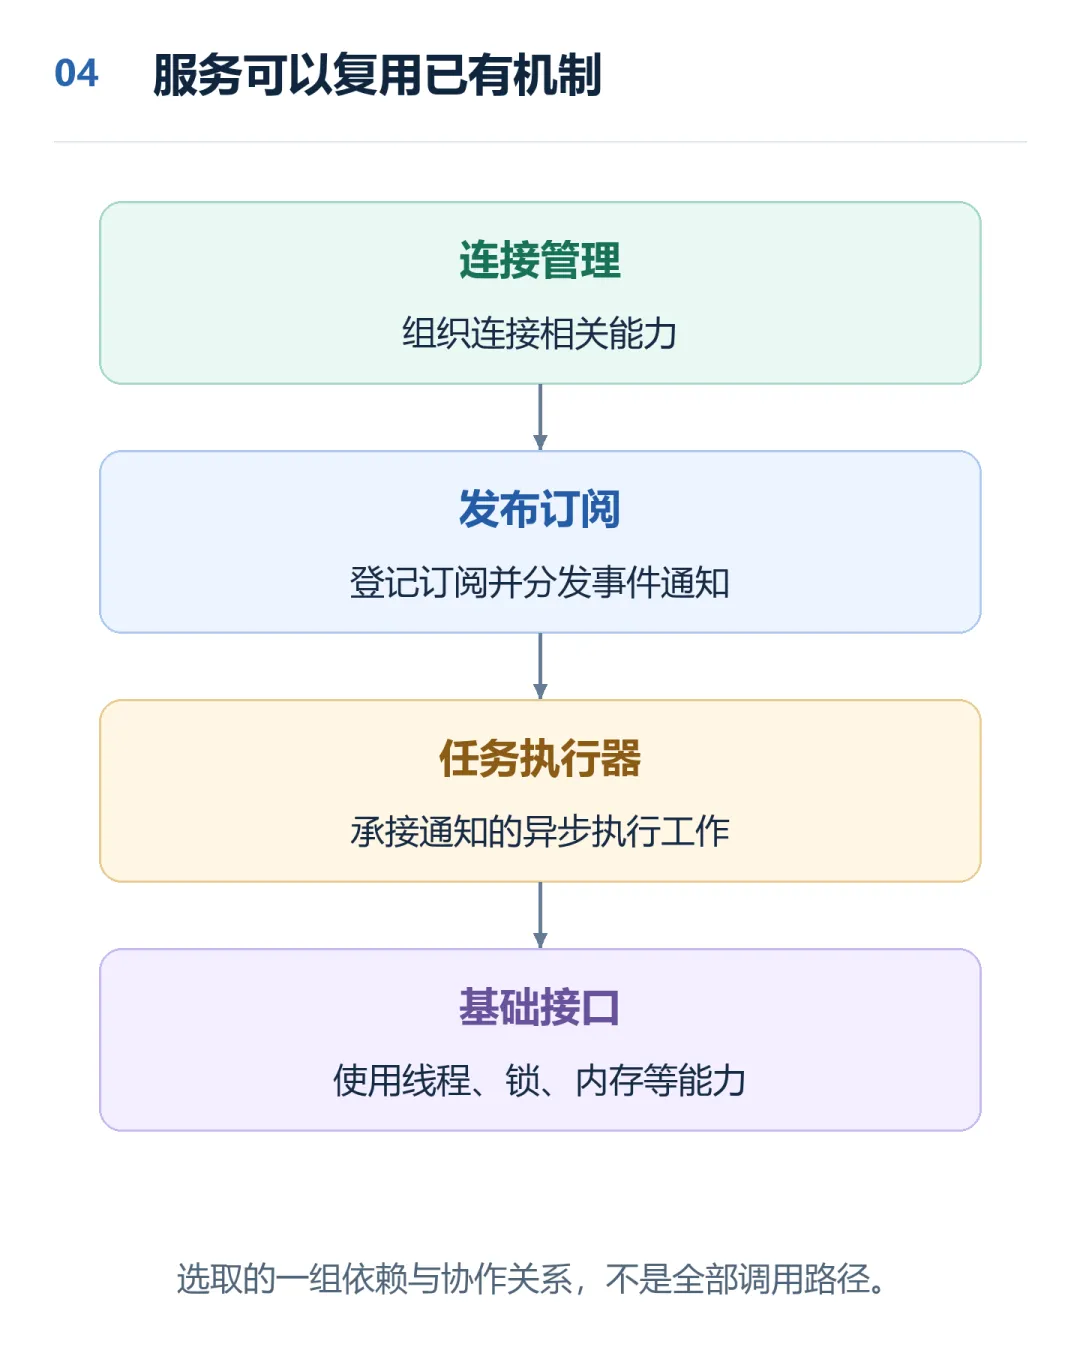
图4:选取的一组组件依赖与协作关系。连接管理依赖发布订阅,发布订阅利用任务执行器,执行器使用基础接口;图中没有列出各组件的全部依赖。
这样组织有一个实际好处:新增服务时,可以利用已有的任务、消息和调用机制,不必每次重新安排一套执行环境。
但不要把它理解成“每项服务都必须经过所有机制”。
例如,读取数据时,数据管理可以按存储类型选择对应后端;不是为了符合层级图,就一定要先发消息、再排任务、最后才能读取。
需要异步时使用异步机制,需要直接操作时使用明确的同步入口。分层不是给每个操作设置固定关卡。
反过来,通用机制也不该顺便决定服务规则:
队列负责安排任务,不负责决定一份资源是否需要更新。 消息分发负责通知订阅者,不负责替接收者决定后续行为。 线程接口负责运行基础能力,不负责决定连接什么时候发起。
如果这些选择不断混入通用机制,底座就会越来越难单独理解和复用。
五、通用流程和上层选择,怎样拆开?
“把规则放到上层”很好理解,但公共流程真运行起来时,总得知道该怎么选。
难道还要在公共服务里,直接写下每一种上层选择吗?
不必。一个已经采用的办法是:公共服务定义策略接口,上层提供实现,再把策略登记进去。
以更新框架中的资源列表生成为例,先不讨论具体资源内容,只看职责:
公共流程负责组织解析、列表处理以及后续步骤。 上层策略负责按照自己的规则,生成需要处理的资源列表。
双方通过约定的函数入口连接。
下面仍是通用名称的简化示意:
struct update_policy {unsigned int package_id;int (*select_resources)(const update_config_t *config,resource_list_t *out);};
不要被函数指针吓到。这里就是在登记:
“遇到这个标识时,需要生成资源列表,就调用我提供的这个函数。”
整体过程可以这样看:
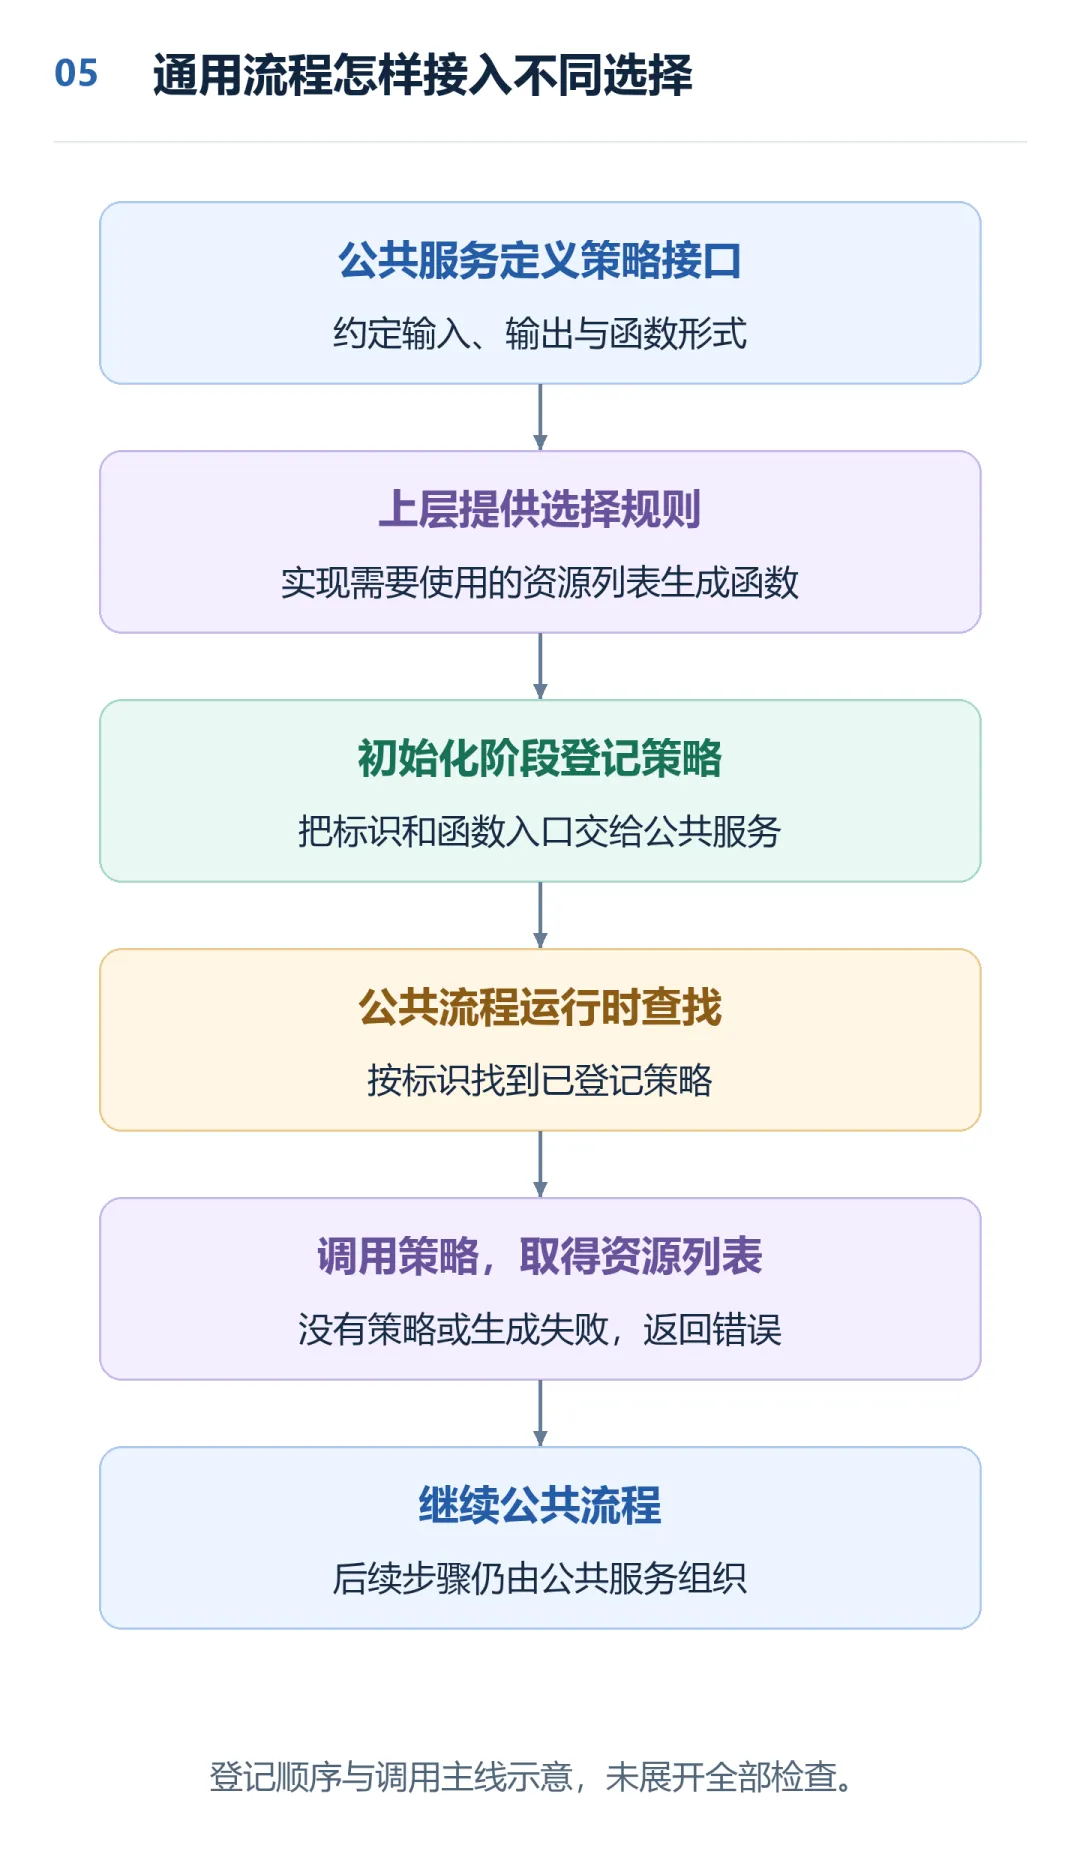
图5:先登记,后使用。公共流程按标识找到策略,并调用约定的入口;这不是自动发现所有规则。
这带来的变化是:
公共流程认识的是“资源选择接口”,不必把每一种具体选择都写进自己的主体流程。
上层也不必复制整套更新流程,只需要提供自己负责的部分。
不过,这种分开并非没有条件:
策略必须先登记,函数入口必须有效,返回结果也必须检查。
找不到策略时,公共流程会返回缺少策略的错误;策略生成列表失败,也不能假装列表已经准备好了。
这里没有一个自动替我们处理一切的“容器”。它是一种很直接的协作方式:先约定,再登记,最后按约定调用。 🧩
六、分好大层还不够,组件内部也要有“门口”
现在假设数据管理已经被放进公共服务。
其他模块调用它时,仍然可能走出两条完全不同的路:
一种是使用公开的读写入口。
另一种是直接找到内部控制块,自己修改字段、操作链表,甚至绕过后端分发。
两种做法都可能暂时跑起来,但后者会把内部实现变成大家共同依赖的东西。
于是,数据管理以后哪怕只是调整内部结构,也可能牵动一大片调用方。
所以,组件内部还要继续区分:
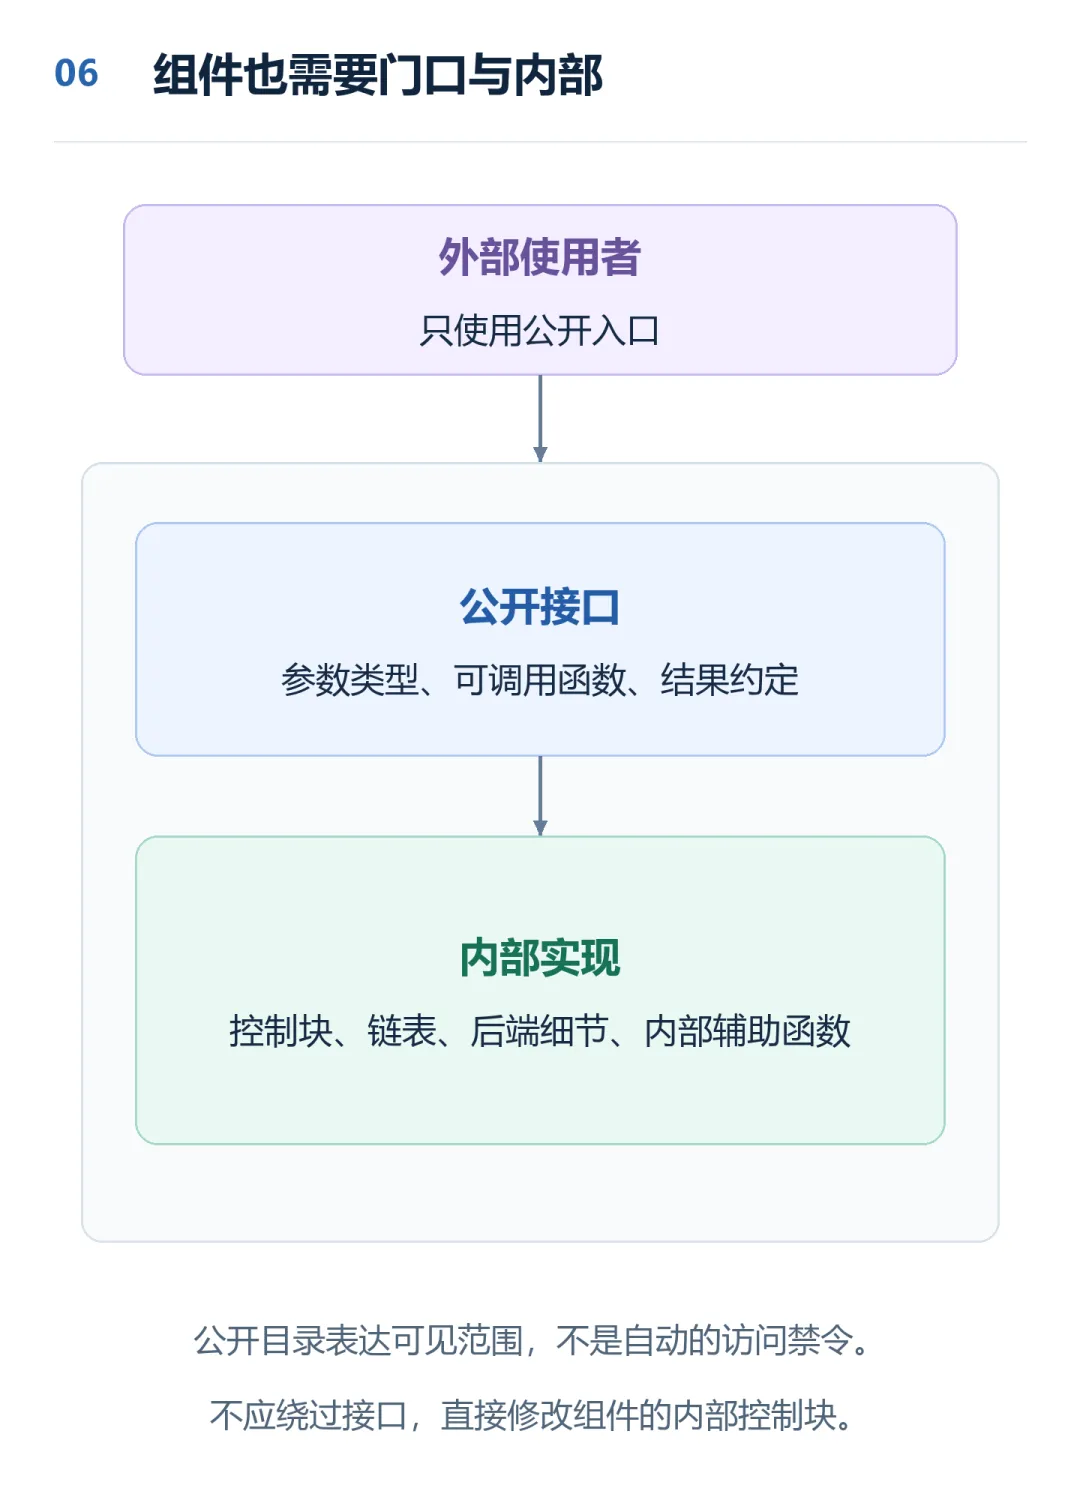
图6:公开接口是使用入口,内部实现负责保存和处理细节。外部不应绕过入口直接操纵控制块。
在组件配置中,可以看到公开头文件目录和内部头文件目录分开声明的组织方式。
它表达的意图很明确:
使用者需要的参数类型、函数声明,放到公开接口中。 控制块、内部节点和辅助声明,尽量留在组件内部。
但目录分开,也不是一道自动生效的围墙。
仍然需要检查:外部有没有包含内部头文件?公开结构里有没有暴露过多实现细节?构建配置有没有把不必要的目录公开出去?
这里还有一个边界:公开接口不一定都要集中到同一个总目录。
线程、锁等基础约定,可以集中组织;数据、连接、资源等服务,也可以分别拥有自己的公开接口。
否则,一个“所有头文件都往里放”的公共目录,很快又会变成新的杂物间。📦
七、已经有分层,为什么仍然可能互相牵扯?
说到这里,很容易产生一个过于乐观的结论:
接口有了,适配有了,公共服务也有了,所以平台已经被完全隔离。
还不能这样判断。
从具体文件里,能够看到一些仍然保留的联系。
1. 公共线程头里,仍有底层布局相关的约束
除了普通的线程属性,公共头文件中还包含与底层任务布局有关的配置,例如栈增长方向、栈地址记录条件等。
这说明接口已经在做统一,但部分约定仍然贴近具体运行环境。
换平台或修改底层配置时,这些地方仍需要核对。
2. 公共存储服务的后端,仍然接触平台专用属性
特定存储后端使用了平台专用的内存属性,决定一块缓冲区放在哪里。
这类细节出现在后端,并不意味着分层完全错误:后端本来就需要接触具体实现。
但它提醒我们,不能因为外面有统一读写入口,就认为服务内部已经全部与平台无关。
3. 板级组件,也不一定只是最底下的一块薄包装
组件依赖描述中,板级部分还会接入运行机制和部分公共服务。
因此,不能仅凭它位于图的下方,就断言它完全不认识上面的任何组件。
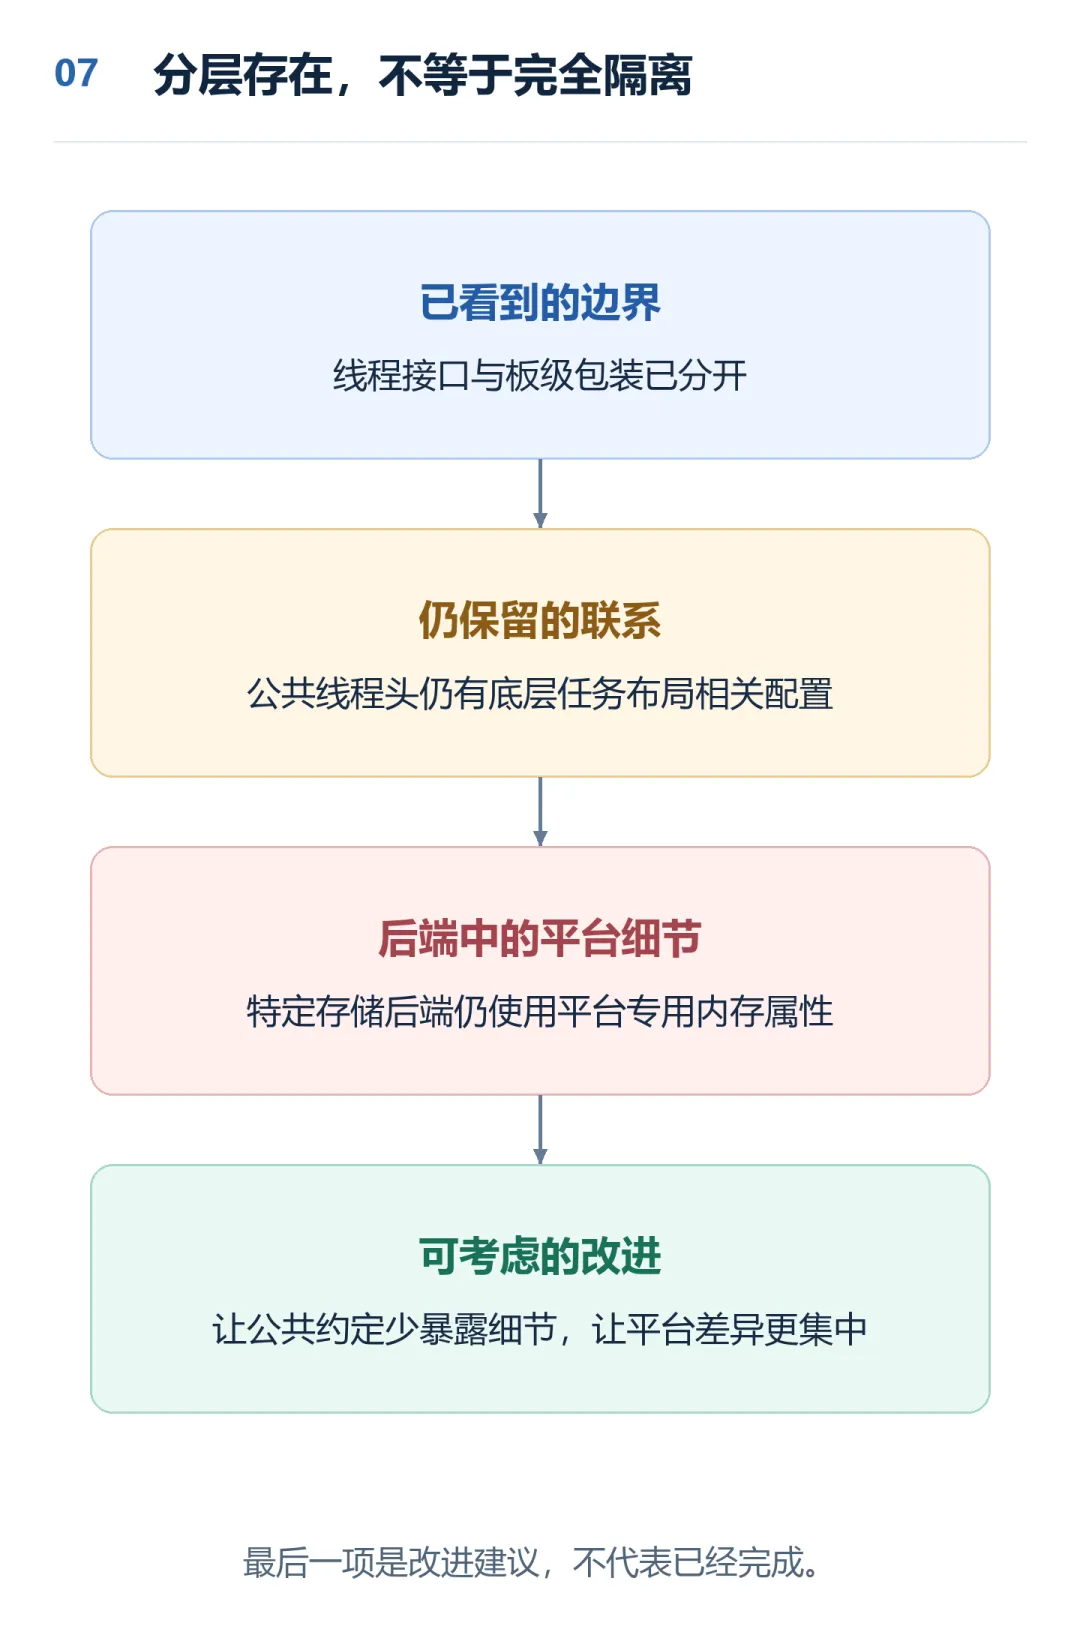
图7:既看已经建立的边界,也看仍然存在的联系。最后一项是可考虑的改进方向,不代表已经完成。
如果继续改进,可以优先检查:
公共接口是否能减少底层布局细节?平台差异是否能更集中地留在后端或适配侧?上层选择是否还在不断渗入公共流程?
这些是改进方向,不应该被写成已经具备的能力。
看懂架构,不是替它画一张完美的图,而是能指出哪些边界清楚,哪些地方仍然会互相影响。
八、分层有没有用,拿一次改动试试看
不妨用四个问题,检查职责是否真的分开:
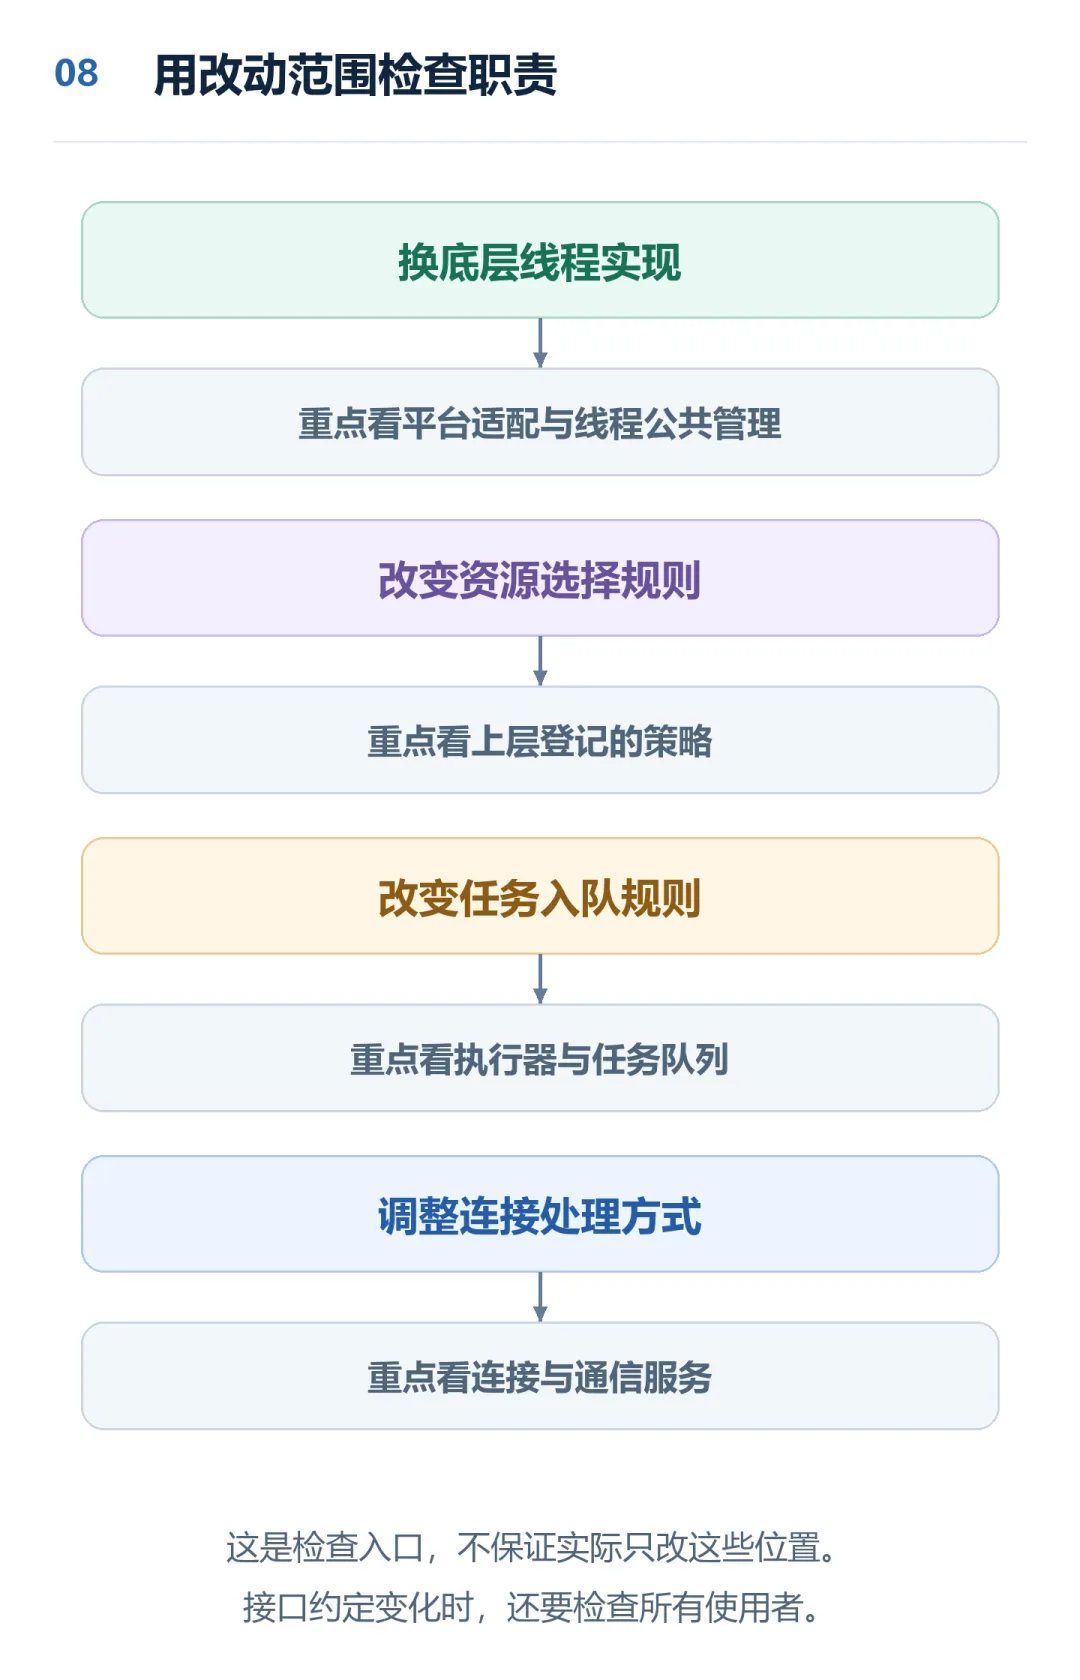
图8:每种改动都有优先检查的位置,但这不保证实际修改只发生在那里。接口约定变化时,还需要检查使用者。
例如,调整资源选择规则,优先去看登记的策略;调整任务入队规则,优先去看执行器和队列。
如果每一种改动,最后都需要深入线程包装、消息分发、存储后端和上层组织,说明职责还没有真正收拢。
当然,分层也有成本。
调用链会变长,排查问题时需要跨几份文件;接口需要维护;策略登记还带来初始化顺序和失败检查。
对于本来就很简单、没有独立职责的操作,硬加几层转发,可能只会增加阅读负担。
所以,判断一层是否值得保留,不妨问:
它是否承担了清楚的工作,或者把一类变化集中到了明确的位置?
线程公共入口承担登记和失败清理,值得单独理解;平台适配处理底层差异,也有明确职责。
如果一个新增的中间函数既不转换约定,也不承担管理,只是无条件转发,就应该再想想:我们到底想通过它隔开什么?
九、写下一个模块前,先回答这五个问题
不必一上来就背很多架构名词。
开始写一个模块前,先把下面五句话说完整:
- 我负责什么?
提供服务、安排执行、组织流程,还是对接平台。 - 我通过什么使用别人?
公共入口、服务接口,还是约定的策略函数。 - 哪些细节应该留在内部?
控制块、链表、平台句柄,不要轻易变成外部依赖。 - 不同场景的选择放在哪里?
尽量不要把每一种选择都塞进通用机制。 - 这类需求变化时,应该先改哪里?
如果答案总是“到处都要改”,就该重新看边界。
分层真正想换来的,不是一张看起来整齐的图,而是一种更踏实的修改体验:
看到一项需求,能判断应该从哪里改;进入一个模块,能知道它负责到哪里;修改内部实现时,能尽量不惊动无关的人。
记住这一句就够了:
把职责分开,把细节藏好,把合作入口留清楚。 🔧
不过,模块各自归位后,还有一个问题:
甲需要乙,乙又需要甲,怎么办?底层通知上层,难道一定要反过来依赖上层吗?
下一篇:《从源码搭建嵌入式软件框架》03|模块互相依赖怎么办?先把依赖方向画清楚。
我们会把“谁调用谁”和“谁依赖谁”分开画,看清那些绕来绕去的关系,究竟可以在哪里解开。