ARTICLE · 1232170
HLE:常用试卷接近满分之后,怎样测量大模型的能力边界?
BUPT Reasoning
AI4S 专栏 · 评测基准
HLE:常用试卷接近满分之后,怎样测量大模型的能力边界?
以 HLE 为例,理解专家级题目的构建、评测与能力边界。
先看全貌
HLE 怎样把专家提出的难题变成一套评测基准?先沿着图 1 看题目进入测试集的路径:通过模型难度筛选,再经专家审核、修订和批准,最后划分公开集与私有集。前端关注题目是否足够难,后端关注它是否适合用来测量能力。
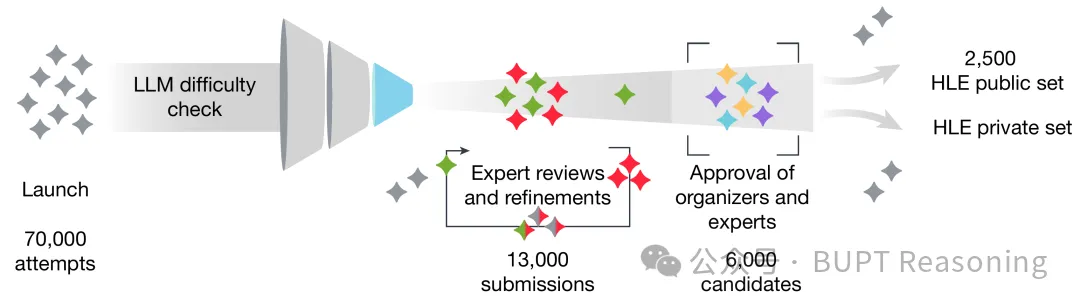
图 1 HLE 的题目构建与审核流程。依次展示模型难度筛选、两轮人工审核,以及公开集和私有集的划分。图源:原论文图 4。
本篇论文
论文全名:A benchmark of expert-level academic questions to assess AI capabilities
主要作者:Center for AI Safety、Scale AI、HLE Contributors Consortium(论文采用集体署名)
研究团队:Center for AI Safety、Scale AI 与全球领域专家共同参与。
发表信息:Nature 649,1139–1146(2026),2026 年 1 月 28 日在线发表。DOI:10.1038/s41586-025-09962-4。
论文链接:https://doi.org/10.1038/s41586-025-09962-4
仓库地址:https://github.com/centerforaisafety/hle
研究要点
HLE 通过专家出题、模型难度筛选与人工审核,构建了包含 2,500 道题的公开测试集。它既检查模型能否答对专业问题,也检查模型能否判断自己的答案是否可靠。理解这些分数,还需要区分专家级答题与真实科研任务。
研究者想让大模型协助回答一个专业问题。模型在常见知识测试中已经拿到很高的分数,也能写出条理清楚的解释。但换成一道需要深入理解某个研究领域的问题,它还能答对吗?如果答不出来,它能否意识到自己的不确定?
要回答这些问题,需要一套仍然能够区分模型能力的测试。当多数模型都接近满分时,原有试卷就很难显示它们还欠缺什么。评测需要进一步触及那些有明确答案、却依然难以解决的专业问题。
Center for AI Safety、Scale AI 与全球领域专家共同构建了 Humanity’s Last Exam(HLE)基准,并将相关研究成果以《A benchmark of expert-level academic questions to assess AI capabilities》为题发表于 Nature。HLE 的公开集包含 2,500 道专家级学术题目,论文系统介绍了题目的构建与审核流程,以及模型评估方法,为理解大模型的能力评测提供了一个具体切入点:题目怎样选出来,分数反映什么,又有哪些能力尚未被测到。
01常用试卷接近满分,为什么还需要新的测试?
评测基准(benchmark)可以理解为一套统一的试卷:给不同模型相同的问题,再按相同规则评分,从而比较它们的表现。论文指出,部分前沿模型在 MMLU(大规模多任务语言理解)等常用知识基准上的准确率已超过 90%。分数接近上限后,新的能力进步就不容易通过这套试卷体现出来。
HLE 将评测范围推进到更困难的专业问题。它的公开集包含 2,500 道题,覆盖一百多个细分学科,汇总为数学、物理、化学、生物与医学、人文与社会科学等八个大类。其中数学约占 41%,是占比最高的类别。
这些题目有两种作答形式。约 24% 是选择题,每题提供至少五个选项;其余要求模型直接给出简短、可核对的答案,例如数值、公式或特定名称。约 14% 的题目还需要结合图片理解,不能只处理文字。
HLE 强调的是“难而可判”:问题可以需要深入推理或非常专门的知识,但应当有明确的参考答案。它不收录任意发挥的开放式论述,也不把尚无公认答案的研究问题直接当作考题。
这些题目能否继续区分模型的表现?图 2 将同一批模型在 HLE 与几项常用基准上的准确率放在一起比较。
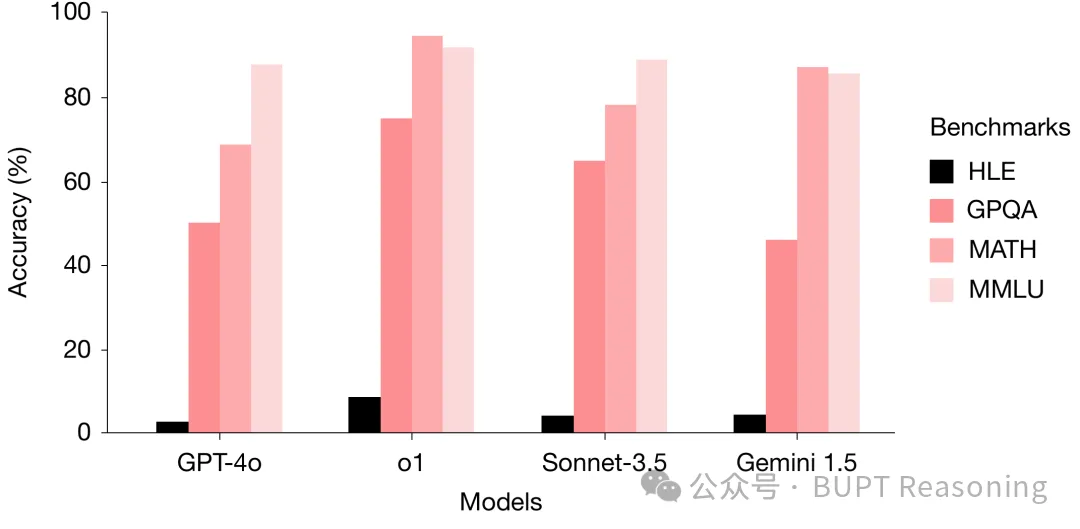
图 2 部分前沿模型在 HLE、GPQA、MATH 和 MMLU 上的准确率比较。黑色柱为 HLE,粉色柱为其他基准;纵轴为准确率。图源:原论文图 1。
图 2 中,同一模型在不同试卷上的分数形成了鲜明差异:例如,o1 在 MMLU 和 MATH 上已取得较高成绩,在 HLE 上的准确率仍只有约 8%。这说明 HLE 在论文所测模型上保留了更大的提升空间。由于题目范围和筛选方式不同,各基准的百分数不能直接当作同一把尺子上的难度倍数。
1.1从两道例题看,难度具体体现在哪里?
仅看低分,还不容易理解 HLE 究竟难在哪里。论文图 3 给出的例题,把抽象的“专家级难度”变成了可以观察的具体任务。
化学例题:读懂结构图,还要追踪反应过程。题目给出一种七烯在热条件下转化为 endiandric acid B 甲酯的反应,说明过程依次包含两次电环化和一次环加成,要求写出前两步涉及的 π 电子数及顺旋或对旋方式,再用“[m+n]”表示最后一步的环加成类型。
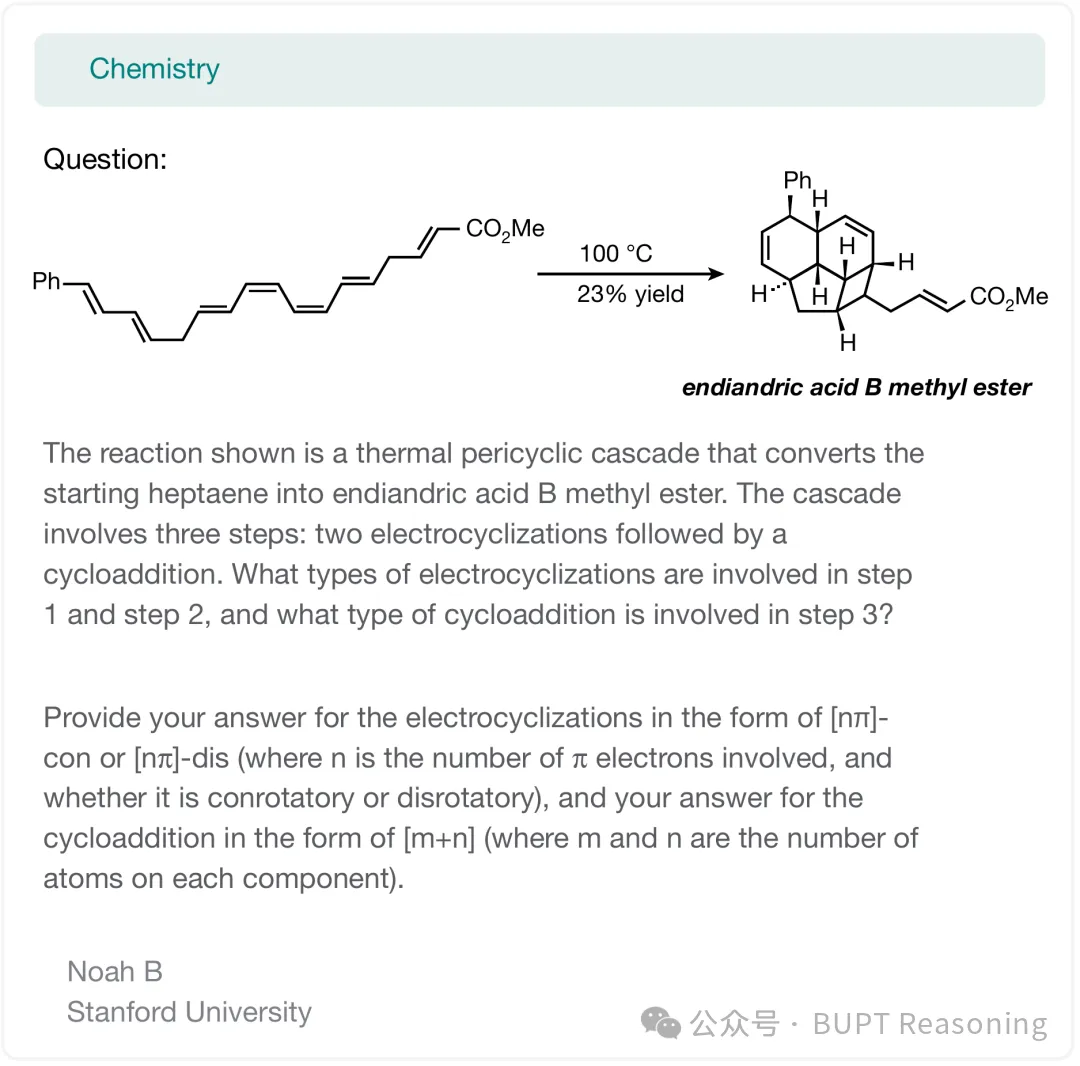
图 3 HLE 化学例题。题目将反应结构图、热反应条件和三步反应类型判断结合起来,并规定简短的答案格式。图源:原论文图 3。
这道题要求模型把图中的化学结构转化为可推理的信息,再结合周环反应规则判断各步变化。只认识产物名称,或只会解释“电环化”的定义,都不足以完成作答。它体现了 HLE 将图像理解、专业知识与连续推理放在同一道题中考查的方式,同时仍让最终答案保持明确、可核对。
计算机科学例题:理解转移规则,再判断哪些条件足够。题目构造了一个图上的马尔可夫链:用两个有顺序的端点表示一条边,每一步随机选择一个端点,再把它替换为另一端点的随机邻居,要求从给定图类别中,选出能保证该过程收敛到唯一且均匀的平稳分布的一类。
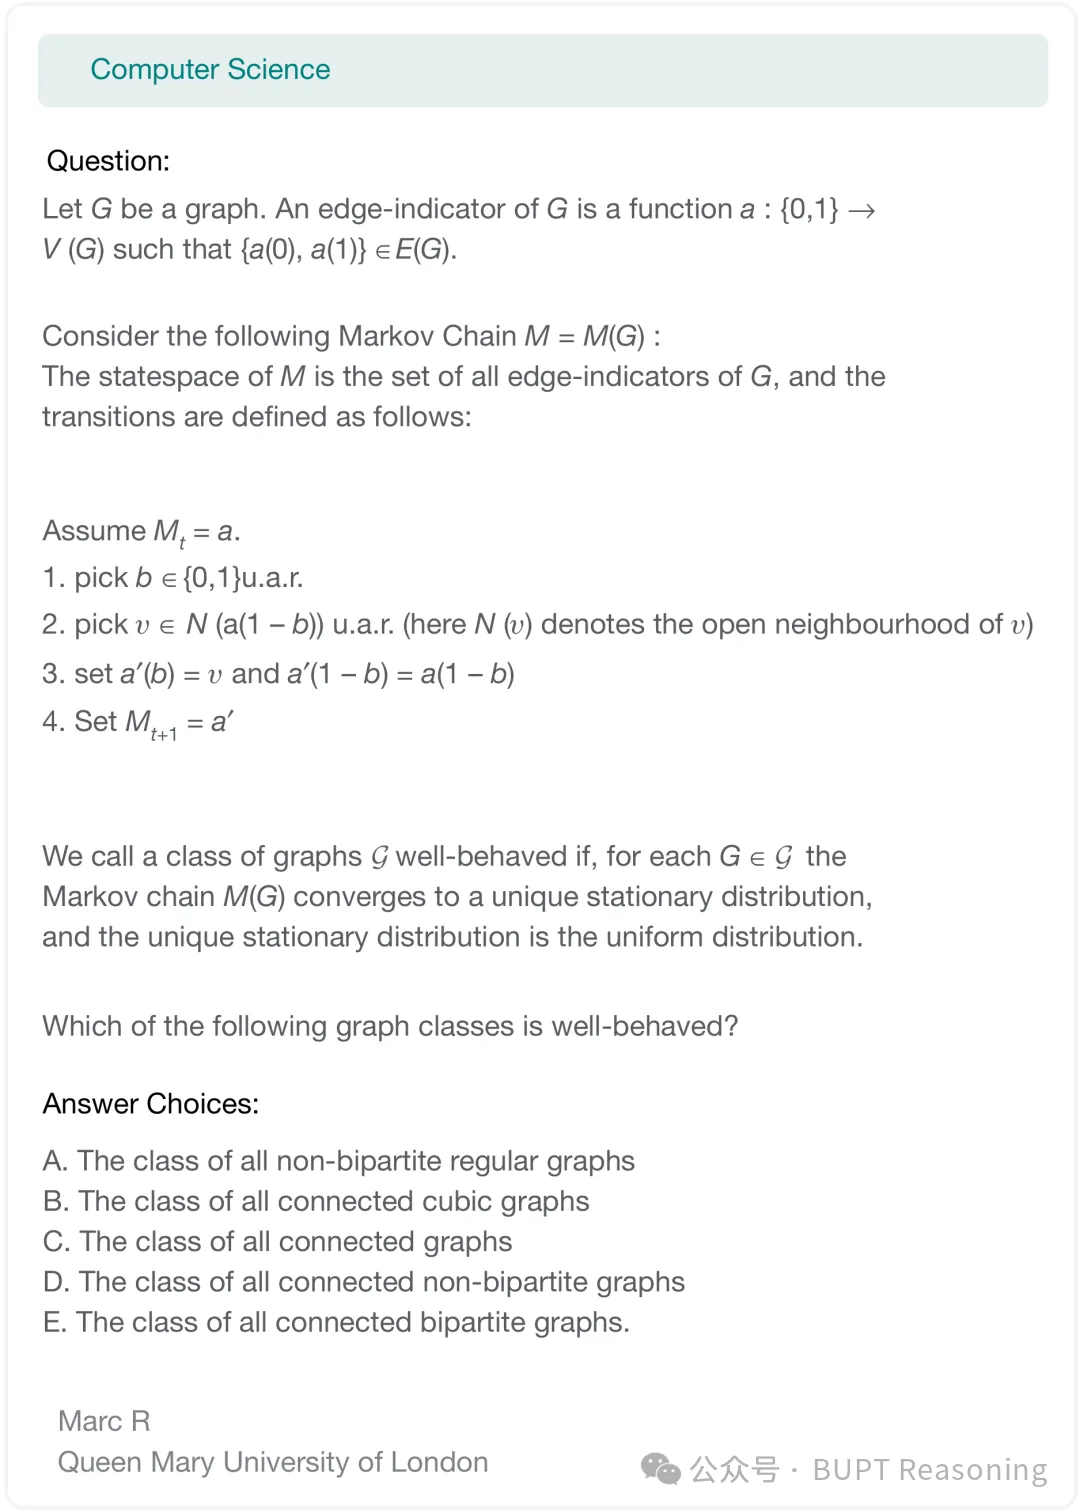
图 4 HLE 计算机科学例题。题目构造了一个图上的马尔可夫链,并要求从给定图类别中选出符合要求的一类。图源:原论文图 3。
这里考查的不是“什么是马尔可夫链”这一概念的复述。作答者需要把端点更新规则转化为状态之间的关系,分析图的连通性、是否为二分图等性质如何影响收敛,并区分选项中看似相近的条件。即使最后只需选择一个选项,背后的判断仍需要把图论知识与概率推理结合起来。
这两道题说明了 HLE 的设计特点,但不能据此把已有基准概括为“只考记忆”。MMLU 已同时考查多学科知识与问题求解;GPQA 也由领域专家编写,覆盖生物、物理和化学,并强调答案难以靠简单搜索获得。HLE 的推进在于:把专家级难题扩展到更广泛的学科,结合以简答为主的作答形式、图文题和针对已有模型的难度筛选,继续寻找尚未被充分测量的能力边界。
不过,专业题并不天然等于可靠的测试题。它们怎样被筛选、答案由谁核验,还需要看题库的构建过程。
02一道专业题,怎样成为可靠的测试题?
2.1先确认它能难住已有模型
HLE 的题目来自近千名领域专家,贡献者关联的机构超过 500 家,分布在 50 个国家。出题人需要提供题目、答案、详细解答,以及学科和身份信息。
提交前,题目先接受多种前沿模型的测试。简答题需要让所有参与筛选的模型答错;选择题允许至多一个模型答对,以容纳偶然猜中的情况。整个过程记录了超过 7 万次尝试,约 1.3 万道通过难度检查的题目进入人工审核。
因此,HLE 上的低分有一部分来自筛选方式本身:研究者主动收集了已有模型不擅长的问题。它能够帮助暴露能力短板,却不能直接代表模型面对所有日常问题时的平均水平。
2.2再检查题目是否清楚、可解和可核验
难住模型只是第一步。题目还需要表述准确,答案有依据,并且不能靠简单的网络检索迅速找到现成答案。允许的来源包括原创问题,以及对已有信息的非平凡综合。
人工审核分为两轮。第一轮由具备相关专业背景的审核者反馈并协助修改;第二轮由组织者和专家审核者批准。每道题附带的解答,也为后续检查提供依据。
这里仍有一个限制:论文方法部分说明,由于题目高度专业化,审核者并不被要求逐一完整核验所有解答的正确性。多轮审核提高了质量,但无法自动保证每道题都没有问题。
2.3发布后继续纠错,并保留未公开题目
HLE 发布后继续接受社区反馈,核查答案标注和题干中的错误,并检查是否存在容易通过搜索找到答案的题目。同时,研究团队保留私有测试集,用于评估模型是否过度适应公开题库。
回看开篇的图 1,需要区分“尝试次数”和“题目数量”:超过 7 万次出题尝试后,约 1.3 万道题进入人工审核,约 6,000 道成为候选,随后继续核查、修订并划分为公开与私有部分,最终公开 2,500 道。流程前端筛选“模型仍不会的题”,后端检查题目是否适合评测;可靠性来自这两个目标的共同约束,也依赖发布后的持续纠错。
03模型答得怎么样,又有多了解自己的不足?
3.1准确率仍有较大的提升空间
评测时,研究团队要求模型输出解释、最终答案和置信度,再使用 o3-mini 将最终答案与参考答案比较。这样可以兼容分数与小数等不同但等价的表达,而不只是机械地比较字符串。
论文表 1 报告的结果如下。前五个模型与 HLE 公开后发布的三个模型分开列示,以提示后者的开发者已有机会接触公开题库。DeepSeek R1 只在纯文本子集上评估,不能与完整多模态测试的成绩直接等同。
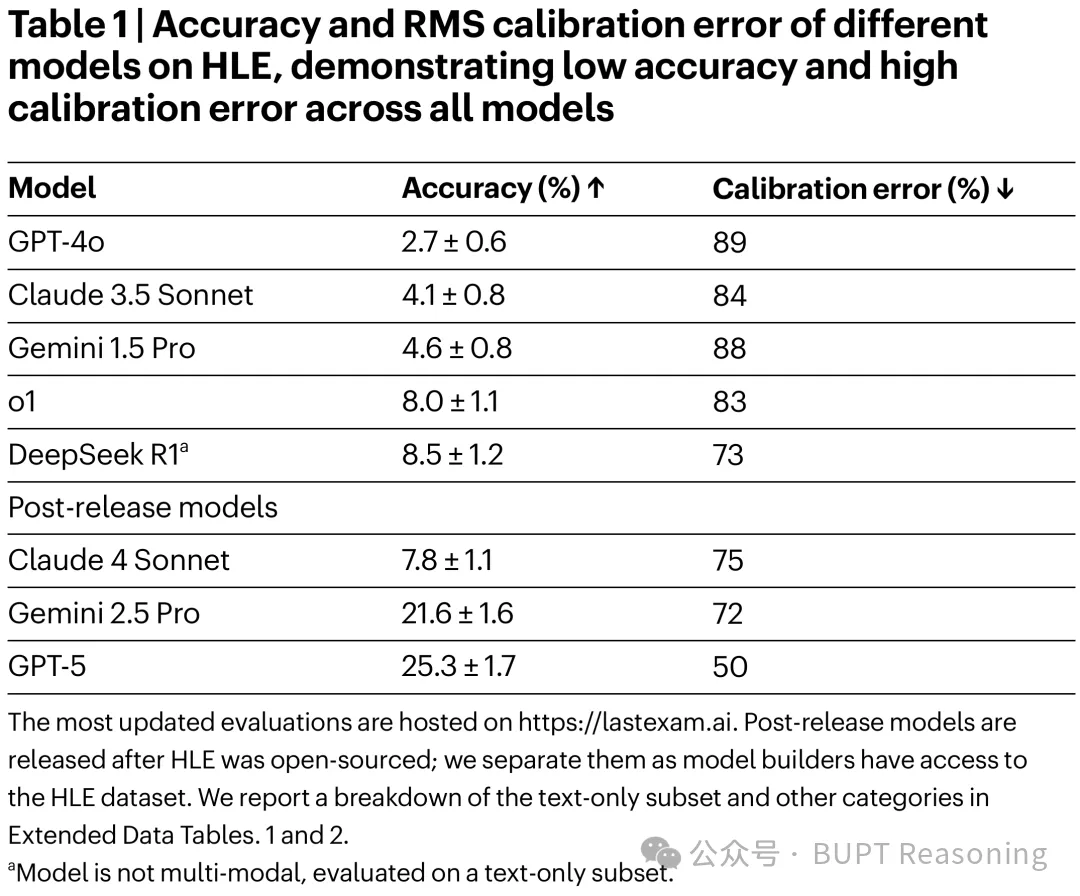
表 1 论文报告的 HLE 准确率与 RMS 校准误差。准确率越高越好,校准误差越低越好;准确率及其“±”报告值沿用原表。表中脚注说明了评测子集及模型发布时间差异。图源:原论文表 1。
表 1 显示,GPT-4o 的准确率为 2.7%,o1 为 8.0%;HLE 公开后发布的 Gemini 2.5 Pro 和 GPT-5 分别达到 21.6% 和 25.3%。但 GPT-5 的均方根(RMS)校准误差仍为 50%,较高的答题成绩并不自动意味着置信度足够可信。
3.2答错之外,还存在过度自信
准确率说明模型答对了多少题,却没有说明它是否知道哪些回答不可靠。为此,HLE 还要求模型给出 0% 到 100% 的置信度,并衡量置信度与实际正确率之间的差距。
用一个假设例子说明:一个模型把一批回答都标为“有 80% 的把握”,如果这些回答最终确实约有 80% 正确,就说明这组预测的置信度比较可信。这种一致性称为校准。
论文中,多数受测模型的均方根校准误差,即 RMS 校准误差超过 70%,说明其自报把握与实际表现存在很大偏差。模型常在答错时仍表现得很有信心。
3.3输出更长,也不一定答得更好
研究还按输出长度比较了部分推理模型的准确率,输出中包含中间推理所用的词元(token)。总体趋势是准确率先随输出长度增加,在约 2¹⁴ 个、即 1.6 万个 token 附近达到峰值,随后下降。
这里比较的是不同输出长度区间中的表现,不能据此推断给任意一道题增加推理预算都会提高准确率。对难题而言,除了愿意花多少计算,还需要考虑这些计算是否形成了有效的求解过程。
04答对专业题,离完成科学研究还有多远?
研究者希望模型协助解决专业难题,HLE 可以提供一部分依据:模型能否理解题目、调用相关知识,并得到可核验的答案。置信度评测则进一步检查,它能否识别自己不可靠的回答。
但 HLE 的题目已经由人提出,答案的判断标准也已给定。真实研究还可能需要发现值得研究的问题,决定收集哪些证据,设计实验,并根据结果修改原先的解释。这些过程超出了封闭式答题的评测范围。
论文因此明确指出,HLE 上的高准确率可以支持对专家级学术答题能力的判断,却不能单独证明模型具有自主科研能力或通用人工智能。
对于科研中的具体用途,还需要增加相应的验证:模型能否正确使用工具,能否处理不完整或相互冲突的证据,以及提出的方案能否经受计算或实验检验。专业题成绩可以成为参考,能否承担实际任务仍需在任务中检验。
05这套更难的试卷,还面临哪些挑战?
5.1专家之间也可能对答案存在分歧
论文报告,在抽样审查与修订后,公开集的专家分歧率估计为 15.4%;针对生物、化学与健康相关题目的审查中,这一比例约为 18%。这些数字提醒我们,专业问题的答案核验仍需要细致的领域知识与证据。
专家分歧率不能直接等同于已经确认的答案错误率。它可能涉及题意、证据、选项判断或答案本身的问题,需要进一步核查。题库更新和结果解释都应保留对这类不确定性的认识。
5.2总分不能代替各个学科的表现
HLE 覆盖广泛,但各类题目的数量并不均衡。数学约占四成,因此总分会较多地受到数学表现影响。一个模型的总体成绩提高,不一定意味着它在化学、医学或人文学科中都同步改善。
如果关心某个具体研究方向,就需要继续查看该学科、相应题型以及纯文本或图文子集的结果。选用评测指标,也要与准备交给模型的任务相匹配。
5.3公开之后,评测本身也需要持续维护
公开题库便于复现和比较,也使模型开发者能够接触题目。此后的分数提升,既可能来自更强的通用能力,也可能受到针对题库的适配影响。保留私有题目,有助于进一步检查这种差别。
论文讨论了持续更新的 HLE-Rolling 方案,用于吸收社区反馈并加入新题。对一套面向快速变化模型的基准而言,维护题目质量、记录数据版本和保持评测条件清楚,与最初出好题同样重要。
06结语
HLE 通过全球专家出题、模型难度筛选和多轮审核,把大模型评测推进到一批更难的专业问题。它呈现出的短板不仅是答对的题还不够多,也包括模型常常不能准确判断自己是否知道答案。
理解这套基准,需要同时关注题目构成、筛选过程和分数的适用范围。回到科研中的实际使用,值得追问的仍然是:面对一个新的专业问题,模型能否给出可靠答案,何时需要补充证据,以及哪些判断仍应交给进一步验证。
本文为个人对论文的解读与总结,图表版权归原作者所有,如需引用请以原论文为准。
BUPT Reasoning
AI4S 专栏 · 评测基准