ARTICLE · 1237368
AI Agent 乱调工具怎么办?4 层工程防线,把误删误改挡在执行之前
用 AI 帮你干活的次数越多,你越可能撞上这种场面:
前一天还在夸它好用,今天你说「帮我把测试环境那台机器清理一下」,它回一句「好的,已完成」。然后你发现,它清的是生产库里的表。
还有一种更隐蔽的:你只是随口问「这个订单现在什么状态」,它却顺手调了个「取消订单」的工具,还一本正经地告诉你「已经为您取消了」。
这两种事的根子是一样的:问题不在 AI 变笨了,而在我们把「做决定」的权力整个交给了它。
这篇文章讲怎么防。不聊「提示词怎么写得更凶」——那顶多算初级方案;真正管用的,是在 AI 和真实操作之间架起四层工程防线。看完你会拿到三样东西:一张全局地图、一份可以直接抄的配置、一份上线前的自查清单。
01 先看清问题的形状
把 AI Agent 想成一个刚入职的实习生:记性一般,特别想表现,嘴上永远说「好的没问题」。
他坐在你的工位上,桌上摆着公司系统的钥匙——能查数据、能改配置、能删记录、能直接给客户发消息。
你交代一句「把测试环境清理一下」,在他的理解里,这等于「我可以自由决定删什么」。剩下的就交给运气了。
已经发生过的翻车,大概逃不出这四类:
· 删错:把「清理测试数据」理解成「清空数据库」
· 改错:用户问价格,它顺手调了「修改价格」的工具
· 发错:把内部草稿当成正式通知,发给外部客户
· 死循环:一个工具报错,它换个参数再来一次,一轮对话调了两百次接口
这四类的共同点是:造成损失的不是 AI 理解得「不够好」,而是它犯错的那一刻没人拦。
02 为什么 AI 一定会乱调工具
想防住,先得承认四件事。
第一,模型是概率机器,不是规则机器。
它输出的是「最像答案的那句话」,不是「经过判断的那句话」。你说「清理」,它脑子里最顺的搭配可能是「删除」。它不会真的去判断你的业务规则。
第二,信息不全的时候,它会自己补全。
用户没说是哪个环境、哪台机器、哪张表,它不停下来问,而是自己挑一个最可能的填进去。它填得越自信,越危险。
第三,工具一多,它认不出谁是谁。
update_user、update_user_profile、patch_user、set_user_status,四个工具穿着同一件衣服站在它面前。工具从 5 个涨到 50 个的时候,选错的概率不是翻倍,是失控。
第四,没人校验,它就会随便填。
没有规则约束的时候,参数就是个自由填空:日期写成「昨天」、ID 写成「最新那个」、金额写成负数。接口只能报错,或者更糟——默默执行了。
结论只有一句:模型永远会犯错。工程体系的任务不是「让它不犯错」,而是「让它犯了错也伤不到人」。
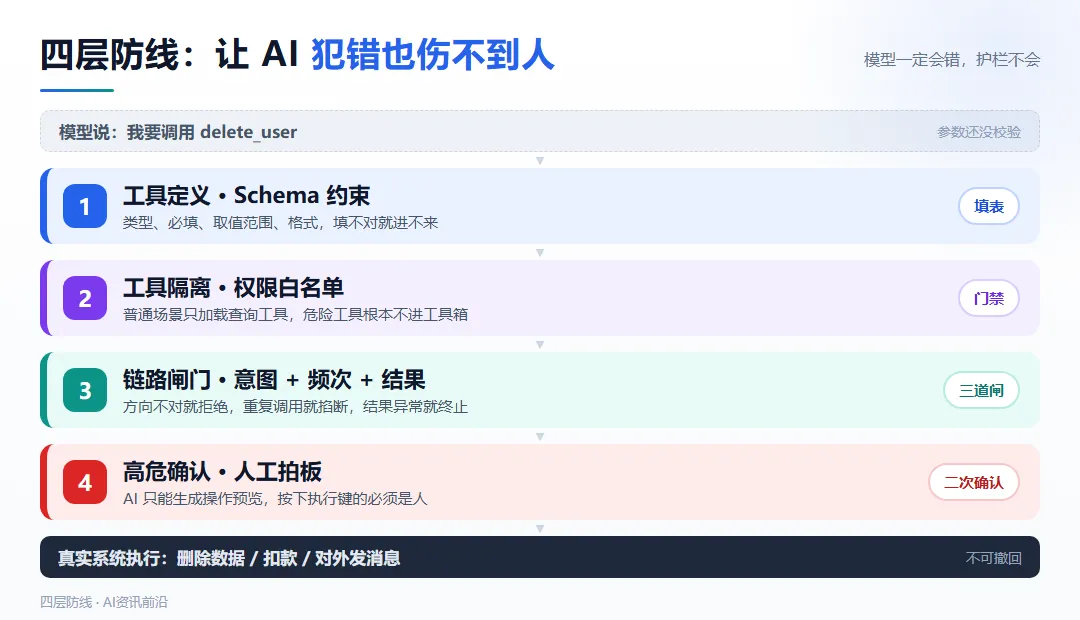
▲ 模型一定会犯错,所以要在它和真实操作之间架起四层防线
03 第一层 · 把「口头交办」变成「填表」
公司不怕员工报销,怕的是「随口说一句就给你打钱」。所以有了报销单:金额、日期、事由、发票,少一项都走不下去。
工具定义就该是这张报销单。
技术上的名字叫 JSON Schema,人话就是「一份给工具写的填写规范」:这个工具要几个参数、每个参数是什么类型、哪些必填、能填哪些值、最长多少字。
具体做三件事。
第一件,把模糊参数改成枚举。 不要让它自由填写「删除原因」,而是给它三个选项:用户主动申请 / 重复账号 / 测试数据清理。它只能在里面挑一个,猜都不给机会。
第二件,把关键参数设成必填,并且规定格式。 用户 ID 必须长成 U 加八位数字的样子,金额必须是正数,时间必须是标准格式。格式不对,就在业务逻辑外面被拦住。
第三件,每个字段都写清楚说明和例子。 说明写给谁看?写给模型看。你写得越具体,它填得越准,这是投入产出比最高的一件事。
最常见的三个坑:所有参数都写成字符串(等于没约束);给了枚举,但说明里写「其他情况自行判断」(等于白给);工具描述写得像诗歌,模型读完还是不知道它能干什么、不能干什么。
04 第二层 · 给工具装门禁
先把工具按「危险程度」分成四类,一类一道门:
| 查询类 | |||
| 修改类 | |||
| 删除类 | |||
| 高危类 |
隔离的意思是:普通问答场景只加载查询类工具。不是「加载了但不许用」,而是根本不在它的工具箱里。模型看不见的工具,它不可能误调。
白名单的意思是:同一个系统,运营账号看到 8 个工具,管理员看到 30 个。权限不是提示词里写一句「你只能查」就算数的,那靠的是自觉;真正的权限,是列表里有没有这个工具。
就像公司的门禁卡:前台能进大厅,能进机房的人一定在名单上。你不会发一张万能卡,然后口头叮嘱他「别进机房」。
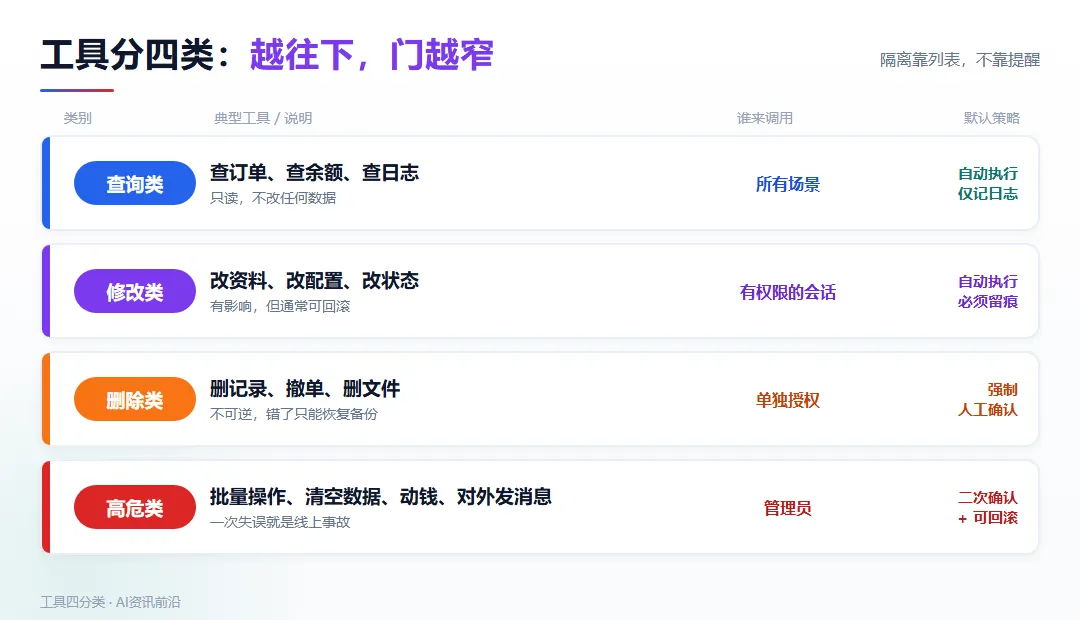
▲ 越往下越危险,能碰到的人越少
05 第三层 · 调用链路上的三道闸门
工具定义管的是「能不能填对」,闸门管的是「这一步该不该发生」。一共三道。
闸门一:前置意图校验。
调用之前先问一句:用户刚才那句话,和这个工具的能力对得上吗?用户问「订单什么状态」,意图是查询;这时候去调「取消订单」,方向就不对,直接拒绝。这道闸门不用多聪明,它只要挡住方向性错误。
闸门二:调用频次限流。
给单轮任务设上限:最多调 12 次工具、同一个工具最多重复 3 次、超时就终止。这一条能砍掉大部分死循环。真实场景里,「AI 疯狂重试把下游接口打崩」比「AI 删错数据」更常发生。
闸门三:结果后置校验。
工具返回空数据、报错、超时的时候,不允许模型拿着这份结果继续编答案。要么让它带着错误信息重试一次,要么直接停掉任务,把失败原因告诉用户。
三道闸门都不判断「AI 想不想」,只判断「这一步合不合法」。这就是工程兜底和提示词约束的区别。
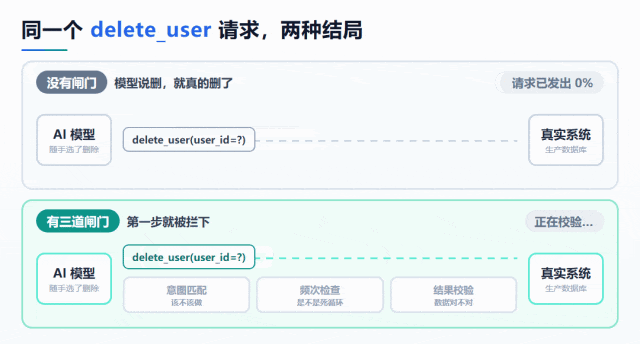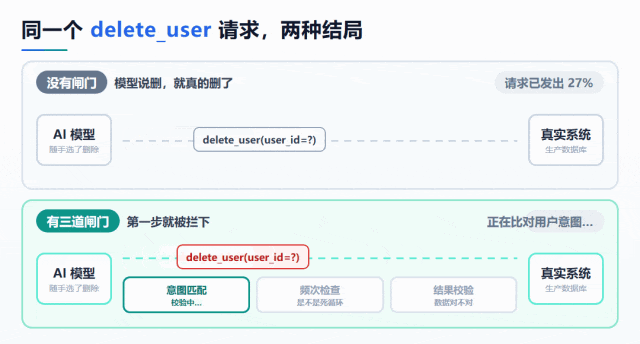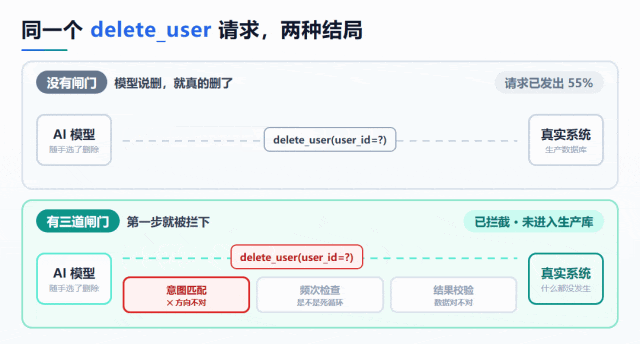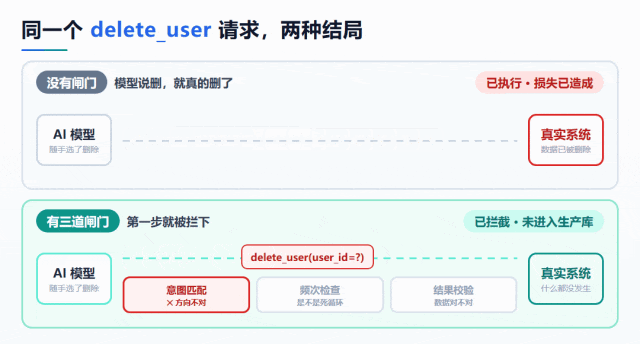
▲ 左边一路裸奔到执行,右边每一步都被拦一次
06 第四层 · 高危操作,AI 只能申请不能执行
前面三层都是自动的,这一层必须有人。
规则很硬:AI 无权自主执行高危操作。它只能生成一份「操作预览」,由人来按下执行键。
预览里必须写清四件事:
· 要做什么:删除 user_id = U00012345 这个账号
· 为什么:用户在对话里明确要求注销
· 影响范围:该账号名下 3 个订单、2 份文件会被一并归档
· 能不能退:7 天内可以从归档里恢复
❌ 不给预览直接执行:出事之后你只能翻日志复盘,损失已经造成
✅ 预览 + 确认 + 执行:AI 负责准备,人负责拍板。哪怕 AI 判断错了,也是人眼看到的错,而不是系统自己捅出来的错
一句话记住四层的分工:查询自动跑,修改留痕迹,删除要确认,高危要双签。
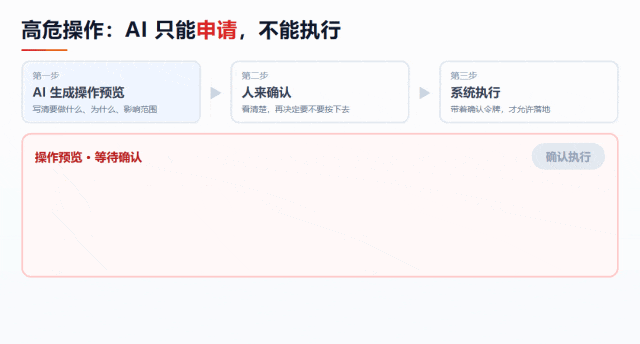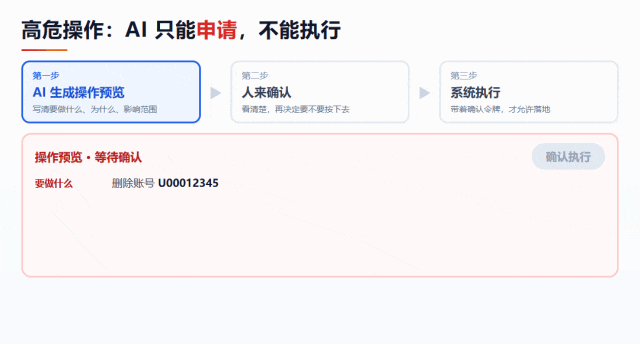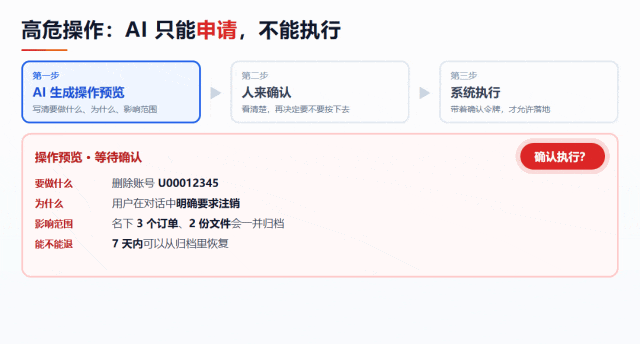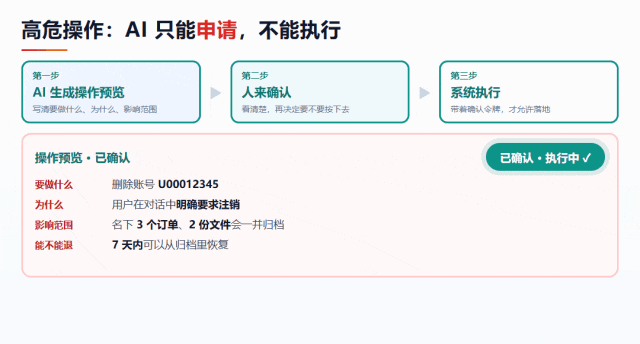
▲ AI 只负责生成预览,按下执行键的永远是人
07 可以直接抄走的一段配置
上面四层落到代码里,其实就是两份东西:一份写清楚每个工具长什么样,一份写清楚每类工具怎么管。
先看「删除账号」这个工具的定义。注意最后那个 confirm_token——它必须由用户在确认之后产生,AI 拿不到也编不出来,这是整段配置里最关键的一笔。
{ "name": "delete_user", "description": "删除用户账号。仅当用户在对话中明确要求删除时使用,禁止用于测试数据清理。", "parameters": { "type": "object", "properties": { "user_id": { "type": "string", "pattern": "^U[0-9]{8}$", "description": "用户 ID,形如 U00012345" }, "reason": { "type": "string", "enum": ["user_request", "duplicate", "test_cleanup"], "description": "删除原因,只能从这三个值里选" }, "confirm_token": { "type": "string", "description": "用户二次确认后拿到的令牌,模型不得自行生成" } }, "required": ["user_id", "reason", "confirm_token"] }}
再看风控那一侧。每类工具的默认策略、限流阈值、结果异常怎么处理,全写在一个地方:
tools: query: { auto: true, log: true } write: { auto: true, audit: true, max_per_turn: 3 } delete: { auto: false, require_confirm: true } danger: { auto: false, require_confirm: true, min_role: admin }loop_guard: max_tool_calls_per_turn: 12 max_repeat_same_tool: 3 on_timeout: abortresult_guard: empty: retry_once_then_abort error: stop_and_report timeout: stop_and_report
上面这份配置里,没有一行在「教育模型」。它做的是:把危险的工具挡住、把重复的调用掐断、把错误的结果拦住。
这不是提示词,这是护栏。
08 上线前的自查清单
十项,逐条过一遍:
☐ 每个工具都有 JSON Schema,没有「自由填空」的参数
☐ 所有写操作、删除操作都有审计日志,能查到「谁在什么时候让 AI 做了什么」
☐ 工具按查询 / 修改 / 删除 / 高危分了四类,分类落在配置里,不靠自觉
☐ 普通问答场景只加载查询类工具,高危工具根本没进工具箱
☐ 不同角色看到的工具列表不同,权限写在白名单里
☐ 单轮任务有调用次数上限,同一个工具的重复调用也有上限
☐ 空结果、报错、超时三种情况,都有明确的处理策略
☐ 所有高危操作都需要人工确认,确认信息里写清了影响范围
☐ 有一个「一键刹车」的总开关,出事时能立刻停掉全部工具调用
☐ 上线前用真实场景做过一次「故意让它乱来」的演练
最后提醒三个常见误区。
误区一:把提示词写得足够严厉,就安全了。 提示词管的是「倾向」,工程管的是「边界」。靠自觉和靠制度,是两回事。
误区二:只防删除,不防「发出去」。 给客户群发错消息、把内部草稿推到公网,同样收不回来。凡是不可撤回的动作,都算高危。
误区三:觉得「我们量小,不会出事」。 事故概率和业务量成正比,但和「有没有护栏」成反比。
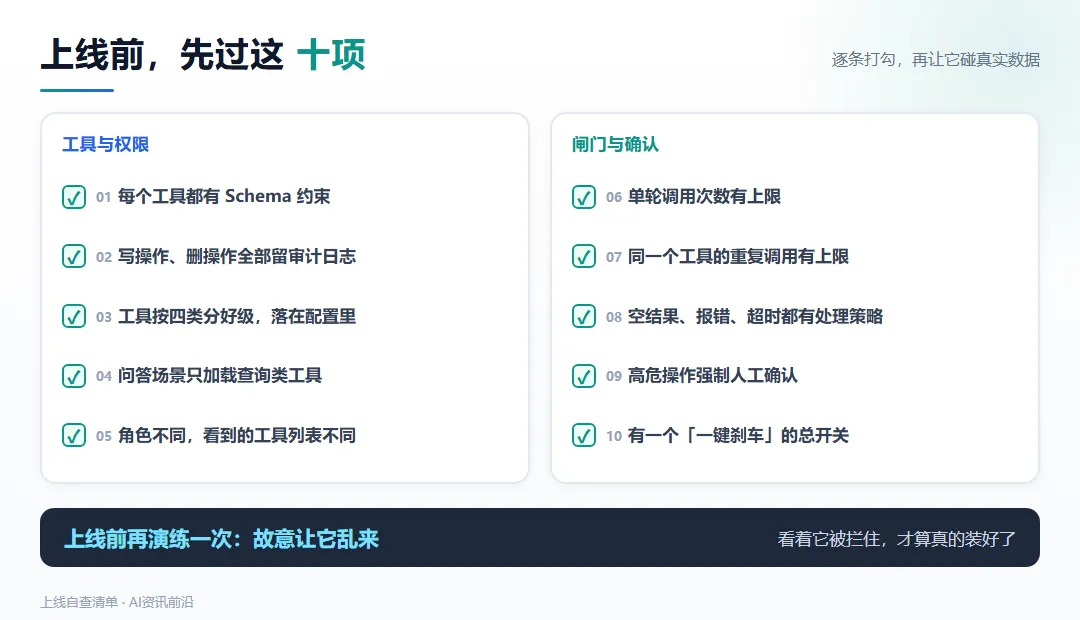
▲ 十项过完,再让它碰真实数据
09 结语:让 AI 犯错,但别让它造成事故
回到开头那个实习生。
你不会因为不信任他,就不让他干活。你只是不会把公章交到他手上,也不会让他一个人签字打款。
AI Agent 的管理逻辑是一样的:把它的能力用在效率上,把它的权限关在制度里。
初级方案是反复叮嘱它「别乱来」,高级方案是让它根本没有乱来的机会。
今天就可以做一件事:打开你的工具清单,给每一个工具按「查询 / 修改 / 删除 / 高危」标个颜色。标完你就会知道,哪几个工具现在正光着站在那儿。
官方文档
JSON Schema 官网:https://json-schema.org/
MCP 官方文档:https://modelcontextprotocol.io/
OpenAI 函数调用指南:https://platform.openai.com/docs/guides/function-calling
往期推荐