ARTICLE · 1257680
AI前沿|npj Precis Oncol:只看HE切片预测胚系BRCA突变,1025例外部验证AUC 0.81
点击上方蓝字 Mua科研 关注我们,设为 ⭐星标,每天一篇文献精读、读图和实验干货,第一时间推送给你。
 写在前面
文献卡片
npj Precision Oncology|开放获取(CC BY-NC-ND 4.0)|Article in Press
论文:Multicentre validation of BRCAura, an AI-based histology model predicting germline BRCA1/2 mutations in HR+/HER2− breast cancer|2026 年 10 月 12 日在线|DOI: 10.1038/s41698-026-01753-y
第一作者兼通讯作者 Oussama Tchita(Waiv,巴黎),末位作者 Magali Lacroix-Triki(法国 Gustave Roussy 研究所),共 24 位作者
研究类型:回顾性、多中心外部验证;模型由 Waiv 公司开发
本文用到的图:原文 Fig. 1–5,许可不允许改编,均为整图转载
核心结论: 在 6 个中心 1025 例 HR+/HER2− 早期乳腺癌中,BRCAura 预测胚系 BRCA1/2 突变的 AUROC 为 0.807(切除标本)和 0.824(活检标本),在约 93% 敏感度下排除了 343 例患者,其中 16 例实际是携带者。
大家好~HR+/HER2− 乳腺癌患者要不要查胚系 BRCA1/2,现在主要看年龄、家族史这些条件。问题是,按这些条件筛,人群研究估计会漏掉大约一半的携带者;全部都测,费用、测序和遗传咨询的人手又跟不上。
法国 AI 病理公司 Waiv 想走第三条路:病理科本来就要做的 HE 切片,扫描后让模型先看一遍,把“不太可能携带突变”的人挑出来,剩下的再送基因检测。它的定位是排除,不是诊断。
这篇 10 月 12 日上线的 npj Precision Oncology 论文,是这个模型的多中心外部验证。
先说几个词:
✦胚系突变(gBRCAm):从父母遗传、全身细胞都带有的突变,区别于只在肿瘤里出现的体细胞突变。
✦AUROC:ROC 曲线下面积,0.5 等于瞎猜,1 是完全分开。
✦敏感度和特异度:敏感度是真携带者被模型留下来的比例;特异度是不携带者被模型排除的比例。
✦AI-WT 和“待定”:BRCAura 只给两种结论。AI-WT 表示不太可能携带,可以不送检;“待定”(Undetermined)表示仍需基因检测。

 01模型怎么看切片:只挑肿瘤区域,最后取最极端的 20 个小块打分
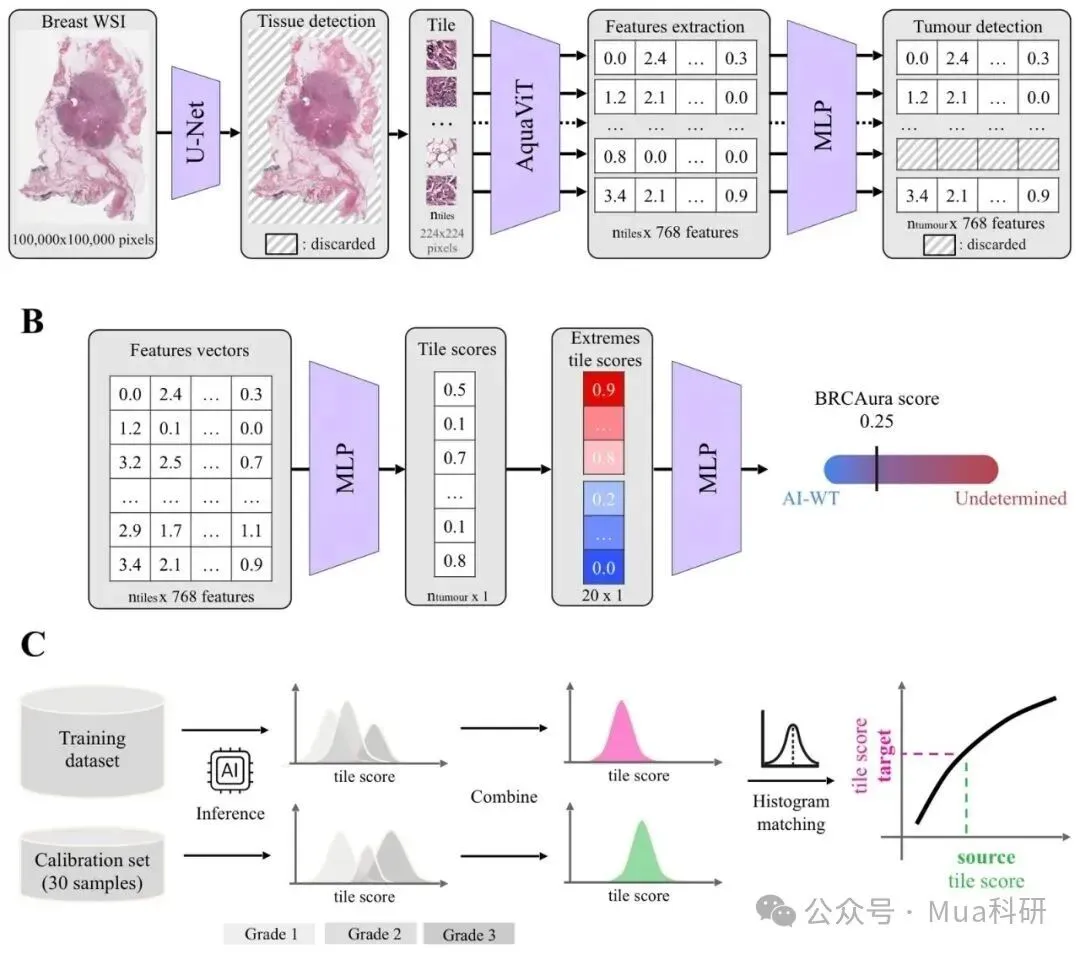
原文 Fig. 1|BRCAura 的模型结构与切片分析流程:A 组织识别、切块、特征提取和肿瘤区域筛选;B CHOWDER 多示例学习结构;C 用 30 张已知分级切片做中心校准。图源:Tchita O, Samuelsson E, Jacobs D, et al. npj Precis Oncol 2026, doi:10.1038/s41698-026-01753-y,CC BY-NC-ND 4.0;整图转载,未改动
一张全切片扫描图大约 10 万 × 10 万像素。BRCAura 先识别组织,切成 224 × 224 像素的小块,用病理基础模型 AquaViT(由 H-optimus-0 蒸馏而来)提取特征,再丢掉所有被判为非肿瘤的小块。
剩下的小块各打一个分,模型只保留最高的 10 个和最低的 10 个,汇总成整张切片的分数,分数低于阈值就判为 AI-WT。最终模型是 150 个这样的网络的集成。
训练分两步。胚系突变病例太少,作者先用 TCGA 里乳腺癌、卵巢癌和前列腺癌共 957 张切片,以同源重组缺陷(HRD)评分做预训练;正式训练用的是 Gustave Roussy 的 639 张切片(429 名患者)。
另一个设计是校准。不同医院的染色和扫描仪差别很大,每个新中心只需提供 30 张已知组织学分级的切片,不需要基因结果,模型据此对齐分数分布,阈值就能沿用。
 02外部验证:1025 例里排除 343 例,漏掉 16 例携带者
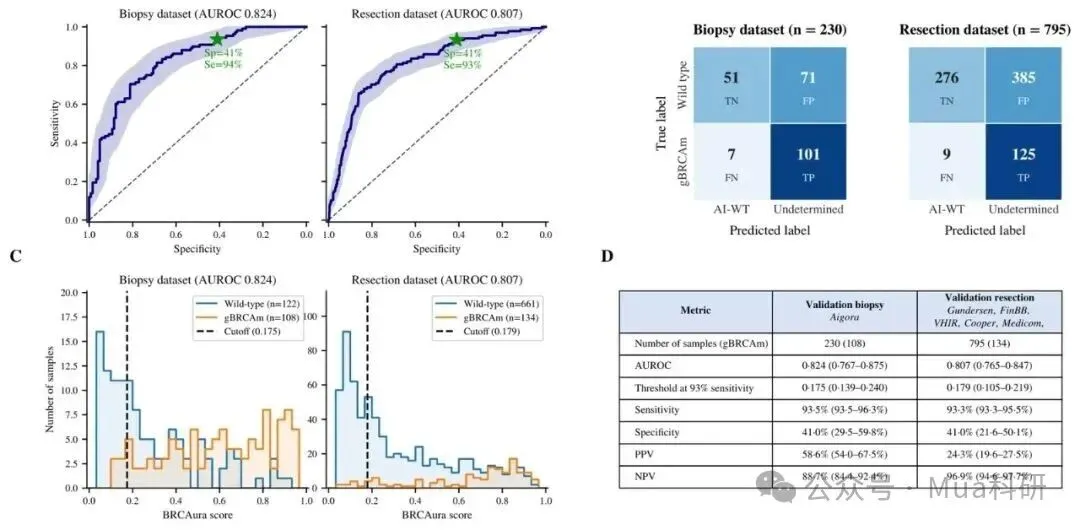
原文 Fig. 2|外部验证结果:A ROC 曲线;B 约 93% 敏感度阈值下的混淆矩阵(左为活检,右为切除);C 两组分数分布;D 各项指标汇总。图源:Tchita O, Samuelsson E, Jacobs D, et al. npj Precis Oncol 2026, doi:10.1038/s41698-026-01753-y,CC BY-NC-ND 4.0;整图转载,未改动
验证数据来自德国、芬兰、西班牙和美国的 6 个中心,用了 4 种扫描仪,训练机构没有参与收集。切除标本 795 例(134 例携带者),活检标本 230 例(108 例携带者),另有每个中心 30 张校准切片不计入结果。
在约 93% 敏感度的阈值下:切除组 AUROC 0.807,特异度 41.0%,阴性预测值 96.9%;活检组 AUROC 0.824,特异度 41.0%,阴性预测值 88.7%。
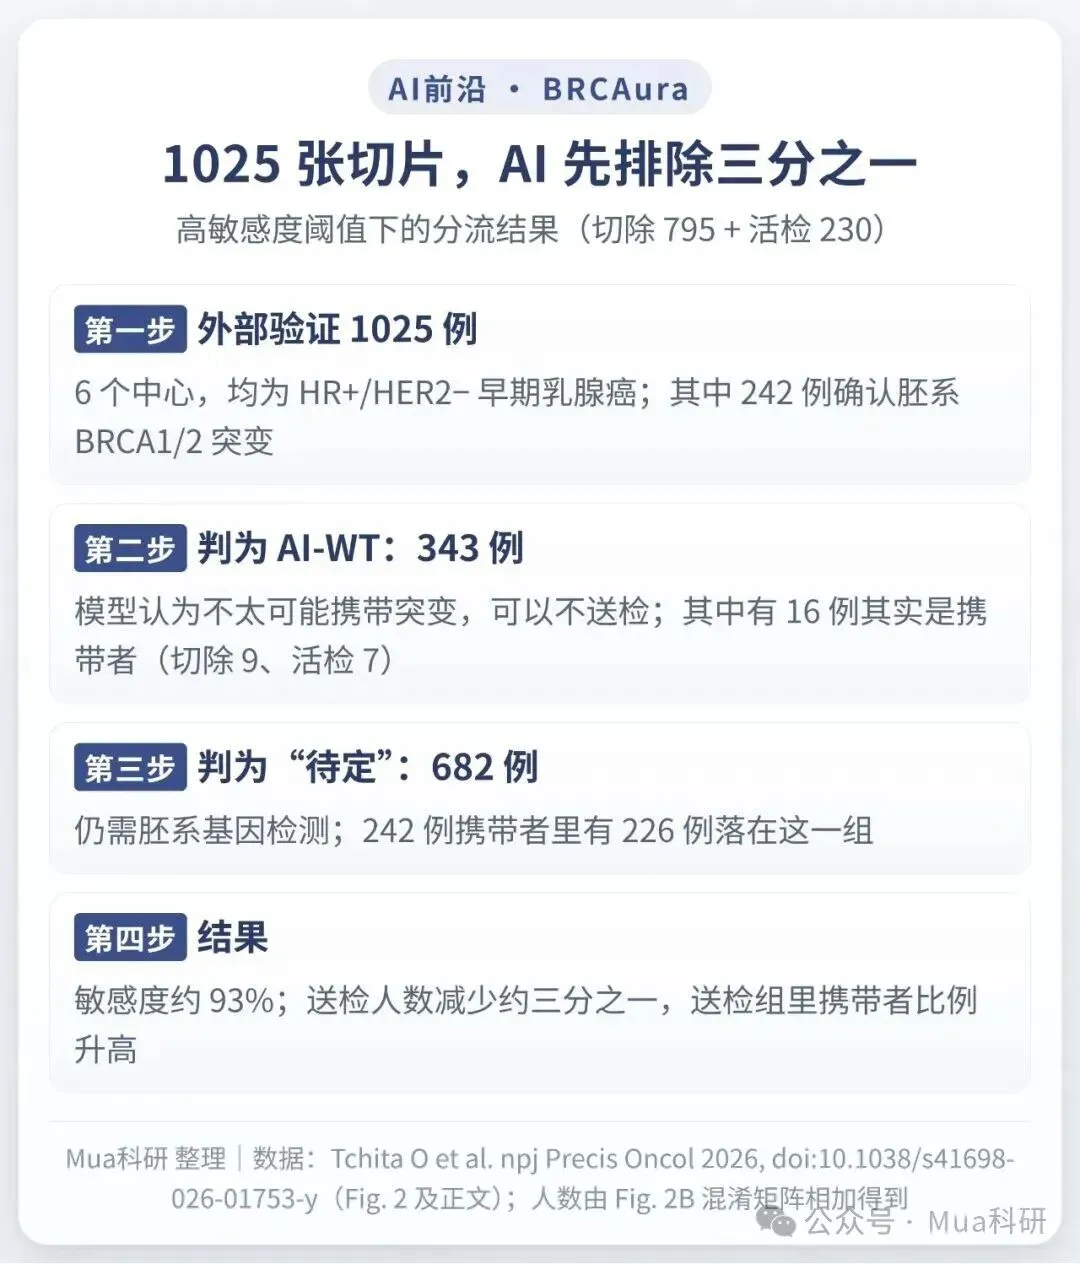
外部验证 1025 例的分流结果。Mua科研 整理;人数由原文 Fig. 2B 混淆矩阵相加得到,数据来源 Tchita O et al. npj Precis Oncol 2026
把 Fig. 2B 的混淆矩阵加起来:343 例被判为 AI-WT,占全部患者的三分之一;这 343 人里有 16 名携带者(切除 9 例、活检 7 例)。242 名携带者中,226 名留在了需要送检的“待定”组。
摘要里写的是排除了“约三分之一的野生型病例”,按混淆矩阵算,被排除的野生型是 327/783,约 42%;三分之一对应的是全部患者(343/1025),正文也是这么写的。
 03比年龄、家族史准,但在活检组两者能互补
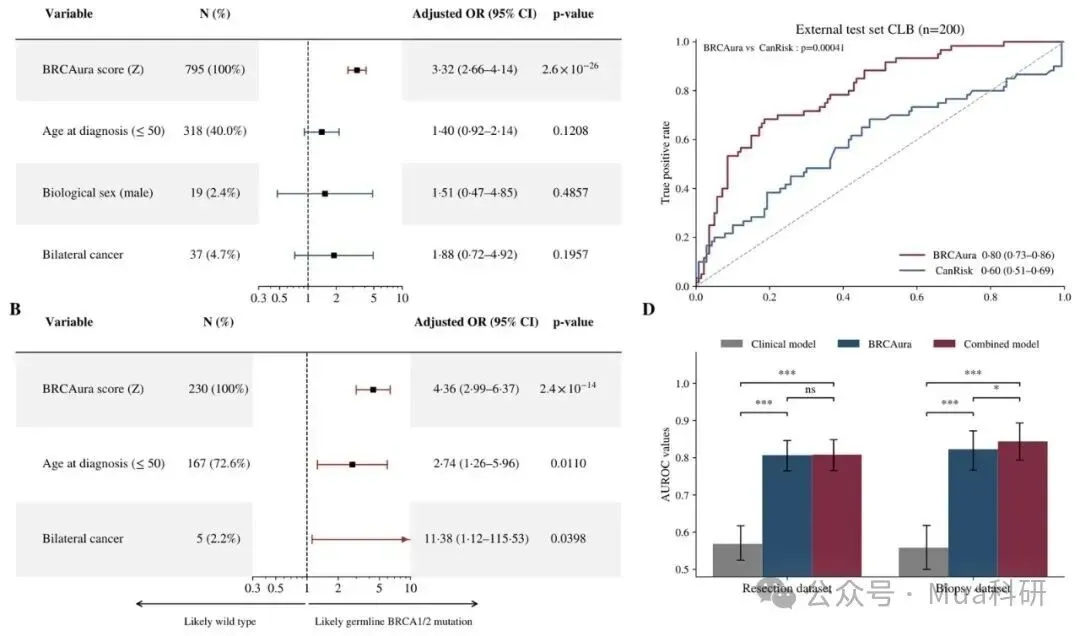
原文 Fig. 3|BRCAura 与临床风险因素、家族史模型的比较:A、B 切除组和活检组的多变量 logistic 回归;C 在 CLB 测试队列(200 例)中与 CanRisk 的 ROC 比较;D 临床模型、BRCAura 和联合模型的 AUROC。图源:Tchita O, Samuelsson E, Jacobs D, et al. npj Precis Oncol 2026, doi:10.1038/s41698-026-01753-y,CC BY-NC-ND 4.0;整图转载,未改动
作者把诊断年龄、双侧乳腺癌、性别和家族史评分放进同一个回归模型。切除组里,只用临床变量 AUROC 是 0.585,BRCAura 是 0.807,两者合起来 0.810,加上临床信息几乎没有提升。
活检组不一样:临床变量 AUROC 0.673,合并后从 0.824 升到 0.866,年轻和双侧发病也是独立预测因素。作者的解释是活检组携带者比例高达 47%,多是高危家系,年龄这类传统指标在这种人群里本来就好用。
在法国 Centre Léon Bérard 的 200 例测试队列里,BRCAura 和常用的家族史模型 CanRisk 直接比较,AUROC 分别是 0.80 和 0.60(DeLong 检验 p = 0.00041)。
 04换切片、换扫描仪,分数基本稳定
作者用 24 名患者的连续切片测重复性,每例做 3 张 HE、3 张 HES(苏木精-伊红-藏红)染色。同一块组织不同切片之间,组内相关系数在 HE 是 0.9888,HES 是 0.9926。
同一批切片用两台不同扫描仪扫,校准后阈值附近的偏差明显缩小,比如 CLB 活检组从 −0.179 降到 0.036。
按基因分开看,切除组 BRCA1 和 BRCA2 的 AUROC 分别是 0.788 和 0.808,两者没有显著差异。
 05模型看的是什么:细胞密、淋巴细胞多的区域
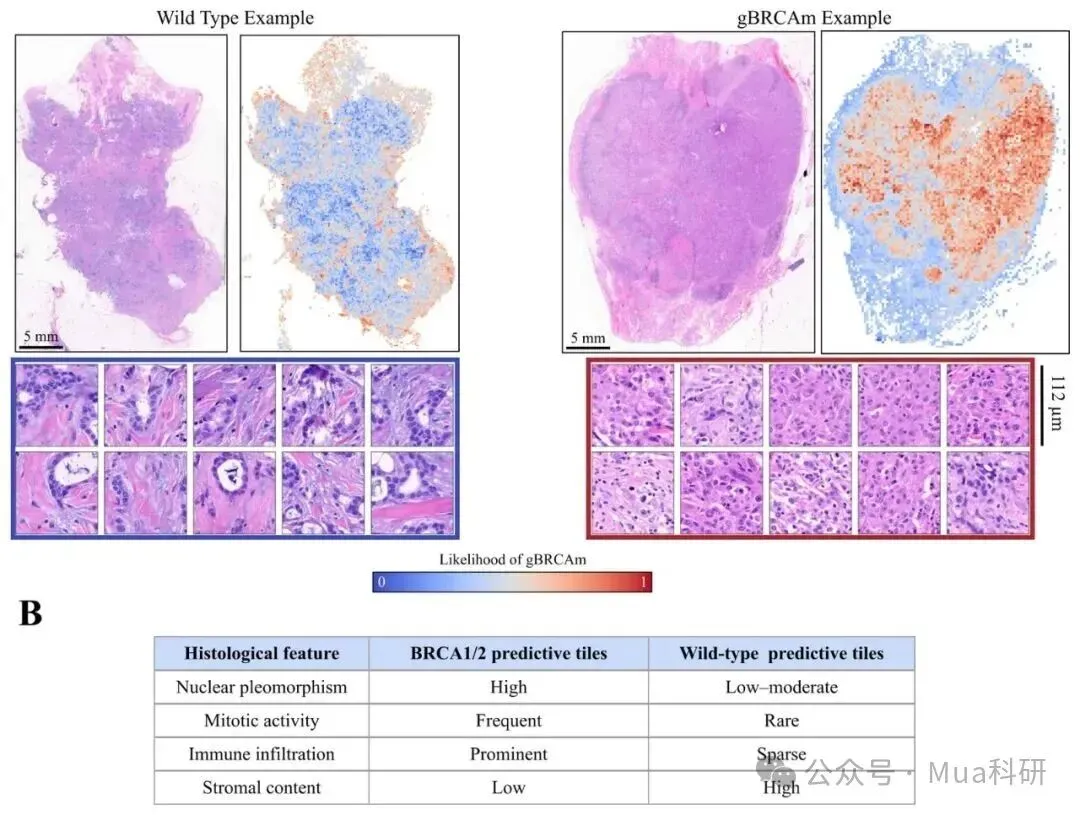
原文 Fig. 4|野生型和胚系 BRCA1 突变病例的小块预测热图,以及两类最具预测性区域的形态特征。图源:Tchita O, Samuelsson E, Jacobs D, et al. npj Precis Oncol 2026, doi:10.1038/s41698-026-01753-y,CC BY-NC-ND 4.0;整图转载,未改动
热图显示,高分区域不是均匀分布,而是成簇出现。病理医生复核时看到,高分区域多是肿瘤细胞密集、核多形性明显、核分裂多、淋巴细胞浸润明显的实性区;低分区域则以纤维间质为主,肿瘤细胞少,常呈管状结构。
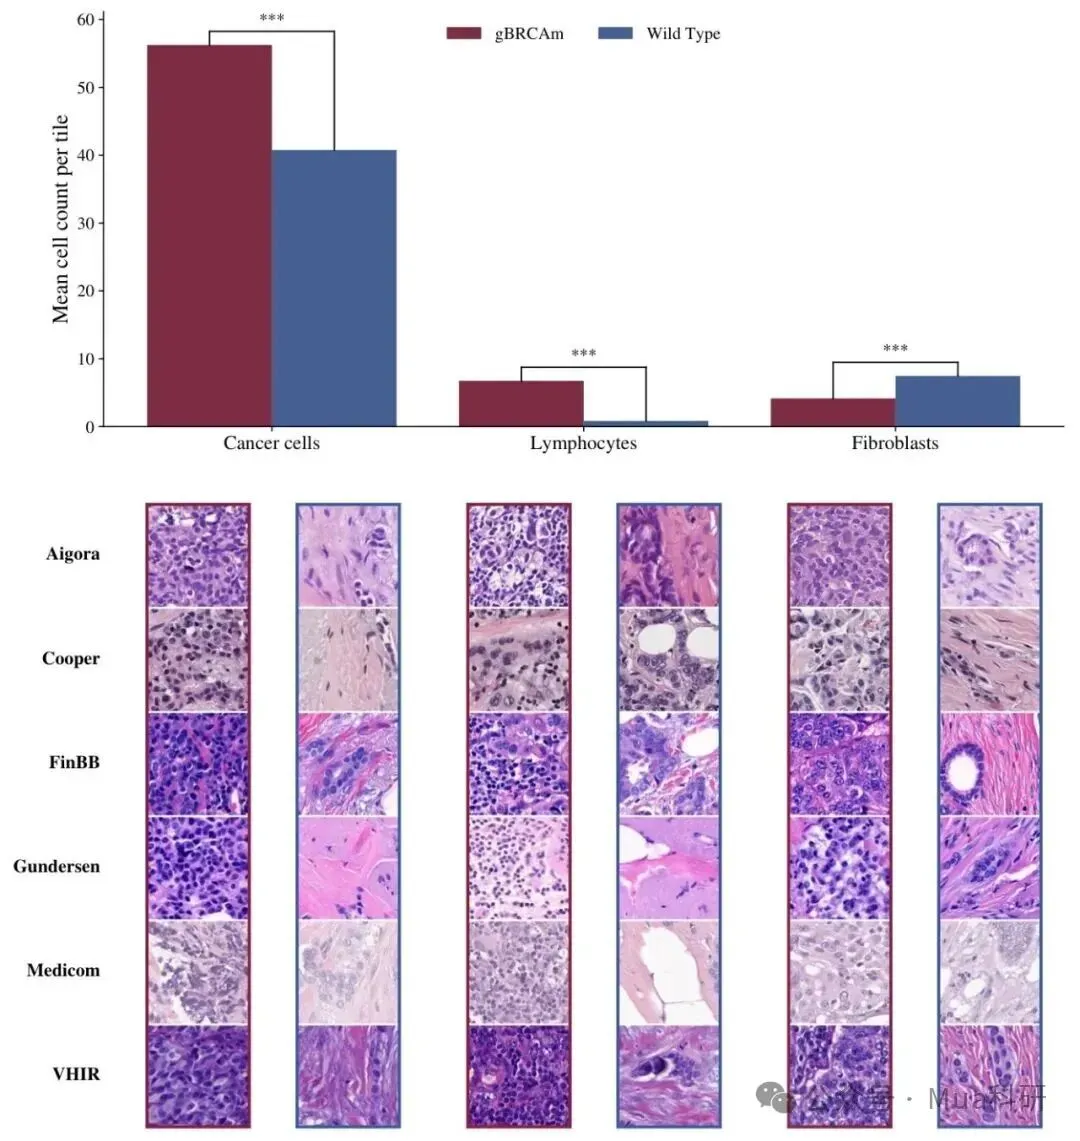
原文 Fig. 5|在突变预测区域与野生型预测区域中,每个小块的肿瘤细胞、淋巴细胞和成纤维细胞平均数量,以及 6 个验证中心的代表性小块。图源:Tchita O, Samuelsson E, Jacobs D, et al. npj Precis Oncol 2026, doi:10.1038/s41698-026-01753-y,CC BY-NC-ND 4.0;整图转载,未改动
用细胞分割工具定量也是同样的结果:突变预测区域的肿瘤细胞和淋巴细胞更多,野生型预测区域的成纤维细胞更多,6 个中心都一致。这些特征和以往报道的 BRCA 相关乳腺癌形态相符。
作者还翻看了一些假阳性病例:有一例肿瘤带体细胞 BRCA1 移码突变,另有几例携带 PALB2 等其他同源重组基因的胚系突变。模型抓到的可能是更宽泛的 DNA 修复缺陷形态,而不只是胚系 BRCA。作者明确说,现阶段不主张用它检测这些情况。
 06数字要放回人群里看:携带者越少,阳性预测值越低
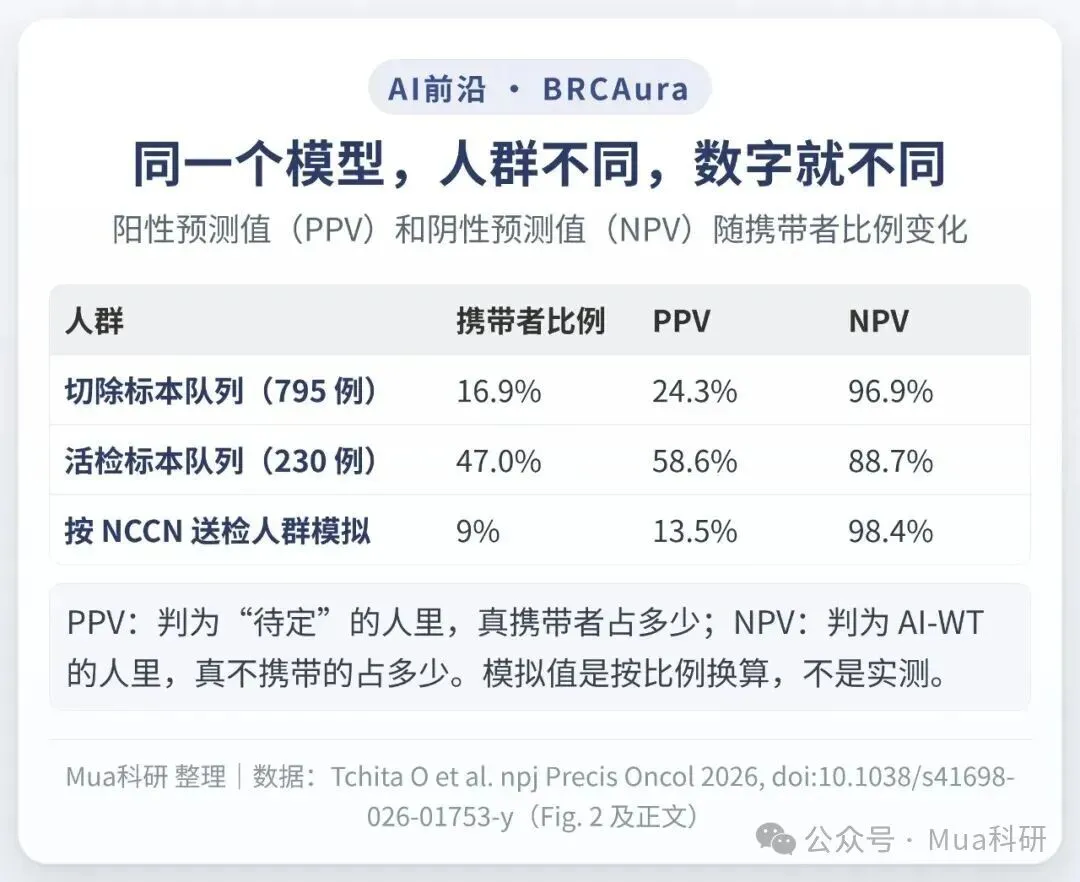
不同携带者比例下的阳性和阴性预测值。Mua科研 整理;数据来源 Tchita O et al. npj Precis Oncol 2026 正文与 Fig. 2D
验证人群本来就是按 NCCN 标准送检过的,又特意加入了更多携带者,所以切除组携带者占 16.9%,活检组高达 47.0%,比普通乳腺癌人群高得多。
作者按 9% 的携带者比例做了模拟:阳性预测值 13.5%,阴性预测值 98.4%。这是按比例换算的结果,不是实测,作者也说需要前瞻性验证。
作者自己列出的局限还有:全部是回顾性数据;没有种族信息,无法判断不同人群表现是否一致;家族史记录不全;没有配对的肿瘤-正常组织测序来区分胚系和体细胞信号。
 07利益关系:Waiv 开发,阿斯利康参与撰写
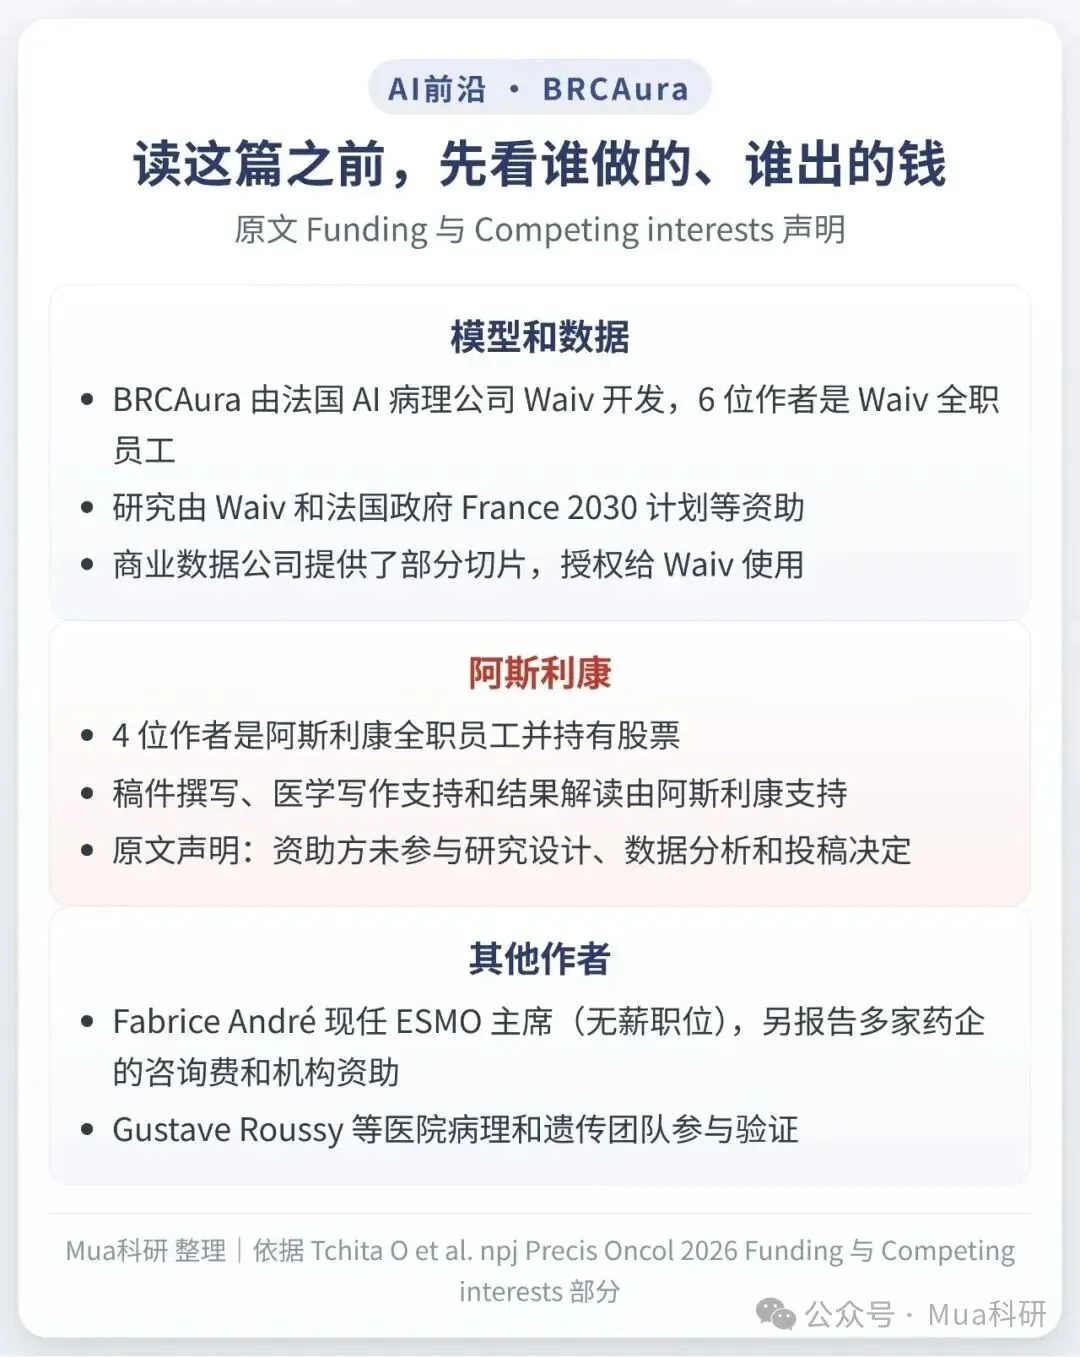
原文资助与利益冲突声明要点。Mua科研 整理;依据 Tchita O et al. npj Precis Oncol 2026 Funding 与 Competing interests 部分
BRCAura 是 Waiv 的产品,6 位作者是 Waiv 员工。4 位作者是阿斯利康的全职员工并持有股票,原文写明稿件撰写、医学写作支持和结果解读得到阿斯利康支持,同时声明资助方没有参与研究设计、数据分析和投稿决定。
作者之一 Fabrice André 现任欧洲肿瘤内科学会(ESMO)主席,这是无薪职位,他另外申报了多家药企的咨询费和机构资助。
补充一个背景:阿斯利康是 PARP 抑制剂奥拉帕利的厂家之一,胚系 BRCA 突变的早期高危乳腺癌患者可以用它做辅助治疗。这类模型的“排除”功能用得越多,送检的人群也就越集中。
 Mua碎碎念
这篇我觉得最有价值的是那张混淆矩阵。AUC 0.81 听起来一般,但模型的用法本来就不是“判断谁有突变”,而是“先放走一部分人”。放走的 343 人里有 16 名携带者,这个数字比 AUC 更值得拿到临床讨论:被模型漏掉的人,可能就错过了 PARP 抑制剂。
能少测三分之一,在测序资源紧张的地方确实有意义。可如果当地本来就能全员检测,这个工具的价值就小很多。另外摘要把“三分之一患者”写成了“三分之一野生型病例”,读原文时值得留意。目前它还是科研用途版本,下一步要看前瞻性、连续入组人群里的表现。
参考资料
[1] Tchita O, Samuelsson E, Jacobs D, Boulet A, Von Loga K, Hocquet E, Hill RJ, Di Maio T, Rossi G, Rawson J, Kenny PA, Holdbrook T, Hernandez-Losa J, Irshad S, Daidj F, Whittum A, Badoual C, Campoy S, Lasset C, Chassagne-Clément C, André F, Garberis I, Caron O, Lacroix-Triki M. Multicentre validation of BRCAura, an AI-based histology model predicting germline BRCA1/2 mutations in HR+/HER2− breast cancer. npj Precis Oncol. 2026. doi:10.1038/s41698-026-01753-y(Article in Press,CC BY-NC-ND 4.0)
[2] Tchita O, Garberis IJ, et al. 327P Development and validation of BRCAura: a histology model to predict germline BRCA1/2 mutations from HR+/HER2- breast cancer images. Ann Oncol. 2025(ESMO 2025 会议摘要)。https://www.annalsofoncology.org/article/S0923-7534(25)01676-X/fulltext
[3] Waiv. Case Study: BRCAura RUO. https://waiv.com/case-studies/brcaura-ruo