ARTICLE · 1278677
英国医院在用的抗菌药 AI 助手:简单问题 96% 正确,复杂场景跌到 23%
2026 年 10 月 26 日,medRxiv 在线发表了牛津大学 CAMS Oxford Institute 与 Nuffield 医学系团队的一项研究:对已在英国多家 NHS 医院上线的抗菌药 AI 建议工具 Ask Eolas 做了迄今最大规模的系统评测——1,040 个基于真实指南生成的模拟临床问题、10 名医生独立评审、再加 HealthBench 外部验证,回答一个所有医院上线 AI 助手前都绕不开的问题:它什么时候可以信,什么时候不能。
抗菌药处方是典型的「时间敏感型」决策:要同时整合感染特征、本地耐药模式和患者个体因素(过敏、肾功能),选错了不只是治疗失败,还会推动耐药。近年 OpenEvidence、UpToDate Expert AI 等医学 AI 工具陆续进入临床,它们大多采用检索增强生成(RAG)架构,让模型基于给定知识库作答而非凭内部记忆。但一个方法论难题始终悬着:这类工具到底要考多少分,才算「可以上线」?目前既没有标准评测框架,既往小规模研究的结论也互相打架。
核心结论
Ask Eolas 在简单(单源指南)查询上表现稳健:LLM 评委与 10 名医生双双判定 96% 回答正确、99% 以上有据可依;但在需要跨多页指南整合信息的复杂场景,正确率从 96% 跌至 23%(医生评审为 66%),瓶颈在检索——多源查询平均只召回 60% 的相关指南页。972 条回答中 25 条被判不安全,其中 4 条被医生评为高致害可能。HealthBench 外部验证的失分中 62% 其实是本地指南与 benchmark 金标准的差异,提示通用 benchmark 直接套用会「误罚」本地化实践。
抗菌药选择需要同时参考多股信息流:感染部位与严重程度、本地耐药谱、患者的过敏史与肝肾功能。各国普遍的做法是由医院制定本地化抗菌药指南,但指南页数庞大、查询费时,低年资医生在夜班等高负荷场景下尤其依赖快速可得的建议。这正是 AI 建议工具的切入点。
Ask Eolas 是英国 Eolas 指南分发平台上的 AI 问答功能,基于 RAG 架构:从本院指南中检索相关页面,再由 LLM 生成有据可查的回答。此前唯一一项正式评估(Waldock 等,2026)发现,使用该工具的医生在 15 个模拟病例中全部答对,而用手机指南和传统纸质指南的医生分别答对 9 例和 7 例——但 15 个病例的样本量远不足以刻画工具的真实性能边界。与此同时,关于同类工具的研究结论并不一致:有研究称 OpenEvidence 在真实临床问题上优于通用前沿模型,也有研究得出相反结论。
本研究的推进在于三点:① 评测规模从十几例跳到 1,040 问,且问题由三家真实 NHS 医院的现行指南生成,覆盖单源(答案在一页指南内)与多源(需跨页整合,如「过敏 + 肾功能不全时选什么药」)两个难度层级;② 用 LLM 评委与 10 名医生双轨评审,可以量化两者的一致性;③ 加入 HealthBench 公开 benchmark 做外部验证,检验通用基准对本地化工具的适用性。
研究纳入三家使用 Eolas 平台的英国 NHS 医院集团(Barts Health、Buckinghamshire、Cambridge)的成人抗菌药指南,共 1,024 页,其中 718 页(70.1%)被用于生成问答对。最终 benchmark 含 1,040 个问答对:463 个单源问题、233 个多源问题,以及模拟高负荷工作场景的改写变体——「精简版」(压缩成关键词式提问)和「噪声版」(故意打错字、混入缩写与商品名)共 344 个。问答对由 LLM 生成后,10%(103 对)经医生抽样核查:76% 的问题被判有高度临床相关性,98% 的参考答案完全有指南支持,无一对存在重大遗漏。
关键概念
检索增强生成(RAG):让 LLM 先从指定知识库(这里是本院抗菌药指南)检索相关段落,再基于检索到的内容生成回答,而非依赖模型内部记忆。优点是答案有出处、可随指南更新;代价是性能上限受检索质量制约——检索漏了,回答很难对。本文的多源查询结果正是这一约束的实证。
每条 Ask Eolas 回答由 LLM 评委(Gemini-3-flash-preview)从五个维度自动评分:正确性、相关性、有据性(groundedness)、安全性、速览摘要充分性;同时 10 名医生(含低年资医生与感染科专家)对 103 对问答独立评审,共贡献 278 条评分,每条至少两名医生背靠背。统计上采用 Wilson 区间估计 95% CI、bootstrap 10,000 次重采样,医生间一致性用 Krippendorff α、医生与 LLM 评委一致性用 Cohen κ。
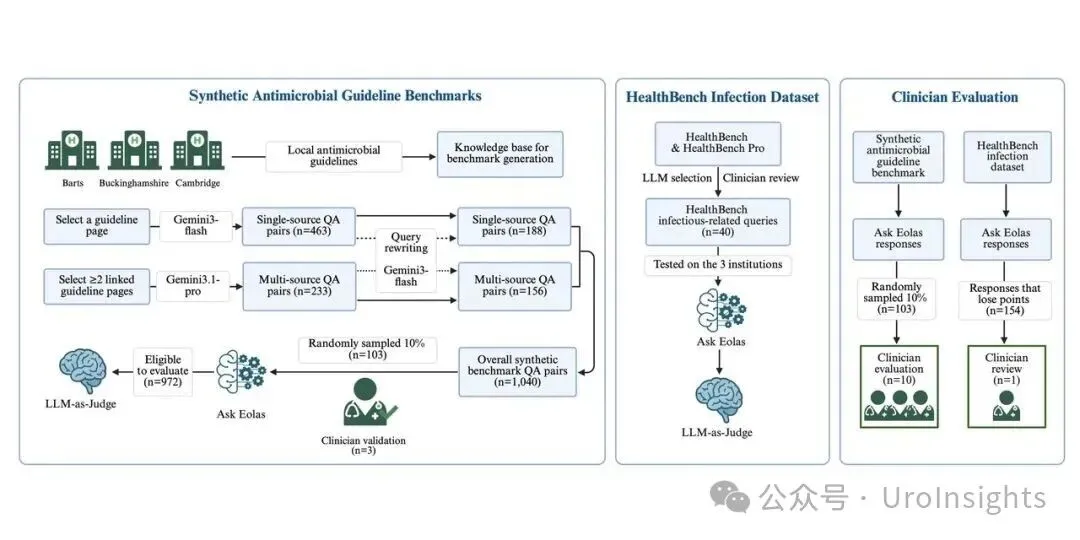
图 1研究总体工作流。Ask Eolas 接受两类评测:三家医院本地指南衍生的benchmark(单源/多源及其改写变体)与 HealthBench 公开基准;约 10% 分层抽样用于人工验证,回答由 LLM 评委与医生双轨评审。图引自原文(CC-BY 4.0),仅等比缩放、未裁剪改绘。
读这张图的重点在左侧的分层设计:单源问题模拟「快速查指南」场景,多源问题则要求工具把多页指南(如药物选择 + 过敏调整 + 剂量换算)整合成一个回答——后者才是临床真正的难点,也是本文性能崩塌发生的位置。
需要注意,benchmark 本身是 LLM 合成、仅 10% 经人工核查,作者承认剩余部分可能存在未被发现的错误,这是解读所有后续数字的前提。
因研究期间指南更新,68 个问答对被剔除,最终 972 对进入分析。单源查询上 Ask Eolas 几乎无懈可击:97.2% 的问题检索到了正确指南页,LLM 评委判定 95.8% 正确、99.4% 有据、99.1% 安全、100% 相关。但多源查询完全是另一幅图景——性能全面下滑(表 1)。
表 1 Ask Eolas 在单源与多源 benchmark 上的性能对比(LLM 评委)
依据原文 Table 1 整理,括号内 95% CI 从略。单源查询的检索命中率与召回率在数值上相等(只有一个来源);多源查询的「命中率」指至少检到一个正确来源,掩盖了召回率的崩塌——平均只召回 60.1% 的应检来源,这是正确率跌至 23.3% 的直接原因。
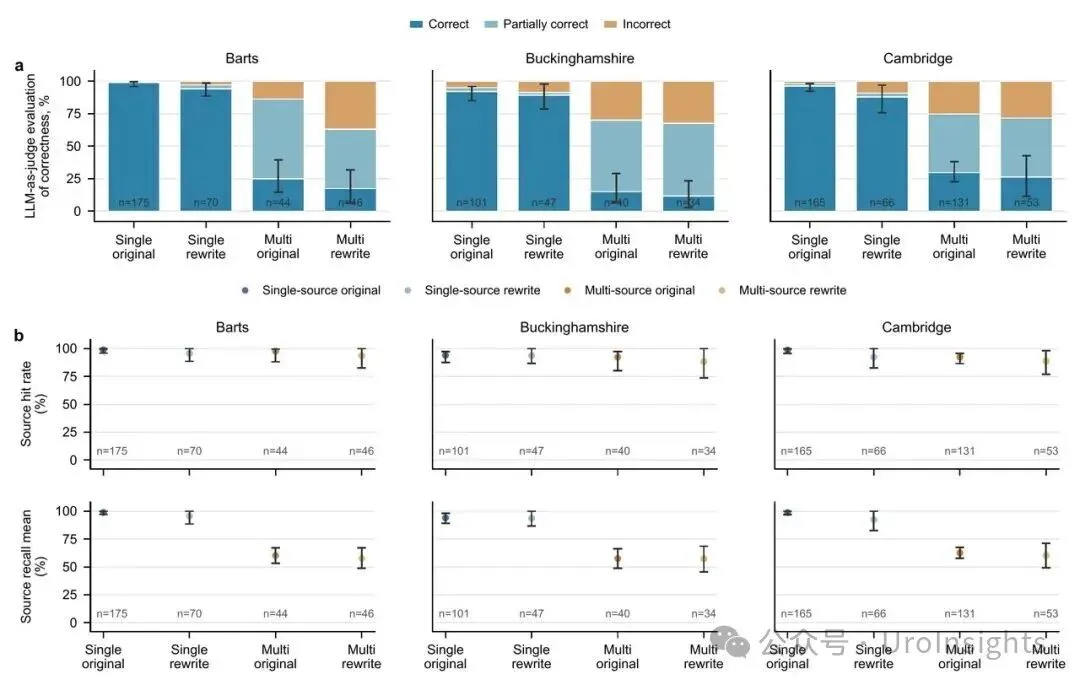
图 2Ask Eolas 在本地抗菌药 benchmark 上的表现。(a) 各 benchmark 类型在三家医院的正确率;(b) 检索表现:来源命中率与来源召回率。图引自原文(CC-BY 4.0),仅等比缩放、未裁剪改绘。
(b) 是全文信息密度最高的子图:多源查询的「命中率」仍在 94% 左右,看起来不错,但召回率骤降至约 60%——也就是说,工具几乎总能找到「一部分」相关指南,却经常漏掉其余部分。对抗菌药处方这种「漏一条就错」的任务,召回率比命中率诚实得多。
三家医院的曲线形态高度一致,说明多源性能崩塌是 RAG 架构的共性问题,而非某家医院指南的特殊性。作者还报告了一个佐证:即使检索完全齐全,多源问题的正确率也只有 85.6%,仍低于单源的 95.8%,即检索之外还有推理整合的损耗。
改写稳健性方面,错别字与商品名对检索几乎无影响,但单源噪声版正确率绝对下降 6.9%(95% CI -12.7% 至 -2.0%),精简版无显著影响;多源改写版则进一步降至 18.5%。另一个值得警惕的信号是安全性:972 条回答中 25 条被 LLM 评委标记为不安全,经医生复核分级为:高致害可能 4 条、潜在致害 12 条、低风险 9 条。
医生评审呈现相同趋势但绝对水平不同:单源正确率 96%、安全率 98%(与 LLM 评委几乎一致);多源正确率 66%、安全率 77%——LLM 评委对多源回答的判错远比医生严格(23% vs 66%),两者在正确性上的 Cohen κ 仅 0.348。另一个反直觉发现是「正确 ≠ 有用」:单源回答 96% 被判正确,但只有 60% 被判临床上有用——作者将这归因于 Ask Eolas 刻意不提供剂量信息的设计(出于安全考虑),医生须自行回查指南页,增加了使用负担。
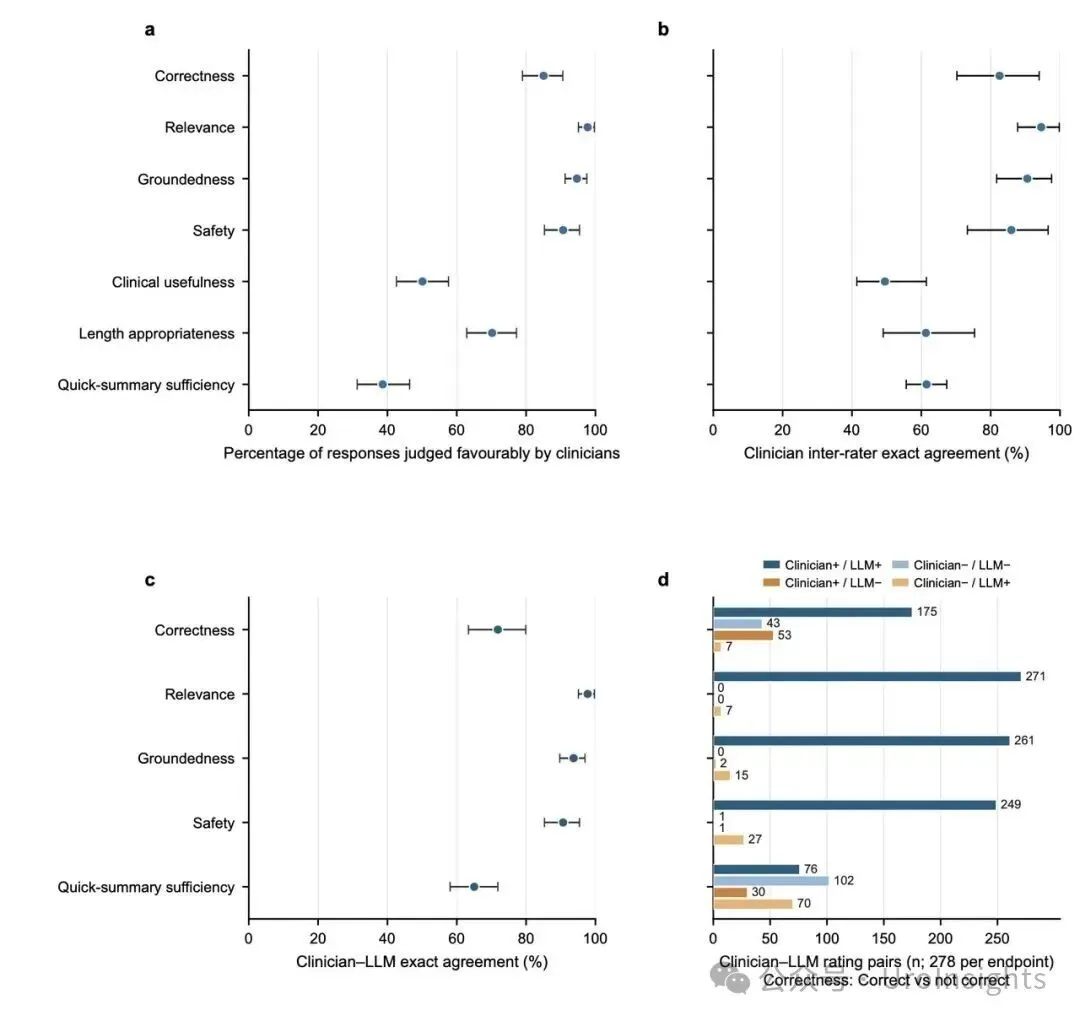
图 3医生评审结果。(a) 10 名医生对 7 个终点的达标率;(b) 医生间评分一致性;(c) 医生与 LLM 评委的逐条一致率;(d) 医生与 LLM 评分的原始配对计数。图引自原文(CC-BY 4.0),仅等比缩放、未裁剪改绘。
(a) 中「正确」与「临床有用」之间的落差最值得关注:96% vs 60%。这不是工具答错了,而是设计取舍——不给出剂量,答案对了但医生还得自己翻指南。(b) 显示医生之间的一致性本身也不高(临床有用性的精确一致率仅 49%),提示这类评价结局存在固有主观性,解读任何单一评分者(包括 LLM 评委)的数字都要留有余地。
(c)(d) 是方法学上最有价值的部分:LLM 评委与医生在相关性上98% 一致,但在正确性上只有 72%。用 LLM 评委替代人审可以省大量人力,但「评委用什么模型、评判口径多严」会直接改变结论的绝对数值——本文若只看 LLM 评委,会得出比医生评审悲观得多的结论。
HealthBench 外部验证揭示了另一个层面的问题。从 HealthBench 及 HealthBench Pro 中筛出的 40 条感染治疗问题里,18 条被 Ask Eolas 直接拒答(系统判定超出本院指南覆盖范围,医生复核确认 17 条属证据缺口)。其余回答的有据率仍有 78%–90%,但按 HealthBench 原厂评分细则的严格得分只有 31.7%–32.3%;校正「不答剂量」的系统设计与本地指南差异后升至 37.5%–39.0%。逐条分析失分原因:62% 是本地指南与 benchmark 金标准不一致所致,真正归因于工具缺陷的占 38%,包括 5% 未在信息不全时追问澄清、5% 未提示需要紧急处理。
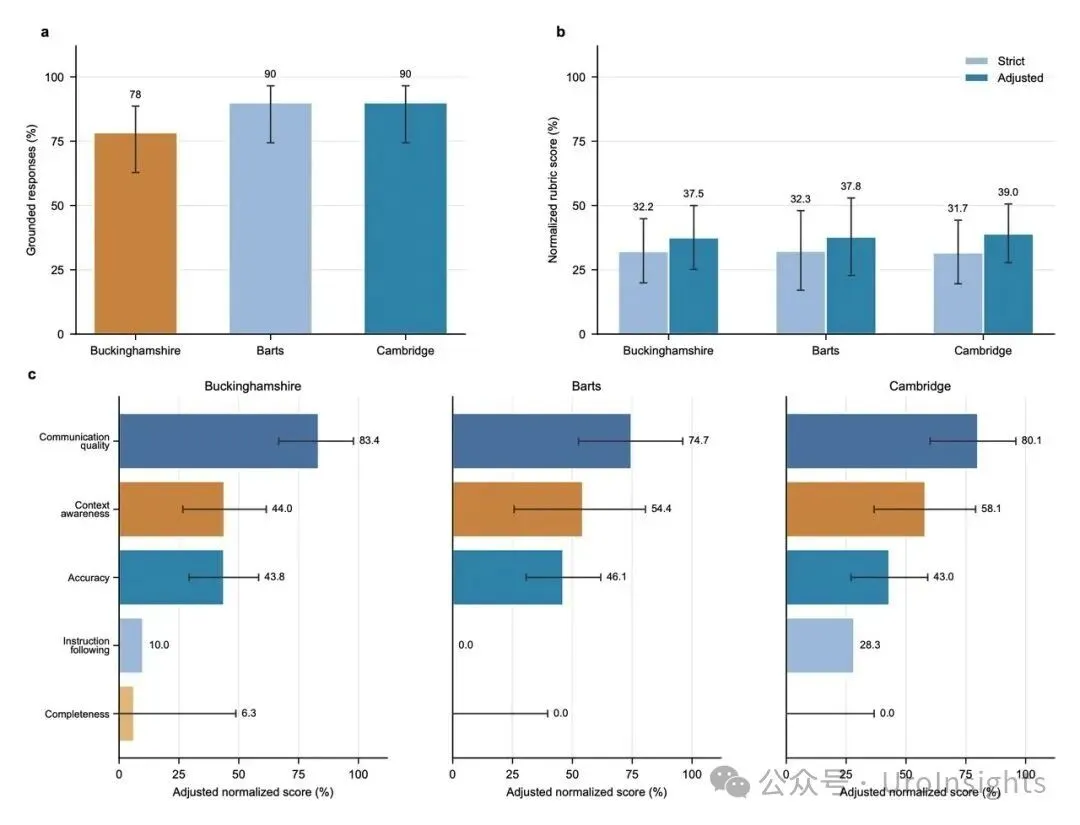
图 4HealthBench 外部验证。(a) 三家医院回答的有据率;(b) 严格得分与校正后得分;(c) 按评分维度(轴)的校正后得分。图引自原文(CC-BY 4.0),仅等比缩放、未裁剪改绘。
(b) 的读法:从严格得分到校正得分的涨幅,量化的正是「通用 benchmark 对本地化工具的系统性误罚」。沟通质量维度得分最高、完整性最低,与本地 benchmark 的多源结果互为印证。
这组图对想做模型评测的读者有直接的迁移价值:日本团队此前报告 HealthBench 有 60% 的评分细则需要按本国医疗语境改写,本文把同一结论推广到了「本地指南锚定的 RAG 系统」——不加本地化校正地套通用 benchmark,得到的低分可能主要反映语境差异而非工具性能。
合成基准 benchmark 由 LLM 合成,虽有医生参与验证,但仅 10%(103 对)经人工核查。抽查质量尚可,其余问答对中仍可能存在未被发现的错误。
验证样本 HealthBench 外部验证仅纳入 40 条感染治疗相关条目(Ask Eolas 设计为回答治疗问题),样本量有限,且其中 18 条被系统拒答,实际进入评分的更少。
评审口径 医生只评审了 benchmark 的子集,且与 LLM 评委在逐条水平上的一致性不完全(正确性 Cohen κ=0.348);尽管总体趋势一致,绝对数值会因评审者不同而明显移动——多源正确率 LLM 评委判 23%、医生判 66%,引用数字时必须说明是谁评的。
作者明确提出三个方向:① 为 AI 建议工具建立性能标准与评测基准,且基准需针对具体本地语境定制——通用 benchmark 与本地化 benchmark 应并用;② 针对复杂场景的性能短板,可行的工程路径包括识别复杂问题并标记转人工,或引入反思式、图检索式的高级 RAG 架构(多步检索);③ 开展真实世界实施研究,检验这类工具能否真正节省时间、改善处方行为与患者结局,而不只是在 benchmark 上拿分。
对泌尿读者,这篇文章的落点比表面看起来更近:泌尿系感染是抗菌药处方最高频的场景之一,而「指南锚定 AI 助手」正是国内多家医院正在试点的形态。本文给出两个可直接带走的经验——评估自家工具时,多源复杂查询才是真正的试金石(单源 96% 的正确率说明不了任何问题);以及上线前先用本地指南重建 benchmark,直接套用公开基准得出的低分,可能惩罚的恰恰是本地化这一优点。
原文出处
Cui H, Pradhan A, Hammond R, Cokljat M, Johnstone K, Luk A, et al. Benchmarking 'Ask Eolas'-a medical AI tool for antimicrobial advice available in UK hospitals. medRxiv. 2026. doi:10.64898/2026.10.22.26366212