ARTICLE · 1294213
从识字到读文档: 三款OCR模型带来了什么新变化?
一、从文字识别到智能文档解析
在日常学习和办公中,我们经常需要处理PDF课件、电子教材、学术论文、扫描文件以及各种图片资料。但这些文件中的文字并不总能直接复制、编辑和检索,复杂表格、数学公式和特殊排版更增加了信息提取的难度。解决这类问题的一项基础技术,就是OCR(Optical Character Recognition,光学字符识别)。传统OCR主要完成文字检测与识别:先确定图片中的文字位置,再将其转换为可编辑文本。Tesseract是具有代表性的传统OCR工具。随着深度学习的发展,CRNN、TrOCR等模型不断提升识别效果,PaddleOCR等开源工具也逐渐广泛应用。
不过,识别文字并不等于理解文档。一篇学术论文可能同时包含双栏正文、数学公式、表格和图片。仅提取文字还不够,还需要恢复正确的阅读顺序和各类内容之间的结构关系。
近年来,视觉语言模型(VLM)的发展推动OCR从文字识别走向文档解析与理解。新一代模型不仅能够识别文字,还可以将复杂PDF转换为保留标题、段落、公式和表格结构的Markdown文档,甚至直接完成信息抽取等任务。
进入2026年,这一趋势进一步延伸到三个方向:超长文档处理、复杂结构解析和多模态文档理解。
Unlimited OCR 2、OXR-1.0和OvisOCR3,正是近期具有代表性的三个模型。
二、Unlimited OCR 2:让OCR能够持续处理超长文档
对于几十页的普通PDF,现有OCR工具通常已经能够完成基本解析。但当文档扩展到数百页甚至数千页时,计算和内存开销会显著增加,跨页表格、连续章节等信息也更难保持完整。
2026年10月27日,百度发布并开源了文心 Unlimited OCR 2,重点探索超长文档的高效连续解析。通常,大模型在生成内容时,需要参考此前处理过的信息。如果始终保留全部历史内容,随着文档长度增长,计算和缓存负担也会不断增加。
Unlimited OCR 2采用更有针对性的处理方式:主要关注当前解析内容,有选择地保留历史参考信息,并释放不再需要的缓存,从而控制长文档处理的资源开销。根据研究团队公开的实验结果,在特定百页级文档测试中,这一机制能够将峰值KV缓存从47GB降低至约1.77GB,并实现约7倍的单步解码加速。
Unlimited OCR 2还展示了处理数千页文档的能力,但能够持续处理超长文档,并不意味着每一页都能保证完全正确。
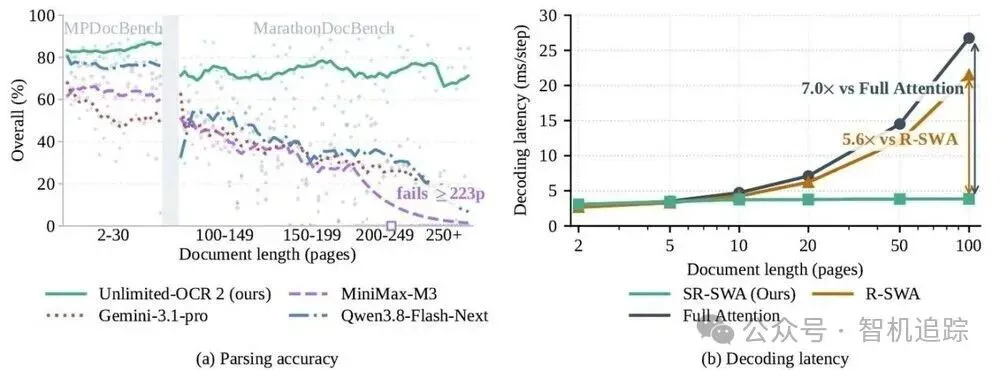
图1|Unlimited OCR 2 的长文档处理表现。左图比较不同文档长度下的综合解析得分,右图展示单步解码耗时;绿色曲线对应本文介绍的方法。结果来自作者的特定测试设置。 图片来源:百度 Unlimited OCR 2 技术报告。
它的重要突破,是让OCR从传统的逐页解析,进一步走向资源开销可控的长文档连续处理。对于电子教材、长篇研究报告、历史档案和大型扫描资料,这一方向具有直接的应用价值。
三、OXR-1.0:复杂文档解析不只是识别文字
如果说Unlimited OCR 2重点关注文档长度,那么OXR-1.0更关注文档内容与结构的准确恢复。
2026年10月,SoMark团队发布了拥有约13亿参数的OXR-1.0。其名称来自Optical Everything Recognition,体现了从文字识别向文档多种元素识别扩展的思路。
实际文档的结构可能非常复杂:学术论文包含双栏正文、数学公式和参考文献;财务报表包含大量合并单元格;化学、生物等专业资料还会出现特殊符号与结构图。
对于这些内容,识别文字只是第一步,更重要的是恢复原始文档的组织方式。
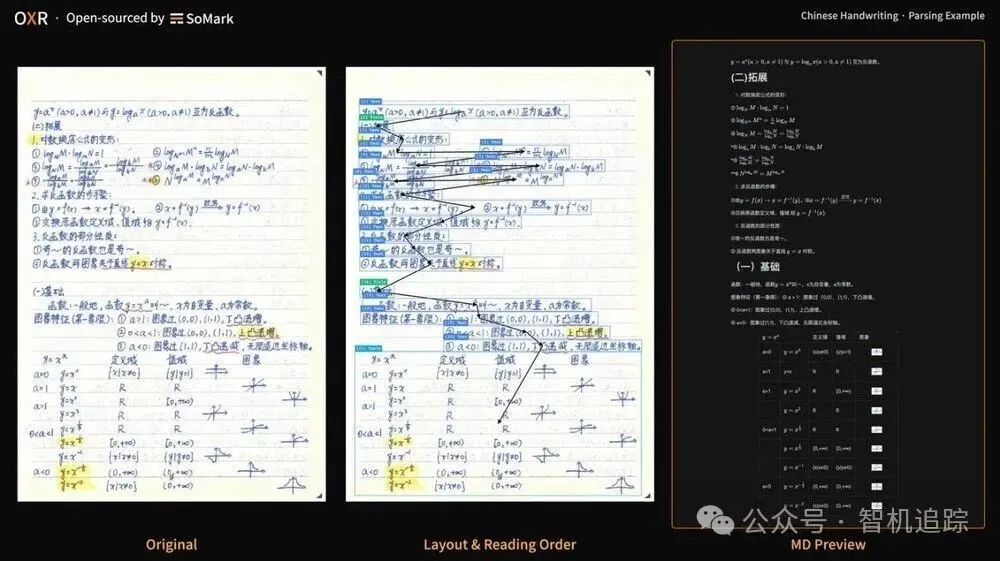
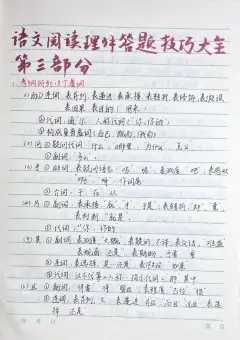
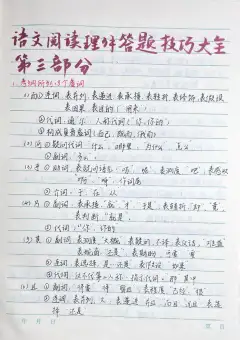
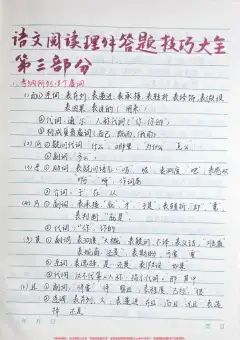
图2|OXR 对中文手写笔记的解析效果。左侧是含公式和表格的原始笔记,中间标出识别区域与阅读顺序,右侧是整理后的结果。可对照查看手写文字、公式和表格的恢复情况。 图片来源:SoMarkAI OXR 官方项目,中文手写示例。
OXR-1.0将版面分析与内容识别相结合,并提供可替换的版面分析模块,方便针对不同类型的文档调整处理流程。
此外,OXR引入了递归自我改进(Recursive Self-Improvement,RSI)训练方法,通过发现模型在困难样本上的不足,持续构建更有针对性的训练数据,改进识别与解析效果。在官方发布的评测中,OXR-1.0在OmniDocBench、olmOCR-Bench等文档解析基准上取得了具有竞争力的成绩。
OCR的目标不再只是提取文字,而是尽可能准确地恢复文档原有的信息结构。
四、OvisOCR3:从文档解析进一步走向文档理解
当文字和排版结构能够被准确识别后,自然会产生新的需求:能否直接从文档中提取关键信息、理解图表,或者重建跨页表格?
2026年10月,阿里巴巴ATH-MaaS团队开源了OvisOCR3。该模型参数规模约为8亿,却集成了文档解析、通用OCR、关键信息抽取、文档图片理解和跨页表格重建等能力。其中,关键信息抽取(KIE)是一项十分实用的功能。例如,处理会议通知、发票或实验报告时,可以指定需要提取的字段,将结果组织为JSON格式,方便后续程序直接使用。
在文档图片理解方面,OvisOCR3能够为图表、流程图等内容生成描述,部分流程图还可以转换为Mermaid等结构化表示。
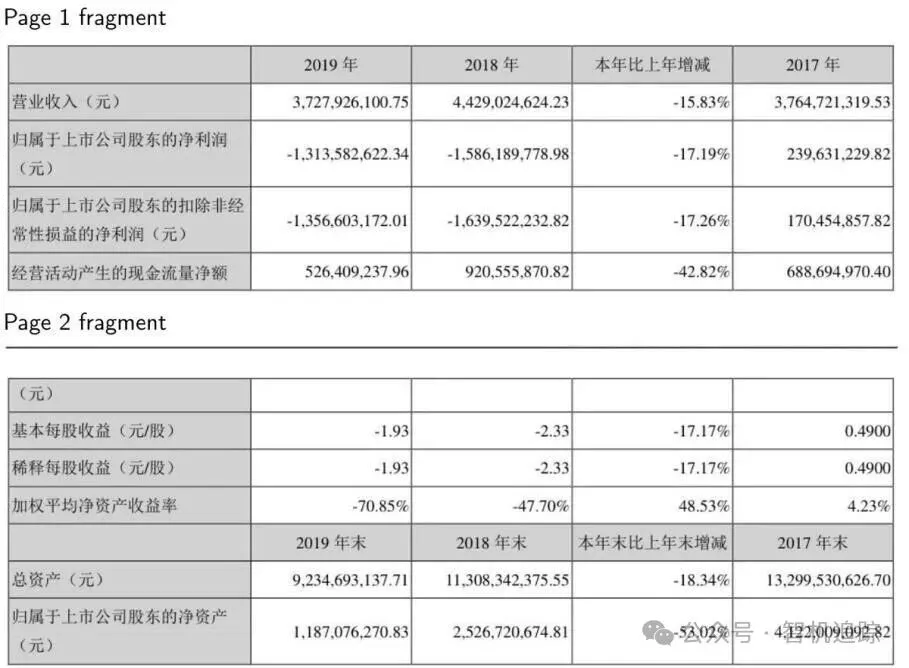
跨页表格重建则尝试判断相邻页面中的表格是否连续,并恢复完整结构。
原始跨页表格片段
OvisOCR3 重建结果
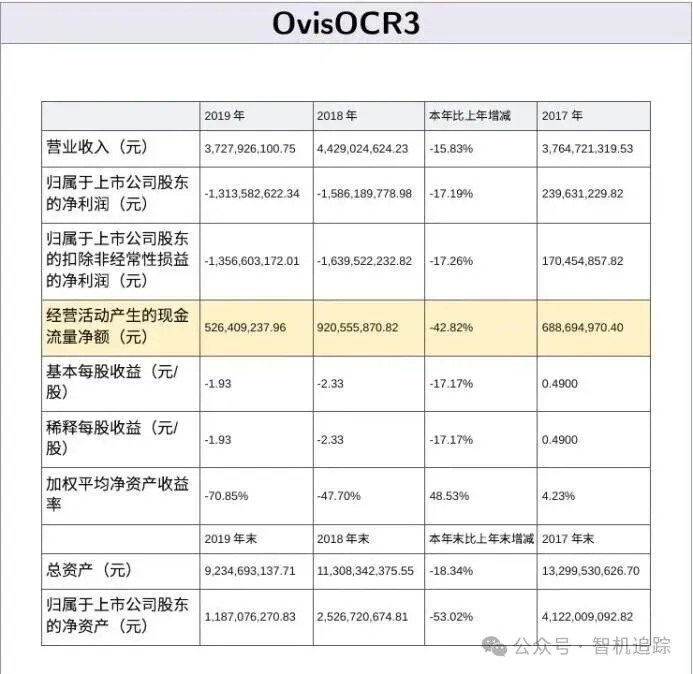
图3|OvisOCR3 的跨页表格重建效果。左侧原表的“经营活动产生的现金流量净额”与单位“元”被分页拆开;右侧结果将单位接回同一单元格,并恢复连续的表格。该图为官方报告中的具体案例。 图片来源:ATH-MaaS OvisOCR3 技术报告。
OvisOCR3的重要意义,是将文字识别、结构解析与部分文档理解任务整合到一个紧凑模型中。这也为文档知识库、智能办公和基于文档的AI助手提供了新的技术基础。
五、三个模型,体现了OCR发展的不同方向
Unlimited OCR 2、OXR-1.0和OvisOCR3虽然都属于新一代OCR技术,但各自解决的问题有所不同。
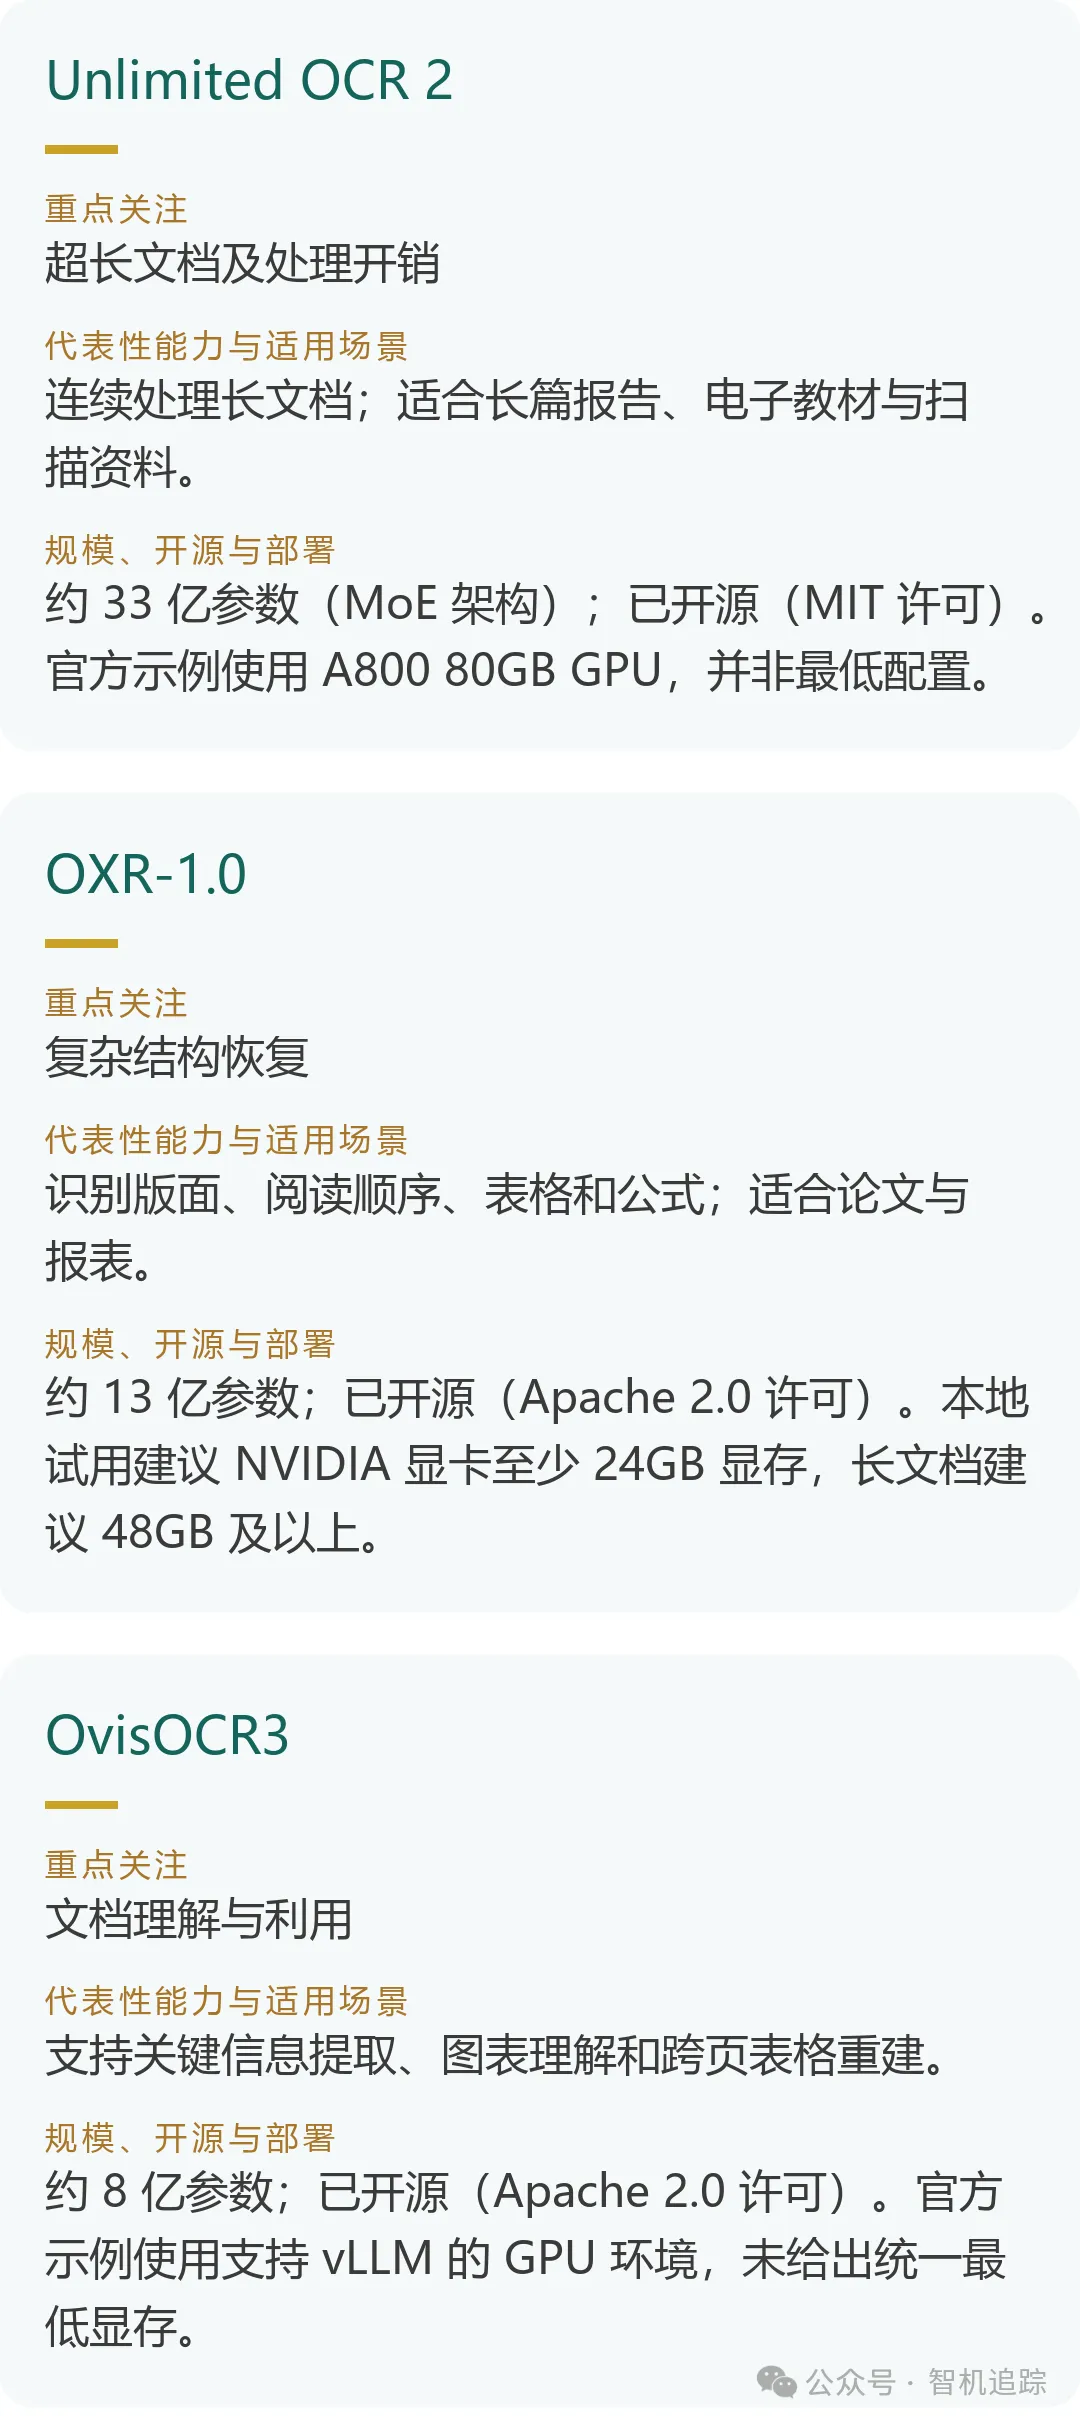
实际选择OCR工具时,应根据文档类型、识别精度、处理速度及使用成本进行综合判断。
六、OCR如何与多模态大模型和AI智能体结合?
多模态大模型可以直接读取图片或 PDF,提取文字、解释图表和回答问题,适合少量材料或需要结合画面理解的任务。面对大量扫描页、复杂表格和公式时,专用 OCR 往往更适合承担批量识别与结构化解析;具体效果仍要结合文档和工具测试。
AI 智能体可以根据任务调用工具并组织流程:OCR 负责识别文字和结构,大模型负责分析、总结与问答。遇到复杂图表或模糊公式时,还可以让多模态模型查看原图或局部截图。
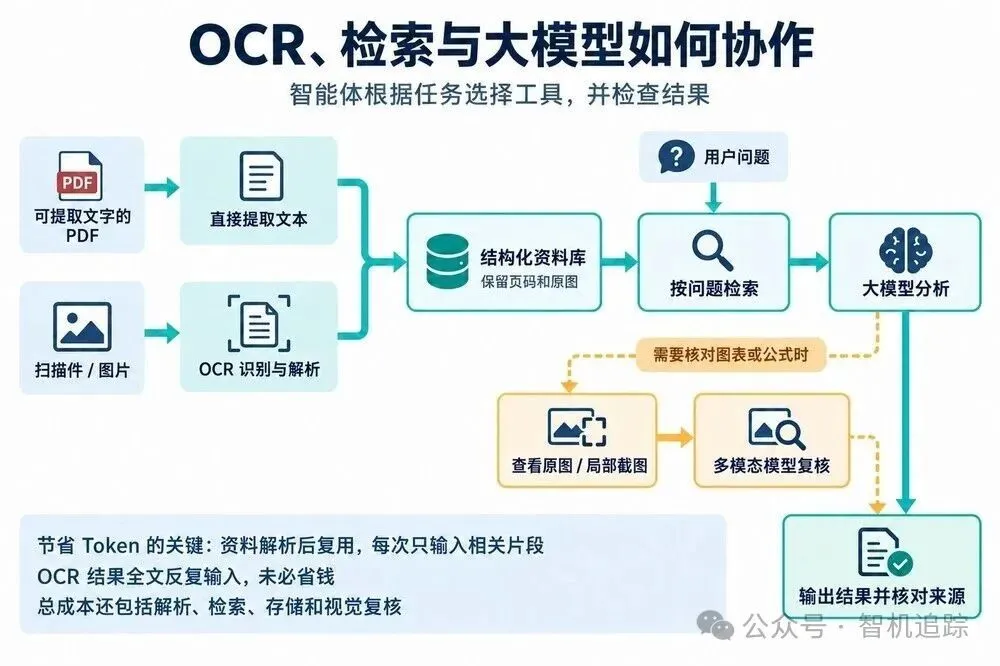
图4|OCR、检索与大模型的协作方式。解析后的资料可以复用,提问时按需检索;图表和公式可返回原图复核。是否节省总成本,还取决于调用次数、解析费用和模型计费方式。
Token 是大模型处理信息的计量单位,文字和图片输入都可能产生消耗。对于需要反复查询的长文档,可以先解析并建立可检索的资料库,提问时只向模型提供相关片段;这种“先解析、再检索、按需分析”的方法是检索增强生成(RAG)的常见思路。
节省并非必然:如果每次仍将全文发送给模型,文本 Token 也可能很多;OCR、检索、存储和原图复核同样可能产生费用。可优先直接提取可复制的 PDF 文字,对扫描件使用 OCR,再按需检索和调用视觉能力;实际成本取决于调用次数、文档内容及服务计费方式。
对于日常图片识字,可以使用手机自带的文字识别功能或PaddleOCR;对于复杂PDF解析,可以尝试OXR提供的在线演示或免费API;对于超长文档和多任务文档理解,则可以关注Unlimited OCR 2和OvisOCR3的官方项目。
最后还需要注意,OCR与大模型都可能出现识别错误或生成不符合原文的信息。数学公式、实验数据、财务金额等重要内容应对照原始文档核查;包含个人隐私或未公开资料的文件,也应谨慎上传到第三方平台。