ARTICLE · 1306467
AI主刀、医生当助手?《Nature Communications》验证"反向人机关系":7B小模型罕见病诊断超o3-mini,NEJM疑难病例胜过人类医生
NATURE COMMUNICATIONS · 2026 / 反向人机关系 × 全流程诊断智能体
| 36.23%罕见病诊断准确率 | 7B小参数量级 | 3 次每例医生被请次数 |
RESEARCH OVERVIEW / 研究速览
本次分享的文献由Shicheng Xu、Liang Pang、Huawei Shen、Xueqi Cheng等研究者合作完成,2026年4月23日在《Nature Communications》(Open Access)发表,研究通过北京大学第三医院伦理审查,并在一家三级甲等医院的真实住院病例上做了双盲评估。团队提出的系统名为DxDirector-7B——一个只有70亿参数的诊断智能体,它要验证的是一个听起来颇为"冒犯"的命题:把AI和医生的位置换过来,由AI从一句模糊的主诉出发主导整个诊断流程,医生只在必要环节被请出来配合。结果是在罕见病基准上,这个7B模型的诊断准确率达到36.23%,超过o3-mini的32.96%;在NEJM临床病理病例上拿到38.4%,高于人类医生组的32.5%;真实住院病例的9个科室双盲评估中,心血管内科的"替代率"达到75%。论文还配了一套误诊问责框架——出了错,能追溯是AI的判断问题还是医生输入的问题。
| 01 | RESEARCH / PART 01研究背景和目的 |
过去几年医疗AI的主流形态是"助手":医生带着具体问题来问,AI答完即止。这个定位有个天然的局限——它默认流程的主导者是医生。但真实的诊断不是问答,它始于一句模糊的主诉("肚子不舒服""最近总头晕"),医生要决定先问什么、查什么、化验什么、排除什么,每一步的选择都会改变后面的走向。助手式的AI答得出"什么病可能引起腹痛",却不会主动决定"下一步给这位患者做什么检查"。
让AI驱动全流程,卡点有两个。其一是能力:流程中的每一步都可能出错,误差会沿链条放大。其二是责任:AI主导的诊疗一旦误诊,算谁的?现有系统既没有给AI立规矩,也没有给医生留证据,出了事无从追溯。这也是监管和临床对"AI自主诊断"始终持保留态度的核心原因。
研究团队的目的因此是同时回答这两个问题:造一个能在"继续推理"和"请求医生"之间自主切换的诊断智能体,让医生介入越少越好、介入的每一步都真正必要;同时给整个流程装上问责机制——每一步都区分AI判断与医生输入、附上文献依据,误诊可以逐步溯源。他们把这称为"反向人机关系":AI是主任医生,医生是会诊专家。
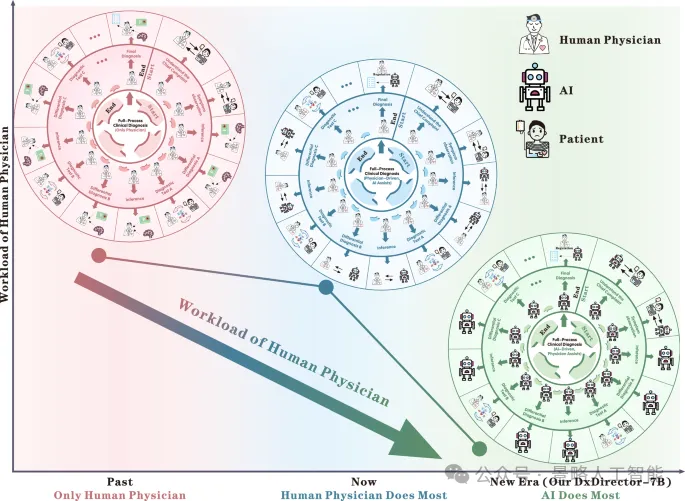
图 1:诊断工作流的三个时代——从医生独自跑全程,到DxDirector-7B的"AI主导"新范式,医生工作量沿箭头方向持续下降(图源:论文原文,Nature Communications)
| 02 | RESEARCH / PART 02数据和方法 |
三阶段训练 / TRAINING PIPELINE
依据原文研究设计整理
模型与训练:
| 1 |
| 2 |
| 3 |
慢思考与问责机制:
| 1 |
| 2 |
| 3 |
| 03 | RESEARCH / PART 03实验结果 |
罕见病是最难的试金石。在RareArena的22,901例确诊罕见病例(4597种病)上,DxDirector-7B诊断准确率36.23%,超过o3-mini(32.96%)、Deepseek-R1-671B(32.07%)、o1-preview(30.20%),更是把医学专用大模型MedFound-176B(23.98%)甩开超过12个百分点。参数量只有对手的约百分之一。
BENCHMARK SCOREBOARD / 四大基准成绩单
依据原文评测结果整理 · 全部为开放式生成评测
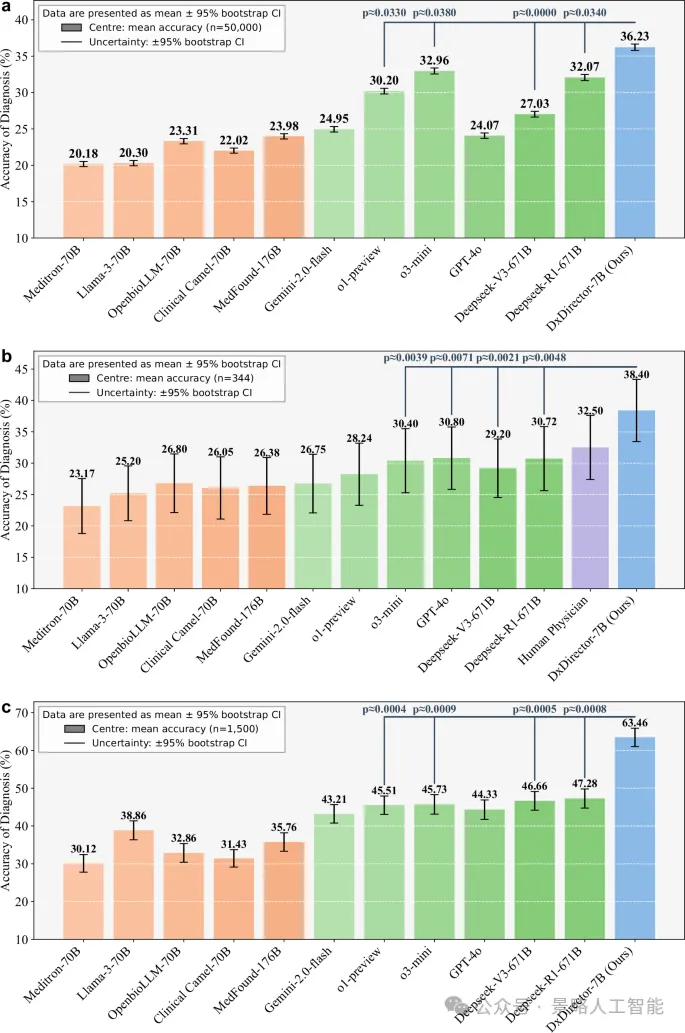
图 2:四大基准诊断准确率对比——RareArena、NEJM临床病理病例与ClinicalBench三个面板,蓝色柱为DxDirector-7B(图源:论文原文,Nature Communications)
真实世界的检验放在一家三级甲等医院:160例住院病例、9个科室、双盲设计,由第三方模型评分并由医生抽检10%复核(评分者一致性Kendall's τ=0.83)。DxDirector-7B在全部9个科室与专科医生的诊疗方案对齐度最高;平均每例只需约3次临床操作——商用LLM需要4到8次,医学适配开源模型接近10次——而它请求的操作中97%到98%对诊断真正有用。换句话说,它极少开口要医生帮忙,一开口几乎都不是废话。分科室看"替代率":心血管内科75.0%,感染、消化、疼痛管理、呼吸、内分泌在60%到66.7%之间,皮肤科和普外科低于50%。
DEPARTMENT REPLACEMENT / 真实病房分科室"替代率"
160例住院病例 · 9科室 · 双盲设计 · 依据原文整理
基准测试的科室细分也值得看。ClinicalBench的17个科室里它在14个领先,神经外科领先幅度高达40.0%,肿瘤+30.93%,呼吸+28.72%;RareArena的19个科室里16个领先,血液病+14.84%、骨科+13.64%。也有输的科目——泌尿科和肾内科败给了Deepseek-V3-671B,说明在少数高度依赖专科经验的领域,大参数模型仍有优势。
问责框架的测试同样有说服力:面对被人为注入错误的1500例病例,基线LLM倾向于把责任推给医生(归因医生的召回率约80%但精确率只有60%出头),DxDirector-7B的精确率和召回率最为均衡——谁错的就是谁错的。
| 04 | RESEARCH / PART 04研究结论与讨论 |
这项研究证明了两件事。其一,驱动全流程诊断的能力并不被参数量垄断:一个7B模型靠着"正确性÷打扰次数"的奖励设计和步级慢思考,在四个基准和真实病房里同时越过了百亿、千亿级对手——范式和训练目标比堆参数更关键。其二,"AI主导、医生辅助"在技术上已经可以运转,且伴随问责机制时,误诊追溯第一次变得可操作。
边界同样清楚。体格检查、化验取样仍必须由医生完成,系统只是学会了把这类请求压到最少;皮肤科和普外科的替代率低于50%,提示高度依赖视觉与操作的科室还不能交给它;真实评测来自单一顶级三甲医院,存在选择偏差;作者也承认,在基础科学知识整合上它仍弱于Deepseek-R1,患者沟通不如GPT-4o。
把它与本号之前分享的两篇连起来看,医疗AI的演进线索更加完整:AMIE与MIRA证明了AI能与医生打平手,Nature Medicine的基准对比证明了通用底座的答题能力全面越线,而DxDirector把终点又向前推了一格——流程的主导权开始易手。接下来的关键变量已经不是模型能力,而是问责制度、监管框架和医院愿意把多大的决策权交给一个可追溯但不完美的系统。医生的角色会从"流程的执行者"逐步转向"流程的例外处理者",这个转变在心血管内科已经跑完了七成半的路。对每天埋在门诊和病历里的临床医生来说,这不是一个远期的预言:当AI开始决定"下一步查什么",医生的价值将越来越多地体现在那3次被请出场的操作、以及系统答不上来的皮肤科和普外科病例上。
EDITOR'S NOTE / 延伸思考
当流程主导权开始从医生手里移向AI,真正的竞争变成了问责机制与信任建设——7B模型都能跑通流程,剩下的问题是我们敢不敢签字放行。
— NATURE COMMUNICATIONS —
研读前沿研究 · 关注方法与证据