ARTICLE · 1308339
NVIDIA开源AI集群故障归因工具:从一串报错找出可能的源头
Attribution把单次训练任务的日志、指标和调度状态串成诊断线索;它能缩小排查范围,但不能代替监控或硬件检测。
NVIDIA 11月2日宣布开源 Attribution。它面向运行大型GPU集群的基础设施团队,将一次AI工作负载中的日志、指标和调度事件按时间与节点关联,输出故障类别、疑似节点、症状链和证据。它解决的是“报错很多,先查哪里”的排障问题;部署仍需要现有遥测系统、受支持的调度器与工程人员判断。
为什么一次训练失败,会留下成百上千条报错?
大型AI训练通常把一个任务分到许多GPU和服务器上并行执行。某个节点的硬件或网络先出问题,其他节点随后可能报通信超时,调度器又记录任务退出。工程师看到的往往是许多“后续症状”,未必就是最早发生的故障。NVIDIA在官方说明中举例:一个节点的GPU互联错误之后,多个训练进程都可能出现NCCL通信报错。
如果只按报错数量排序,最吵的那条不一定是根因;如果逐台机器翻日志,排查会被大量重复信息拖慢。Attribution试图把同一工作负载的一次运行作为分析边界,将应用日志、系统日志、GPU驱动与网络信息、指标和调度器状态放回一条时间线里。
它怎样把“症状”缩成一条诊断?
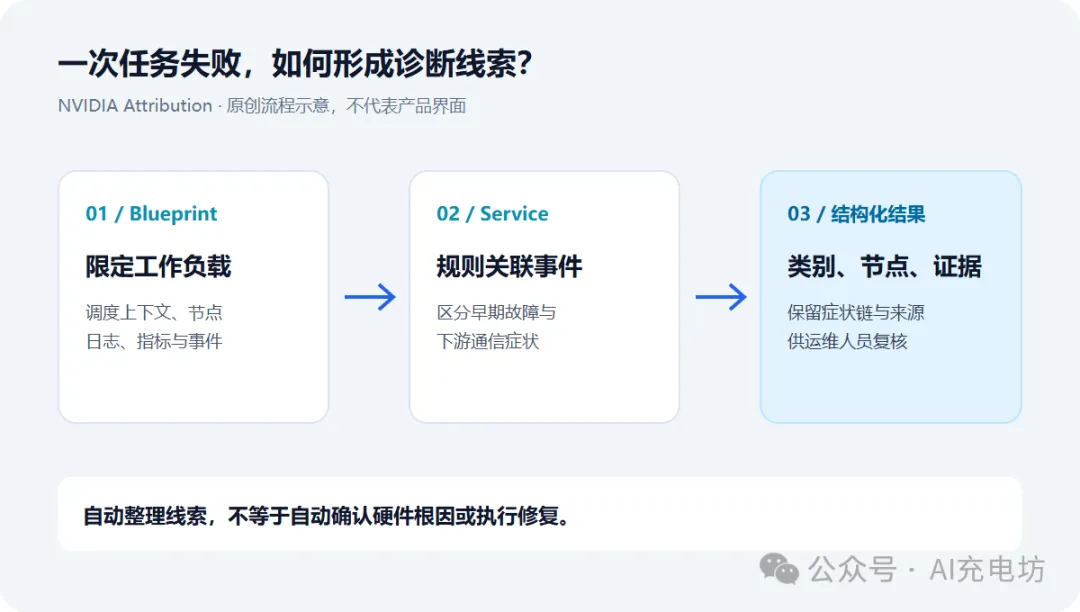
系统分成两个部分。Attribution Blueprint负责根据调度器或指定时间范围确定任务涉及的节点,调用日志和指标连接器收集证据,再把整理后的观察结果交给 Attribution Service。Service运行归因规则并返回结构化结果,包含任务是否失败、归属类别、相关节点、支持判断的症状,以及证据来自哪里。
NVIDIA博客展示了一个合成案例:三个节点的应用日志出现NCCL错误,其中一个节点的系统日志还出现XID 149。规则把该XID对应的NVLink信号完整性问题识别为较可能的源头,同时保留其他节点上的NCCL错误作为后续症状。这个示例说明了工具想做的事:把“哪里看见报错”和“什么事件可能先触发故障”区分开。它是规则系统对给定样例的处理结果,不代表每次真实故障都能得到同样确定的结论。
这次开源,团队能拿它做什么?
公开仓库采用Apache 2.0许可,提供服务端和Blueprint参考编排器。Blueprint包含面向Slurm、Kueue和静态输入的执行上下文连接器,也提供Loki、本地文件、Kubernetes Pod日志和PromQL指标等连接方式,以及stdout和SQLite输出。团队可以先用仓库样例跑通流程,再按自己的集群调度、日志和指标系统增加连接器或规则。
NVIDIA称,这套归因系统已在其AI基础设施中运行多年,每周分析数百万个工作负载,覆盖数十万块GPU;公司还描述了一个RDMA集群案例,归因结果帮助运维人员把网络错误集中到特定主机端口和交换机端口附近。以上规模和效果来自厂商自己的说明,公开材料没有给出独立评测,也不能据此推断其他团队部署后会得到相同收益。
它不是“一键修好GPU”的按钮
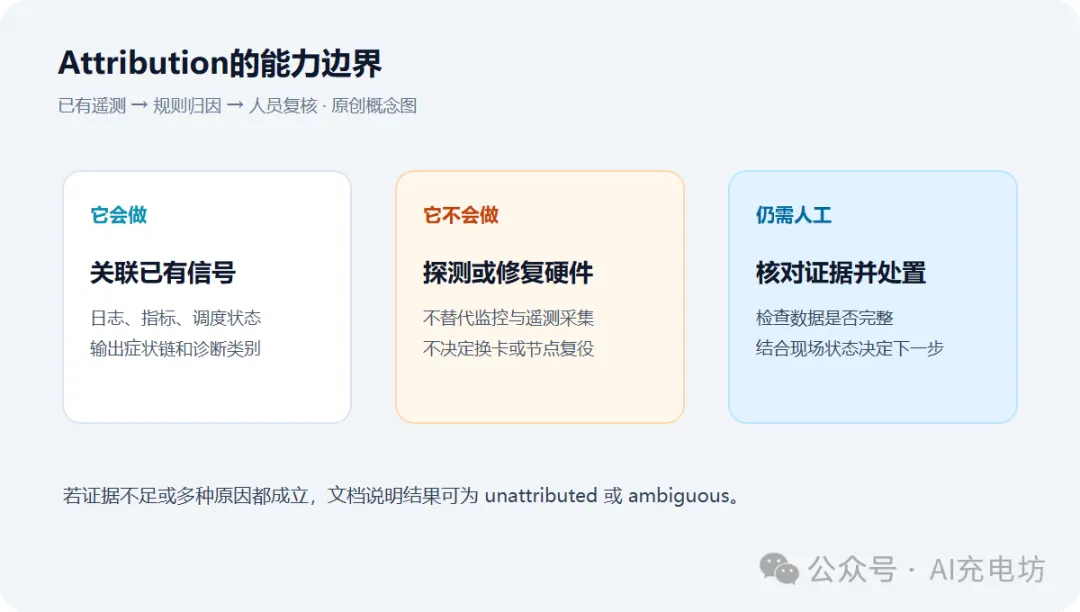
Attribution读取的是已有日志和指标并做关联,不会主动探测硬件,不会替代Prometheus等监控,也不会自动决定一块GPU该不该下线或更换。系统给出的是规则支持的诊断线索,后续仍需运维人员查看原始证据、判断现场状态,再决定是否检查网络、驱动或硬件。
结果质量也取决于数据是否完整。官方文档说明,如果多个原因都符合,输出可以标成“ambiguous”;证据不够时会标成“unattributed”。这类边界很重要:日志关联适合帮助缩小排查范围,不等同于经过物理检测确认的根因。若某个采集器没有权限、日志时间不一致或调度数据已过期,症状链也可能缺少关键一环。
开源可用,不代表所有集群即装即用
公开文档列出的条件包括Slurm 25.11及以上,或特定版本的Kueue与JobSet;Blueprint要能访问日志/指标后端,并通过HTTP连接Service。Service要求Python 3.14系列,Blueprint要求Python 3.11及以上,快速体验还需要uv与Docker。支持列表包括A100、H100、L40S、B200、GB200和GB300,其中GB200、GB300的规则覆盖仍在完善。
NVIDIA KAI Scheduler目前尚未实现归因支持,虽然Service API可以接受相应调度器值。使用者应先对照仓库的版本和权限要求,确认自己的调度器、数据源和GPU在覆盖范围内,再从样例数据开始试跑。对于没有专门集群运维团队的普通用户,这不是可直接安装到个人电脑上的AI助手。
这件事对AI服务使用者有什么关系?
它不会改变聊天机器人或图像生成产品的操作方式,直接用户也不需要安装它。它更接近云服务后台的排障组件:如果这类工具能帮助运营团队更快定位一类反复出现的故障,理论上可能减少某些训练或推理任务中断的排查时间;但这是潜在用途,不是NVIDIA公告已经证明的普遍结果。
开源的价值在于让集群团队可以查看规则、复现样例并按实际环境扩展,也让外部开发者有机会反馈遗漏的故障模式。接下来可以观察的不是宣传中的GPU总数,而是仓库版本维护、社区贡献、规则覆盖和其他团队报告的实际部署经验。
这条新闻的事实边界
给从业者的检查项|部署前先确认调度器、GPU型号、日志/指标后端和版本要求;先用样例数据检查输出是否能追溯到原始证据,再评估接入生产集群。
后续关注|关注仓库后续版本、规则覆盖更新和独立部署反馈;NVIDIA公布的使用规模与案例属于厂商自述。