ARTICLE · 1333092
文档解析批量跑太慢?每份白等0.9秒,100份实测差了93秒
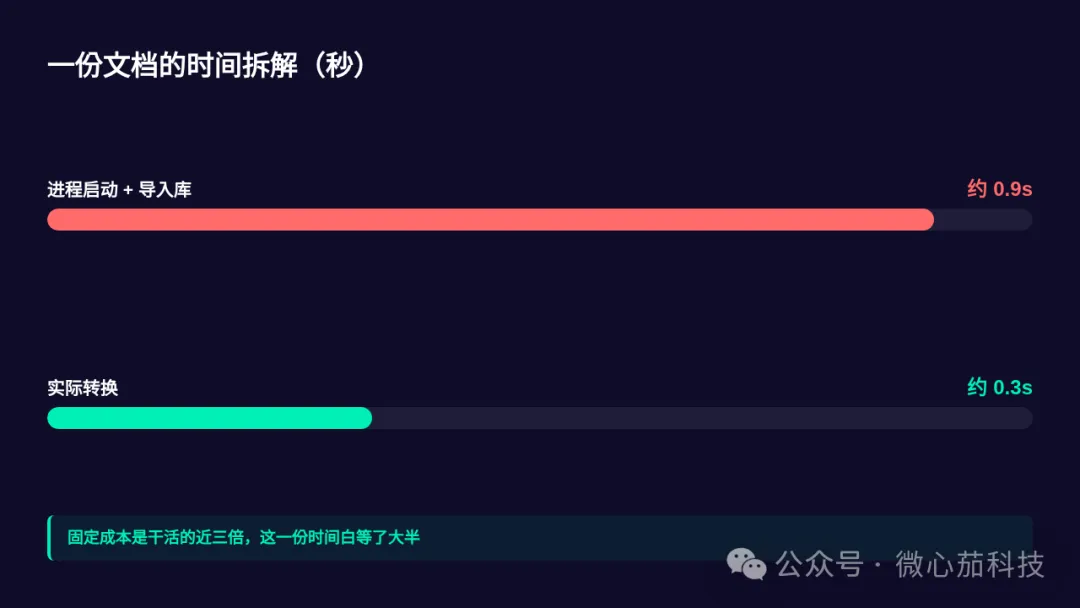
先把账算出来:60 页的 Word 合同,常驻进程里转一次 0.35 秒;每份新起一个 Python 进程去转,1.26 秒。
一份差 0.9 秒。一天几十份,看着不多。
但我第一次跑批量任务时是每份文件起一个进程,一百多份文档跑了四分多钟,而且机器风扇一直在响。我以为是自己代码写得烂,查到最后发现,时间全花在启动上。
"
这篇不聊功能,只聊一件事:同一套解析工具,进程怎么起,决定你每天白等多久。
{01}
PART
账要拆成三层才看得清
PART 1
我们做的生意里,文档是持续来的:渠道发来的对账单、客户签的合同、设备回收的报价单。我把这些归类算了一下,每天大概几十份,周末和月初月末会集中爆发。
之前我没在意“一份文件要转多久”,因为单次看都在一秒以内,感觉不出来。直到有一次月初集中对账,我把一批文件丢进去,去泡了杯咖啡,回来才转完一半。
于是我把时间拆成三层,一层一层测。
结论摆在明面上:每份文件的固定成本,是实际工作的三倍。
{02}
PART
我测的三个场景
PART 2
同一个 60 页合同,我测了三种起法。
第一种:每份起一个新进程。
$ time python3 -c "from markitdown import MarkItDown; MarkItDown().convert('contract.docx')"
real 0m1.26s
第二种:一个进程里连续转。
$ python3 -c "
from markitdown import MarkItDown
import time
md = MarkItDown()
for i in range(3):
t = time.time(); md.convert('contract.docx'); print('%.2fs' % (time.time()-t))
"
0.35s
0.29s
0.35s
第三种:常驻服务。
我把它挂成一个本地端口,客户端 POST 文件路径上去。第二批文件开始,每份稳定在 0.3 秒到 0.35 秒之间。
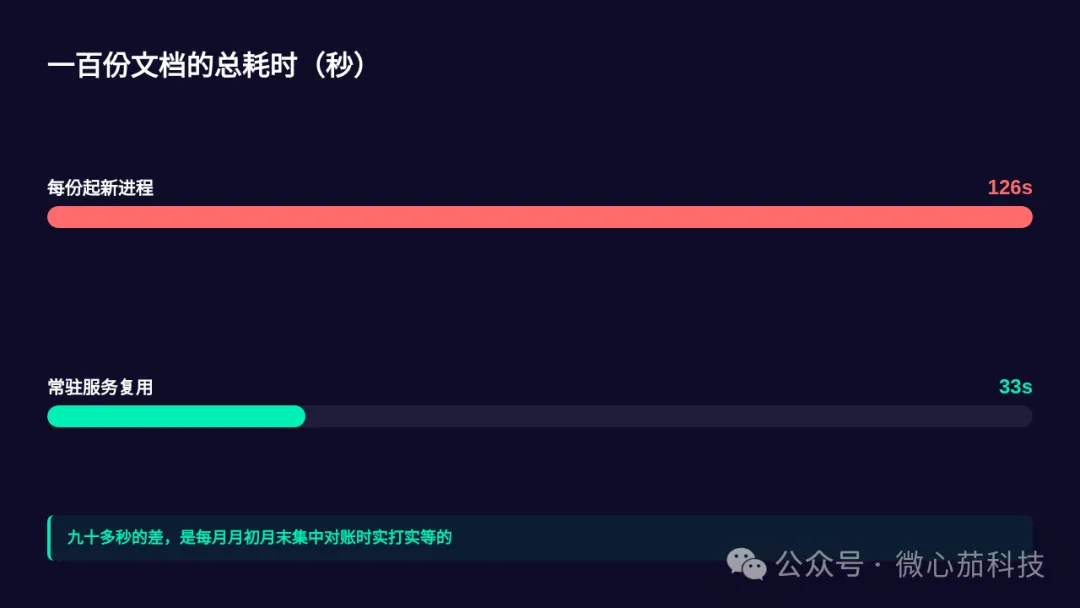
一百份文档的差距:
每份起进程:约 126 秒
常驻服务:约 33 秒
差了九十多秒。一个月里月初月末各一次集中对账,一年下来是四十多分钟,还不算我中途要盯着它别卡死。
{03}
PART
顺带发现的第二个成本
PART 3
优化进程之后我以为到顶了,结果输出内容又给我添了麻烦。
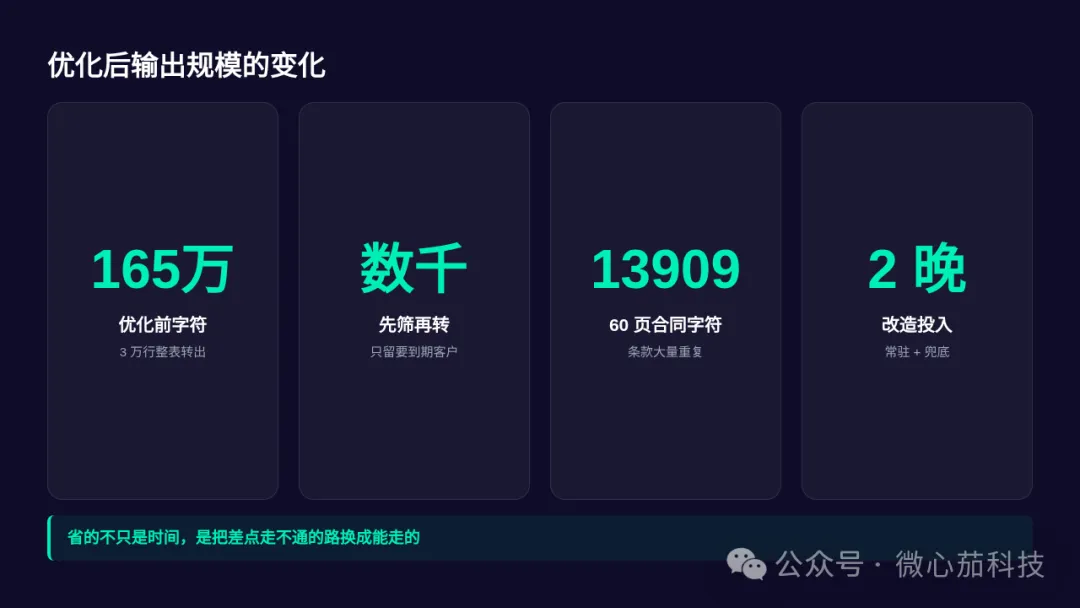
60 页合同转成文本是 13909 个字符,看着还行。但里面的条款是同质的——“甲方应在收到账单后十五个工作日内完成付款”这一句,在六十页里重复了几十次。
这种内容塞进模型做检索,等于用一个重复的句子占满上下文。我后来加了一步句级去重,只保留每一条条款的第一次出现,后面重复的折叠成一句“以下若干条款内容重复”。
对账单也类似:3 万行的客户表转成文本,是 165 万字符。真正有价值的是“哪些客户的套餐要到期了”,不是全部三万行。我现在先筛再转,输出从 165 万字符降到几千。
这一步省的不是时间,是后面差点走不通的路。
{04}
PART
我为什么没选更快的方案
PART 4
有人会问,为什么不直接用更快的解析库,甚至自己写?
我试过。对账单这种结构化数据,pandas 读进来直接算,比转成文本快得多。但合同、说明类的 Word 文档,自己写解析要处理标题层级、列表、表格、嵌套结构,我写了两天就放弃了。
所以我的选择是:结构化数据自己处理,非结构化文档交给现成工具,把省下来的力气花在“怎么起进程”这种一次性优化上。
这个取舍我不是很满意。它是妥协——我没有找到一个又通用又快的东西,只能各管一段。如果你的文档类型比较单一,自己写解析会比我这套干净。
{05}
PART
常驻之后踩的新坑
PART 5
说完好处,把常驻带来的新麻烦也说清楚,不然你照着我这套做也会撞上。
第一个:内存不回收。
常驻进程跑一天之后内存涨到接近 1G。我一开始以为是泄漏,翻了半天代码没找到问题。后来把每次转换前后的常驻内存打出来,才发现是每次转换都会临时加载一份文档结构,转完不主动释放。我加了一句显式的对象清理,涨幅就收敛了。
第二个:单次失败拖死整批。
每份起进程的时候,一份失败不影响别人;改成常驻之后,一份文件把进程搞崩,后面排队的全卡住。我第一次遇到是一份损坏的 docx,进程直接退出,队列里剩下的十几份文件全部超时。
后来我给每份文件加了独立的 try 包裹,超时单独掐,失败的那份记日志跳过。这一层保护必须加,不加就不要上常驻。
第三个:端口和重启。
常驻服务意味着它得一直在。机器重启、端口被占、进程被系统杀掉,这些事都会发生。我没有做很复杂的守护,就是一个启动脚本加一次健康检查,服务不起来时告警,不自动重试。
自动重试我是故意不做的。之前试过一次,服务启动失败后自动重试,结果一个死循环跑了二十分钟,日志刷了几百兆。宁可让我收到告警手动看一眼,也不要它自己在那边一直转。
{06}
PART
算下来值不值
PART 6
按我这边的量:一天几十份,每份省 0.9 秒,一天省半分钟左右。
单看时间,不值。 为它改代码、加常驻服务、处理重启和端口占用,前期投入的时间比省下来的多,我大概花了两个晚上。
真正值的是另外两件事:
第一,批量任务变得可预期。原来一百份文件跑四分多钟,中间我总想去看一眼;现在三十多秒,丢上去就回来收结果。
第二,不再为了省时间而偷懒。之前因为慢,我会把好几天的文档攒一起跑一次,结果出错时不好定位是哪天的文件。现在快了,随时跑,出问题当场能查到。
这笔账我的结论是:如果一天只处理几份,别优化,用最简单的方式跑就行;如果批量跑、每次几百份,把这 0.9 秒砍掉是值得的。
最后说清楚这篇给不了什么:没测精度、没比各家解析质量,那些是另一个问题;也没给出通用方案,不同工具的启动开销差很多,得自己掐表。
问个具体的:你们批量任务里,每份文件是起新进程还是进程池复用?我是踩了坑才改成常驻的,不知道有没有更省事的做法。
你们批量任务里,每份文件是起新进程还是进程池复用?我是踩了坑才改成常驻的。
THANKS FOR READING