ARTICLE · 1336737
100K 上下文够用吗?这个开源插件,想帮你省下 5 倍 token
窗口越大越好?
100K 上下文真的够用吗?
它说能省 5 倍 token
billion-context · 上下文压缩 · 20+ 编程助手
开源项目实测
📦 3 Parts + Conclusion
👉 滑动
PART 01
它解决什么问题
为什么越聊越贵
PART 02
数据有多猛
三组硬指标
PART 03
怎么上手
三条命令跑起来
PART ///
写在最后
适合谁,不适合谁
上下文不是越大越好,而是越会用越好。
写代码的 Agent 都有同一个毛病:聊得越久,越容易失忆。
每问一句,它都要把前面的历史重新读一遍;窗口一满,要么截断,要么摘要,要么干脆重开一个会话。上下文窗口,正在变成 AI 编程里最贵的工位。
今天 GitHub 日榜上,一个叫 billion-context 的项目排到第 9:今日新增 460 星,总星 5.5k。它干的事很直接——架在你的编程助手和模型 API 之间,把聊过的内容压缩、折叠、按需还原。
它喊出的口号更直接:100K 上下文就够用,一个会话能跑一个月,token 省 5 倍。
这期不吹不黑:它凭什么省、数据有多硬、怎么上手、哪里要小心。
01
PART
它解决什么问题
WHY IT MATTERS
先说痛点。
现在主流模型的窗口越来越大,1M 甚至 2M 都在路上。但窗口大不等于便宜:Agent 每一轮都要重发历史,输入 token 会随对话长度线性增长。一个跑了几天的长会话,账单可能比模型本身还吓人。
客户端自带的压缩,通常是“到点了做一次摘要”:一次性、不可逆,而且改写历史前缀会让缓存失效。结果就是窗口省了,钱没省下来,细节还丢了。
billion-context 换了个思路:不换模型、不换编辑器,只在中间加一层代理;什么时候压、压哪一段,交给模型自己判断。
不是把历史砍掉,而是把历史折叠起来。
四个工具,把上下文变成可折叠的档案
代理会向对话注入四个上下文管理工具:
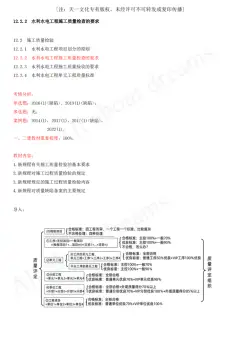
| compress | |
| decompress | |
| search_context | |
| acp_status |
模型在上下文增长时自行调用这些工具,不是硬编码的定时截断。更关键的是“增量、可逆、对前缀缓存友好”:摘要只在小范围写入,缓存前缀保持完整,所以省 token 不等于牺牲速度。
项目方给出的健康线是:缓存命中率 95–97%,压缩本身只吃掉 2% 以内。
02
PART
数据有多猛
THE NUMBERS
先看生产数据。
174,327
次模型调用
4 个半月 · 3 个宿主
187.6 亿
累计输入 token
三宿主合计约 247 亿
0
次窗口违规
204,800 token 窗口
再看第三方横评。
项目仓库里挂了一份 1,500 题 的横评,覆盖 LongMemEval-S、ContextBench、MemoryAgentBench 三个基准:
同一份评测里,全量上下文在 199 道题上全部爆窗。
但先别急着“闭眼冲”。
!先别急着闭眼冲 🕳
这些数字来自项目方公布的评测,测试模型、数据口径、复现条件都值得自己看一遍。项目本身也很早期:v0.1.x、5.5k 星,README 里明确写着“早期,真实模型集成测试是下一里程碑”。
所以更稳妥的结论是:值得拿一个旧项目,试三天。
03
PART
怎么上手
GET STARTED
安装
Linux / macOS 建议用用户级目录安装,不需要 sudo:
npm install -g billion-context --prefix=~/.local
Windows 直接装:
npm install -g billion-context
装完会得到一个 bili 命令。
选一种接入方式
最省事的是启动器,一条命令同时拉起代理和客户端,不改真实配置:
bili claude
bili codex
bili opencode
想更原生,可以把 bili 装成客户端插件:
bili plugin install opencode
bili plugin install dsh
bili plugin install pi
最通用的方式,是启动代理后改客户端 baseURL:
CMDbili
然后把 baseURL 前面加上 http://localhost:8787/bili/。
看它在不在干活
在客户端里输入 /acp,可以看当前会话的压缩状态;输入 /acp-cache,能看到缓存命中率和每次折叠的“经济账”。打开 http://localhost:8787,还有一个完整的网页面板。
它支持 20 多个客户端:Claude Code、Codex、OpenCode、Kimi、Gemini CLI、Qwen Code、Copilot CLI、Zed、aider 等,主流编程助手基本覆盖。
上手前,先知道这几件事
它是早期项目,v0.1.x,别直接上生产环境。
Claude Desktop 的 Code 标签页会绕过代理,终端里的 Claude Code 不受影响。
Claude 车道走自定义 baseURL 后,Remote Control 等账号绑定功能会消失。
压缩只作用于发给模型的内容,不会缩小客户端自己的会话文件。
Windows 用户建议把会话目录加进杀毒软件排除项。
许可证是 MIT 加一条附加署名条款,商用或分发前要看清楚。
///
LAST
写在最后
SUMMARY
如果你是长会话重度用户,每个月看着 token 账单心疼,又愿意折腾,billion-context 值得试。
如果你只是偶尔问几句,或者完全不想碰命令行,它大概率不是为你准备的。
窗口变大是厂商的事,把窗口用得更聪明,是开发者自己的事。
我是codeXF,热衷于分享 AI 观察与干货。
如果你觉得今天这篇有收获,欢迎 点赞、分享、推荐、关注 四连,我们下篇见。
THANKS FOR READING