ARTICLE · 1362498
Excel部分函数 用Pandas实现
会用 Excel 的人学 pandas,卡住的往往不是语法,而是思维:Excel 在改一个格子,pandas 在改一整列呢
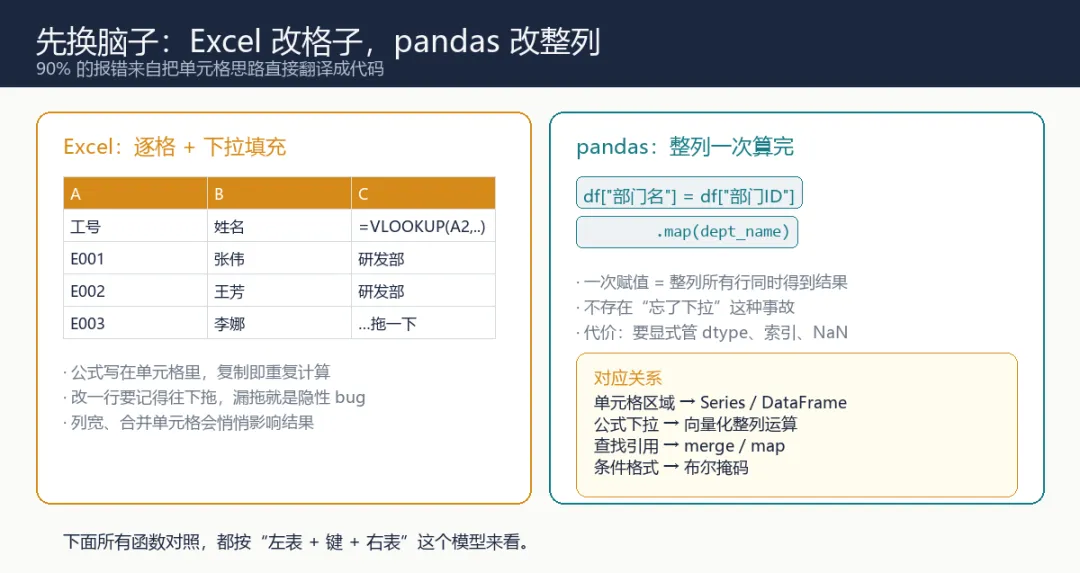
一、VLOOKUP:它其实是"左表保行数 + 按键取右表列"
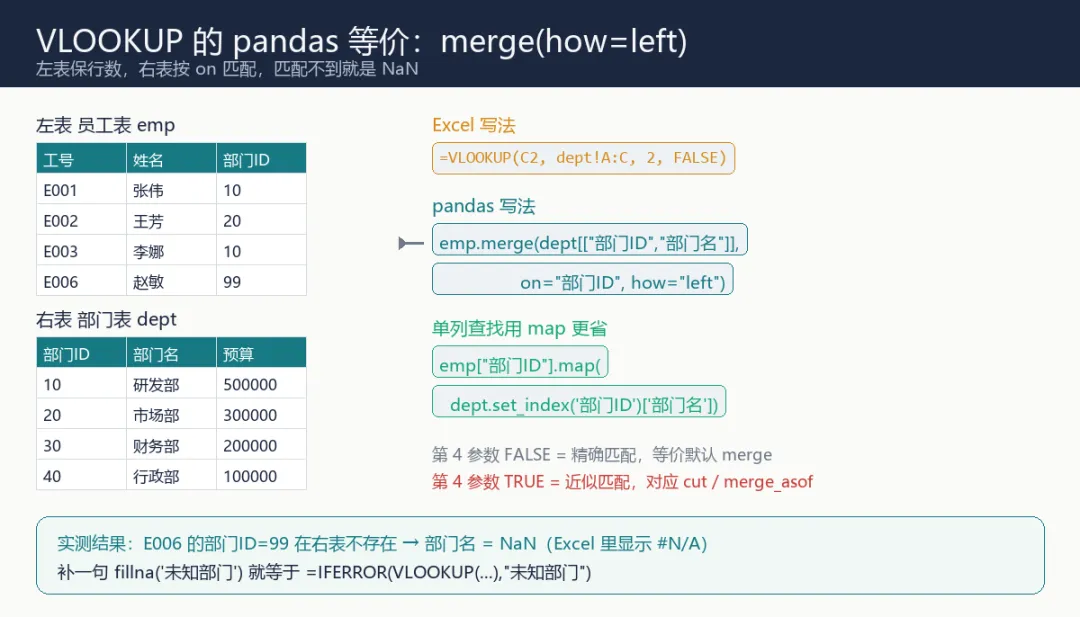
# Excel: =VLOOKUP(C2, 部门表!A:C, 2, FALSE)
emp.merge(dept[["部门ID", "部门名"]], on="部门ID", how="left")
实测输出:
  工号 姓名  部门ID 部门名
E001 张伟    10 研发部
E002 王芳    20 市场部
E003 李娜    10 研发部
E004 刘强    30 财务部
E005 陈静    20 市场部
只取一列时,map 比 merge 轻
emp["部门ID"].map(dept.set_index("部门ID")["部门名"])
# ['研发部', '市场部', '研发部', '财务部', '市场部']
map 走的是字典查找,不会因为右表键重复而改变行数,行为最接近 VLOOKUP。
#N/A 和 IFERROR
新增一条 E006 / 部门ID=99 后,右表没有 99:
  工号  部门ID 部门名
E006    99   NaN      # Excel 里这里显示 #N/A
=IFERROR(VLOOKUP(...),"未知部门") 的等价写法就是 fillna:
r["部门名"].fillna("未知部门") # [..., '市场部', '未知部门']
注意 NaN 不能用 == 比较,要用 isna()。
二、how 选错,行数立刻变
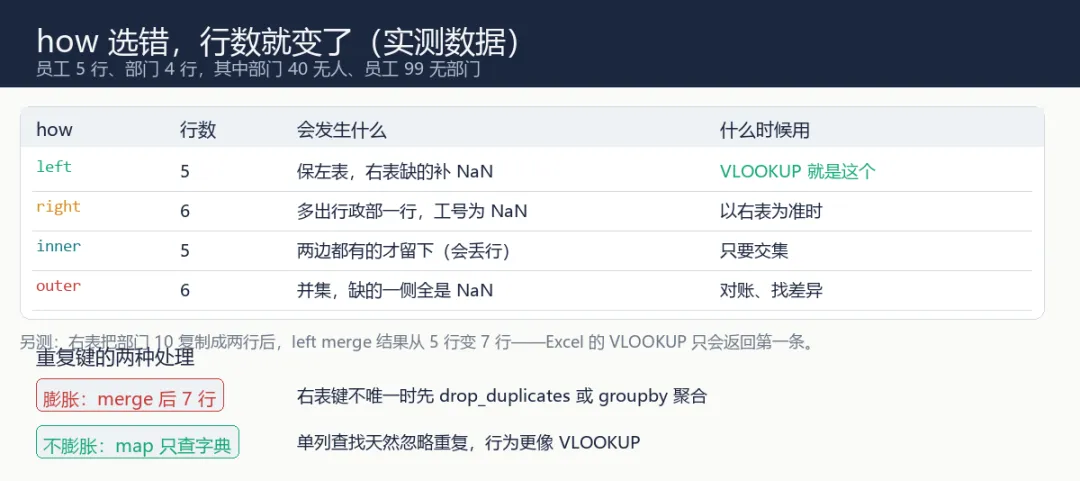
员工 5 行、部门 4 行(部门 40 无人,员工 99 无部门),实测:
left   行数=5      right  行数=6
inner  行数=5      outer  行数=6
VLOOKUP 语义只对应 left。另外把部门 10 复制一份造成重复键后:
员工 5 行 -> merge 后 7 行
Excel 的 VLOOKUP 只会返回第一条匹配,pandas 会把每一对组合都展开——这是从 Excel 转过来最容易失控的一个点。关联前先 dept["部门ID"].is_unique 看一眼。
三、查找家族完整对照
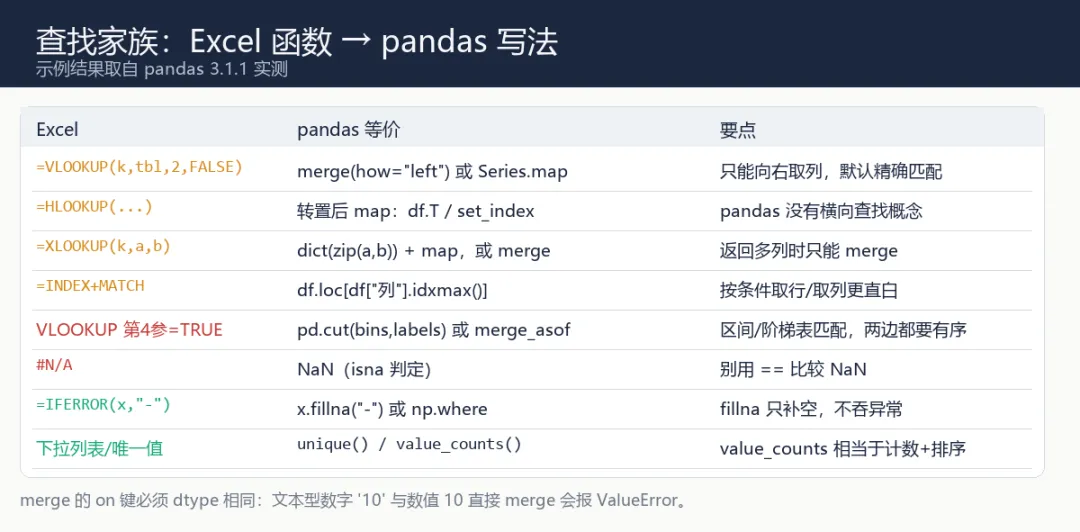
近似匹配(第 4 参数 = TRUE)
薪资分档这种阶梯表,对应 pd.cut 或 merge_asof:
emp["职级"] = pd.cut(emp["薪资"], bins=[0, 20000, 25000, 99999],
                    labels=["P5", "P6", "P7"], right=False)
姓名    薪资 职级
张伟 18000  P5
王芳 25000  P7      # right=False:[25000,99999) 归 P7
李娜 16000  P5
刘强 32000  P7
陈静 21000  P6
merge_asof 给出同样结果,但要求两张表都先按键排序——这点和 Excel 里"近似匹配必须先排序"完全一致。
四、FIND / SEARCH / LEFT / MID 这类文本函数
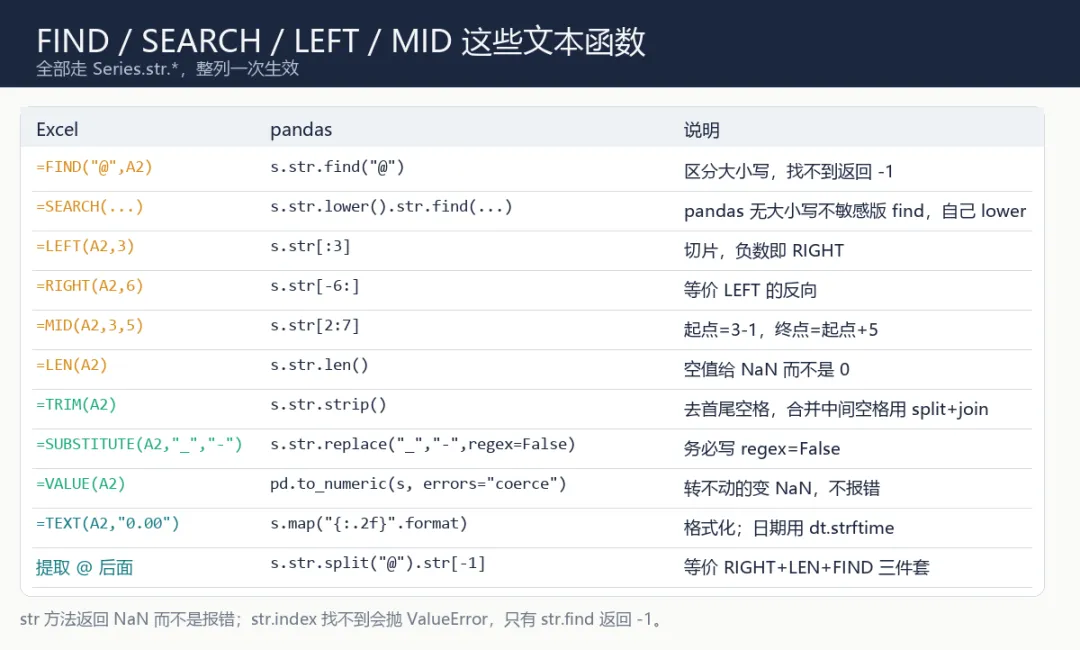
关键差别:**pandas 没有 SEARCH,只有区分大小写的 str.find**,不敏感就自己 .str.lower()。
实测(邮箱列第 1 行大写、第 4 行前后带空格):
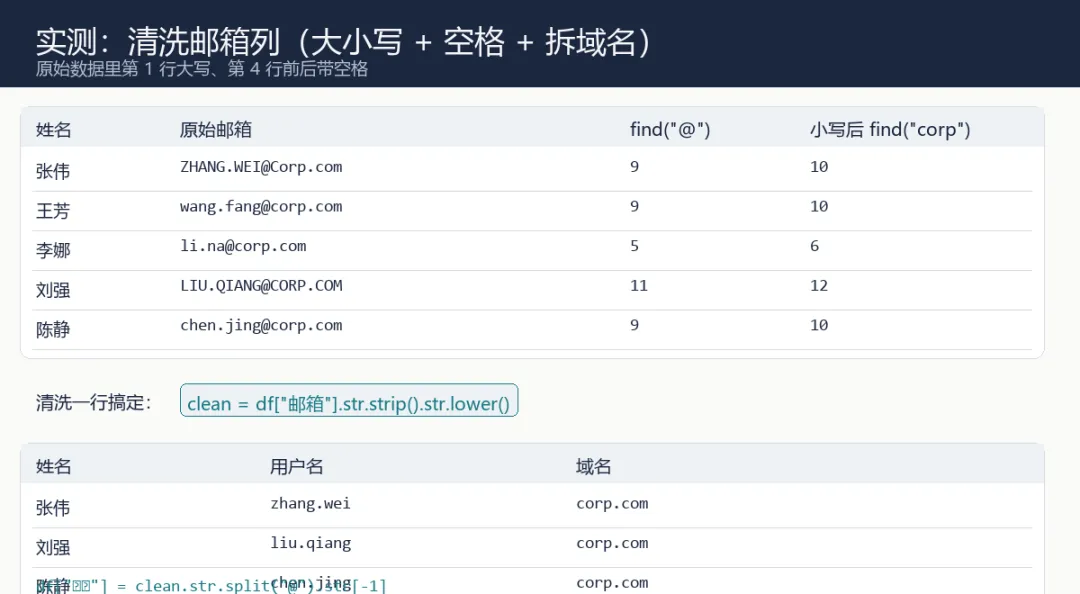
姓名                    邮箱  find("@")  小写后 find("corp")
张伟    ZHANG.WEI@Corp.com        9            10
李娜        li.na@corp.com        5             6
刘强   LIU.QIANG@CORP.COM       11            12
拆域名这种在 Excel 要 LEFT+LEN+FIND 三件套的活,pandas 一行:
clean = emp["邮箱"].str.strip().str.lower()
emp["域名"] = clean.str.split("@").str[-1]
# 张伟 zhang.wei corp.com / 刘强 liu.qiang corp.com
MID(A2,3,5) 换成 s.str[2:7]:起点减 1,终点是起点加长度。另外 str.index 找不到会抛 ValueError: substring not found,只有 str.find 返回 -1——要和 Excel 行为一致就用 find。
五、SUMIF / COUNTIF / AVERAGEIF / SUMIFS
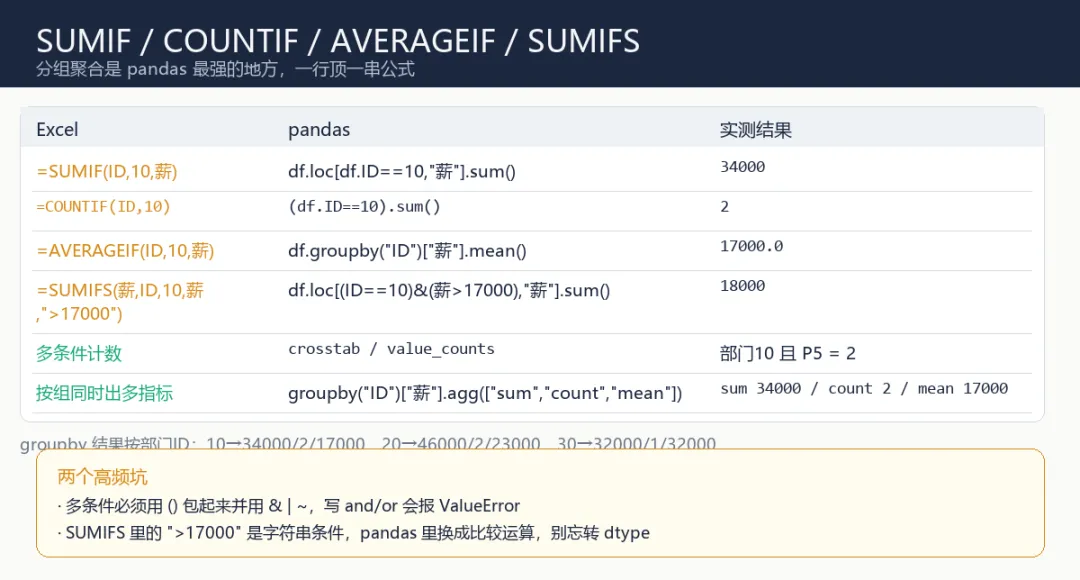
实测输出:
        sum  count     mean
部门ID
10    34000      2  17000.0
20    46000      2  23000.0
30    32000      1  32000.0

SUMIFS 双条件(部门=10 且 薪资>17000): 18000
COUNTIFS(部门=10 且 职级=P5): 2
一个 groupby(...).agg([...]) 就顶掉一整片 SUMIF 公式。多条件必须写成 (df.ID==10) & (df.薪>17000),用 and/or 会直接报错。
六、数据透视表
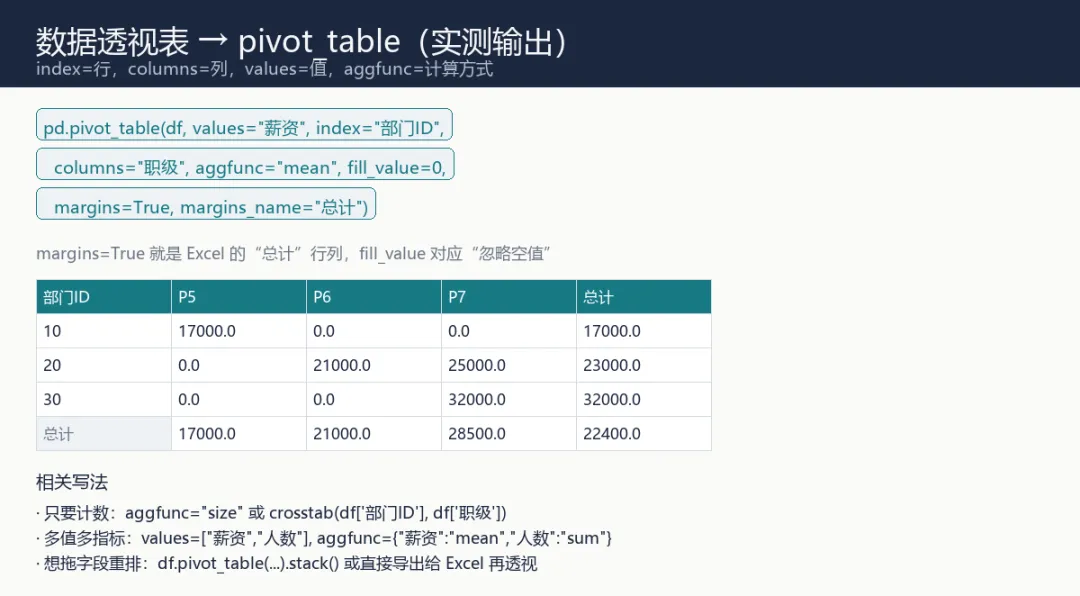
margins=True 就是 Excel 的"总计"行列,实测结果与手工核对一致(总计 22400.0)。
七、IF / IFS / IFERROR
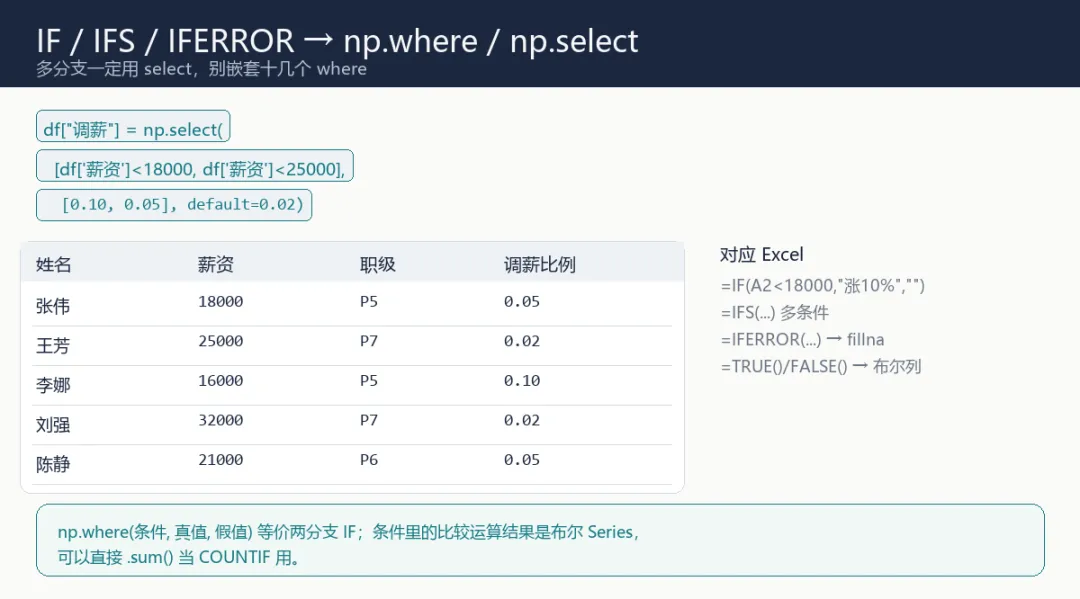
嵌套 IF 超过两层就该用 np.select,可读性和性能都好得多:
emp["调薪"] = np.select([emp["薪资"] < 18000, emp["薪资"] < 25000],
                        [0.10, 0.05], default=0.02)
# 张伟 18000→0.05  李娜 16000→0.10  王芳 25000→0.02
两分支用 np.where(条件, A, B);布尔列直接 .sum() 就是 COUNTIF。
八、六个必踩的坑
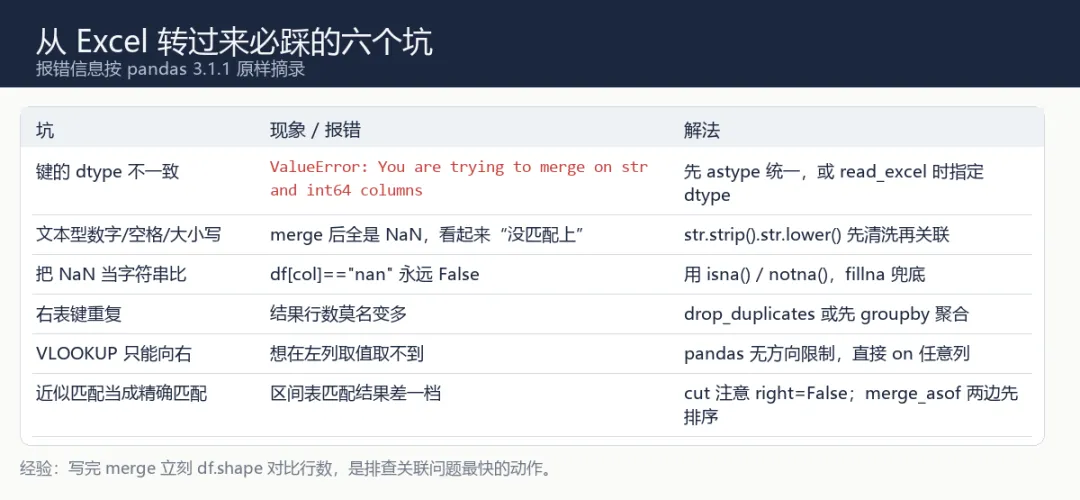
第一个坑最隐蔽也最常见。Excel 里"文本型数字"和数值混用很普遍,pandas 3 会直接拒绝:
ValueError: You are trying to merge on str and int64 columns for key 'k'.
If you wish to proceed you should use pd.concat
解法是把键统一:left["k"] = left["k"].astype(int),或 read_excel 时用 dtype= 指定。
第二个坑是脏数据导致"看起来没匹配上"。实测:同一批邮箱不做清洗直接 merge 只匹配上 1 条,strip().lower() 之后匹配上 2 条。
排查习惯:每次 merge 完立刻看 df.shape,行数变了就去找右表的重复键和左表的脏数据。
摘要
Excel 转 pandas 先换掉单元格思维:VLOOKUP 对应 merge/map,#N/A 即 NaN,FIND 对应 str.find,SUMIF 交给 groupby,透视表是 pivot_table