ARTICLE · 1372954
PDF 转格式总出错,我让 AI 批量搞定
PDF 转格式总出错,我让 AI 批量搞定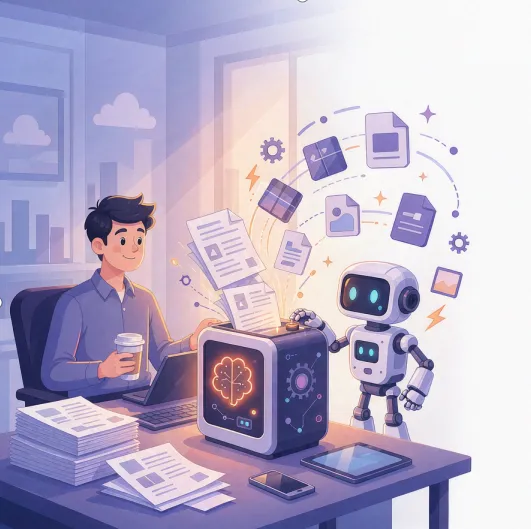
上周收到一摞 PDF 要改成可编辑的 Word,三十多个文件。我一个个另存,转出来一半是乱码,表格全飞。熬夜重排到凌晨,发誓下次再不手动干这种活。 PDF 转格式是个坑,尤其是别人发来的。我以前用在线工具一个个传,慢不说,带字的表格一转就乱,还担心文件泄出去。 我把需求说清楚:本地、批量、不联网。AI 给我写了个用现成库的小脚本,丢个文件夹进去,一晚上把三十多个 PDF 转成 Word,坐在旁边看就行。 我要把一整个文件夹的 PDF 批量转成 Word,要求本地运行、不联网、保留原排版。请给我一段 Python 脚本,并说明要装什么库、怎么运行、转出来乱码时怎么办。 转完发现,那几个扫描版的 PDF 还是乱的。AI 提醒我:扫描件没有文字层,得先 OCR 识别。它给了 OCR 的思路,我挑了个本地工具跑,文字出来了,再转 Word 才正常。 有些 PDF 是扫描图片,直接转是空的。请说明:怎么判断一个 PDF 有没有文字层、没有的话本地 OCR 该走哪一步、识别完怎么校对怕错的地方。 AI 写的脚本跑起来偶尔卡某个文件,它不会自己跳过。我让它在脚本里加「遇到坏文件记下来继续下一个」,别因为一个卡住全停。这种容错得自己加,AI 第一版想不到。 以前:三十多个文件手动转加排版,一整晚。现在:写脚本加跑完约 20 分钟,扫描件 OCR 另花 15 分钟,合计半小时出头,还不用盯。 含机密的合同、财报 PDF,别用联网工具,也别随便丢给本地 AI 解析,脱敏或离线处理。OCR 出错率不低,关键数字一定人工核对一遍。 你被 PDF 坑过几次?评论区聊聊。
PDF 转格式总出错,我让 AI 批量搞定