ARTICLE · 1390159
TorchAO Ascend开源:插件化支持TorchAO,打造高效易用的昇腾低精训推底座
大模型正朝着稀疏化的混合专家(MoE)架构和长上下文方向演进,参数规模的增长快于算力增长,因此低精度量化成为训练提效的关键路径。TorchAO是 PyTorch社区的量化工具库,把 Float8、MX 等低精工作流统一到PyTorch生态。
为了让开发者在昇腾上沿用这一体验,我们推出TorchAO Ascend:以插件方式接入TorchAO,将低精度算子调度到昇腾内核,兼容TorchTitan/DeepSpeed/FSDPTurbo/HyperParallel等分布式训推框架,并在Atlas 950 SuperPoD/Atlas 850E上完成验证。项目现已开源,欢迎广大开发者关注与参与贡献。
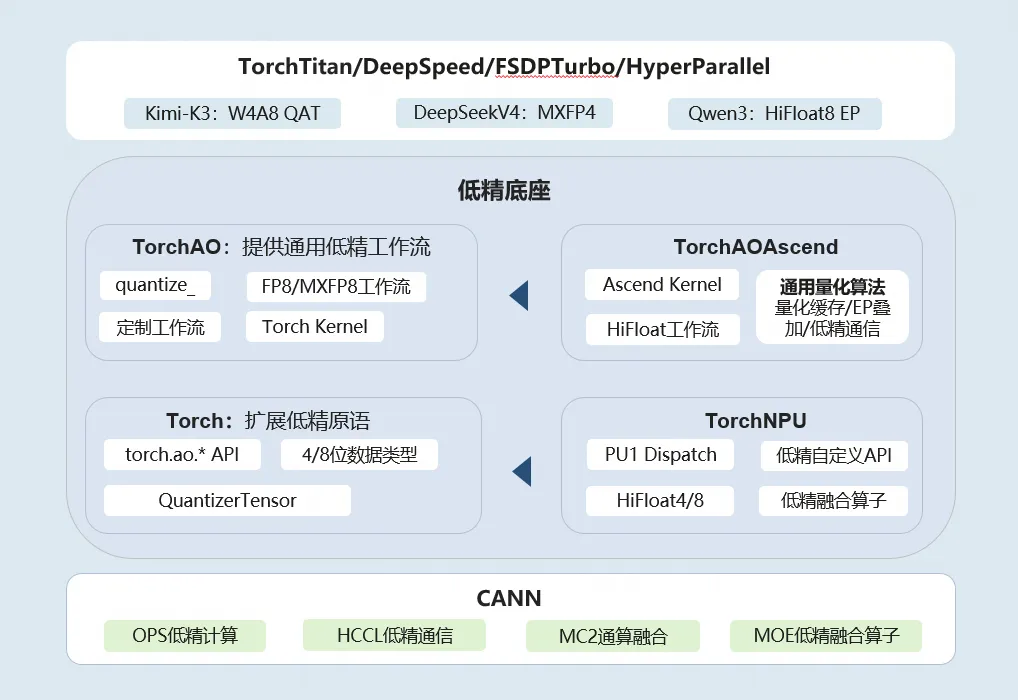
图1 Pytorch生态低精训推底座的分层能力栈
MoE 架构把模型容量做“大”、把单 Token 计算做“小”:以 Qwen3.5-122B-A10B 为例,模型总参数约122B,每个Token仅激活约 10B。模型的容量来自大量专家网络,计算开销则由稀疏激活决定,这也放大了大模型训推的资源矛盾:
显存墙。 专家网络占据参数大头,全部权重需常驻设备。122B 参数即使以 BF16 存储,权重也超过 240GB,叠加优化器状态、梯度与激活后,单卡乃至单机都难以承载。
通信墙。 专家并行(EP)会引入 All-to-All通信,数据并行带来梯度同步,通信字节量随参数规模线性增长,越来越难被计算时间掩盖。
算力墙。 同样的token预算下,硬件提供的FP8算力数倍于 FP16 的算力;停留在高精度路径,意味着放弃这部分硬件红利。
量化能够同时压低这三面墙:权重、激活与梯度均以 8-bit 甚至 4-bit 表示,使显存与通信开销直接减半,同时可以充分利用硬件的低精度算力。但低精度训练并不只是“换一种存储格式”——Float8 E4M3/E5M2 动态范围有限,需要维护逐层缩放因子;MX系列格式引入分组共享缩放,量化与反量化路径带来额外开销。训练链路对数值稳定性的要求,使得低精度训练的工程复杂度远高于低精度推理。
同样的,生态层面存在碎片化问题:不同训推框架各自封装低精实现,API与数值语义各不相同,量化配置难以在框架间复用。TorchAO 以“量化配置与训练流程解耦”的方式,把Float8、MX等的量化方案统一进PyTorch原生workflow,与分布式训推框架自然衔接,成为PyTorch生态的低精训推底座。
HiFloat8是昇腾发表的8-bit浮点格式,采用渐变精度:按幅值分三档分配尾数(7/8/16个指数值分别配3/2/1位),非规格值再把动态范围从31扩到38个二进制量级(FP16为40)。相比固定尾数的Float8(E4M3范围窄、E5M2尾数少),它在同样8-bit下兼顾范围与精度,也无需逐层维护缩放因子。
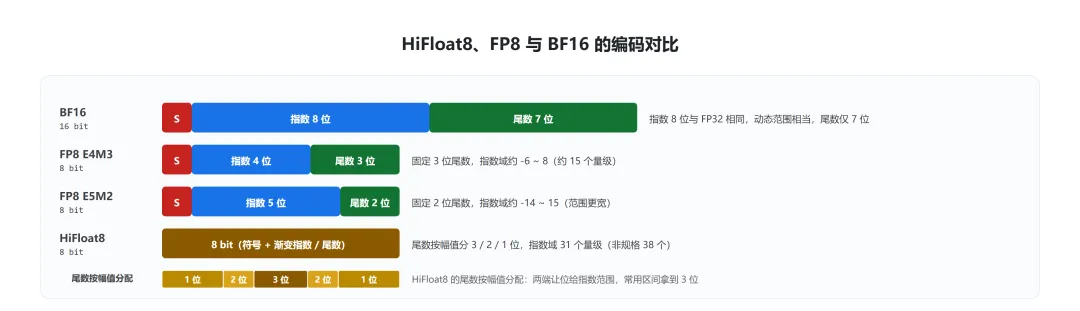
图2 HiFloat8、Float8与BF16的编码对比
TorchAO Ascend已覆盖Linear和MoE两条HiFloat8低精度工作流,均可通过quantize_统一入口做低精度转换,权重与优化器状态保持不变。在训练阶段,采用per-tensor动态量化,激活、权重与梯度按配方各自缩放,即可达成接近BF16的训练精度。
分布式并行技术包括TP/PP/EP/FSDP等,是大规模集群训推大模型所必须的优化技术,主要作用于部署和通信阶段;低精度技术包括量化/反量化、低精矩阵乘等,主要作用于计算阶段。两者天然支持在收益上的正交叠加:在TP/PP域上,权重、梯度与优化器状态按分片切分到多卡上,再配合量化进一步压缩权重和梯度,预留更多显存来做训推加速;在EP域上,token先量化再经All-to-All分发到多卡上,和每张卡上的低精度专家权重计算分组矩阵乘。
TorchAO Ascend沿用TorchAO的转换载体机制,来实现两者在实现上的正交叠加:ModuleSwap通过nn.Module层面的低精转换,允许用户定制分布式场景的低精计算流;TensorWrap通过Tensor层面的低精转换,天然支持分布式的DTensor特性。
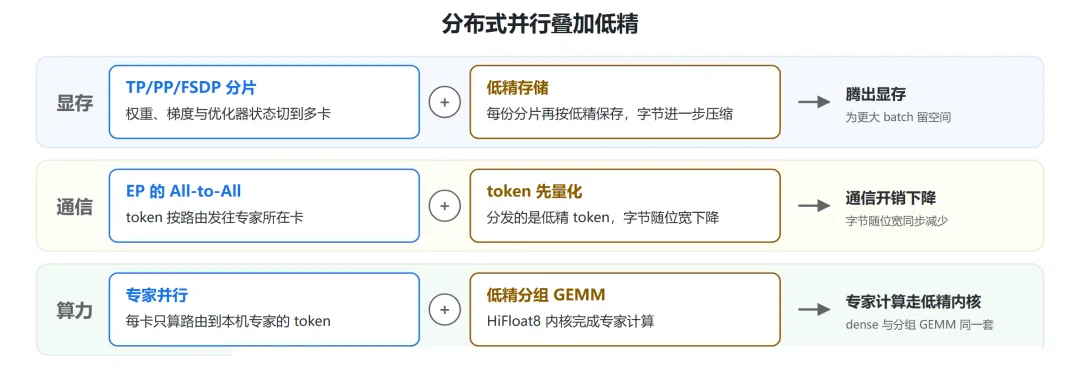
图3 分布式并行叠加低精的整体架构
权重All-Gather分发是MoE模型训推过程中仅次于专家并行的通信开销。为降低这一开销,一般采用量化前移的策略:权重分片在通信前就先量化到低精度。对此,训练过程有两处需额外处理:集合通信对数据类型的限制,反向重算对权重的两次量化。
由于HCCL不支持uint8的All-Gather,TorchAO Ascend在实现上把1-bit的张量按BF16视图重新解释,使得在字节数不变的同时,也统一了通信时的数据类型; 由于量化结果按step缓存、优化器步后会失效,TorchAO Ascend用相位状态机区分前反向,避免同一份权重被反复量化,还能进一步叠加量化缓存技术。
Qwen3.5-122B-A10B采用Gated DeltaNet线性注意力与MoE(256专家、top-8路由加1个共享专家)的混合架构。其专家权重占据绝对大头,是低精度训练收益最明显的场景。
本示例在Atlas 950 SuperPoD单机8卡上启动Qwen模型训练,专家并行按每卡32个专家切分、batch 4、序列2048。本轮聚焦链路验证,为把122B权重完整装入单机8卡,仅在部分专家层上开展训练。
参考TorchAO Ascend安装说明准备依赖、算子,并下载所需的数据集和模型文件。训练脚本首行导入TorchAO Ascend即完成插件注册,随后对nn.Module类型的model调用quantize_,即可完成大模型的低精度转换。
import torchao_npufrom torchao.hifloat8 import HiFloat8Config, mixed_filter_fnfrom torchao.quantization import quantize_quant_config = HiFloat8Config.from_dict({"linear": {...}, "grouped": {...}})quantize_(model, quant_config)
详细指导见:
https://gitcode.com/Ascend/torchao-ascend/blob/main/docs/HiFloat8_usage.md
HiFloat8与BF16在同模型、同数据、同配置下完成200步训练。在性能上,GMM前反向的计算时延相比BF16降低 17.3%;在精度上,全程loss相对误差小于0.5%,两精度曲线基本重合,grad_norm轨迹一致。
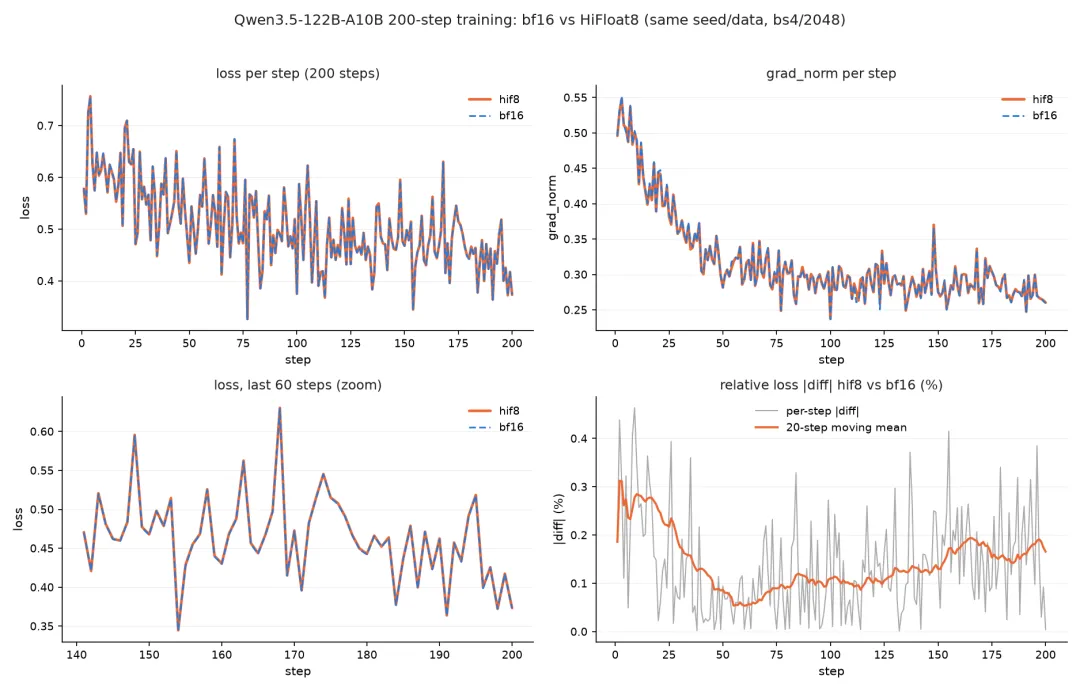
图4 Qwen3.5-122B-A10B 200步HiF8/BF16训练对比。四张子图依次为逐步loss、逐步grad_norm、末60步loss,以及loss逐步相对偏差及其20步滑动均值
TorchAO Ascend 属于Ascend for PyTorch 生态,欢迎开发者参与内核适配、训练验证与场景共建,共同完善昇腾低精训练底座。
TorchAO Ascend 仓库:
https://gitcode.com/Ascend/torchao-ascend
TorchAO 上游仓库:
https://github.com/pytorch/ao
Ascend for PyTorch Core SIG:
https://gitcode.com/Ascend/community/blob/master/AscendForPyTorch/sigs/core/README.md
Ascend for PyTorch TC 与SIG 组织:
https://gitcode.com/Ascend/community/blob/master/AscendForPyTorch/README.md
SIG 会议日历:
https://meeting.ascend.osinfra.cn/?sig=sig-distributed
◆往期推荐◆