ARTICLE · 1393950
国产开源大模型下载破100亿次,中国模型连续29周排第一
发布时间:2026-11-21 14:27:03 最近访问:2026-11-21 14:27:03
国产开源大模型下载破100亿次,中国模型连续29周排第一
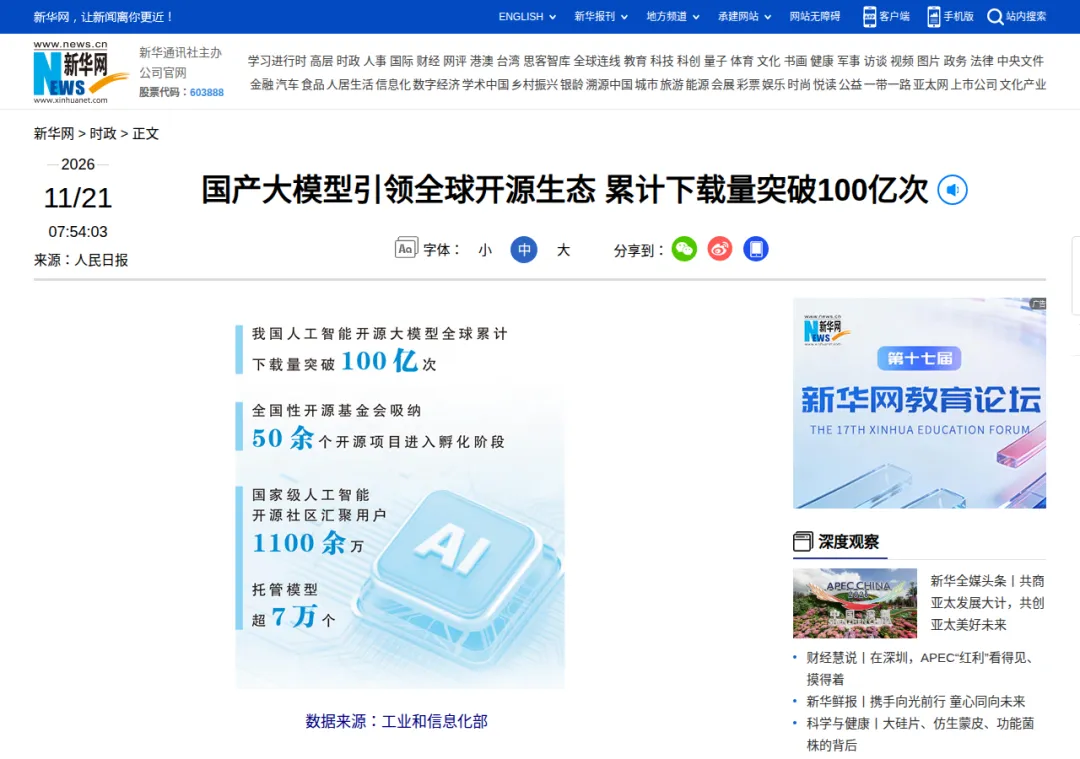
11月21日,人民日报刊了一组数据,国内人工智能开源大模型的全球累计下载量,突破了100亿次。这个数字来自工信部,配图里还有几个数,全国性开源基金会吸纳了50余个开源项目,国家级开源社区汇聚用户1100余万,托管模型超过7万个。新华网11月21日报道,工信部数据显示国产开源大模型全球累计下载量突破100亿次下载量只是一个侧面。更能说明问题的是海外开发者到底在用谁的模型。全球模型聚合平台OpenRouter公布的最新周榜显示,11月9日到15日这一周,中国模型的调用量是119.1万亿词元,连续第29周排在全球第一。这里要补一句口径。OpenRouter上的调用量按词元计,谁的模型便宜、谁被更多中间层路由调用,都会把数字推高,它不等于模型能力排名。但连续29周这个时长,已经很难用偶然解释了。这轮开源里,几个名字值得单独记。月之暗面刚放出Kimi K3.1 Pro的完整权重,外界叫它全球参数规模最大的开源模型。腾讯混元的新一代模型Hy4也在最近发布,指令遵循、长文理解和深度研究这几项都做了提升。之前DeepSeek用混合专家架构把推理成本压下来,现在这套架构几乎成了全行业的共同方向。对普通用户来说,这些数字的意义不在于榜单。开源模型能下载到自己电脑上跑,意味着不需要把数据传到别人服务器,也不用按次给API付费。对个人开发者和小团队,这直接把试错成本降到了接近零。不过也得看清另一面。开放权重不等于免费商用,很多模型用的是带条件的自定义许可,真要用在产品里,条款得逐条读。下载量破百亿是里程碑,但不是所有下载都变成了收入。我的判断是,国产开源这一波已经从能不能用走到了好不好用。下载量和调用量双双登顶,说明中国模型在全球开发者手里的位置,早就不是追赶者了。以上就是这次的全部内容。觉得有用,点个「在看」,转发给还在关注AI的朋友。想第一时间收到更新,点关注,更新早知道。