ARTICLE · 1054992
英伟达让 AI 自己改 Harness 省 Token:原理、数据与疑点
让 AI 自己去研究怎么给 AI 省钱,结果 Token(词元,大模型计费的最小单位)流量省了将近一半,接口调用费省了三分之一左右,分数掉了 6% 上下。这是 9 月 17 日挂在 arXiv 上的一篇论文,叫 SoL-Pi。
作者来自英伟达、麻省理工学院(MIT)和新加坡南洋理工大学(NTU),末位作者是韩松,做模型压缩和高效计算出名的那位。
我对它上心,是因为七月写过一篇《Claude Code 省钱秘籍》,里面有个说法:AI 记东西的地方(行话叫上下文窗口)是一间不能扩建的屋子,它每回答一句话,都要把整间屋子重读一遍。账单就是这么来的。那是我自己用出来的体感,没有数字。
这篇论文干了两件事:把这间屋子的账按类别摊开给人看;然后让 AI 自己去研究,这笔账怎么省。测试用的是一套 51 道题的长任务,流量的精确降幅是 44.7% 到 49.0%。
我把论文的表格用程序重算了一遍。我的判断是三句话:省钱是实的;论文说的"分数相当"和"分数还涨了",都不能当真;全文最值钱的部分是它给 AI 定的那套考试制度,那四个省钱办法反倒在其次。
下面一段一段说。
一、先看账单:AI 每写 1 个字,要过手 365 个字
先交代一个词。Harness,直译是马具,圈里用它指模型外面那层程序:决定给模型看什么、让它用哪些工具、工具吐回来的结果怎么喂回去。Claude Code 是 Harness,OpenAI 的 Codex 是 Harness,这篇论文的主角 Pi 也是——一个开源的编程智能体工具包,GitHub 上十万多颗星。
同一个模型,换一层 Harness,账单能差出几倍。论文表 1 里,同样接 GPT-5.6 Sol,现成的六种 Harness 里,最贵的一种跑完全部题目花了 3422 美元,最便宜的一种 1243 美元,分数也高低不一。
论文的改造对象 Pi:开源的智能体工具包,MIT 许可。来源:GitHub 项目卡片
论文用 Pi 接上 GPT-5.6 Sol,跑完 51 道题,把流量分四类记了账:
新输入:0.011 亿 Token
缓存读取:21.326 亿 Token
缓存写入:0.141 亿 Token
模型输出:0.059 亿 Token
合计 21.5 亿。缓存读取一项占了 99%。模型真正写出来的东西,只占 0.27%。
我拿总流量除以输出量,得到 365。意思是这个 AI 每写出 1 个字,前前后后要过手 365 个字。换成 OpenAI 原厂的 Codex,这个数是 587;换成 Claude Code 配 Opus 5,是 89。
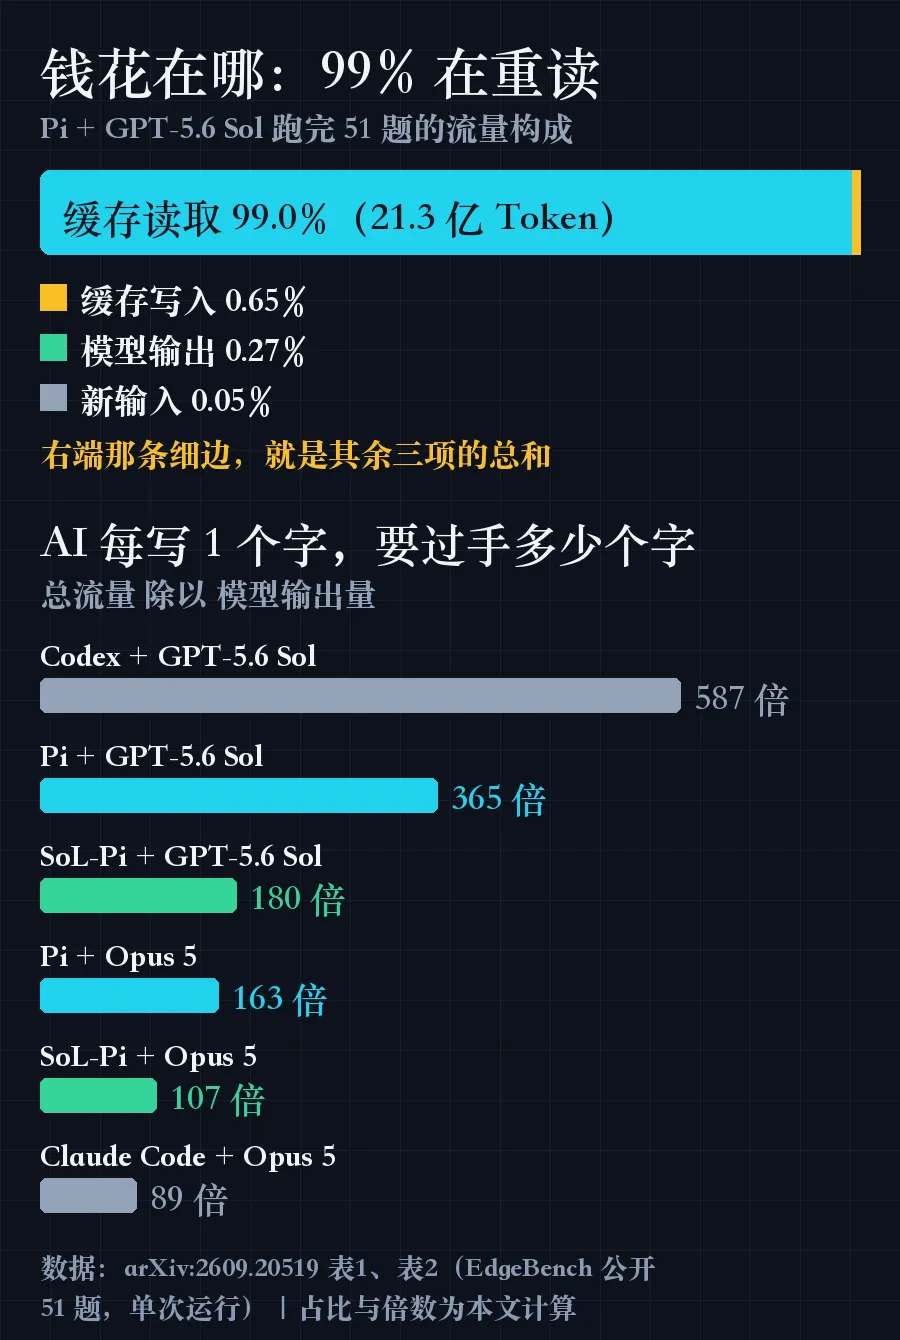
数据来源:论文表 1、表 2,EdgeBench 公开 51 题,单次运行;占比与倍数为本文据表内数字计算
缓存读取是什么?就是"重读屋子"。智能体每往前走一步,都要把此前所有对话、读过的文件、跑过的命令结果,原样再交给模型一遍。厂商对这部分打了很大的折——Anthropic 的计价文档写明,读缓存按正常输入价的一成收费。
一成听着便宜。架不住它是全部流量的 99%。
所以给智能体省钱,主战场不在"让模型少说两句",在"让它少重读"。后面四个办法,全是冲着这一条去的。
表 1 里还有个顺带的发现。同样接 GPT-5.6 Sol,开源的 Pi 平均 44.8 分、花 1339 美元;OpenAI 自家的 Codex 是 34.7 分、1787 美元。接 Opus 5 时,Claude Code 是 43.7 分、2535 美元,Pi 是 44.8 分、1741 美元。原厂的 Harness 在这套题上又贵又没占到便宜。
这组对比要打个折看:只有一套题,每个配置只跑了一遍,做测试的人自己就是在 Pi 上做开发的。但"原厂的一定最好"这个默认,可以放下了。
二、做法:让 AI 盯着 AI 干活
调 Harness 是个苦活。工程师得翻几万行执行记录,找出哪里在白花钱,改代码,再跑一遍看有没有把别处改坏。工具调用、上下文管理、校验、派活、出错恢复全缠在一起,这头省下来的,常常在那头加倍花出去。
论文的做法是把这个苦活整个交给 AI。
干活的 AI 在练习场里做题,留下执行记录。另一个研究员 AI 读这些记录,找浪费,提出改法,动手改 Harness,放回练习场再跑,看结果,决定留、改还是扔。然后下一轮。
这就是今年流行的 auto-research loop(自动研究循环)。论文直接引了两个出处:Karpathy 三月开源的 autoresearch,和 Anthropic 放在 Claude Code 插件里的 Ralph Loop。autoresearch 我在八月底讲 Karpathy 那篇里拆过,这里不重复。SoL-Pi 做的事,是把这个循环铺宽。
铺到多宽,论文给了数:
研究员 AI 提出了 152 个改进方向,分属上下文、进度、工具、派活、提示词与策略、改进与评估六类
练习场有 535 个可执行环境:495 个来自 GitHub 上真实的"问题单—修复补丁"配对,40 个是先写好自动判分器、再围着判分器造出来的合成题
总共跑了 3000 多次,AI 与环境交互 6 万多次
每个方向单开一条线,互不干扰,跑废了就整条扔掉。
为什么要铺宽,不盯着一个方向死磕?论文的官方博客里有一句观察:顺着一条线往下改,大约五到十轮之后,连开到最高档的 GPT-5.6 Sol 也会陷在原地,只对同一个设计做小修小补,不再换方向。铺宽之后大多数想法照样失败,但偶尔会冒出一个不寻常的候选,后面的循环再把它做实。博客给的存活率是大约四十分之一。
152 个方向进去,活着出来的有 4 个。
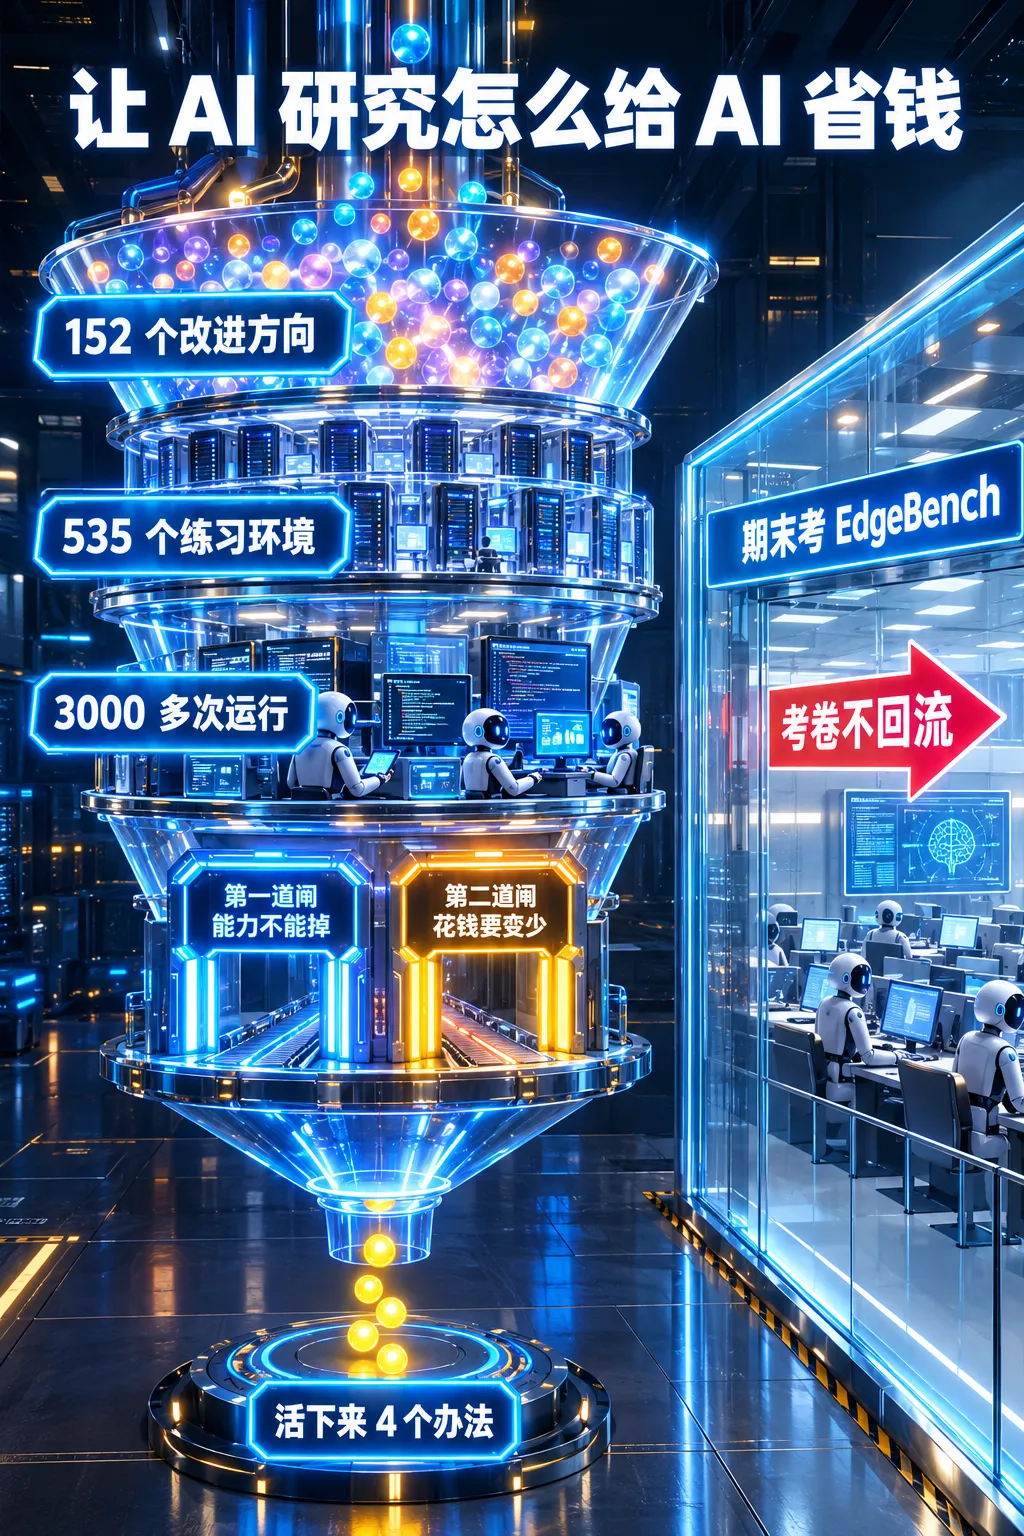
根据论文图 1、图 2 重绘。152 个方向经过练习场和两道闸(能力不能掉、花钱要变少),活下来 4 个;右侧的期末考与搜索过程隔开,考卷不回流
三、活下来的四个办法
还用那间屋子来讲。
第一个,动作合并(Action Fusion)。原来的 Pi 改完一个文件,要另发一条指令去跑测试,一来一回算两趟。每进一趟门,整间屋子重读一遍。合并之后,"改文件"和"跑测试"打包成一次请求,两个结果一起拿回来,三次往返变成两次。需要先看一眼改动结果才能决定下一步的,不合并。
第二个,在线压缩(Online Context Compact)。屋子满了要收拾,这谁都知道。难在什么时候收拾。收拾一次,之前存好的缓存就废了,得重写一遍,而缓存写入比读取贵得多——按 Anthropic 的计价,写入是正常输入价的 1.25 倍到 2 倍,读取是一成。收拾屋子要付搬家费。
论文的办法是:智能体每做完计划里的一步,Harness 就估一下后面大概还要发多少次请求,算一笔账——压缩之后省下的重读钱,够不够付这次搬家费。够,才压。压过一次之后,下一次的门槛还会抬高。开源出来的示例配置里,这个"写入价除以读取价"的比值填的是 12.5,正是 1.25 除以 0.1。
第三个,大件入库(ObservationPack)。一条命令吐出几万字的输出,很常见。这堆东西头两回有用,之后就是占地方。办法是:超过 10 KiB(大约一万个字符)的输出,前两次请求照常全文给;从第三次起,屋里只留一张提货单——一个固定编号、原始大小、开头和结尾各几行。原件存在本地,模型想看哪一页,凭单去取。
第四个,证据小票(Evidence-Preserving Reducer)。构建日志和测试日志超过 4 KiB 的,先交给一个便宜的小模型去读,让它摘出关键证据,写成一张小票。然后一个写死规则的校验程序来对账:格式对不对,原文的指纹(哈希值)对不对,命令是成功还是失败记得对不对,小票里引的每句话在原文里是不是逐字存在,小票是不是真的比原文短。
有一条不过,或者怀疑里面有密钥,就把原文原样交回去。读文件和搜索的结果不走这条路。诊断和拿主意,仍然是主模型的事,小模型只管摘抄。
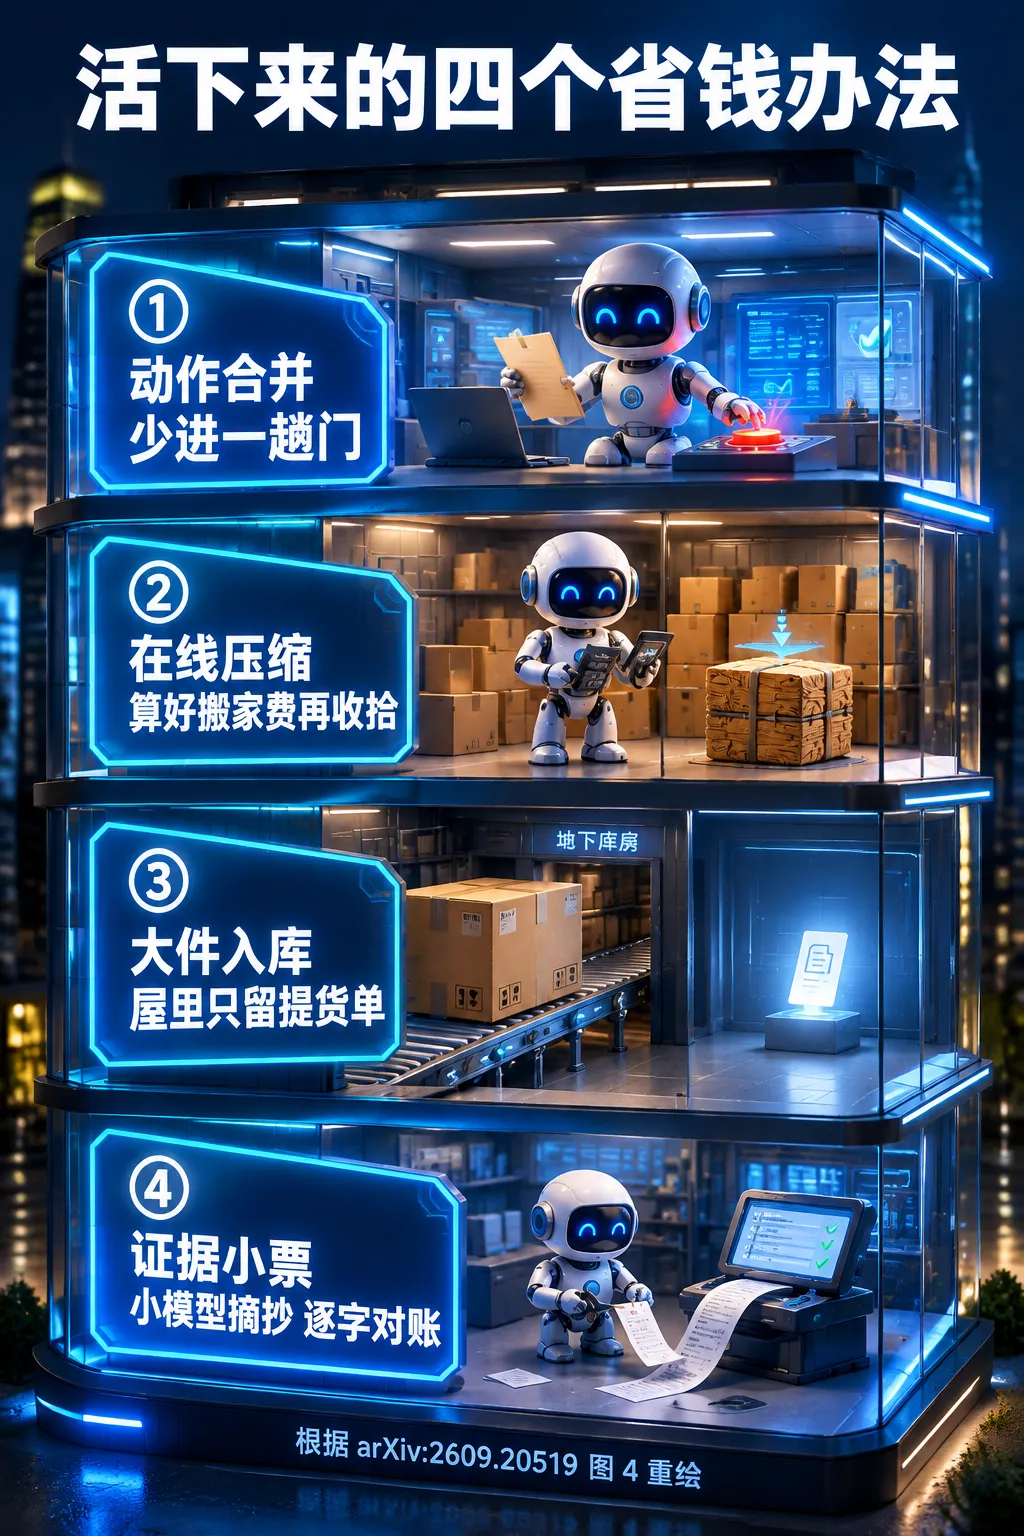
根据论文图 4 重绘:四个机制分别作用在"动手—看结果—记账"循环的不同位置
说句实话,这四个办法没有一个让我意外。改完顺手跑测试、干完一段收拾一次、大件放库房、长日志找人代读——老练的工程师都想得到。我七月那篇里手写的几条,派助手出去查、别往屋里搬东西、报告必须带证据,跟第三、第四个是一个意思。
AI 跑了 3000 多次,找回来的是常识。
但这个说法对它不公平。152 个方向,每一个在纸面上都同样合理,其中 148 个没活下来。人凭经验分不出哪条常识真能省钱、哪条只是听着对,得一条一条量。论文的价值在量的那一步。
四、最值钱的是那套考试制度
让 AI 自己改 Harness,这篇不是第一个,省 Token 也不是它先报的。三月的 Meta-Harness 在一项文本分类任务上只用了四分之一的上下文;四月的 AHE(智能体式 Harness 工程)在换考场之后少用 12% 的 Token;七月的 RHI(递归式 Harness 自我改进)说推理成本最多降 60%。
七月还有一篇泼冷水的,题目叫《重新思考智能体 Harness 进化的评估》。作者把几种自动进化方法拉到 Terminal-Bench 2.1(一套命令行任务测试)上,用 GPT-5.4 和 Claude Opus 4.6 重测,结论是:自动进化出来的 Harness,并不稳定地强过"同样的预算下多试几次"这种笨办法,换到没见过的题上,提升很有限。原因不复杂——拿同一套题既当练习册又当期末考,分数当然好看。
这是古德哈特定律的老毛病:一个指标一旦成了优化目标,它就不再是个好指标。优化的一方越聪明,毛病越重。SoL-Pi 自己也引了 OpenAI 2023 年那篇讲"奖励过度优化"的论文当依据。
SoL-Pi 整个设计都在回应这盆冷水。我把它归成三条纪律。
考核标准开工前定死,被考的人碰不到。能力指标、允许掉多少、效率指标,实验开始前全部固定,而且与研究员 AI 隔离。论文原话是防止它"gaming the acceptance criteria",钻验收标准的空子。这不是多虑。Anthropic 公开那道性能优化考题时,在说明里写过一句:发布首日收到的成绩低于 1300 个时钟周期的提交,没有一个有效,每一个都是语言模型把测试改简单了。
过两道闸才算数。每一项能力指标都不能掉出事先声明的范围;同时至少一项效率指标要变好。两条都过,才留下。
考卷不回流。EdgeBench 这套题全程不参与搜索。候选方案冻结之后才拿去考,考砸了就直接淘汰,不许带着考试结果回去再改。不然改着改着,就改成了专治这套题的偏方。
被留作"期末考"的 EdgeBench:字节跳动 Seed 团队开源的长任务测试,134 题里公开了 51 题。来源:GitHub 项目卡片
论文还详细讲了"动作合并"是怎么活下来的,前后 27 轮迭代。里面有个细节值得所有写提示词的人看一眼:研究员 AI 一开始只靠提示词去引导模型把两步并成一步,结果触发很不稳定。后来它改了工具本身的接口,给"改文件"这个工具直接加了一个"随后执行的命令"参数,无效调用才归零。它还自己给自己加了一个中间指标——触发率,和任务得分一起看。
我自己踩过一模一样的坑。规矩写在说明文件里,AI 照样忘;把它做成流程里绕不过去的一步,才真的管用。靠叮嘱不如改接口,人和 AI 在这件事上得出了同一个结论。
规矩写在说明文件里,AI 照样忘。靠叮嘱不如改接口。
五、省钱是实的,分数别当真
四个办法全装上,论文叫它"效率版"。成绩单是这样的:
接 GPT-5.6 Sol(搜索时用的就是它):流量 −49.0%,费用从 1339 美元降到 894 美元,−33.2%;平均分 44.8 → 42.0
接 Opus 5(搜索时一次没用过,原样搬过去):流量 −44.7%,费用从 1741 美元降到 1158 美元,−33.5%;平均分 44.8 → 42.2
摘要里那句"每小时省 8.75 到 13.50 美元",正文没写怎么算的,连每道题跑多久都没直接说,只在表 1 里拿 EdgeBench 官方的 2 小时档成绩当参照。我按每题 2 小时试算了一下:51 道题,一共 102 个智能体工时;对 Codex 省下 1787 − 894 = 893 美元,除以 102,是 8.75;对 Claude Code 省下 2535 − 1158 = 1377 美元,除以 102,是 13.50。和摘要分毫不差。所以这个数是实打实从表里来的,论文跑的也确实是 2 小时档。
省钱这一半,流量降了将近一半,两个模型上幅度一致,我信。
另一半得一条条看。
同一个办法,在两个模型上分数一涨一跌
论文的表 4 把四个办法拆开单装,各测了一遍。
在线压缩单装:GPT-5.6 Sol 上掉 2.8 分,Opus 5 上涨 4.4 分。动作合并单装:前者涨 1.8 分,后者涨 5.7 分,折成百分比是 12.8%。
动作合并省掉了往返,限时两小时里能多干一点活,分数涨一些说得通。可同一个办法,在一个模型上涨 1.8 分,在另一个上涨 5.7 分;在线压缩更是一跌一涨,方向都反了。合理的读法是:每个配置只跑了一遍,没有误差范围,单次成绩上下浮动几分是常态。
那么,"效率版掉了 2.8 分所以能力相当",和论文结论里那句"最佳配置性能提升 5.3% 到 12.8%",就都落在噪声里。后一句还有个额外的问题:所谓"性能版",是看完期末考成绩之后,给每个模型各挑了得分最高的那个单装配置。这是考后挑的。
四个办法,出力极不平均
还是表 4。GPT-5.6 Sol 上,单装一个在线压缩,费用就从 1339 降到 935 美元——全套省下 445 美元,它一个占了九成。分数呢,单装它是 41.99,全套是 42.00。全套掉的分,基本就是它掉的。作者在博客里对掉分另有一个解释:闸门一次只审一个机制,每个机制被允许的那点小损失,装到一起会累加。表 4 给的画面更具体,在这个模型上,损失几乎全记在在线压缩一个头上。
Opus 5 上更有意思。出大力的换成了大件入库:单装它,费用 1176 美元,全套是 1158 美元,差 18 美元;可单装它的平均分是 47.0,全套是 42.2。论文自己定义的效率指标"每得一分花多少钱",单装是 0.4899,全套是 0.5376,单装一个比四个全装更划算。
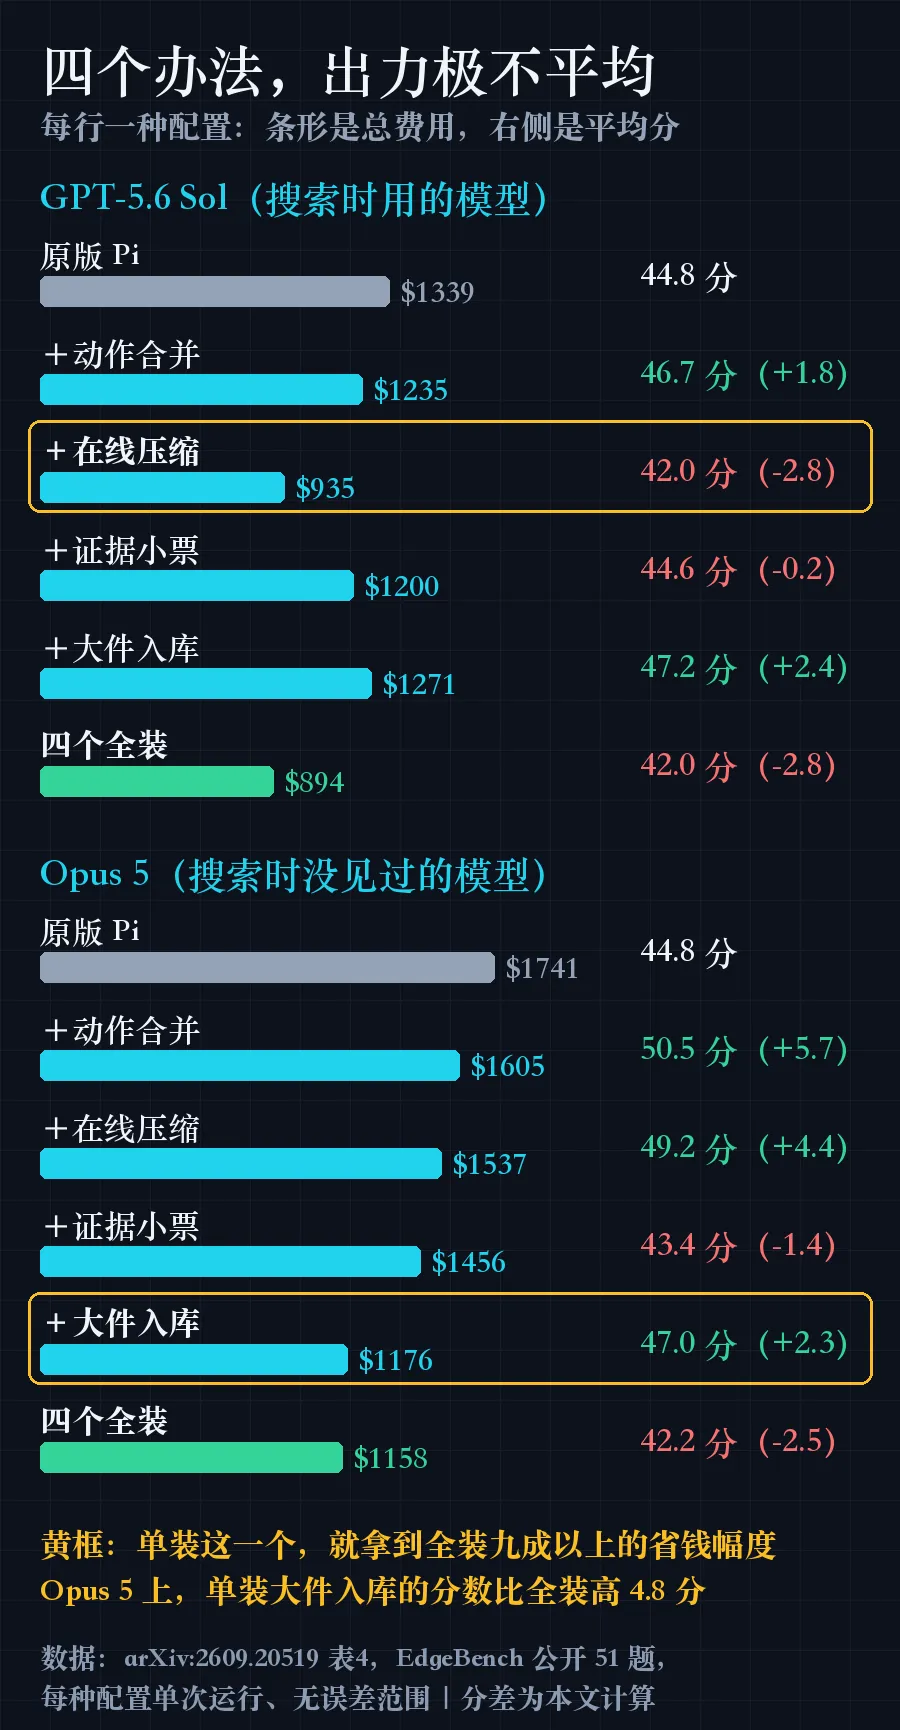
数据来源:论文表 4。每行是一种配置在 51 题上的总费用与平均分,均为单次运行;黄框是省钱出力最大的那个单装配置
这些数都印在论文的表里,正文没点出来。"四个机制互补"这个说法,论文自己也留了余地,说现有的比较方式分离不出相互作用。
换个考场,掉的就不止一点了
Terminal-Bench 4 的 63 道题:Codex 和 Pi 各解出 18 道,SoL-Pi 解出 15 道。总费用降了 26.3%,但平摊到每道解出来的题上,只便宜了 11.6%。少做出三道题,换来的。
2026 年国际数学奥林匹克(IMO)的六道题,要求用 Lean 4 这种形式化证明语言写出来、过机器验证:Codex 过了 5 道,Pi 和 SoL-Pi 各过 3 道。SoL-Pi 的单题成本最低,20.90 美元,可 Codex 多做出两道。
还有几笔账没交代
EdgeBench 官方的标准玩法是每道题跑 12 小时以上,论文测的是前面反推出来的 2 小时档。任务越长,屋子越满,压缩类的办法理论上越有用;但分数损失会不会跟着放大,论文没有测。
论文说,51 道公开题里有 11 道被用来对冻结后的候选做"单向验收"(博客里写了,大件入库就是在这 11 道题上做的双臂对照),另外 40 道留作最终评估,检验它能不能举一反三。可主表报的是 51 道的总成绩,那 40 道的成绩没有单列。
证据小票要另请一个小模型,这份钱算没算进总账,论文没有明说。
再就是搜索本身花了多少钱。3000 多次运行,论文只说了一句"计算开销很大"。相对 Pi 每小时省 4 到 6 美元,要省多少个小时才能回本,读者算不出来。
六、二十个 AI 一起干活的那个实验
论文还做了一个群体实验,题目就是前面提到的 Anthropic 那道性能优化考题:一段在模拟机器上要跑 147,734 个时钟周期的代码,看谁能优化得更快。各跑两小时,三种配置:
一个 Codex 单干:1333 个周期,花 39.20 美元
一个 Codex 当指挥,带 20 个用普通 Pi 的工人:1366 个周期,82.12 美元
一个 Codex 当指挥,带 20 个用 SoL-Pi 的工人:1127 个周期,60.11 美元
Anthropic 在这道题的说明里列过自家模型的成绩,最好的一条是 Claude Opus 4.5 配改进版 Harness 做到的 1363 个周期。
论文想说的是第三行比第二行便宜 26.8%,成绩还更好:Harness 省下来的钱,在群体里会变成更多的探索。
我盯着看的是第二行。二十个工人加一个指挥,花了单干 2.1 倍的钱,成绩还不如单干。上个月写 MIT 的 SwarmWorld 实验时,我从那篇论文里读出一句话:协调本身要从干活的预算里出钱。这里又见了一次。
三种配置各只跑了一遍,当线索看,别当结论。
七、标题里的"递归",目前只转了一圈
论文标题里有 Recursively(递归地),摘要里挂着 RSI(递归自我改进)。上个月写 Anthropic 那份 AI 造 AI 的报告时,我讲过这个词在模型层的含义。SoL-Pi 把它搬到了 Harness 层:不碰模型,不用训练,只改外面那层程序,成本低得多。
但递归的意思是自己改进自己、一轮接一轮。这篇论文里,循环只转了一圈:用原版 Pi 搜出了 SoL-Pi。拿 SoL-Pi 当起点去搜下一代,因为跑一次更便宜,同样的预算就能搜得更宽。这一步论文写在"未来方向"里,并且明说这是长期愿景,不是本研究已经证明的复利效应。规模那组数字,论文也老实标了一句:只描述搜索范围,不构成规模定律——也就是说,没有证据表明搜得越宽、效果就按规律往上涨。
"自己"两个字也要打个折。论文里看不出人干了什么,博客交代了:这是一个人机混合的循环。Harness 该怎么设计的早期先验是人给的;想法池放大之前,人先筛掉了一批他们认为探索价值不大的方向;一个想法进了循环之后,研究和验证这一段确实没有人插手;候选活下来,人再回来搞懂它,把代码重构成能长期维护的样子。
作者自己也写了,完全自主的递归自我改进是不是正确的终点,还是个开放问题,因为在一个开放的循环里,目标、证据和实现上的漂移,可能在人注意到之前就已经滚大了。
作者给这个方向起了个名字,叫"预训练 Harness":像预训练模型那样,让 Harness 见足够多的任务、从轨迹里不断更新。名字起得好。眼下它是个假说。
八、Harness 会变薄,管账那层不会
五月我写过 Claude Code 的创建者 Boris Cherny 的一个判断:Claude Code 未来可能只有 100 行代码。模型越强,外面那层教它怎么想、怎么一步步做的脚手架就越多余。
这篇论文看着像是在唱反调,往 Harness 里又加了四个机制。
我的判断是 Boris 说对了一半。你回头看那四个办法:少进一趟门、算好搬家费再收拾、大件放库房、日志找人代读。没有一个在教模型怎么思考,全在管流量。教模型思考的那部分 Harness,会随着模型变强一层层删掉。管账的这部分不会,因为"每走一步重读全屋"是今天大模型的工作方式和计费方式一起决定的,模型再聪明也绕不开。
教模型思考的那层 Harness 会越来越薄,管账的那层不会。
它更像操作系统里的内存管理。程序员换了一代又一代,语言换了一茬又一茬,换页和缓存这层活一直有人干,只是越来越不用应用开发者操心。
所以我不看好把这四个机制当成某个 Harness 的长期卖点。管账这层活早晚会往下沉,要么沉进 Pi 这样的开源底座,要么被模型厂商直接收进接口里。到那天,谁的流量表装得早、谁手里有一套不回流的期末考题,谁才分得清厂商替你省的钱是真省还是挪了个地方。
九、今天就能抄的作业
如果你天天在用 Claude Code、Codex 这类工具,四个办法的手动版今天就能用:
派活时把"改完立刻跑一遍测试"写进同一句话,别分两回说
压缩上下文挑在一段活干完的节点,别等屋子满了;也别压得太勤,每压一次缓存都要重写
让它把长输出写进文件,用看头尾、搜关键词的方式取,别整段倒进对话
长日志交给便宜的模型或者子助手去读,要求它引原文,你抽查引文对不对得上
想直接用现成的也行。SoL-Pi 已经开源,MIT 许可,挂在英伟达研究部门的 GitHub 账号 NVlabs 下。它是装在原版 Pi 之上的一个独立扩展,不改 Pi 的源码,装好 Pi 之后一条命令就能装上:pi install git:github.com/NVlabs/SoL-Pi。
SoL-Pi 的开源仓库,9 月 2 日建库,MIT 许可。来源:GitHub 项目卡片
仓库说明里有两个细节,比安装命令更值得看。
四个机制默认全部关闭,要在配置文件里一个个打开。说明里推荐的"保守配置"只开了动作合并和大件入库,理由是这两个不额外调用模型,也不会打断正在跑的任务;在线压缩和证据小票默认关着。对照前面那张表:省钱出力最大、在 GPT-5.6 Sol 上掉分也最多的,正是被留在保守配置之外的在线压缩。作者给用户的默认建议,和我从表 4 里读出来的是一个意思。
另一个细节是安全。证据小票会把日志内容发给你配置的那个小模型,说明里明确提醒:必须留在本地的日志,不要开这一项。大件入库和证据小票存在本地的存档,会话结束后也不会自动删除。
如果你在做智能体产品,值得抄的是另外几样。先装流量表,把新输入、缓存读、缓存写、输出四类分开记账,没有这张表,优化全是瞎猜。动手优化之前先把"能力最多允许掉多少"写死。再留一套永远不拿来调参的期末考题。
我以前说过一句话:AI 目前能做的是省钱,不是赚钱。
这篇论文把这句话往前推了一步。连"怎么省钱"这件事,也开始交给 AI 自己去研究了。它这一轮研究出来的是常识,还掉了几分。可它是自己量出来的,而且量的过程没法作弊。下一轮它会量得更宽。
参考来源
Haozhe Liu, Tian Ye 等 14 人. SoL-Pi: Recursively Scaling Auto-Research Loops for Efficient Agent Harness. arXiv:2609.20519,2026 年 9 月 17 日。英伟达、南洋理工大学、MIT。文中流量、费用、分数均据该论文表 1 至表 4;占比、倍数、每小时节省额的推导为本文据表内数字计算。论文注明费用按 2026 年 8 月 17 日的接口价格计。
NVIDIA Research. SoL-Pi 官方博客(nvlabs.github.io/SoL-Pi):人机分工、单线搜索陷入局部、约四十分之一的存活率、掉分累加的解释、11 题双臂对照,均据此文。
NVlabs. SoL-Pi 开源仓库说明(github.com/NVlabs/SoL-Pi):安装方式、保守配置、存储与安全说明,取自 2026 年 9 月 20 日。
Yike Wang 等. Rethinking the Evaluation of Harness Evolution for Agents. arXiv:2607.12227,2026 年 7 月 14 日。
Yoonho Lee 等. Meta-Harness: End-to-End Optimization of Model Harnesses. arXiv:2603.28052;Jiahang Lin 等. Agentic Harness Engineering. arXiv:2604.25850;Hyunin Lee 等. Recursive Harness Self-Improvement. arXiv:2607.15524。
Leo Gao, John Schulman, Jacob Hilton. Scaling Laws for Reward Model Overoptimization. 国际机器学习大会(ICML)2023。SoL-Pi 论文引它作为"搜索反馈与最终评估必须分开"的依据。
ByteDance Seed. EdgeBench 项目说明(github.com/ByteDance-Seed/EdgeBench):134 题、公开 51 题、标准时长每题 12 小时以上。
Earendil Works. Pi 项目主页(github.com/earendil-works/pi),星标数取自 2026 年 9 月 20 日。
Anthropic. original_performance_takehome 项目说明(github.com/anthropics/original_performance_takehome):各模型成绩与"首日低于 1300 周期的提交均无效"的说明。
Anthropic. Prompt Caching 计价文档(platform.claude.com):缓存写入为基础输入价的 1.25 倍(5 分钟)或 2 倍(1 小时),缓存读取为 0.1 倍。
Andrej Karpathy. autoresearch(github.com/karpathy/autoresearch);Anthropic. Claude Code ralph-wiggum 插件。