ARTICLE · 1056581
企业知识库内容与数据工程实战 07|PDF、扫描件与图片解析,如何保住版面、页码与阅读顺序
1. 每个字都识别对了,答案为什么仍然错
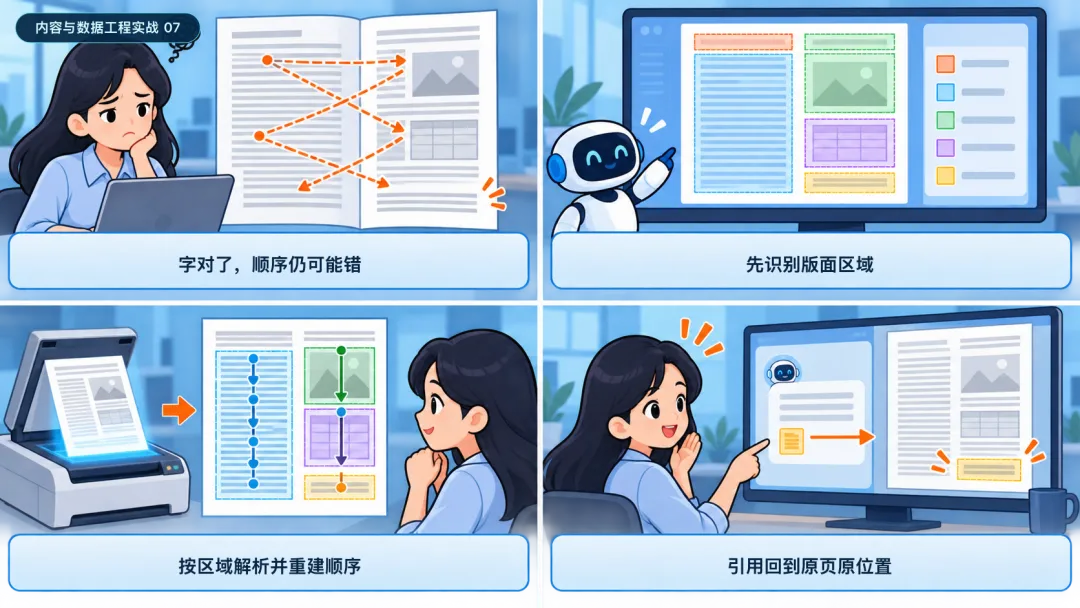
一份双栏制度经过 OCR 后,单字识别看起来几乎没有问题,问答系统却把左栏第二条与右栏第一条拼成了一句话。另一份费用标准中,脚注“仅适用于海外项目”被放到了正文末尾,模型据此给所有员工返回了同一个额度。
这类问题很难从纯文本中发现。字符可能是对的,阅读顺序、层级、表格关系和页内位置却已经损坏。后续切分、向量化和重排只能在错误结构上继续计算,模型越流畅,错误越像真的。
文档解析的目标因此不是“拿到文字”,而是恢复一份可定位、可验证的结构表示。
2. PDF 不是一种统一的数据结构
企业里的 PDF 至少可以分成四类:带可靠文本层的电子 PDF、文字与图片混排的版式文档、只有页面图像的扫描件,以及文本层损坏或与页面图像不一致的混合文件。
不同类型需要不同路线。电子 PDF 应优先读取文本层;扫描件需要 OCR;复杂版式要先识别区域和阅读顺序;表格、公式、脚注、页眉页脚还需要专门恢复。对所有 PDF 一律运行 OCR,不仅成本高,还可能用识别误差覆盖原本正确的文本层。
3. 理论依据:版面结构是内容的一部分
DocLayNet 将标题、正文、列表、表格、图片、页眉页脚等作为独立布局类别,说明文档理解不只是字符识别。OmniDocBench 则把文本、表格、公式、阅读顺序和 OCR 分开评估。这些研究不能直接代表企业文件准确率,但给出了一条重要工程原则:不同错误维度必须分别测量。
W3C Web Annotation 提供了用页码、文本位置和区域坐标定位内容的通用思路。对知识库而言,定位信息不是展示附件时才需要的附属字段,而是引用、人工复核和纠错的共同接口。如果一个答案只能回到整份 PDF,不能回到第几页、哪个区域,它就缺少可核验的证据。
4. 建立四层文档表示
建议不要直接从 PDF 生成段落文本,而是保留四层对象。
第一层是原始页面:原件、页数、页面尺寸和页面图像。第二层是布局区域:标题、正文、列表、表格、图片、公式、脚注等区域及其坐标。第三层是内容对象:文本行、词、表格单元格、公式表达和图片说明。第四层才是面向检索的知识单元,它引用前面三层,而不是复制一份失去位置的字符串。
一个文本块至少应带有:
{ "page": 12, "bbox": [86, 142, 914, 386], "block_type": "paragraph", "reading_order": 27, "parent_heading": "第五章 费用标准", "text_source": "native_text", "confidence": 0.99}扫描件还应记录 OCR 引擎、语言、置信度和对应页面图像;表格区域则引用独立的表结构,不应塞回普通段落。
5. 一条可靠的解析路线
第一步:判断文本层是否可用
不要以“能抽出几个字符”为标准。要同时检查字符覆盖率、乱码比例、字符与页面区域的对应关系,以及抽取顺序是否合理。文本层质量不足时才进入 OCR 路由。
第二步:做页面级布局检测
识别多栏、标题、列表、表格、图片、脚注和页眉页脚。版面模板稳定的制度和报表,可以增加规则校正;模板多变时,应保留模型置信度并抽样复核。
第三步:按区域处理
正文区域做文本提取或 OCR,表格进入结构恢复,公式保留图像和表达,图片至少保留区域与附近说明。区域级处理比全页 OCR 更容易设置不同阈值,也便于失败后局部重跑。
第四步:重建阅读顺序
阅读顺序不能简单按纵坐标排序。双栏、侧边栏、浮动图注和跨页表格都需要结合列结构、标题层级和邻接关系。建议把顺序保存为显式序号或有向关系,便于人工修正。
第五步:生成可回指的知识单元
知识单元应绑定页码、区域坐标、父级标题和解析版本。用户查看引用时,系统能够打开原页并高亮对应区域;解析修复后,也可以找到受影响的单元重新发布。
6. 不要用一个平均分掩盖结构错误
字符错误率低,不代表阅读顺序正确;表格单元格准确,不代表表头继承正确;段落召回高,也不代表脚注没有被拆散。
建议把验收拆成五组:
• 文本:字符或词错误、乱码、缺失和重复; • 版面:区域类别、边界框和标题层级; • 顺序:多栏、列表、图注、脚注和跨页内容; • 专项对象:表格、公式、印章、手写和低清页面; • 引用:页码、区域高亮和原件回指是否成功。
高风险制度不能只看平均指标。应单独构造“否定词”“金额”“日期”“适用范围”“脚注例外”等反例集,因为这些小区域一旦丢失,业务影响可能远大于一整段普通正文。
7. 解析失败后如何处置
低置信度结果不应静默进入索引。可采用三种状态:可发布、需人工复核、隔离。人工修正时,不要直接改最终文本,而应保留原识别结果、修订内容、修订人和原因,并把样本加入回归集。
当解析器升级时,只重跑受影响的页面或区域,生成新的派生版本;旧结果保留用于审计,但不继续对外服务。这样才能解释“某条答案过去为什么引用了错误文本”,也能控制批量回放的成本。
8. 如何验收
正式上线前,至少准备电子 PDF、双栏论文、扫描制度、传真、低清图片、复杂表格、脚注、印章遮挡和跨页列表等样本。每类样本分别记录文本、布局、顺序和引用结果。
验收时需要回答:页数是否一致;标题层级是否完整;双栏是否串行;脚注是否绑定正文;表格是否保留行列关系;OCR 低置信度是否进入复核;答案引用能否准确打开原页区域;解析器升级后结果能否回放比较。
公开基准适合比较方法,不适合直接设定企业上线阈值。阈值应基于本组织 100—300 份代表性对象建立,再按高风险文档单独提高门槛。
9. 小结
PDF 解析最危险的误区,是把“字符抽出来了”当作完成。真正可用的结果必须同时保住页面、版面、阅读顺序和证据定位。
可迁移的原则是:先判断文本层,再做布局和区域处理,最后派生检索单元;任何一步都能回到原页。不同组织需要调整的是文档类型、专项对象和人工复核阈值。
主要参考资料
• Apache Tika PDF Parser Configuration:https://tika.apache.org/docs/4.0.x/configuration/parsers/pdf-parser.html • DocLayNet:https://arxiv.org/abs/2206.01062 • OmniDocBench(CVPR 2025):https://openaccess.thecvf.com/content/CVPR2025/papers/Ouyang\_OmniDocBench\_Benchmarking\_Diverse\_PDF\_Document\_Parsing\_with\_Comprehensive\_Annotations\_CVPR\_2025\_paper.pdf • W3C Web Annotation Data Model:https://www.w3.org/TR/annotation-model/ • Human-in-the-Loop Document Layout Analysis:https://arxiv.org/abs/2108.02095