ARTICLE · 1091254
每周一份数据集:AI 教学软件进了农村课堂,数学成绩真的提高了吗?8,634 名学生,3个年级,105所学校
2026 年 9 月 25 日,一份中国农村教育实验的复现包公开在哈佛大学 Dataverse 上:8,766 条学生记录、875 个变量、1,091 行 Stata 分析脚本,许可为 CC0。实验把每所学校的四、五、六年级各一个班随机分到三种状态——不上机的对照班、用普通上机学习软件的班、用带个性化推荐的 AI 学习软件的班。
要判断“AI 版软件有没有用”,只看三组平均分并不够。这份数据同时记录了每个学生在平台上的停留时间,而后者可能比成绩差异更能解释结果。本文要核验的是:软件效果和实际使用量,能不能在这批数据里分开。
数据从哪里来
数据存放在哈佛大学 Dataverse 的 Yue Ma Dataverse 下,版本号为 V1,发布时间标注为 2026 年 9 月 25 日。页面同时给出了 DOI、许可证、关联论文出处和文件清单,重放这份分析所需的三份文件都在同一条记录里。
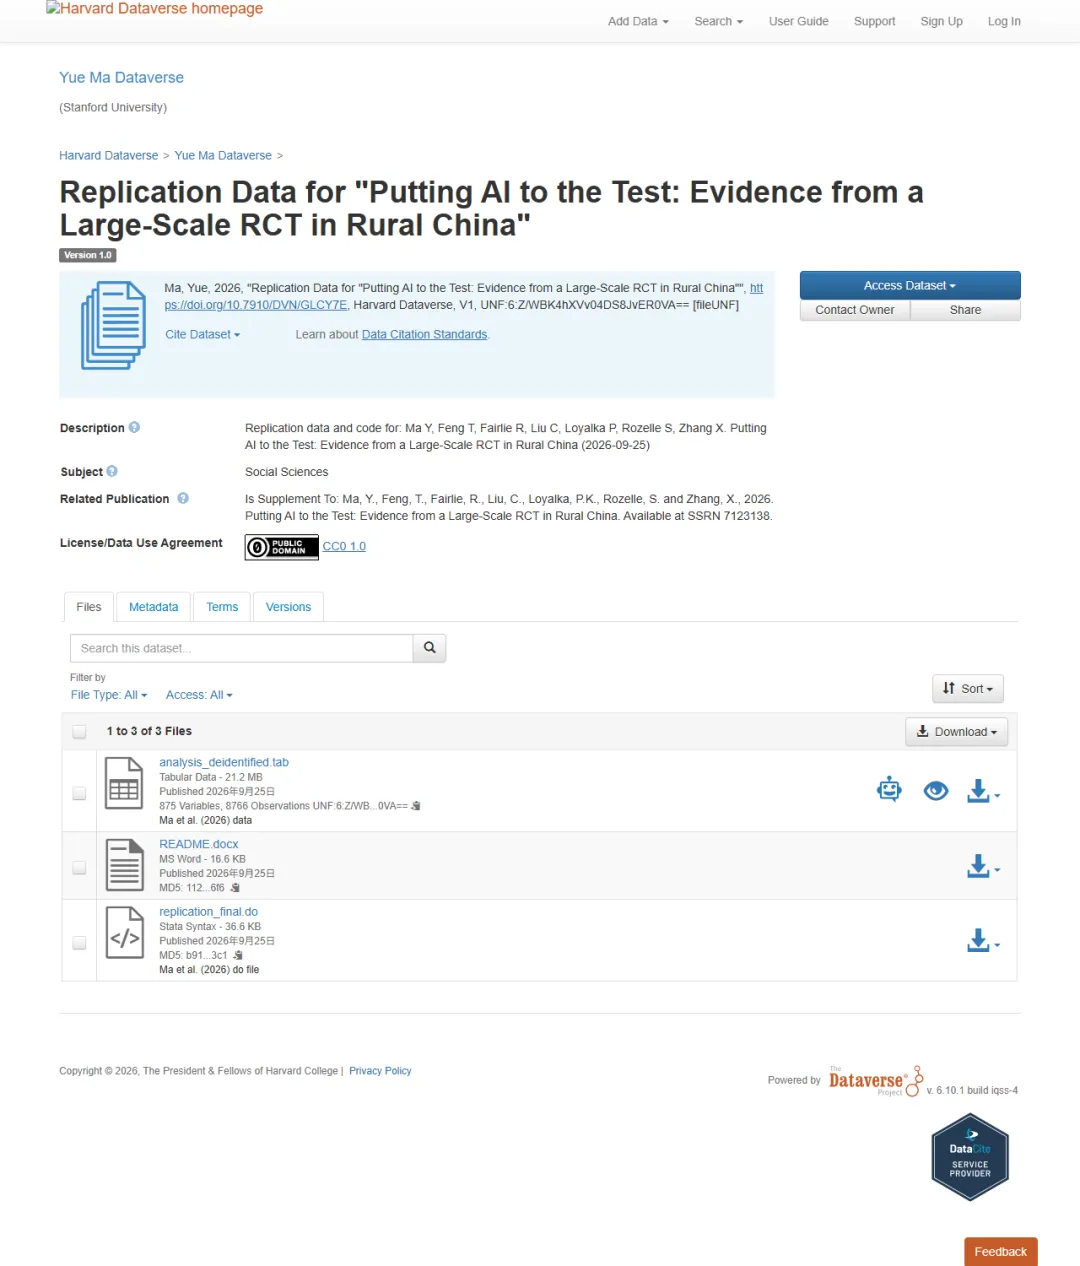
图 1 数据集发布页局部,显示标题、存入机构、版本号、许可证、关联论文与文件清单。来源:Ma, Y. 等,Replication Data for "Putting AI to the Test: Evidence from a Large-Scale RCT in Rural China",Harvard Dataverse,V1,2026-09-25 发布,DOI 10.7910/DVN/GLCY7E;2026-09-28 访问。图片仅作页面截图,未改动任何信息。
treatment 与结局字段 z_end_score | |||
表 1 三个文件的入口与用途。数据来源:Ma, Y. 等,Harvard Dataverse,V1,DOI 10.7910/DVN/GLCY7E;
文件的打开门槛不高,三个文件加起来不到 22 MB,用 Python 或 Stata 都能直接读。真正需要先花时间核对的是字段口径:treatment 的三种取值分别代表哪一组,z_end_score 是如何标准化的,平台日志的时间字段用的是秒还是分钟。这三件事在 README 和脚本里都能查到。
数据访问方式有三种:从发布页点选下载;用 Dataverse 的数据访问接口按文件 ID 直接取;或通过 DOI 引用后由机构库自动抓取。许可为 CC0 1.0,可自由下载、再分发与再分析,署名不是强制要求,按学术惯例引用 DOI 与配套论文即可。
315 个班级单位是怎样分组的
实验的随机化单位是班级,共 315 个,来自 105 所学校;每所学校各有一个四年级班、一个五年级班和一个六年级班。这 315 个单位被放进 51 个随机化分层,每个分层内三组数量相同,最后纯对照组、AI 组(AI-CAL)、普通 CAL 组各得到 105 个单位。班级规模平均 27.5 人,中位数 28 人。
原始文件长什么样,下面这张摘录可以直接看到。每组取 3 名学生的真实记录,字段名与数值都按原样保留:treatment 为 0、1、2 分别对应三个组,z_bs_stu_score 与 z_end_score 是按年级标准化后的基线和期末成绩,两个时间字段的单位是秒,空单元格表示该组没有这项日志。
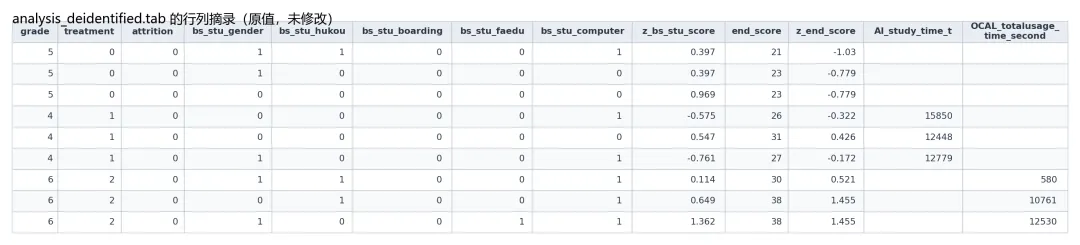
图 2 原始文件 analysis_deidentified.tab 的行列摘录,每组各取 3 条记录。来源:Ma, Y. 等,Harvard Dataverse,V1,2026-09-25 发布,DOI 10.7910/DVN/GLCY7E,2026-09-28 访问并读取;按原始单元格数值渲染,未做四舍五入、替换或补值,空单元格保持空白。图中未显示行号与匿名 ID。
8,647 名学生带有分组标识,其余 119 条记录没有分组,对应后加入或未进入主分析的学生。主分析使用 8,634 名有期末数学成绩的学生:对照组 2,821 人、AI 组 2,835 人、普通 CAL 组 2,991 人。
表 2 三组的设计与基线特征。数据来源:Ma, Y. 等,Harvard Dataverse,V1,DOI 10.7910/DVN/GLCY7E,2026-09-28 访问;作者按原始数据计算。“被标记流失比例”取数据中 attrition 标记非零的比例,“期末成绩缺失比例”按期末数学成绩缺失计算,两者口径不同。
三组的基线特征相当接近:性别比例都在 50% 上下,父亲上过高中的比例相差不到 3 个百分点,家里有电脑的比例相差约 3 个百分点,基线数学标准化成绩的组间差异在 0.007 个标准差以内。这种平衡是随机化成功的一个证据,也意味着后面的成绩差异不太可能由“哪一组的学生本来就更强”来解释。
基线和期末用的是两份不同的试卷:基线满分 35 分,均分 25.43、标准差 5.43;期末满分 45 分,均分 27.64、标准差 7.94。两份卷子不能直接比分数,所以下面的结果全部换算成“以对照组为基准、按年级标准化”的标准差单位。1 个标准差大致相当于年级内部成绩位次的一次明显移动。
三组平均成绩的差异都与零无法区分
按仓库里 do 文件的设定重算——控制随机化分层的固定效应、加入学生年龄、性别、父母学历、家里有无电脑、基线成绩、数学焦虑和内在动机等协变量、按学校-年级聚类稳健标准误——三组之间的平均成绩差异都落在零附近。
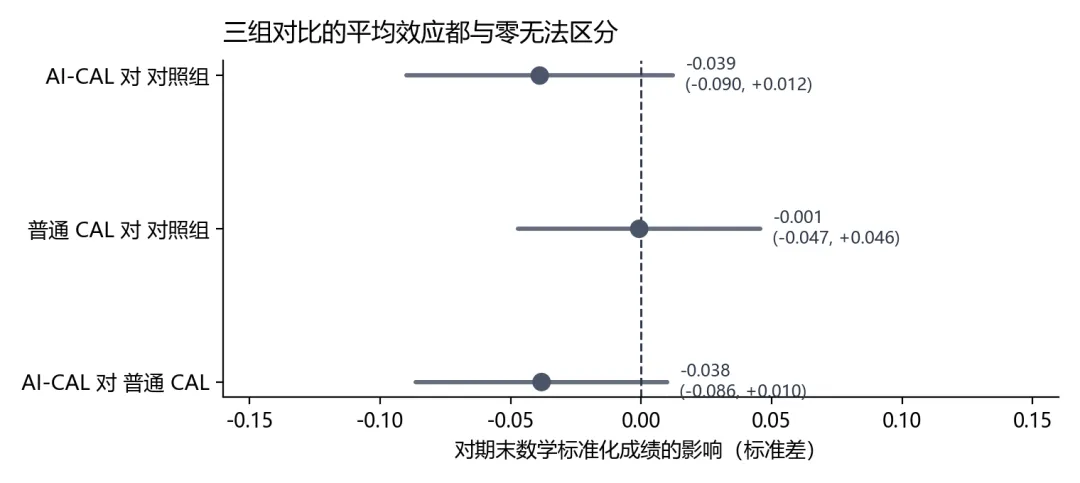
图 3 随机分配对期末数学标准化成绩的平均效应(标准差)与 95% 置信区间。数据来源:Ma, Y. 等,Harvard Dataverse v1.0,DOI 10.7910/DVN/GLCY7E,获取日期 2026-09-28;作者按仓库 do 文件设定,用分层固定效应回归与学校-年级聚类稳健标准误计算;样本 8,634 人。
AI 组比纯对照组低 0.039 个标准差,置信区间是 −0.090 到 +0.012;普通 CAL 组比对照组低 0.001 个标准差,区间是 −0.047 到 +0.046;AI 组比普通 CAL 组低 0.038 个标准差,区间是 −0.086 到 +0.010。三个对比的置信区间都跨过零,在 5% 水平上都不显著。
按随机分配估计的这种平均效应,通常叫意向性治疗效应(ITT)。它回答的是“把学生分到这一组”带来的变化,衡量的是政策如果照这个方式推开能拿到什么结果。它与“实际使用量增加一单位带来多少变化”是两种不同的估计,Athey 和 Imbens 在政策评估方法综述里对这种区分有系统讨论。这组数字说明的是:在这样一次推广里,AI 版本和普通版本都没能带来可检出的平均提升。
这里最容易犯的错误,是把“平均效应不显著”读成“AI 教学无效”。ITT 为零可以来自很多种情况,其中一种与本数据高度相关:学生实际用得太少。
学生一共只用了两个多小时
平台日志给出了每个学生真正停留在学习系统里的时间。把 AI 组和普通 CAL 组的日志换算成小时,结果比成绩更值得看。
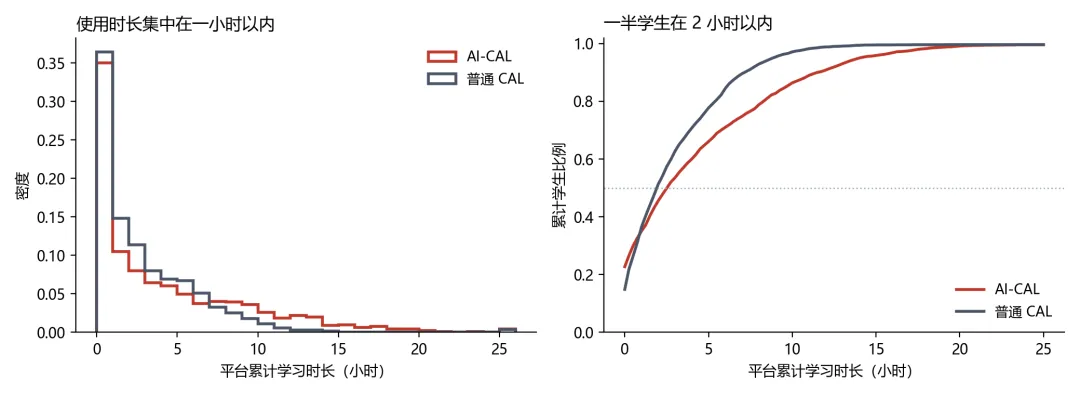
图 4 平台累计学习时长的分布(左:密度分布,超过 25 小时的部分已合并;右:累计分布)。数据来源:Ma, Y. 等,Harvard Dataverse v1.0,DOI 10.7910/DVN/GLCY7E,获取日期 2026-09-28;AI 组取 AI_study_time_t,普通 CAL 组取 OCAL_totalusage_time_second,单位为秒换算为小时,日志缺失按仓库 do 文件的做法记为 0 小时;作者计算。AI-CAL 组均值 4.36 小时、中位数 2.51 小时、第 90 百分位 11.49 小时;普通 CAL 组对应为 3.02、1.90 和 7.15 小时。
AI 组学生人均累计学习 4.36 小时,中位数 2.51 小时。有 35.1% 的学生在整个项目期间的学习时长不足 1 小时,66.1% 不足 5 小时。普通 CAL 组的时间更少,人均 3.02 小时,中位数 1.90 小时。作为对照,AI 组的平均时间比普通 CAL 组高约 44%,方向符合预期:AI 版本确实让学生多停留了一段时间。
把设计和用量放在一起,这项实验实际比较的是“整个项目期间大约 1 小时到 4 小时的软件使用”所能带来的效果。这个剂量与市面上关于 AI 辅导的宣传口径之间,存在一个需要正视的落差。它同时解释了一个现象:如果软件效果真的存在,那么在一半学生用了不到 2 小时的情况下,把它识别出来的统计功效也会很低。
同一研究脉络里,剂量问题早就出现过。Lai 等人在青海少数民族学校做的随机实验《更多并不总是更好》:
https://www.tandfonline.com/doi/full/10.1080/19439342.2016.1220412
讨论的就是增加计算机辅助学习的投入强度未必换来更好结果。本数据无法区分“用得少所以看不出效果”和“软件本身没有效果”,因为在这批数据里,用量本身就没有形成可比较的高剂量组。
平均为零掩盖了方向相反的子群
把学生按基线数学成绩分成低、中、高三组,再分别估计处理效应,得到的不是三个接近零的数字。
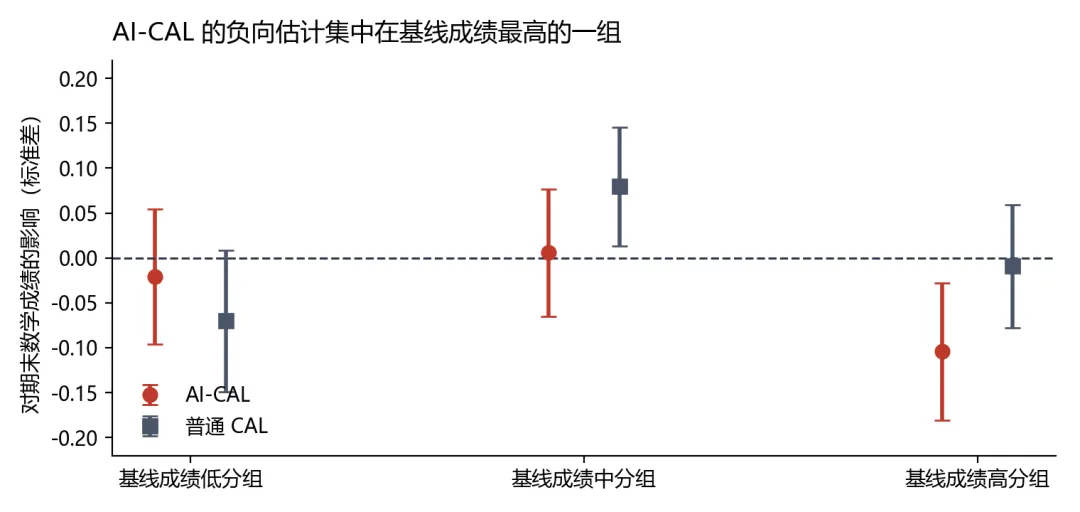
图 5 按基线数学成绩三分位分组的处理效应(标准差)与 95% 置信区间。数据来源:Ma, Y. 等,Harvard Dataverse v1.0,DOI 10.7910/DVN/GLCY7E,获取日期 2026-09-28;作者计算,分层固定效应、按学校-年级聚类。低分组 2,910 人、中分组 3,094 人、高分组 2,630 人。
基线成绩最高的那一组里,AI 组的效应估计是 −0.104 个标准差,置信区间 −0.181 到 −0.028,不跨零;同一组的普通 CAL 组是 −0.009 个标准差,与零几乎没有差别。中分组里,普通 CAL 组是 +0.080 个标准差,区间 +0.013 到 +0.146;AI 组是 +0.006。低分组里,AI 组是 −0.021,普通 CAL 组是 −0.070,两者都不显著。
若把这张图单独拿来看,很容易得出“AI 对成绩好的学生有害”的结论。这个结论目前站不住。理由有三个:一是实验预设的异质性维度不止基准成绩一项,还包括性别、家庭财富和计算机拥有情况,四类子群共产生几十个比较,单个子群在 5% 水平上的显著性需要多重比较校正后才可靠;二是高分组的点估计虽然显著,但区间宽,对模型设定敏感;三是本数据没有过程性证据解释为什么高分学生用 AI 反而更差。
值得保留的部分是方向本身:三个子群的方向并不一致,中分组里普通 CAL 组的表现甚至好于 AI 组。把它当成“需要后续验证的线索”比当成结论稳妥。
这份结果放在既有证据里是什么位置
计算机辅助学习在中国农村不是一个新问题。Mo 等人在陕西农村学校做过把计算机辅助学习整合进常规课程的随机实验https://www.tandfonline.com/doi/abs/10.1080/19439342.2014.911770,Lai 等人在青海做过同类实验,更早的 Ma 等人对智能辅导系统与学习结果的元分析也汇集了多年研究https://psycnet.apa.org/doiLanding?doi=10.1037/a0037123。这条线索上的一致经验是:效果高度依赖实施方式、使用时长和软件与课程的配合程度,很少出现“装上软件就提分”的情形。
同一时期,生成式 AI 进入课堂的证据也在分化。Kestin 等人在大学物理课上做的随机对照研究(预印本,2024)https://www.researchsquare.com/article/rs-4243877/v1报告,使用 AI 辅导的学生在更短时间内学到两倍以上的内容,参与度和学习动机也更高。而另一份标题为《生成式 AI 可能损害学习》https://papers.ssrn.com/sol3/papers.cfm?abstract_id=4895486的工作论文(Bastani 等,SSRN 工作论文,2024)则提出了相反方向的警告。本文只核对了两者的书目信息,没有复现其内部数字;它们并列存在的价值在于说明学界对“AI 辅导是否提高成绩”远未形成共识。
两份研究的场景与本次实验差别明显:Kestin 的实验在大学课堂、由研究团队直接组织使用;Bastani 的实验在高中,学生练习时可以随时调用生成式模型。本次实验的现场是农村小学和中年级课堂,软件使用被嵌进日常教学,实际用时由学校安排决定。把不同场景的结论直接搬过来,都会失真。
政策已经把 AI 推向农村课堂
这项数据发布的时间点,正好落在政策密集推进的区间内。2025 年 8 月,国务院印发《关于深入实施“人工智能+”行动的意见》(国发〔2025〕11 号),要求把人工智能融入教育教学全要素、全过程,创新人机协同的教学模式,推动大规模因材施教。
2026 年 4 月,教育部等五部门印发《“人工智能+教育”行动计划》(教科信〔2026〕1 号),提出到 2030 年形成人工智能与教育深度融合格局,并要求支持农村、边远地区学校利用国家平台开好人工智能课程,推动智能技术在中西部地区和乡村学校的应用,促进教育优质均衡。
同一份文件里还有一句与本文直接相关:文件要求持续开展人工智能社会实验,科学评估技术对教育的影响。这项农村实验的数据开放,恰好给这种评估提供了一个可以复算的样本。政策文本已经写明了推广方向,而在推广规模扩大之前,把“实际使用剂量”纳入评估口径,可能比再增加一项效果估计更有价值。
这套数据适合谁用
表 3 使用场景与仍需补充的材料。资料来源:本文依据 Harvard Dataverse 公开数据、配套 do 文件与教育部政策文本整理,2026-09-28。
方法与边界
本文的分析对象是 Harvard Dataverse 上公开的 analysis_deidentified.tab(8,766 行 × 875 列)与配套 do 文件。处理组变量 treatment 取值 0、1、2;主结局是 z_end_score,即按年级、以对照组均值和标准差标准化的期末数学成绩。主回归采用分层固定效应并加入协变量,标准误按学校-年级聚类,与 do 文件的设定一致。本文用 Python 复算,没有运行 Stata,个别报告细节(例如原文用 nlcom 后的输出)可能与作者版本存在微小差异。
需要明确的是,本文只使用公开数据自行估计,未取得配套论文全文,因此不对论文的结论、表述或表格作任何转述。上述所有估计都是复现结果。
四项限制会影响解读。数据经过匿名化处理,不含地区、县、学校名称和家庭收入的原始值,因此无法比较地区差异,也无法用收入直接分层。平台日志有缺失,本文按 do 文件的做法把缺失记为 0 小时,这会让“全员平均”低于“有日志记录者平均”,但不改变量级。期末只测了数学一门,没有语文、科学和非认知能力的测量,也没有课堂教学过程的观察记录。最后,数据里没有记录使用的是哪一款软件、底层模型是什么版本,所以结果无法归因到某个具体产品。
配套论文目前是工作论文,尚未见同行评议版本。这也是这份数据在写作时需要保留的一层不确定。
现在可以给出的答案
在这批数据能够支持的范围内,答案是:把 AI 个性化学习软件装进农村课堂之后,期末数学成绩的平均变化在统计上无法与零区分;同期学生实际使用平台的累计时长中位数只有 2.5 小时,超过三分之一的学生不足 1 小时。这两个事实合起来,指向的解释是低使用剂量下的效果不可检出。
最脆弱的推断有两条,需要明确区分:把负向点估计当作“AI 有害”的证据,以及把本次结果当作“AI 教学无效”的证明。前者受多重比较和子群波动影响,后者与用量数据直接冲突。
会改变这一判断的新证据是具体的:一是配套论文通过同行评议并公开完整实施信息,说明学校是如何排课、教师如何组织上机的;二是出现实际使用时长显著更高的同类实验,能让“剂量不足”这个解释得到直接检验;三是期末测验与软件训练目标更对齐的复现研究。在这三类证据出现之前,这次实验能给推广工作留下的最有用提示,是先把“学生到底用了多久”测准。
参考资料
Ma, Y., Feng, T., Fairlie, R., Liu, C., Loyalka, P., Rozelle, S., & Zhang, X.(2026).《Putting AI to the Test: Evidence from a Large-Scale RCT in Rural China》. SSRN 工作论文. https://doi.org/10.2139/ssrn.7123138 Ma, Y. 等(2026).《Replication Data for "Putting AI to the Test: Evidence from a Large-Scale RCT in Rural China"》. Harvard Dataverse, V1. https://doi.org/10.7910/DVN/GLCY7E (获取日期 2026-09-28) 国务院(2025-08-26).《关于深入实施“人工智能+”行动的意见》(国发〔2025〕11 号). https://www.gov.cn/zhengce/zhengceku/202508/content_7037862.htm 教育部、国家发展改革委、工业和信息化部、科技部、国家数据局(2026-04-02 成文).《“人工智能+教育”行动计划》(教科信〔2026〕1 号). https://www.gov.cn/zhengce/zhengceku/202604/content_7065138.htm Mo, D. 等(2014).《Integrating computer-assisted learning into a regular curriculum: evidence from a randomised experiment in rural schools in Shaanxi》. Journal of Development Effectiveness. https://doi.org/10.1080/19439342.2014.911770 Lai, F. 等(2016).《More is not always better: evidence from a randomised experiment of computer-assisted learning in rural minority schools in Qinghai》. Journal of Development Effectiveness. https://doi.org/10.1080/19439342.2016.1220412 Ma, W., Adesope, O. O., Nesbit, J. C., & Liu, Q.(2014).《Intelligent tutoring systems and learning outcomes: A meta-analysis》. Journal of Educational Psychology. https://doi.org/10.1037/a0037123 Kestin, G., Miller, K., Klales, A., Milbourne, T., & Ponti, G.(2024).《AI Tutoring Outperforms Active Learning》. Research Square 预印本. https://doi.org/10.21203/rs.3.rs-4243877/v1 Bastani, H., Bastani, O., Sungu, A., Ge, H., Kabakcı, Ö., & Mariman, R.(2024).《Generative AI Can Harm Learning》. SSRN 工作论文. https://doi.org/10.2139/ssrn.4895486 Athey, S., & Imbens, G. W.(2017).《The State of Applied Econometrics: Causality and Policy Evaluation》. Journal of Economic Perspectives. https://doi.org/10.1257/jep.31.2.3