ARTICLE · 1101276
AI 视频不好看,问题不在模型 ——有人用纯代码写了 39 支电影,全是开源的
先说个有点反直觉的事。
过去一年,所有人都在等同一件事:视频生成模型再强一点,强到能直接出片。
等画质更清晰一点,等时长更长一点,等它能听懂更长的一段话,等它别在第 3 秒把手变成六根手指。
但有个人,绕开了这条路。
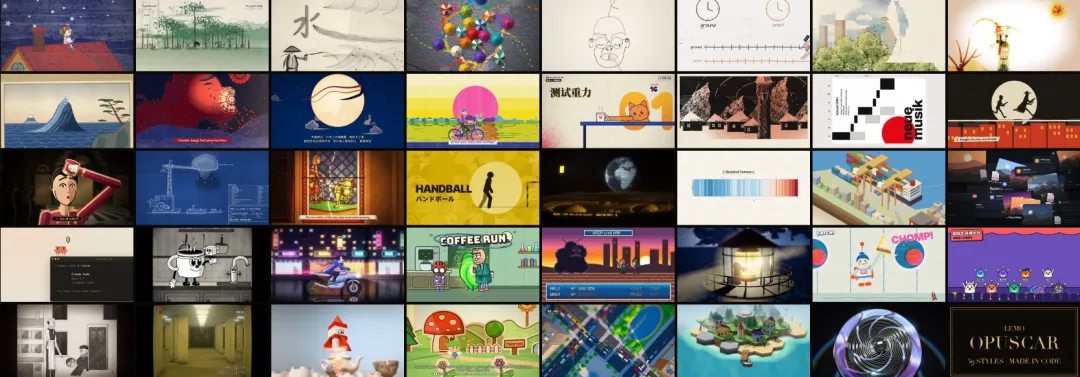
他用 Claude Opus 5.5 前后做了 100 多支视频,最后挑出 39 支开源。这 39 支片子里,没有用过任何视频生成模型,也没有用过任何素材库画面。
每一帧,是 AI 写代码画出来的:Canvas 和 WebGL 页面逐帧渲染;配乐是用免费采样库写的原创曲子;配音走本地 TTS;混音、校对、出片,也是它自己干。
他把整套方法开源成了一个仓库,叫 Lemo-opuscar(Lemo + Opus + car,名字里藏着模型名)。
代码 MIT,文档和成片 CC BY 4.0。
但我觉得,这个仓库最值钱的东西,不是那 39 支片子。
是他在做完 100 支之后,得出的那个结论。👇
一、为什么"纯代码"这条路反而成立
你第一反应可能是:这不是绕远路吗?明明有现成的视频生成模型不用,非要写代码一帧一帧画?
我一开始也这么想。但看完他的做法,我发现这条路解决了视频生成模型三个至今没解决的死穴。
死穴一:不可控
视频生成模型给你的是概率。你抽卡,出来什么算什么。同一个 prompt 跑十次,十次都不一样。
而代码是确定性的。第 12 秒那个角色要从左边走到右边,它就是会走,不会突然长出三条腿,也不会在下一帧换个发型。
对商业交付来说,这个差别是致命的——客户要改一个字,你不可能跟他说"我再抽一次卡试试"。
死穴二:不可复现、不可修改
模型出片是一次性的。你拿到一个 mp4,想改里面的一个细节?重跑。
代码渲染出来的片子,改一行参数就能重渲。风格、色板、节奏、镜头全在代码里,是版本可管理的。这也是为什么他能做 100 多支——因为第 40 支能复用第 20 支的引擎。
死穴三:风格漂移
你让模型"水墨风",它可能给你一幅水墨,也可能给你一幅"看起来像水墨的水彩"。跑 10 秒之后,风格往往就散了。
代码不会。你定义好墨的浓淡、洇开的速率、留白的比例,它就老老实实按这个来,从第 0 帧到第 1500 帧。
那代价是什么
当然有代价,而且不小:
一支片子 agent 要干 30–60 分钟,连续写几千行代码 需要 Node 20+、Chrome、ffmpeg、Python 3.11+ 对模型的长程能力要求极高——它得自己看图、自己听混音、自己返工
所以这不是一条更省事的路,是一条更可控的路。
他自己的判断是:如果你要的是"快速出一堆能看的东西",视频生成模型更合适;如果你要的是"一支能交付、能改、风格从头到尾不塌的片子",代码更合适。
二、39 种风格,到底是什么
这 39 支不是随便凑的,是按 9 大类排的。我把它整理成了一张表,你可以先看看有没有你要的:
| 手绘与绘画 | |
| 东方传统 | |
| 印刷与版画 | |
| 图形与排版 | |
| 信息与发布 | |
| 卡通与动画 | |
| 游戏 | |
| 电影与时代 | |
| 材质与 3D |
注意几个有意思的:白板讲解和活体实机录屏被归在绘画和发布类里——说明这套东西不只是做艺术短片,产品教程、科普、发布会都能用。
蓝图/工程制图那支叫《Patent Pending: The Cloud Catcher》,讲一个发明家的蓝图自己画出一台接云机器,最后"修订云线"变成了真的雨云。这种把专业符号系统玩成叙事的,是纯代码才做得到的。
三、三份文档里,到底写了什么
这是整个项目最核心的部分。他把"怎么拍电影"这件极度依赖经验的事,拆成了三份 Markdown。
DIRECTOR.md | |
TECHNIQUE.md | |
styles/<风格>/STYLE.md |
DIRECTOR.md:六个维度,把"感觉"变成"规则"
最打动我的是它把导演经验拆得极细,而且每一条都是可执行的规则,不是形容词。挑几条:
镜头:每个镜头都要有理由,全片至少 4 种运镜,并且要有一个让人记住的"签名镜头"(一镜到底、尺度揭示、用媒介本身做转场) 编排:转场要在风格里设计,不用默认的淡入淡出——水墨用墨滴洇开,立体书用翻页,剪纸用刀刻 表演:每个动作要有预备、动作、跟随;角色要有情绪变化,不能从头到尾一个表情 声音:画面上每个动作都要有声音,全片至少两处真正的静音,不许用万能的"钢琴 + 弦乐"
"至少两处真正的静音"和"不许用钢琴+弦乐"——这种具体到有点武断的规则,恰恰是 agent 最需要的。你跟它说"要有节奏感",它不知道怎么做;你跟它说"高潮前全场静音 2 秒",它就知道了。
TECHNIQUE.md:把工程流程也写死
逐帧渲染怎么排、配音怎么对轨、配乐怎么写、怎么混音、审片看哪几项——全在里面。
STYLE.md:39 份"风格说明书"
每个风格一份,写清楚这个风格长什么样、听起来什么样,以及样片是怎么做出来的。这是 39 支片能保持水准一致的关键。
四、用法简单到有点离谱
git clone https://github.com/lemomo-ai/lemo-opuscar.gitcd lemo-opuscarclaude
然后直接说人话:
用水彩风格做一支 45 秒的片子,讲我家经营的咖啡园。
它会自己读这三份文档,像一个小工作室一样开工。中途停下来找你两次:一次看故事和分镜,一次看画面。
注意这个设计——两个确认点
第一次停,看故事和分镜。 在这里改方向只要几分钟;等全片渲完再改,要几个小时。
第二次停,看画面。 它会渲 2–3 张风格帧(有角色的话还会附一张角色设定表),并且主动告诉你它最没把握的地方。
第二步这个"主动交代不确定项"的设计很妙——它把"你不知道哪里会有问题"变成了"它告诉你哪里可能有问题"。
这一步,请认真看。
五、它自己是怎么质检的
确认完画面,它就自己往下跑,跑完自己检查。这几条我觉得最值得抄进任何 AI 工作流:
"每 1–2 秒抽一帧拼成缩略图总览"这条特别聪明——让 AI 用看的方式检查自己做的片子,而不是只看代码逻辑。
我看片时最常挑的几类问题是他列的:主体太小、字幕没停够就切走、动作不连贯、有动作没声音。
注意最后一条——"有动作没声音"。这已经不是技术问题,是导演问题了。
六、剩下的是第二件事:需求怎么说
他的原则就一句话:你负责「拍什么」,agent 负责「怎么拍」。
你不需要懂分镜、BPM、景别。但下面六件事说清楚,出片会稳很多。
1️⃣ 主题:拍什么、给谁看、多长
「做一个视频」太空了。「做一支 40 秒的片子,给新用户介绍我们 app 的离线模式」就够了。
三个参数要定:
时长:默认 30–60 秒。短比长稳,第一支强烈建议 30–45 秒 比例:默认横屏 16:9。要发抖音、小红书就说「竖屏 9:16」 语言:就用你说话的语言,字幕会自动烧录
为什么强调"短比长稳"?因为长度是误差的放大器。一支 30 秒的片子,哪怕有一两处瑕疵也不致命;一支 3 分钟的片子,任何一处崩了整段就废了。
2️⃣ 故事:有就给,没有就给方向
有真实故事最好:你的经历、品牌的来历、一个梗、一个数据。
但有一条铁律——事实部分一定要你给。名字、数字、必须出现的产品和标志,agent 编的事实不可靠。它会很自信地给你编一个"成立于 1998 年",而你们公司是 2003 年成立的。
没有故事也没关系,给一个方向就行,比如「温暖一点,结尾有反转」。它会按**「一个主体、一个目标、一次转折」**的结构自己编,开场 3 秒抓人,结尾首尾呼应。
3️⃣ 节奏:快还是慢
这条最容易被忽略,但它决定整支片子的骨架。
在他的流程里,音乐网格先于动画:agent 先写 cue map(速度、小节、每个卡点落在哪一拍),画面再卡到这个网格上。
这个顺序很反直觉——通常我们以为"先有画面,再配音乐"。他反过来了。理由是:音乐是最精确的时间尺。有了网格,画面才知道该在哪一帧动。
所以你说的「快」和「慢」,会直接翻译成三件事:
音乐:快闪卡点可能 140 BPM 以上,抒情片 70–90 BPM 剪辑密度:快片一拍一个动作,慢片一个长镜头走到底 速度变化:好片子不是匀速的。可以直接说「前面慢,中间越来越快,高潮前停一下,结尾留白」
还可以指定旁白:"温暖的女声旁白" / "不要旁白,纯音乐" / "像默片一样只用字幕卡"。
4️⃣ 给一个对标(这条最值钱)
镜头、编排、表演、声音,都是 agent 的活,DIRECTOR.md 里写得很细。
但你能做的最有用的一件事,是给它一个对标:
「节奏参考 Edgar Wright 的剪辑」 「像 60 年代 007 的片头」
关键在于对标只学语法——构图、节奏、镜头、配乐结构——不抄角色和画面。这样既拿到了风格,又避开了版权和同质化。
他的原话是:「在我所有的经验里,对标对质量的提升比任何一条规则都大。」
为什么对标这么管用?因为"好看"是不可描述的,但"像《XX》那样"是可描述的。你给不出形容词,总能给得出一个例子。
这一条我建议你无论如何都填上。 哪怕只是"像苹果发布会的开头"。
5️⃣ 素材:代码画不了的,可以补
这 39 支是纯代码做的,但你的片子不必这么「洁癖」。可以补充:
生图工具:出角色设定、贴图、背景参考,让 agent 照着画或直接用作图层 3D 模型生成工具:生成 glb 模型,放进 three.js 场景里打光、做景深、运镜 你自己的东西:照片、logo、产品截图、一段录音、品牌字体
放进一个文件夹,告诉 agent 路径就行。
唯一要注意的是版权:库里只用 CC0、CC BY、OFL 的素材,每一条都写进 CREDITS。这个习惯值得学——商业交付时,CREDITS 就是你免责的凭据。
6️⃣ 反馈要说具体
成片出来,你说「节奏不太对」没用;说「第 12 秒摔倒太快,看不懂」,好用十倍。
原因在于:抽象的反馈会让 agent 整体重做,具体的反馈只改一处,而且改完不会破坏其他地方。
他看片时最常挑的几类问题,可以直接拿去当检查清单:
主体太小 字幕没停够就切走 动作不连贯 有动作没声音
七、万能模板,直接抄
什么都不会的话,复制这段,填空就行:
用【风格名,比如 watercolor】风格做一支【30–60】秒的片子。主题:【拍什么,给谁看】故事:【有就写:谁、想要什么、发生了什么、结局。没有就写"你来编,要有一个转折"】节奏:【快 / 慢 / 前慢后快】,【旁白:什么声线、什么语言;或者不要旁白】对标:【一两部你喜欢的片子、片头、广告,学它的节奏或镜头】素材:【我放在 assets/ 里的照片、logo、模型;必须出现的名字和数字】画幅:【横屏 16:9 / 竖屏 9:16】先给我看故事和分镜,再给我看画面,我确认后再做全片。
连风格都不知道选哪个,就说这句:
我想做一支关于【……】的片子,帮我从库里挑两三个合适的风格,说说各自怎么拍,其他你定。
提前说明:一支片子 agent 大约要干 30–60 分钟,token 用量不算高,3D 场景比 2D 高很多。需要 Node 20+、Chrome、ffmpeg、Python 3.11+。
八、没有 Opus 5.5 怎么办
他很实诚,这点我挺欣赏的:这 39 支都是 Opus 5.5 做的,风格也是按它调的,其他模型没系统测过,不保证同等效果。
原因讲得很清楚:一支片子要连续写几千行代码、自己看图、自己听混音、自己返工,对模型的长程能力要求很高。这不是"能不能写一段 Canvas 动画"的问题,是"能不能在一小时后还记得第 3 秒那个镜头为什么要这么切"的问题。
但方法本身不绑定模型——三份文档都是普通 Markdown,任何能读 AGENTS.md 的 agent(Codex、Cursor……)都能用。他给了 6 条降级方案:
1. 从样片改,不要从零写
每个风格的 demo/ 里都有完整源码和 build.sh。跑 sh tools/fetch.sh demo <风格> 取回配乐、字体这些输入,就能重建样片。
让 agent 在一个已经能跑的引擎上换故事,比从零搭稳得多。 这是 6 条里我最想强调的一条——它把"创作"变成了"改稿",难度直接降一个量级。
2. 先挑"代码原生"的风格
不是所有风格难度一样。他的排序:
第一支别选 3D。 他明确说了 3D 场景的 token 消耗比 2D 高很多。
3. 缩短、减量
先做 20–30 秒、一个角色、4–6 个镜头。跑通一次完整流程,比憋一个大作品有价值得多。
4. 拆小步,多停几次
方案 → 风格帧 → 单个镜头 → 全片。每一步都让它渲出静帧给你看,别一口气跑到底。
这条其实是通用经验:AI 做长任务失败,八成是因为中间没人拦。
5. 强模型当导演,普通模型干活
导演方案和分镜用最强的模型写,执行交给便宜的模型,审片再切回强模型。
这是我最喜欢的一条——它把"贵"的部分精确控制在真正需要判断力的环节上。
6. 标准可以降,流程别省
声音、自检、两个确认点,这些和模型无关,照做就能少踩很多坑。
这句话我觉得是整篇文章里最实用的一句。模型会换、能力会变,但流程是你唯一能完全掌控的变量。
九、11 支片子,看看能做到什么程度
从 39 支里挑的 11 支,尽量覆盖不同类型。我按"手法有多巧"排一下:
01 瑞士动态排版《Five Rules for a Poster》
内容:一张音乐会海报按瑞士设计的五条规则自己排版,第五条是「只打破一条」。手法:所有元素吸附网格,每次落位都踩在拍子上,像一声打击乐。唯一不守规矩的红色元素成了主角。高潮:结尾揭晓——7 列网格就是 7 个音,16 行就是 16 个八分音符。海报本身就是乐谱。适合:品牌视觉、活动、设计教学
02 钢笔淡彩《Where the Wind Went》
内容:公园只是一张钢笔速写,风把草帽吹到哪里,哪里才有颜色。手法:线条按真实笔顺一笔笔画出来;颜色从一个源头带着水痕洇开,被颜色碰到的人物才开始动。高潮:最后拉远,露出整页速写本,兼作片尾。适合:城市旅行、建筑、生活方式品牌
03 中国水墨《The Swordsman and the River》
内容:侠客踏水过江,一剑断流。手法:六到八成画面是留白,唯一的红色是一方朱印。留白就是江水,一剑劈开露出纸白;墨滴洇开代替转场。高潮:高潮前全场静音,一笔飞白横扫整个画面。适合:武侠、文化品牌、诗词
04 皮影戏《Hou Yi Shoots the Suns》
内容:十日炙烤大地,后羿张弓射日。手法:幕布后一盏油灯,染色驴皮刻成的影人透着光,关节铆钉清晰可见。每个太阳就是幕后的一盏灯——每射下一个,画面就真的暗一档。高潮:高潮后绕到幕后,露出灯、艺人的手和竹签。适合:神话民俗、非遗、节日
05 60 年代间谍片头《The Velvet Cipher》
内容:虚构 1964 年间谍片的片头,追一把被偷的钥匙。手法:Saul Bass 时代的语言——平涂纸色、手剪边缘、剪影人物。演职员表就是布景,主角躲在字母 I 后面、在单词之间跳车。图形匹配剪辑(车轮 → 轮盘 → 瞳孔 → 月亮 → 锁孔)卡在铜管上,越追切得越快。适合:片头、活动开场、预告片
06 白板讲解《Einstein in Your Pocket》
内容:手机怎么知道你在哪:GPS、原子钟,和相对论每天多出的 38 微秒。手法:一块真实的白板,马克笔自己飘着写,墨水在落笔处积墨,还有擦不干净的旧笔迹。公式按笔顺一项项写出来,正好对上旁白说到的那个词;一台摄影机跟着笔走到底,不剪辑。适合:知识科普、网课、产品原理
07 活体实机录屏《Clawd Moves In》
内容:像素小人 Clawd 跳出终端、搬进 Claude 应用,演示 Plan 模式、diff 评论和自检。手法:看起来像真实产品的录屏,但每个窗口、菜单、按钮都是代码重画的。小人只站在真实界面元素的上沿,位置每帧从页面实测;它的每个动作都触发一次真实的界面变化。适合:产品教程、功能发布、新手引导
08 象形运动图形《Aichi-Nagoya 2026 — All 43 Sports》
内容:2026 亚运会 43 个大项,几何象形人卡着节拍快闪。手法:150 BPM 太鼓电子配乐,70 张运动卡一拍一个动作;同一个速度里切出一拍两张的快板,多出一种快慢;最大的章节用一个横移长镜头拍完。高潮:所有图标拼成一面墙,收成一轮太阳。适合:体育赛事、视觉识别、活动开场
09 HD-2D《The Lampbearer》
内容:灯塔熄灭,孙女提着最后一簇火穿过夜林、爬上风暴悬崖。手法:3D 微缩场景贴像素材质,2D 像素角色站在里面。角色保持低帧率像素,摄影机、光、粒子、焦点每帧平滑运动——两种时间感并存。细节:她提着的灯既是主光源也是情绪计量表,灯一亮影子就被拉长。适合:游戏预告、奇幻、剧情短片
10 纸片立体书《Pip's Paper Adventure》
内容:立体书在书桌上打开,小精灵 Pip 在纸片世界冒险,最后跳出书外。手法:一帧里两个世界——照片级的真实书桌和台灯,书里是平涂、描边的剪纸卡通。真实灯光和微距景深照在纸片上,纸片投下剪影形状的影子;翻页就是转场。高潮:故事里"又亮起的一盏灯",最后揭晓是读者的台灯。适合:儿童绘本、游戏预告、剧情短片
11 科幻情景喜剧卡通《Coffee Run》
内容:厌世天才开传送门只想买杯咖啡,却穿过越来越离谱的平行宇宙。手法:用天大的科幻手段办一件鸡毛小事。每穿一次门,整个宇宙的配色、音乐动机、生物都换一套,全片只有传送门会发光。节奏:三段式越跳越快,最后一秒一个宇宙地连跳;每个离谱画面后面都跟一个反应特写——笑点在脸上,不在怪物身上;结尾两秒以上彻底静音,再抖包袱。适合:喜剧、科技品牌、社媒短片
看完这 11 支你会发现一件事:它们不是「AI 味的视频」,是有导演的视频。
每一支都有一个"只有想明白了才做得出"的设计:海报就是乐谱、太阳就是灯、灯就是情绪计量表、笑点在脸上不在怪物身上。
这些不是模型生成的,是方法推导出来的。
最后
我喜欢这个项目的点,不在于它证明了 AI 能把水墨画得多像。
而在于它把一件一直很玄学的事——「怎么让 AI 稳定产出好东西」——拆成了三份 Markdown、两个确认点、一个万能模板。
我们这一年讨论 AI,大部分时间都在讨论模型能力:谁的参数多、谁的上下文长、谁的榜单分高。
但真正卡住我们的,往往是另一件事:你有没有一套方法,能把模型的能力稳定地兑现出来。
同样一个模型,有人用它做出 39 支能看的片子,有人用它做出 39 段谁都不想看的东西。差别不在模型,在方法。
AI 的瓶颈,正在从「能不能生成」,转向「有没有方法」。
而方法这件事,恰好是我们唯一能从别人那里直接抄走的。
🔗 39 支片都在图鉴里,可以直接看:https://lemomo-ai.github.io/lemo-opuscar
🔗 仓库:https://github.com/lemomo-ai/lemo-opuscar
⚖️ 协议:代码 MIT,文档/风格/成片 CC BY 4.0,署名即可使用
如果你用它做出了自己的片子,欢迎发出来 @ 我,我也很想看。
你们觉得呢?纯代码逐帧渲染这条路,会不会比等视频模型变强更快到终点? 评论区聊聊 👇
关注我,了解更多最新AI知识~