ARTICLE · 1151715
Langfuse 实战:看清 AI Agent 的每一次模型请求和工具调用
给 AI 助手接入工具以后,我们终于可以问它:
查询订单1001的物流。
它选择物流技能,调用工具,读取数据库,再告诉我们订单正在运输中。
流程跑通了,但新的问题随之出现:
如果它答错了,我们应该从哪里查起?
是路由选错了技能?模型传错了订单号?工具没有查到数据?还是数据库明明返回了“运输中”,模型却说成“已签收”?
只看最后一句回答,很难分清。
这一篇,我们给之前的 Router + Skill 订单助手接入 Langfuse,把一次查询的执行过程记录下来。
传统接口通常有较明确的输入、处理逻辑和输出。Agent 则可能在一个请求里多次调用模型,选择工具,再根据工具结果决定下一步。
我们项目的一次物流查询,可以拆成:
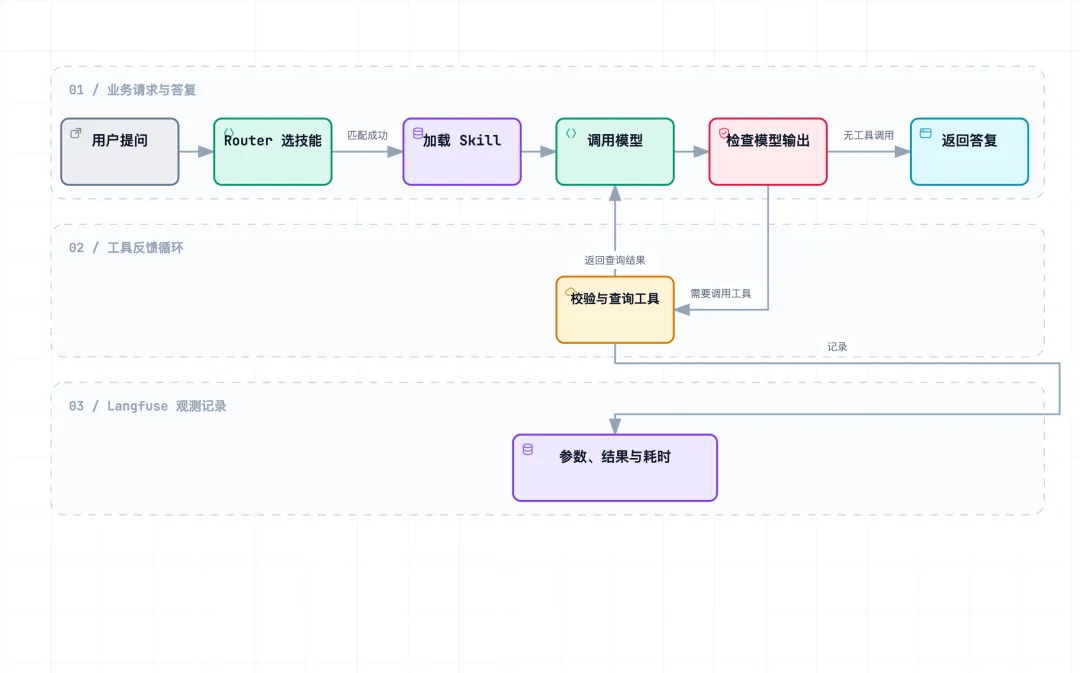
其中任何一层出错,最后都可能表现为“回答不对”。
终端里的 print 对起步调试很有帮助。但当我们开始处理连续追问、多次工具调用和不同用户的会话时,还需要把这些记录关联起来:哪几步属于同一次请求?哪个数据库查询是哪个工具触发的?哪次模型请求耗时最多?
Langfuse 帮助我们把分散的执行记录组织成可以查看、比较和排查的调用过程。
它能提供排查证据;答案是否正确,仍需要结合业务事实和评测标准判断。
接入之前,先认识 Trace、Observation 和 Session。Langfuse 数据模型文档介绍了它们的关联方式。
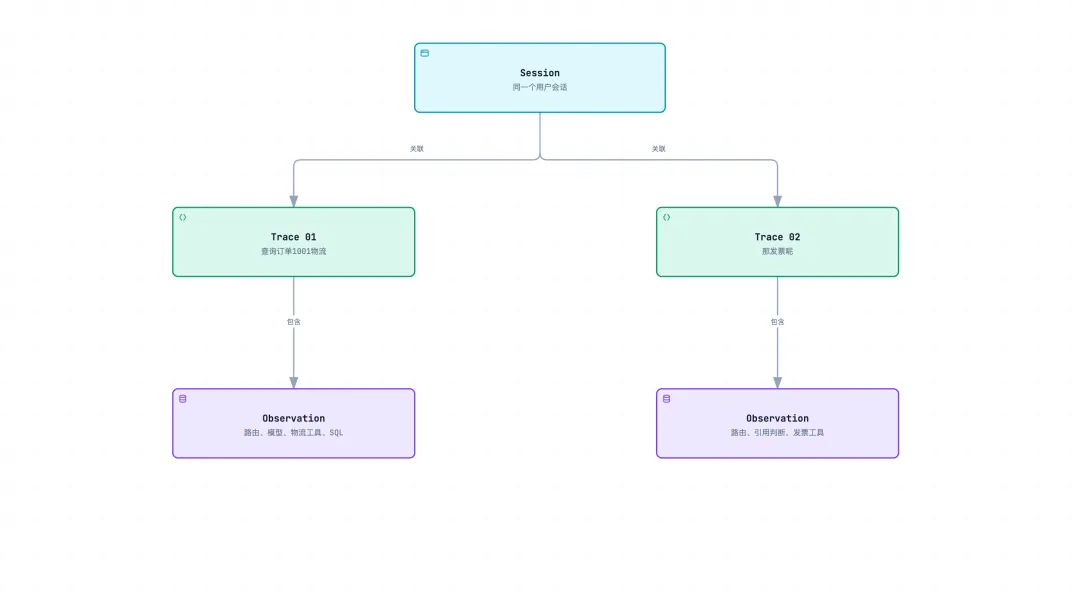
Observation 可以有不同类型。我们用普通 Span 记录技能加载和数据库查询,用 Generation 记录模型请求,用 Tool 记录业务工具执行。
下面是交互模式下的一轮查询。节点名称来自我们的项目,结构做了简化:
chat-turn:这一轮用户请求├── router-model│ └── deepseek-route:模型选择技能└── order-assistant ├── load-skill:加载物流技能 ├── deepseek-response:模型提出工具调用 ├── get_shipping_status:物流工具 │ └── sqlite-query:读取数据库 └── deepseek-response:模型整理答复父子关系很有用:展开物流工具,就能看到它对应的数据库查询,不必在一堆日志里猜哪些记录属于同一次操作。
注意,图中的模型节点记录的是我们发送和接收的内容,不能据此看到模型内部的全部思考。
我们选择用 Docker Compose 在本机部署 Langfuse。
第一次启动时,很容易疑惑:
我只是想看模型调用,为什么还有 PostgreSQL、ClickHouse、Redis 和 MinIO?
因为 Langfuse 自身也需要接收事件、后台处理、保存记录和提供查询页面。官方自托管架构说明了这些组件的分工。
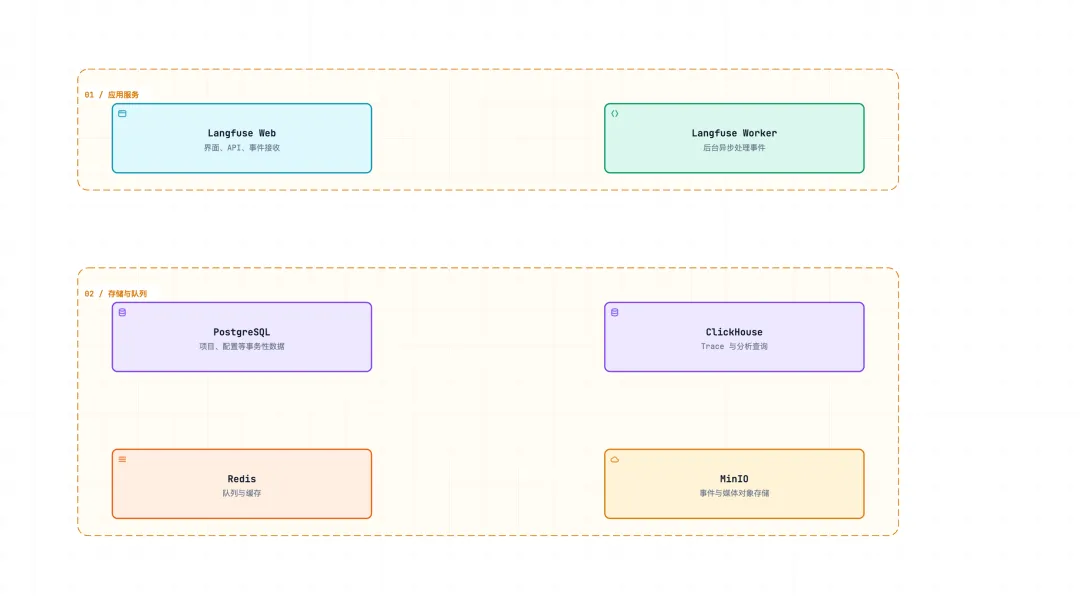
MinIO 也用于保存输入事件,并非只有上传图片时才会用到。
从概念上看,事件接收后会持久化到对象存储,通过队列交给 Worker,再处理进入分析存储。这个过程让数据上传和后台处理可以分开进行。
这里还有一个容易混淆的地方:
订单助手的 SQLite → 保存订单、物流、发票等业务数据Langfuse 的存储组件 → 保存观测事件及平台自身的数据接入 Langfuse,不需要把订单数据库换成 PostgreSQL。
我们的部署将 Web 映射到 localhost:3008,对象存储端口映射到 localhost:9098。它们是本项目的配置,官方示例的端口可能不同。
首次从零部署,可参考官方 Docker Compose 指南,修改示例中的密钥与密码后再启动。Langfuse 没有默认管理员账号;可在界面创建用户和项目,或配置自动初始化。
Docker Compose 适合本地学习和单机试用。需要高可用、扩容和备份时,还要补充对应的部署方案。
很多人想到观测,第一反应是记录模型调用。
但对 Router + Skill 项目来说,只记录模型还不够:问题可能出在技能选择,也可能出在查询权限检查。
因此,我们记录五类信息:
- 路由
:选中了哪项技能,还是要求澄清、拒绝执行。 - 技能加载
:加载了哪个 Skill,允许调用哪些工具。 - 模型请求
:输入、输出、模型名称及 API 返回的 Token 用量。 - 工具执行
:工具名称、参数、结构化结果和业务错误。 - 数据库查询
:工具实际读取到了什么结果。
这些边界与代码职责对应,排查时就能逐层对照。
Python SDK 支持通过上下文管理器创建观测,并通过嵌套关系关联步骤。下面是埋点结构的简化示例,不执行真实订单查询:
from langfuse import Langfuselangfuse = Langfuse()try: with langfuse.start_as_current_observation( name="order-assistant", input={"question": "查询订单1001物流"}, ) as request: with langfuse.start_as_current_observation( name="load-skill", ) as step: # 实际项目在这里加载技能 step.update(output={"skill": "shipping-status"}) request.update(output="这里记录最终答复")finally: # 命令行程序退出前,发送缓冲中的记录 langfuse.flush()使用前,需要配置项目 Public Key、Secret Key 和服务地址。示例写法与我们使用的 Python SDK 4.17.0 对应;不同版本应核对官方埋点文档。
我们的项目把这些操作封装在 telemetry.py 中,业务模块通过 observation() 创建观测,避免每个模块重复处理客户端配置。
flush() 帮助短进程在退出前发送缓冲记录;服务端还有异步处理过程,所以发送结束后,页面上的数据可能需要稍等才能看到。
接入后,运行项目:
cd order-assistant.venv/bin/python app.py '查询订单1001物流' \ --mode model --router model终端会打印 Trace 链接。打开后,我们可以按顺序回答四个问题。
第一,路由选对了吗?
应该选择 shipping-status。如果选成 invoice-status,就先检查路由输入和输出,不必急着改物流工具。
第二,模型提出了什么调用?
应该看到:
{ "name": "get_shipping_status", "arguments": { "order_id": "1001" }}第三,工具真正返回了什么?
本项目的演示订单返回:
{ "ok": true, "order_id": "1001", "status": "运输中,已离开发货仓", "carrier": "演示快递"}第四,最终答复是否忠于结果?
工具没有提供预计送达日期。如果助手说“明天下午送达”,这条信息就缺少本次查询结果的支持,需要检查生成答复时的约束。
现在,问题已经从笼统的“Agent 不靠谱”,变成了具体的“答复增加了工具未提供的事实”。
上述查询使用真实 DeepSeek API 和真实 SQLite;数据库里的订单与物流记录是虚构教学数据。
再看两轮对话:
你:查询订单1001物流助手:订单1001运输中……你:那发票呢助手:订单1001的发票状态为已开具。每一轮各有一条 Trace,用同一个 Session ID 关联。
第二轮还要额外判断:“那发票呢”是否引用上一单。我们用 resolve-reference 节点记录这个判断,再由程序补充已验证的订单号,调用发票工具。
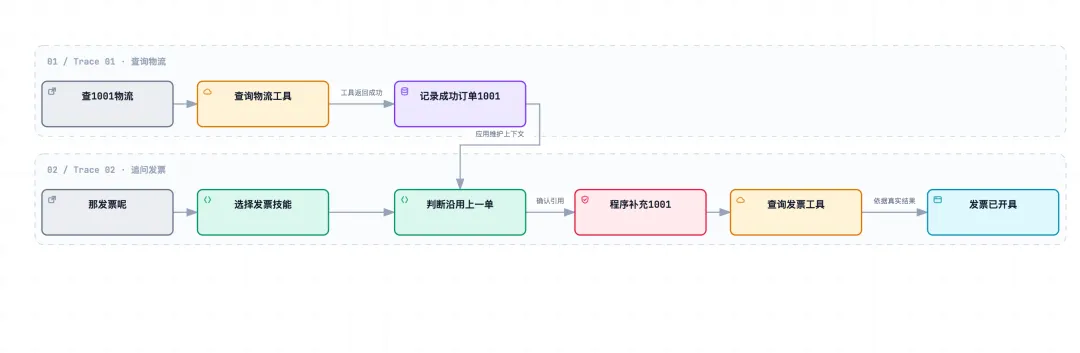
此前一次真实联调的验收记录显示,这两轮产生了2 条 Trace、19 个观测节点,包含引用判断和发票工具调用。节点数量取决于当次执行路径,不是每次请求都固定如此。
这里还要分清职责:Session ID 用于在 Langfuse 中关联记录;助手是否记住上一单,由我们自己的会话代码决定。
给请求设置 Session ID,不会自动给 Agent 增加记忆能力。
ORDER_NOT_ACCESSIBLE 是业务检查结果,不必然代表服务故障。我们的工具会统一处理不存在或不可访问的订单,排查时也要保留这个访问边界。
耗时同样要结合调用关系分析:整轮请求已经包含子步骤的时间,不能把父节点和所有子节点耗时简单相加。
Token 用量可以辅助比较模型调用的开销;费用还需要正确的模型价格配置,不能把 Token 数直接当成账单金额。
Trace 能帮助我们发现路由误判、参数错误、调用次数异常和答复缺少依据等问题。
但“页面里没有红色报错”并不代表答案正确。
例如,用户说“不要查物流,只看发票”,系统顺利完成了物流查询。技术链路可能全部成功,业务意图却理解错了。
因此,我们可以把真实失败输入加入评测样本:
发现问题 ↓查看 Trace,定位出错步骤 ↓保存失败输入和预期结果 ↓修改提示词或程序逻辑 ↓运行评测,检查是否修复我们订单助手里的意图评测,就分别检查“选对技能”和“是否沿用上一单”。这两件事都正确,才能算这个追问样本通过。
记录模型输入、技能指令和工具结果也意味着记录了应用数据。发布截图前应遮盖账号、订单信息和密钥;实际业务中应按需要脱敏、控制访问和设置保留期限。
前面的文章解决了三个问题:
Router 决定使用哪项技能,Skill 说明如何处理任务,Tool 获取业务事实。
接入 Langfuse 后,我们又能回答:
这次请求经过了哪些步骤,模型调用了什么,工具返回了什么,答案依据是什么。
当 Agent 的能力继续增加,这些证据会帮助我们更快判断该修改哪一层,也让每一次优化有结果可核对。
下一次遇到错误回答,先打开 Trace,看清执行过程,再决定怎么改。