ARTICLE · 1155748
[AI安全]第1期:传统软件安全测试(MC/DC)面对黑盒深度学习时的维度灾难与失效分析
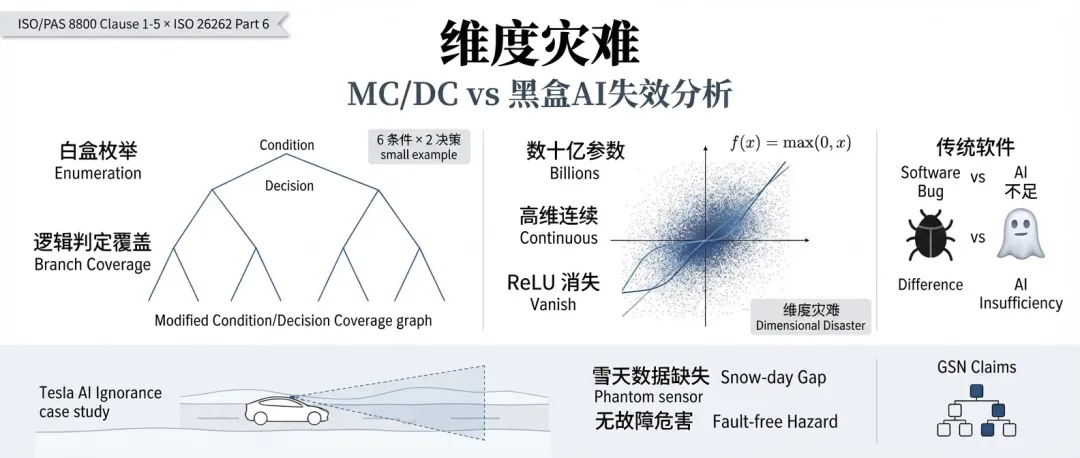
从白盒逻辑覆盖,到输入空间、鲁棒性边界与工具链证据闭环:自动驾驶进入 Level 3 之后,安全论证的支点已经改变。
在传统软件世界里,MC/DC 曾经是证明“测试做得足够深”的黄金指标;但当感知决策从离散 if-else 转入高维连续空间的 DNN 模型之后,原本可解释、可枚举、可分支覆盖的逻辑,被压缩进了神经元激活边界、训练数据分布和编译后推理图之中。真正的问题,不是 MC/DC 有没有价值,而是它面对黑盒深度学习时,已经不再是那个能够单独支撑安全声明的核心证据。
1. 汽车安全范式的代际转型
从 SAE Level 2 向 Level 3 的跨越,不只是驾驶功能数量的增加,更是责任结构与合规逻辑的重构。按照 SAE J3016 的语境,当系统在预定义 ODD 内接管动态驾驶任务时,安全论证就不能再停留在“硬件没有坏、代码没有崩”的传统层面,而必须进一步回答:即便执行链条完全正常,感知模型本身会不会在边界场景中做出危险判断?
这也是 ISO 26262、ISO 21448、ISO/PAS 8800 与 EU AI Act 被放在同一张审计桌面上的原因。ISO 26262 处理电子电气系统中的随机硬件失效与系统性软件错误,SOTIF 关注功能不足引起的危险行为,而 ISO/PAS 8800 则把焦点推进到 AI 组件本身的安全生命周期与证据组织方式。对 OEM 和 Tier-1 来说,Level 3 的真正挑战,不只是把模型部署到车上,而是证明这套模型在 ODD 之内的非确定性风险已被量化、被约束、被持续监控。
在传统 E/E 架构中,安全工程师熟悉的是确定性逻辑:输入、分支、状态转移、故障反应。可一旦感知堆栈由 DNN 主导,系统就会出现一种新的失效方式——硬件无故障,代码执行正确,调度也没有问题,但由于算法性能边界、数据分布缺口或编译量化偏移,仍然可能在关键对象识别上做出致命误判。
本文的核心立场并不激进:MC/DC 并没有失去价值,它仍然是传统软件层面非常重要的基础项;但如果把它直接套用到黑盒深度学习之上,并试图据此得出“AI 感知已被充分验证”的结论,那么审计上会立即遭遇维度灾难。
2. 维度灾难:为何 MC/DC 在深度神经网络中失效
在 ISO 26262-6 的软件验证语境里,MC/DC 是一个非常强的充分性指标。它要求每个条件都能独立影响判定结果,因此特别适用于安全相关软件中的复杂布尔逻辑。问题在于,DNN 并不以这种方式表达自身“逻辑”。它没有传统意义上稳定、显式、可枚举的 if-else 路径,而是把决策边界编码到了高维参数与激活函数的组合之中。因此,MC/DC 不是简单“不够高”,而是从机理上与对象失配。
2.1 ReLU/GELU 激活函数与“逻辑隐藏”
传统软件的逻辑分支是显式的。工程师能够指出某个判断条件来自哪一行代码、在哪个状态下转移、由哪个布尔表达式触发。而在 DNN 中,所谓“逻辑”被压缩在 ReLU、GELU 等非线性激活函数与权重矩阵之中。ReLU 的分段线性特性看似简单,但真正的决策面却是大量局部分段组合而成的高维折面。模型并不向测试工具暴露“这个像素扰动触发了哪条安全相关逻辑分支”,它只给出一组激活值和最终输出。
因此,传统覆盖工具即便能够观测某些神经元是否被激活,也难以像覆盖判定条件那样,量化“某个内部逻辑单元是否被独立验证过”。更关键的是,很多危险行为并不是由一个孤立条件显式触发,而是由多个特征在高维空间中共同逼近某条隐含边界。对审计而言,这种现象更适合被称为逻辑隐藏,而不是简单的“分支太多”。
2.2 输入空间的维度爆炸
感知系统面对的是数百万像素的连续输入空间。传统测试理论里,等价类划分之所以有效,是因为工程师能够识别边界值、离散状态和有限路径;但图像、点云、时序融合信号的世界并没有这样的天然离散结构。强光、阴影、噪声、污损、视角变化、压缩损失、遮挡比例、运动模糊,都会在高维输入空间中造成细微但可能致命的偏移。
这意味着两幅在人眼看来几乎相同的图像,只要在若干关键像素、局部纹理或亮度分布上发生微量变化,就可能让模型穿越内部非线性边界。工程上常见的 sensor glare、摄像头噪声、遮挡物边缘反射,都可能成为这种边界穿越的触发器。试图用“穷举逻辑路径”的方式覆盖这一类输入,在数学上已经失去意义,在工程资源上也不可承受。
2.3 技术对比:确定性软件 vs. 概率模型
这张对比表的重点,不是宣告传统方法完全失效,而是提醒审计边界:MC/DC 仍然适用于传统软件外壳、状态机、故障诊断和安全机制本身,但它无法单独覆盖 DNN 的行为正确性。
3. 定义不可预测性:无故障危害(Fault-free Hazard)机理
在 AI 安全审计中,最容易被误解的一点,是把“系统没有报错”误当成“系统没有风险”。实际上,ISO 21448 与 ISO/PAS 8800 正是为了解决这种误判而存在:它们要求工程团队区分实现错误与设计极限,区分失效与不足,区分 Bug 与能力边界。
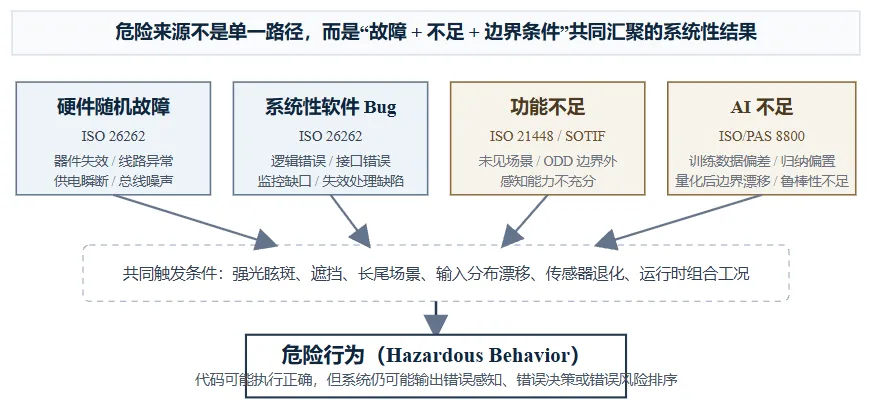
图 1|从 ISO 26262 到 SOTIF / ISO/PAS 8800:硬件故障、软件 Bug、功能不足与 AI 不足共同汇聚为危险行为。
对审计流程而言,这里的核心区分可以概括为四类:第一类是 ISO 26262 典型覆盖的硬件随机失效;第二类是传统系统性软件错误;第三类是 SOTIF 关注的功能不足,即系统在未见场景或感知能力边界外产生误判;第四类则是 ISO/PAS 8800 更强调的 AI 不足,包括模型归纳偏置、训练数据质量不足、标签偏差、量化后性能边界变化等。
这也是“Fault-free Hazard”之所以棘手的原因。它不是某一行代码写错了,也不是某个电源或总线随机掉线,而是系统即便在“无故障执行”前提下,依然会因为认知边界不够而产生危险行为。强光致盲、遮挡、逆光、低对比度目标、非典型外形对象,都是典型触发条件。代码执行正确,不等于行为安全;这句话在 AI 审计中必须被反复强调。
4. 案例解剖:长尾场景中的“AI 愚昧”
如果说 Fault-free Hazard 是理论框架,那么 CARLA/SUMO 等仿真环境提供的就是工程证据。实践中,很多团队在常规验证场景下取得了很高的分类准确率、不错的回归误差,甚至软件层面的覆盖率也相当漂亮;但一旦切入“夕阳逆光”“行人从遮挡物后突然冲出”“湿路面强反射”“边缘阴影贴近人体轮廓”等长尾输入,模型的置信度就会发生明显坍塌。
这一类问题的危险之处在于,它并不总以“完全失明”的方式出现。更多时候,模型输出依然很稳定、很自信,只是自信地错了。对于审计方而言,这比普通软件异常更难处理,因为系统没有崩,没有报错,没有触发硬故障路径,却在最关键的一瞬间把风险目标归到了低风险背景。
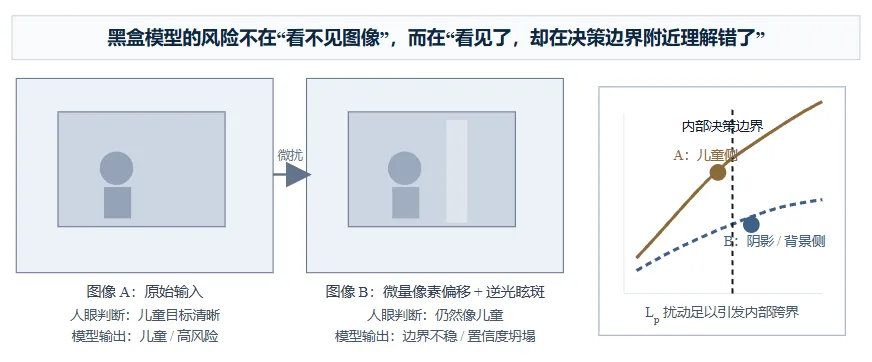
图 2|在人眼看来几乎相同的两帧图像,可能因微量扰动跨越模型内部决策边界,从“儿童”被压缩成“阴影”或低风险背景。
这也是为什么“MC/DC 已达 100%”并不能直接转译为“感知安全已充分验证”。MC/DC 可以告诉我们:围绕模型的控制代码、监控逻辑、接口软件可能被覆盖得很好;但它无法证明模型本体在 Lp Norm 扰动、长尾场景和输入分布偏移下依旧稳定。审计上最危险的,不是指标缺失,而是用错误指标证明了错误对象。
5. 量化安全指标:从逻辑覆盖转向扰动边界与证据闭环
AI 安全论证最大的变化,在于“安全声明”必须被转写为“量化边界声明”。也就是说,工程团队不应再笼统声称“模型足够安全”,而应明确:在怎样的 ODD 内、面对怎样的扰动等级、经过怎样的量化与编译处理、在怎样的目标硬件之上,该模型仍能维持可接受的性能下界。这是审计能够落地的唯一方式。
5.1 Lp Norm 扰动边界与 EU AI Act 第 15 条
EU AI Act 第 15 条把高风险 AI 系统的鲁棒性、准确性与网络安全提升到了法律要求层面。对汽车行业来说,这意味着不能只证明“代码执行正确”,还要证明“在可预期扰动下,行为边界可量化”。FGSM、PGD 等对抗性方法并不是全部答案,但它们至少提供了一个工程上可复现、可记录、可横向比较的起点:在给定 Lp 扰动预算下,模型分类一致性能否维持在声明区间内。
审计时更关心的不是某个单一鲁棒性分数,而是鲁棒性声明是否与 ODD 一致:该扰动预算是否对应真实摄像头噪声、逆光强度、遮挡比例、压缩损失或目标尺寸变化?如果企业给出的只是实验室里的对抗攻击结果,而没有把它映射回道路、天气、光照、视距和传感器链路,那么证据的解释力仍然不足。
5.2 生产环节的“证据鸿沟”:量化与编译风险
很多团队在 PyTorch 中完成了 FP32 模型验证,随后经过导出、图优化、INT8 量化、TensorRT 编译,再部署到目标平台。问题是,审计对象真正关心的并不是“训练框架中的浮点理想体”,而是最终跑在车上的可执行实体。量化误差、逐通道尺度差异、算子替换、融合策略、编译器优化,都可能让决策边界出现偏移。
因此,任何仅基于训练环境内浮点模型的安全论证,如果缺少量化一致性记录、目标硬件执行日志和编译后二进制可追溯信息,都应被视为不完整证据。工程上常见的做法,是在目标硬件上执行闭环复验,例如在 Drive Orin-X 这类实际计算平台上,对同一批场景输入比对 FP32、INT8 和最终部署图的输出偏差,并记录逐通道量化损失、告警阈值变化与关键对象召回的变化幅度。
5.3 工具链合格性(Tool Qualification)与 TI/TD 分析
传统 ISO 26262-8 的工具合格性分析,主要围绕编译器、代码生成器、静态分析工具、测试工具展开。到了 AI 开发流程中,训练框架、数据预处理脚本、模型转换器、量化工具、推理引擎乃至图优化编译器,都可能成为影响安全目标的关键节点。尤其当某一工具链优化会改变模型执行图、算子精度或张量量化方式时,工具本身就不再只是“效率工具”,而是潜在的行为塑造者。
从 TI/TD 的角度看,这类 AI 工具链常常呈现出较高的风险画像:一旦输出结果偏移,可能直接影响安全目标;而其内部错误又不总能通过传统手段轻易检测。基于这一点,在安全相关场景下,某些 AI 编译器和模型转换工具可视为接近较高等级 TCL 风险画像的对象,至少应配套更严格的独立交叉验证、样本回归、哈希管理和目标硬件一致性复验,而不能停留在“工具是行业常用,所以默认可信”的层面。
审计提示:
不要把训练框架内的验证报告直接当成量产部署证据,尤其在经历 FP32 → INT8 → 推理引擎编译之后。 不要把“工具为主流开源或行业常用”自动等价为“工具已满足安全合格性要求”。 对关键模型至少保留三条平行证据链:训练链、编译链、目标硬件执行链。 平均精度提升不代表安全提升;审计更关心长尾场景、关键类别和危险状态下的性能下界。
6. GSN 安全论证集成:如何证明非确定性风险已降至可接受水平
MC/DC 的局限,并不意味着 AI 安全论证无从落手。恰恰相反,它要求企业把分散的仿真、鲁棒性测试、量化一致性、工具链控制与运行时监控,组织成一条结构化声明链。GSN 的价值就在这里:它并不替代证据本身,但它强迫团队明确“我在声称什么、基于什么策略、处于什么上下文、依赖什么证据”
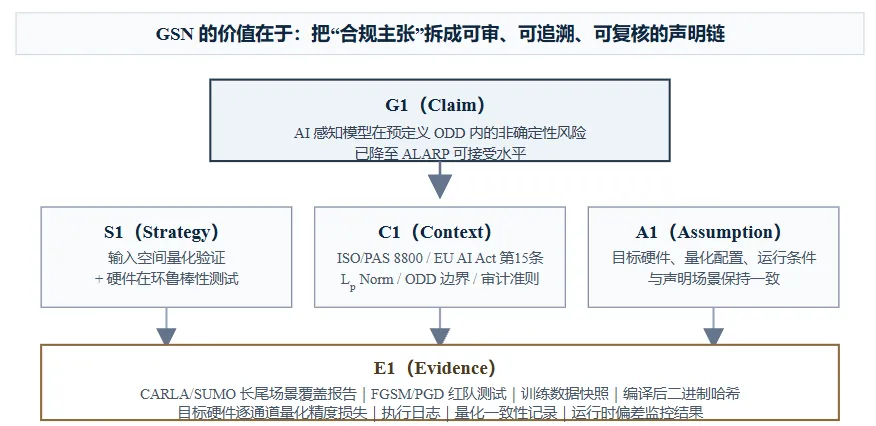
图 3|GSN 在 AI 安全论证中的作用:把“非确定性风险可接受”拆解成声明、策略、语境与证据的可审计结构。
如果把这条论证链写成简洁版本,可以这样表达:G1 是主张,即 AI 感知模型在预定义 ODD 内的非确定性风险已被压到 ALARP 可接受水平;S1 是策略,即同时采用输入空间量化验证和硬件在环鲁棒性测试,而不是依赖单一准确率报告;C1 是上下文,包括 ISO/PAS 8800 的生命周期框架、EU AI Act 第 15 条的鲁棒性要求,以及所声明的 Lp Norm 与 ODD 边界;E1 则是证据,包括 CARLA/SUMO 长尾场景覆盖报告、FGSM/PGD 红队结果、编译后二进制哈希、训练数据快照、目标硬件逐通道量化精度损失记录等。
这条链最大的价值,不是把风险“证明为零”,而是把原本松散、主观、难以追责的 AI 能力描述,转化为可复核、可追踪、可质询的工程声明。对审计来说,这已经是从“经验相信”走向“结构化相信”的关键一步。
7. 结论与审计建议
维度灾难并不是一句口号,它意味着白盒逻辑覆盖对 AI 的证明力已经触顶。MC/DC 仍然必要,但它只覆盖传统软件层面:模型调度代码、故障监控逻辑、安全状态机、接口与降级策略仍然要做;只是当审计对象扩展到黑盒深度学习本体时,安全支点必须转向数据追溯、数学鲁棒性、编译后一致性与工具链合格性。
换句话说,在 AI 时代,“测试是否充分”这个问题,已经不能只问覆盖率做到了多少,而要问:模型在何种 ODD 内声明有效、其扰动边界是否被量化、部署工件是否和验证对象一致、工具链是否被纳入合格性视野、运行时是否对 ODD 漂移和输入异常具备监测与退避能力。
面向 OEM 与 Tier-1 的审计建议:
- 建立全链路溯源机制。
从训练数据快照、标注版本、模型权重、量化报告到最终目标二进制哈希,必须形成完整追踪链,防止生产环节引入“证据偏移”。 - 对 AI 工具链执行 TI/TD 深度评估。
训练框架、模型转换器、量化工具、推理引擎和编译器,都应进入工具合格性视野;对于高风险画像工具,至少要有独立验证与交叉回归。 - 把运行时监控纳入安全论证。
一旦输入超出声明扰动边界,或出现 ODD 漂移、置信度异常、感知一致性下降,就应触发安全退避,而不是继续沿用静态验证时的理想假设。 - 不要把“MC/DC 完成”当作 AI 安全论证完成。
它是传统软件层面的必要基础项,但远远不足以替代模型鲁棒性、量化一致性与部署证据闭环。
结论框:
在 ISO/PAS 8800 时代,真正的合规,不是证明系统从不出错,而是证明你已经量化并约束了它会以什么方式、在什么边界内出错。对白盒软件来说,MC/DC 依然重要;但对黑盒深度学习来说,真正决定审计结论的,是你能否把“不可预测性”转写为“可追溯、可量化、可退避”的工程证据。
变现转化区
关于作者 | 知猷君
微信公众号:知猷君
近20年造车老兵 · 前自动驾驶整车控制总工 · 前知名主机厂三电总工“我们不制造行业焦虑,我们只提供硬核的工程弹药。”“驭电策新,谋见未来”——关注我,拒绝碎片化,构建你的新能源技术护城河。
© 2026 知猷君. 本内容仅供学习交流,严禁未授权转载。*未经书面授权,任何机构或个人不得通过AI洗稿、切片搬运或抄袭商用。侵权必究。