ARTICLE · 1155755
MongoDB 深度:文档模型/聚合管道/索引策略/Mongoose 最佳实践(生产收藏级)
面试官问「MongoDB 4.0 都支持多文档事务了,是不是就能完全替代 MySQL 了?」——大多数人会顺着答「是」。能把「事务只在副本集/分片集群可用、且不该把文档库当关系库用」讲出来的人,才说明你真的想清楚了文档模型和关系模型的边界在哪。
🎯 这篇文章解决什么问题
MongoDB 是 Node.js 全栈开发者几乎绕不开的一个数据库。你写过 find、用过 $group、配过 populate,但被追问到底层——什么数据该用文档模型、什么该回关系型?聚合管道的分阶段思想是什么?explain() 里的 IXSCAN 和 COLLSCAN 到底说明了什么?Mongoose 的钩子和虚拟字段各自解决什么问题?——很多人就卡住了。
这篇文章是「Node.js 全栈深度拆解」系列的第 13 篇,也是数据库板块的第二篇。它把 MongoDB 从「基本使用」到「生产最佳实践」完整串起来,四件事讲透:
文档模型:嵌套文档 vs 关系型 JOIN 的选型判据——核心是「读模型」 聚合管道:多阶段顺序处理,复杂统计像搭积木一样组合 索引策略:B 树索引、最左前缀、 explain()看执行计划、覆盖查询Mongoose 最佳实践:Schema 校验兜底、中间件钩子、虚拟字段、 populate的 N+1
一、基本使用
1. MongoDB 是什么 + 核心概念
MongoDB 是一个基于分布式文件存储的开源数据库系统,把数据存储为一个文档。文档的数据结构由键值对(key => value)组成,类似 JSON 对象,字段值可以包含其他文档、数组以及文档数组——这一点和 MySQL 的「一张表、行列固定」是两种完全不同的世界观。
先厘清三个核心概念:
数据库(database):MongoDB 单个实例可以容纳多个独立的数据库 集合(collection):数据库由集合组成,一个集合用来表示一个实体(如学生集合) 文档(document):集合由文档组成,一个文档表示一条记录(如一位同学就是一个文档)
和 MySQL 的术语对照,一目了然:
MongoDB 的主键 _id 默认是 ObjectId 类型——分布式环境下没法用 MySQL 的自增主键(会冲突),所以 MongoDB 用 12 字节的 BSON 字符串做主键。它由四部分组成:4 字节 UNIX 时间戳 + 3 字节机器标识 + 2 字节进程 PID + 3 字节计数器。前 9 个字节保证了「同一秒、不同机器、不同进程」产生的 ObjectId 唯一,最后 3 字节计数器保证「同一进程、同一秒」内也不重复。
2. 文档基本 CRUD
MongoDB 的增删改查都通过 db.集合名.方法() 完成。先看插入——insertOne 是标准做法,老版本的 save 和 insert 已被取代:
# insert:主键已存在会抛 DuplicateKeyExceptiondb.teacher.insert({_id: '1', name: 'test1'})# save:已废弃,新版本用 insertOne/replaceOne 替代db.teacher.save({_id: '1', name: 'test111 '})更新用 updateOne/updateMany(老版 update 的 multi 参数控制是否更新多条,默认只更新第一条):
# 更新文档:query 是查询条件,update 是更新内容(含 $set/$inc 等操作符)db.teacher.update({_id: '1'}, {$set: {'name': 'mongoDB'}})更新操作符是 MongoDB 查询体系里很重要的一块,常用的几个:
#$set:指定键并更新值,键不存在则创建db.teacher.update({_id: '1'}, {$set: {'name': 'mongoDB'}})#$inc:在原基础上累加db.teacher.update({}, {$inc: {'age': 1}})#$unset:删除指定键db.teacher.update({}, {$unset: {'age': 1}})#$push:向数组添加元素db.teacher.update({}, {$push: {'hobbys': 'reading'}}, {multi: true})#$addToSet:向集合添加元素(去重,不重复添加)db.teacher.update({name: 'mongoDB'}, {$addToSet: {'hobbys': 'playing'}})#$each:把数组元素逐个添加到集合var hobbys = ['reading', 'writing']db.teacher.update({name: 'mongoDB'}, {$addToSet: {'hobbys': {$each: hobbys}}})#$pop:删除数组中的一项db.teacher.update({_id: '1'}, {$pop: {'hobbys': 1}})# 修改指定索引的元素db.teacher.update({_id: '1'}, {$set: {'hobbys.0': 'play'}})删除用 deleteOne/deleteMany(老版 remove 已过时):
# remove() 已过时,官方推荐 deleteOne() / deleteMany()db.teacher.remove({_id: '1'})查询是最核心的部分。find 以非结构化方式显示所有文档,findOne 只返回一个:
# find(query, projection):query 查询条件,projection 指定返回的键db.teacher.find()db.teacher.find({}, {name: 1, _id: 0}) # 只返回 name 列,不返回 _iddb.teacher.findOne({_id: '2'}, {name: 1, _id: 0})比较操作符是查询条件的主力:
#$gt 大于 / $lt 小于 / $gte 大于等于 / $lte 小于等于 / $eq 等于 / $ne 不等于db.teacher.find({age: {$gt: 5}}).pretty()db.teacher.find({age: {$lt: 5}}).pretty()db.teacher.find({age: {$gte: 5}}).pretty()db.teacher.find({age: {$lte: 5}}).pretty()db.teacher.find({age: {$eq: 5}}).pretty() # 等价于 {age: 5}db.teacher.find({age: {$ne: 10}}).pretty()范围查询用 $in/$nin:
#$in:包含,类似关系型的 IN;$nin:不包含,类似 NOT INdb.teacher.find({age: {$in: [1, 3]}}).pretty()db.teacher.find({age: {$nin: [1, 3]}}).pretty()逻辑运算用 $and/$or/$not/$nor:
# 与:$and(同字段多条件可直接合并写)db.teacher.find({$and: [{age: {$gt: 5}}, {age: {$lt: 7}}]}).pretty()db.teacher.find({age: {$gt: 5, $lt: 7}}).pretty()# 或:$ordb.teacher.find({$or: [{age: {$lt: 3}}, {age: {$gt: 8}}]}).pretty()# 非:$not / $nordb.teacher.find({$nor: [{age: {$lt: 3}}, {age: {$gt: 8}}]}).pretty()db.teacher.find({age: {$not: {$gt: 3}}}).pretty()数组查询有几个专用的操作符:
#$all:必须包含数组里所有值(比 $in 严格,$in 只需满足其中一个)db.teacher.find({hobbys: {$all: ['reading', 'playing']}}).pretty()#$size:数组元素个数db.teacher.find({hobbys: {$size: 3}}).pretty()#$slice:限制返回的数组元素个数 [起始位置, 输出个数]db.teacher.find({hobbys: {$size: 3}}, {hobbys: {$slice: 1}}).pretty()还有一些零散但实用的操作符:
#$mod:取模运算(查询 age 取模 3 等于 0 的数据)db.teacher.find({age: {$mod: [3, 0]}}).pretty()#$exists:判断字段是否存在db.teacher.find({age: {$exists: true}}).pretty()#$where:条件过滤(用 JS 表达式,性能差,慎用)db.teacher.find({$where: 'this.age > 9'}).pretty()正则模糊查询——MongoDB 的正则使用 Perl 兼容语法。i(忽略大小写)、m(多行)可直接用,x、s 必须走 $regex:
# 基础语法:{key: 正则标记};完整语法:{key: {$regex: 正则, $options: 选项}}db.teacher.find({"name": /1/}).pretty()游标(cursor)可以一行行处理数据,类似 ResultSet。find() 返回游标,用 hasNext() 判断是否还有下一行、next() 取当前数据:
var cursor = db.teacher.find()while (cursor.hasNext()) { var doc = cursor.next() print(doc.name)}分页用 skip(跨过多少行)+ limit(取多少行)+ sort(1 升序 -1 降序):
db.teacher.find().skip(0).limit(3).sort({"age": -1}).pretty()批量插入大量数据时,逐条 insert 太慢,可以用脚本一次插入:
const startTime = Date.now()const db = connect('demo')const students = []for (let i = 1; i < 1000000; i++) { students.push({name: 'student' + i})}db.student.drop()db.student.insert(students)print(Date.now() - startTime)3. 聚合管道基本用法
MongoDB 的聚合(aggregate)用于处理数据(统计平均值、求和等),类似 SQL 里的 count(*)/GROUP BY。基本语法:
db.COLLECTION_NAME.aggregate(AGGREGATE_OPERATION)分组是聚合里最常用的操作。下面这组数据按 uid 分组、统计每个作者的文章数:
db.article.insert({uid: 1, content: '1', visit: 1})db.article.insert({uid: 2, content: '2', visit: 2})db.article.insert({uid: 1, content: '3', visit: 3})db.article.aggregate([{$group: {_id: '$uid', total: {$sum: 1}}}])// { "_id" : 2, "total" : 1 }// { "_id" : 1, "total" : 2 }等价 SQL:
select uid, count(*) total from article group by uid
$group 阶段里常用的聚合表达式:
$sum | |
$avg | |
$min / | |
$push | |
$addToSet | |
$first / |
聚合管道的核心思想是管道——像 Unix/Linux 里「当前命令的输出作为下一个命令的输入」一样,MongoDB 文档在一个阶段处理完毕后,把结果传给下一个阶段,阶段可以重复。常用阶段有七个:
$project:修改文档结构(重命名、增删字段、创建计算结果)$match:过滤数据,只输出符合条件的文档$limit:限制返回文档数$skip:跳过指定数量的文档$unwind:把数组字段拆分成多条,每条含数组中的一个值$group:分组,用于统计$sort:排序后输出
把「统计各科室处方数量」这个需求,用这几个阶段组合起来写,就是最典型的聚合管道:
db.prescriptions.aggregate([ { $match: { status: '已审核' } }, // ① 先过滤,只统计已审核处方 { $group: { _id: '$dept', count: { $sum: 1 } } }, // ② 按科室分组计数 { $sort: { count: -1 } }, // ③ 按数量降序 { $project: { _id: 0, dept: '$_id', count: 1 } } // ④ 投影,重命名 _id 为 dept])$unwind 值得单独看一下——它把文档里的数组字段「拆开」,一个数组三个值就变成三条文档(除了这个字段不同,其他字段都相同):
db.vistors.aggregate([ { $project: {_id: 1, uid: 1, type: 1, visit: 1} }, { $match: { visit: {$gte: 1, $lte: 10} } }, { $unwind: '$type' }])4. 索引创建
索引能极大提升查询效率。没有索引时,MongoDB 必须扫描集合里的每个文档再筛出符合条件的结果,大数据量下可能几十秒甚至几分钟。索引是「对表里一列或多列的值排序」的特殊数据结构,方便范围查询和匹配查询——查询时先在索引里定位,再按位置取文档:
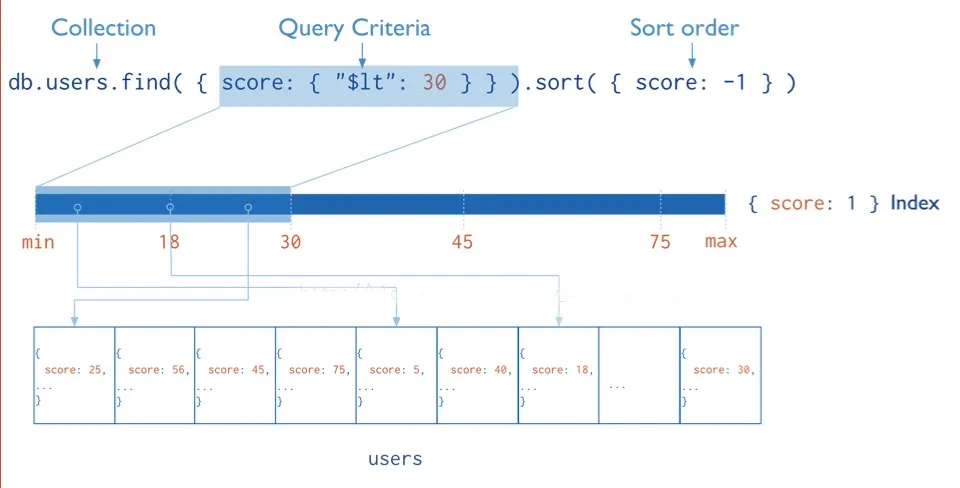
创建索引的语法,3.0 之前用 ensureIndex(),之后用 createIndex()(ensureIndex 还能用,但只是别名):
db.collection.createIndex(keys, options)keys 里的 1 表示升序、-1 表示降序。复合索引支持多字段和各自的排序方向:
db.teacher.createIndex({"name": 1})db.teacher.createIndex({"name": 1, "age": -1})常用 options 参数:
background | ||
unique | ||
name | ||
sparse | ||
expireAfterSeconds |
MongoDB 的索引类型比较丰富,除了普通索引,还有几种要认识:
唯一索引: unique: true,保证字段值唯一多键索引:对数组字段自动建索引,一个数组元素对应一个索引项 过期索引(TTL): expireAfterSeconds后自动删数据(字段必须是 Date 对象,每 60 秒跑一次,有误差),适合 session、日志、缓存全文索引:大篇幅文章里搜关键词,用 $text: {$search: 'boy'}查询二维索引(2D):地理坐标,用 $near/$within查询附近点
5. Mongoose 基本用法
Mongoose 是 MongoDB 的对象模型工具,封装了增删改查等常用方法,还提供 Schema、hook、plugin、virtual、populate 等机制,让 Node.js 操作 MongoDB 更灵活简单。安装:
npm i mongoose -SMongoose 有三个层次的概念,一定要分清:
Schema:集合的模型骨架,定义字段名称、类型、默认值 Model:由 Schema 构造,除了骨架还能操作数据库 Entity:由 Model 创建,就是一个文档/一条数据
先定义 Schema 和 Model。Schema 支持的类型很全——基本类型、数组、内嵌文档都有:
const mongoose = require('mongoose')const conn = mongoose.createConnection('mongodb://localhost:27017/demo')conn.on('error', (error) => console.log('数据库连接失败:' + error))conn.on('open', () => console.log('数据库连接成功!'))const Schema = mongoose.Schemaconst TeacherSchema = new Schema({name: String, // 姓名binary: Buffer, // 二进制living: Boolean, // 是否活着birthday: Date, // 生日age: {type: Number, max: 200, min: 0, required: true}, // 年龄createAt: {type: Date, default: Date.now()},arrayOfString: [String], // 字符串数组nested: { name: String }, // 内嵌文档})// ref 指向另一个 Model,为 populate 关联查询做准备const StudentSchema = new Schema({name: String,age: Number,teacher: { type: Schema.Types.ObjectId, ref: 'Teacher' },})const Teacher = conn.model('Teacher', TeacherSchema)const Student = conn.model('Student', StudentSchema)集合名 = 模型名转小写再转复数,如
Person > person > people、Child > child > children
新增——Model 的 create 和 Entity 的 save 都能插入,Model 能做的事比 Entity 更多:
// Model.create 新增const teacher = await Teacher.create({ name: 'test', age: 30 })const student = await Student.create({ name: 'student', age: 10, teacher: teacher.id })// Entity.save 新增(new 一个实例再 save)const t = new Teacher({ name: 'test', age: 30 })await t.save()// 批量添加const teachers = []for (let i = 0; i < 100; i++) { teachers.push({name: 'test', age: i + 1})}await Teacher.create(teachers)更新——updateOne 更新一条,updateMany 更新多条:
await Teacher.updateOne({age: 30}, {name: 'test 30'})await Teacher.updateMany({age: 30}, {name: 'test 30'})删除——deleteOne 删一条,deleteMany 删多条:
await Teacher.deleteOne({name: 'test'})await Teacher.deleteMany({name: 'test'})查询——find 返回多条、findOne 返回一条、findById 按 _id 查。投影时设为 0 表示不返回(_id 默认返回,不要就加 _id: 0):
await Teacher.find({}, {_id: 0, __v: 0})await Teacher.findOne({age: '30'}, {_id: 0, __v: 0})await Teacher.findById('614aaf0467cde85179afa808', {_id: 0, __v: 0})条件查询和 shell 语法一致,只是写在 find 的第一个参数里:
Model.find({"age": {"$gt": 6}}) // 大于 6Model.find({"age": {"$lt": 6}}) // 小于 6Model.find({"age": {"$gt": 6, "$lt": 9}}) // 6~9 之间Model.find({ age: { $ne: 6 } }) // 不等于 6Model.find({ age: { $in: [6, 7] } }) // 等于 6 或 7Model.find({"$or": [{"name": "zfpx"}, {"age": 6}]}) // 或Model.find({name: {$exists: true}}) // 存在 name 字段高级查询用 limit(限制数量)、skip(跳过)、sort(排序)组合做分页:
const page = 2const pageSize = 5const res = await Teacher.find({}, {_id: 0, __v: 0}) .sort({ age: 1 }) .skip((page - 1) * pageSize) .limit(pageSize) .exec()populate() 关联查询——MongoDB 没有 JOIN,但 Mongoose 用 ref + populate 模拟。前面 StudentSchema 的 teacher 字段 ref: 'Teacher',存的是 Teacher 的 _id,查询时 populate('teacher') 就能把 _id 自动替换成对应的 Teacher 文档:
const res = await Student.find({}, {_id: 0, __v: 0}) .populate('teacher', {name: 1, age: 1, _id: 0}) .exec()注意:
populate()底层是多条查询,不是真正的 JOIN。列表场景会放大成 N+1,这一点后面「注意事项」会专门讲。
6. 事务支持(MongoDB 4.0+ 多文档事务)
MongoDB 长期以来是「单文档操作天然原子」,但跨多个文档、多个集合的一致性保证,直到 4.0 版本才通过多文档事务补齐。典型场景:跨集合更新「患者 + 处方状态」——患者取药成功,既要改处方状态,又要累计患者已取药次数,两步要么都成功、要么都不改。
MongoDB 事务用 session 承载,核心三步:startTransaction 开启 → 业务操作 → commitTransaction 提交(失败则 abortTransaction 回滚)。Mongoose 里这么写:
const session = await mongoose.startSession()session.startTransaction()try {await Prescription.updateOne( { _id: rxId }, { $set: { status: '已取药' } }, { session } // 👈 所有操作都要带上 session )await Patient.updateOne( { _id: patientId }, { $inc: { completedPrescriptions: 1 } }, { session } )await session.commitTransaction() // 提交} catch (err) {await session.abortTransaction() // 回滚throw err} finally { session.endSession()}关键前提:多文档事务只在副本集或分片集群上可用,单机部署不支持。这个约束决定了它和 MySQL 事务的本质差异,下一章「注意事项」里会展开。
二、企业最佳实践
1. 文档模型 vs 关系型的选型判断(本篇灵魂)
MongoDB 和 MySQL 不是「谁更好」的问题,而是「什么数据适合谁」的问题。选型的核心判据就一条——读模型。
什么时候用文档模型(嵌套):数据有明显「层级嵌套」结构,而且经常整体读取。一份病历含多次就诊、每次就诊含多项检验结果,这天生就是一棵树。用嵌套文档存,一次查询把整份病历拿全;用关系型就得拆成「病历表 + 就诊表 + 检验表」三张表 JOIN,读一次要查三次。
什么时候用关系型:数据需要频繁跨实体复杂关联查询和强一致性事务。比如处方与药品库存,开方要强一致地扣库存、防超卖,这类数据实体之间关系密集、事务频繁,关系型更合适。
一句话判据:
经常整体读、少跨实体关联 → 文档模型;经常跨实体聚合、强一致 → 关系型。
映射到医疗场景最直观:患者的「电子病历」是典型的文档模型(整体读、嵌套结构);「处方 + 库存 + 支付流水」是典型的关系型(跨实体、强一致扣减)。
💬 面试官:什么场景适合用 MongoDB 的文档模型,什么场景更适合关系型数据库?
✅ 标准答案:看「读模型」。数据有明显层级嵌套结构、且经常整体读取的(一份病历含多次就诊、每次就诊含多项检验),用嵌套文档一次拿全,避免多表 JOIN;数据需要频繁跨实体复杂关联查询和强一致性事务的(处方扣库存),用关系型。核心判据是「经常整体读、少跨实体关联 → 文档模型;经常跨实体聚合、强一致 → 关系型」。
🎁 加分答案:能举出反例说明边界不是绝对的——同一份业务里两种模型可以共存,比如患者主档案用文档存嵌套病历,处方扣库存部分仍用关系型事务。再补一句:文档模型还规避了关系型「跨表 JOIN 在分布式下的扩展难题」,这是它在大规模读多写少场景吃香的原因。
🔧 真实场景:患者详情页要展示「基本信息 + 全部历史就诊 + 每次就诊的检验结果」。如果用关系型,这个页面要 JOIN 三张表、三次往返;用嵌套文档,一次 findById(patientId) 全拿回,首屏直接快一个数量级。
2. 聚合管道的分阶段思想
聚合管道的精髓是把复杂统计拆成多个顺序执行的阶段——$match 过滤 → $group 分组 → $sort 排序 → $project 投影。每个阶段吃上一个阶段的输出,像搭积木一样组合。
为什么这比一条巨型 SQL 更好维护?
可读性:每个阶段只做一件事,看管道一眼就知道数据流怎么走 可组合性:要加一个过滤、换一个排序,只在对应位置插一个阶段,不用改整条语句 可复用:中间的阶段组合可以抽象成片段,多处统计复用
💬 面试官:聚合管道的设计思想是什么?和 SQL 的
GROUP BY相比表达方式有什么不同?✅ 标准答案:聚合管道把复杂统计拆成多个顺序执行的阶段(
$match→$group→$sort→$project),每个阶段吃上一个阶段的输出,像搭积木一样组合。SQL 的GROUP BY是一条声明式语句,一步到位但嵌套复杂后难读;聚合管道是命令式流水线,数据流一目了然,更容易维护和复用。
🎁 加分答案:能说出「每个阶段处理的是上一个阶段产出的中间结果集」,所以阶段顺序影响性能和正确性——
$match越靠前越省(先过滤再分组),这跟 SQL 里「先 WHERE 再 GROUP BY」是同一套优化直觉。还能点出$unwind是文档模型特有的「数组展开」操作,关系型没有直接对应物。
🔧 真实场景:医院管理后台要出「各科室本周处方量 TOP 榜」,就是 $match(本周 + 已审核)→ $group(按科室计数)→ $sort(降序)→ $project(重命名输出)四步。需求变「只统计门诊科室」,只在 $match 里加一个条件,别的阶段都不用动。
3. 索引策略
MongoDB 的索引和 MySQL 一样基于 B 树,复合索引遵循类似「最左前缀」的规则。判断查询有没有走索引,用 explain():
db.students.find({age: 299999}).explain()explain() 返回里最值得看的是 stage——IXSCAN(命中索引)说明走索引,COLLSCAN(全表扫描)说明没走索引:
IXSCAN | ||
FETCH | ||
COLLSCAN | ||
SORT | ||
COUNTSCAN |
executionStats 里三个数字直接决定查询快慢——nReturned(返回条目)、totalKeysExamined(索引扫描条目)、totalDocsExamined(文档扫描条目)。最理想的状态是三者相等:nReturned = totalKeysExamined = totalDocsExamined,说明「查了多少就返回多少、没有多余扫描」。
建索引前先造数据验证差距,是最直观的方式:
// 插入 30 万条数据var students = []for (var i = 1; i <= 300000; i++) { students.push({name: 'zfpx' + i, age: i, random: i})}db.students.insert(students)// 无索引:245msdb.students.find({age: 299999}).explain(true)// 建索引后:7msdb.students.ensureIndex({age: 1})db.students.find({age: 299999}).explain(true)30 万条数据,245ms 降到 7ms——这就是索引的意义。复合索引和排序方向的配合:
// 复合索引:查询条件不止一个时用db.students.ensureIndex({name: 1, age: 1})db.students.find({name: 1, age: 2}, {name: 1, age: 1, _id: 0}).explain(true)// 指定使用某个索引db.students.find({name: 'zfpx299999', age: 299999}).hint({name: 1}).explain(true)索引使用有六条注意事项要记住:
1 为正序、-1 为倒序 索引提升查询但会降低写入,插入多查询少不要建索引 数据量不大时不需要索引,性能提升不明显反而增加内存硬盘消耗 查询数据超过表数据量 30% 时,不要用索引字段查询(不如全表扫) 排序工作时可以建索引提高排序速度 数字索引比字符串索引快得多
4. 覆盖查询(Covered Query)
覆盖查询是索引性能优化的一个进阶概念。当查询涉及的字段和返回的字段都恰好被索引覆盖时,MongoDB 直接从索引里读数据返回,不读实际文档——少了一次「索引找到位置 → 回文档取数据」的磁盘读取,性能显著优于常规索引查询。
这跟 MySQL 的「覆盖索引」是同一个道理(呼应第 12 篇):二级索引的叶子节点如果已经包含了查询要的所有字段,就省去了「回表」这一步。
在 explain() 里怎么判断是否覆盖查询?看 totalDocsExamined(文档扫描数)是否为 0:
// 建一个覆盖 name + age 的复合索引db.students.ensureIndex({name: 1, age: 1})// 查询和投影都只用 name + age,能完全被索引覆盖db.students.find( { name: 'zfpx150000' }, { name: 1, age: 1, _id: 0 } // 👈 _id 必须显式排除,否则还是要读文档).explain()// 若 totalDocsExamined = 0,说明没碰任何实际文档,纯索引返回一个关键细节:**投影里必须显式排除 _id**(_id: 0),因为 _id 默认返回、且通常不在你的索引里,一旦返回 _id 就必须回文档取,覆盖查询就失效了。
💬 面试官:什么是覆盖查询?它是怎么提升查询性能的?
✅ 标准答案:当查询涉及的字段和返回字段都恰好被索引覆盖时,MongoDB 直接从索引返回结果、不读实际文档,省掉一次磁盘读取,性能显著提升。判断方式是
explain()里totalDocsExamined为 0。
🎁 加分答案:能说出两个关键前提——① 投影里必须显式排除
_id(_id: 0),否则_id会强制回文档;② 和 MySQL 的覆盖索引是同一原理(二级索引叶节点含所需字段就不用回表),把两套数据库的知识串起来。
🔧 真实场景:药品搜索列表只需要「药名 + 规格」两个字段。建一个 {name: 1, spec: 1} 复合索引,查询和投影都只用这两个字段、排除 _id,几百万条药品的搜索就不碰任何实际文档,纯索引返回。
5. Mongoose 中间件与虚拟字段
Mongoose 的 pre/post 钩子(middleware)能在 save/remove/find 等操作前后插入逻辑,典型用途是「保存前自动算衍生字段」。比如用户注册时,在保存前用 salt 把明文密码 hash 掉:
const crypto = require('crypto')TeacherSchema.pre('save', function(next) {this.password = crypto.createHash('md5').update(this.password).digest('hex') next()})pre('save') 在每次 save 之前执行,this 指向当前要保存的文档,把 password 换成 hash 值再落库。这样业务代码只关心「传明文密码」,加密逻辑被收敛在 Schema 层,不会散落各处。
virtual 虚拟字段则解决「冗余存储」的问题。虚拟字段不持久化到数据库,读取时基于已有字段动态计算。比如「患者年龄」不存,而是按出生日期实时算:
TeacherSchema.virtual('area').get(function() {returnthis.phone.split('-')[0] // 从电话号里动态算区号})TeacherSchema.virtual('address').get(function() {returnthis.province + this.city // 拼接省市})// 读取时直接访问虚拟属性const res = await Teacher.findOne({name: 'virtual'}, {_id: 0, __v: 0})console.log(res, res.address, res.area)模型属性 = Schema 定义的属性 + virtual 属性
为什么用 virtual 而不是直接存年龄?因为年龄是派生数据,存了就要在出生日期变化时同步更新,容易出现不一致。virtual 用「实时计算」替代「冗余存储」,从根上消除更新一致性问题。
除了钩子和虚拟字段,Mongoose 还支持在 Schema 上扩展自定义方法——statics(类级,针对集合)和 methods(实例级,针对单个文档):
// statics:类上扩展,针对集合StudentSchema.statics.findByName = function(name) {returnthis.findOne({name})}// methods:实例上扩展,针对单个文档StudentSchema.methods.findByName = function(model) {returnthis.model(model).findOne({name: this.name})}在类上还是实例上扩展,关键看这个操作是针对集合还是单个实例
还有 plugin 插件——Schema 是可插拔的,插件把通用逻辑(如自动记录最后修改时间)打包复用:
// plugin.js:给 Schema 加 lastModify 字段 + 保存前自动更新时间module.exports = functionlastModified(schema, options) { schema.add({lastModify: Date}) schema.pre('save', function(next) {this.lastModify = newDate() next() })if (options && options.index) { schema.path('lastModify').index(options.index) }}// 使用:TeacherSchema.plugin(plugin, {index: true})💬 面试官:Mongoose 的
pre/post钩子和虚拟字段分别解决什么问题?✅ 标准答案:钩子(
pre/post)在save/remove/find等操作前后插入逻辑,把「保存前自动算衍生字段、加密密码」这类横切逻辑收敛到 Schema 层;虚拟字段(virtual)不持久化、读取时基于已有字段动态计算(如按出生日期算年龄),用「实时计算」替代「冗余存储」,避免更新一致性问题。
🎁 加分答案:能说出虚拟字段的本质是「派生数据不落库、用时才算」,它消除的是「两个字段本该保持同步却可能不一致」的冗余陷阱。再补一句:钩子适合放「加密、审计、衍生计算」这类每次写入都要做的横切逻辑,但要警惕在钩子里做「重 I/O」(会拖慢每次 save),重逻辑应移到 service 层。
🔧 真实场景:患者注册时,pre('save') 统一 hash 密码;患者年龄用 virtual 按出生日期算,前端展示永远是最新值,不需要在生日当天跑批量更新任务。
6. Schema-less 的一致性兜底
文档模型的优势是灵活演进——加一个字段不用停机迁移,新老文档可以并存。但代价是失去数据库层的结构约束:数据库不校验你存的是 age: 30 还是 age: "三十",脏数据会毫无阻拦地混进来。一致性的责任从数据库转移到了应用层。
实践中的兜底方案就是 Mongoose Schema 在应用层做校验:
const TeacherSchema = new Schema({age: {type: Number,max: 200, // 👈 应用层校验:上限min: 0, // 👈 应用层校验:下限required: true, // 👈 必填 },createAt: { type: Date, default: Date.now() },})数据库层「不约束」给了灵活性,应用层 Schema 校验把一致性「补回来」——既保留了文档模型加字段不用迁移的优势,又有类型和约束的兜底。这正是「Schema-less 不等于无 Schema」这句话的完整含义。
三、注意事项
1. Schema-less 的代价
数据库不约束结构,脏数据容易混入。如果不在应用层做 Schema 校验,同一个集合里的字段会五花八门——有的文档有 age、有的没有,有的是数字、有的是字符串——查询和迁移都会崩。必须靠应用层 Schema 校验兜底(Mongoose 的 type/required/min/max),否则文档模型的「灵活」会变成「失控」。
2. $match 要尽早放
聚合管道里 $match 越靠前,后续阶段处理的文档越少。把过滤条件写到最后面,会导致全量文档跑完整个管道才被过滤,性能天差地别:
// ✅ 先过滤再分组:$match 靠前,只统计 2026 年的处方db.prescriptions.aggregate([ { $match: { year: 2026 } }, { $group: { _id: '$dept', count: { $sum: 1 } } },])// ❌ 分组后再过滤:全量数据先跑完 $group,才轮到过滤db.prescriptions.aggregate([ { $group: { _id: '$dept', count: { $sum: 1 } } }, { $match: { year: 2026 } }, // 这时过滤已经晚了])这条规则和 SQL 里「WHERE 尽量靠前、减少中间结果集」是同一个直觉——管道是顺序执行的,前面的阶段省下的每一份数据量,都会在后面被放大收益。
3. 大文档读写
单个文档过大(比如把海量检验结果全塞进一个文档)会导致读写放大、内存压力大,超过 16MB 上限直接报错。合理做法是拆分子集合或引用:
病历主文档存「基本信息 + 就诊摘要」,每次就诊的详细检验结果用子集合/引用分开存 真正的大文件(图片、音频、视频)用 GridFS 存储——它把超过 16MB 的文件透明地切成 256K 的小块,用 fs.files(元数据)和fs.chunks(二进制内容)两个集合存储
4. 连接池与事务
MongoDB 4.0+ 的多文档事务只在副本集或分片集群可用,单机版不支持。而且事务本身有性能开销——它会占用连接、加锁、拉长响应时间。不要因为「有事务了」就把它当关系型用:能用单文档原子操作解决的,就别上多文档事务;真的需要跨集合强一致,才用事务,并且要部署在副本集上。
这也就回答了开头那个问题——事务的补齐没有改变文档模型和关系模型各自的适用边界,它只是让 MongoDB 在「偶尔需要跨文档一致性」时有了兜底手段,而不是让它变成另一个 MySQL。
💬 面试官:MongoDB 4.0+ 支持多文档事务后,是不是就可以完全替代关系型数据库了?为什么?
✅ 标准答案:不能。第一,多文档事务只在副本集/分片集群可用、单机不支持;第二,事务有性能开销,频繁跨实体强一致扣减(如库存)还是关系型更擅长;第三,事务只是补齐了「偶尔需要跨文档一致性」的兜底,没有改变文档模型和关系模型各自的适用边界——经常跨实体聚合、强一致的数据依然该用关系型。
🎁 加分答案:能点出「单文档操作天然原子」这个前提——很多一致性需求在文档模型里根本不用事务,把相关字段嵌进一个文档、一次更新就天然原子了;真正需要事务的,是「跨集合」那少部分场景。所以正确姿势是「优先用嵌套文档消除事务需求,剩下的才用事务兜底」。
5. Mongoose populate 的 N+1
populate() 模拟 JOIN,但底层是多条查询——先查主文档,再对每个 _id 发一条查询去取关联文档。查「10 位学生及其老师」就是 1 + 10 次查询,列表或深关联场景会放大成 N+1。
// ❌ 10 个学生 = 1 次查学生 + 10 次查老师(N+1)const students = await Student.find({}).populate('teacher')// ✅ 改用聚合管道的 $lookup,一次查询完成关联const students = await Student.aggregate([ { $lookup: {from: 'teachers',localField: 'teacher',foreignField: '_id',as: 'teacher', } },])处理 N+1 的两条路:批处理(收集所有 _id 一次 IN 查询)或**改用聚合管道的 $lookup**(在数据库端一次完成关联,不发多条查询)。
四、对比与面试
前面三层走完了「怎么用 → 怎么选 → 怎么避坑」,这一节站高一步收口:先把 MongoDB 放进数据库选型的坐标系看横向对比,再看面试官最常追问的点。
对比梳理
MongoDB 的文档模型和 MySQL 的关系型模型不是「谁更先进」,而是「读模型」不同——经常整体读、少跨实体关联选文档模型;经常跨实体聚合、强一致事务选关系型。即便 MongoDB 4.0+ 支持了多文档事务,也只在副本集/分片可用、且有性能开销,并不能因此替代关系型。把「读模型判据」和「事务边界」一起记住,才不会被「文档库也能事务」误导。
一张图总结(面试速记表)
IXSCAN 命中 vs COLLSCAN 全表扫描 | ||
totalDocsExamined=0,不读文档;投影必须排除 _id | ||
pre/post | ||
$match | ||
$lookup | ||
💡 记住这条主线:文档模型(读模型判据)→ 聚合管道(分阶段)→ 索引 + 覆盖查询(少读文档)→ Mongoose(Schema 兜底 + 钩子 + virtual)→ 事务边界(别当关系库)。MongoDB 的生产实践,每一步都在回答「什么数据、怎么读、怎么约束」。
面试核心问
什么场景适合用 MongoDB 的文档模型,什么场景更适合关系型数据库?(读模型:整体读少关联 → 嵌套文档;跨实体聚合强一致 → 关系型) 聚合管道的设计思想是什么?和 SQL 的 GROUP BY相比表达方式有什么不同?(多阶段顺序执行、命令式流水线 vs 声明式一步)什么是覆盖查询?它是怎么提升查询性能的?(字段全被索引覆盖,直接读索引不读文档, totalDocsExamined=0)Mongoose 的 pre/post钩子和虚拟字段分别解决什么问题?(钩子收敛横切逻辑,虚拟字段用实时计算替代冗余存储)MongoDB 4.0+ 支持多文档事务后,是不是就可以完全替代关系型数据库了?为什么?(不能:只在副本集可用、有性能开销、单文档原子优先、选型边界没变)
📝 思考题
一份患者电子病历,含「基本信息 + 多次就诊记录 + 每次就诊的检验结果」,要支持「患者详情页一次加载全量」和「医生按时间查某次就诊的检验明细」两种读法。你会怎么设计文档结构?提示:想想「嵌套文档」和「子集合引用」各自的读放大问题——如果就诊次数特别多(比如慢性病长期复诊),全嵌进一个文档会碰到 16MB 上限吗?什么时候该把「检验结果」拆成独立子集合?
欢迎评论区写出你的答案 👇
参考资料
https://www.mongodb.com/docs/manual/ (MongoDB 官方文档) https://www.mongodb.com/docs/manual/aggregation/ (聚合管道) https://www.mongodb.com/docs/manual/indexes/ (索引) https://www.mongodb.com/docs/manual/core/transactions/ (多文档事务) https://mongoosejs.com/ (Mongoose 官方文档) https://www.mongodb.org.cn/ (MongoDB 中文网) https://www.runoob.com/mongodb/mongodb-tutorial.html (菜鸟教程)
🔖 这是「Node.js 全栈深度拆解」系列第 13 篇。上一篇:《MySQL 全栈:基本使用/索引与事务最佳实践/慢查询与设计范式》;下一篇预告:《Redis 深度:五大数据结构/持久化/缓存与分布式锁最佳实践/接口限流》