ARTICLE · 1209559
我花 50 行代码搭了个 AI 聊天工具,结果它记不住我叫什么
Streamlit 当壳、DeepSeek 当脑,从零拼出一个网页聊天窗——顺手拆穿"多轮对话"的假象
学 AI 应用开发,第一关基本都长一个样。
脑子里想的是"我要有个自己的聊天窗口",手上干的是——搜"Python 聊天机器人教程",关掉;换个关键词,再搜,再关掉。
前后端、Vue、部署、跨域……光"前端"两个字就能劝退一半人。
真动手了你才会发现:一个能聊天的网页,核心代码不到 50 行。
先说跑起来什么样:顶上一个标题,中间大片空白,最底下钉着一个输入框。你敲一句,它回一句。没有登录、没有侧边栏、没有打字机特效。朴素得有点可爱。
然后我干了件特别自然的事:
我: 我叫冬青,你记住了吗?它: 你好冬青,很高兴认识你。我: 我叫什么?它: 抱歉,我还不知道你的名字呢。
……行。恭喜,这一跤摔得值——它就是这个项目里含金量最高的坑。
这篇把整个搭建过程拆给你看,最后把这个坑刨到底。
一、把最劝退人的"前端"划掉
Streamlit 的定位可以用一句话说完:它不是让你写网页,它是让你把 Python 脚本直接变成网页。
不需要 HTML、不需要 CSS、不需要 JavaScript、不需要懂"组件"和"状态管理"。你在脚本里写什么,页面上就从下往上按顺序长出来。
st.title("测试") | |
st.divider() | |
st.chat_input("请输入您的问题") | |
st.chat_message("assistant").markdown("你好") |
这一整套界面,四行。
装起来也简单:
pip install streamlit requestsstreamlit run chat_page.py默认跑在 localhost:8501,浏览器自动弹开。改代码保存,页面立刻问你要不要刷新。就这么个东西,撑起了无数 AI Demo 的界面——因为所有人都在同一个想法上达成了一致:我不想写前端,我只想看看模型能不能跑通。
二、拆开看:三段代码,一个聊天工具
这份代码逻辑上是三层,从上到下:一个调模型的类、一个存对话的字典、一小段页面。整个文件 50 行出头,一半还是注释和空行。
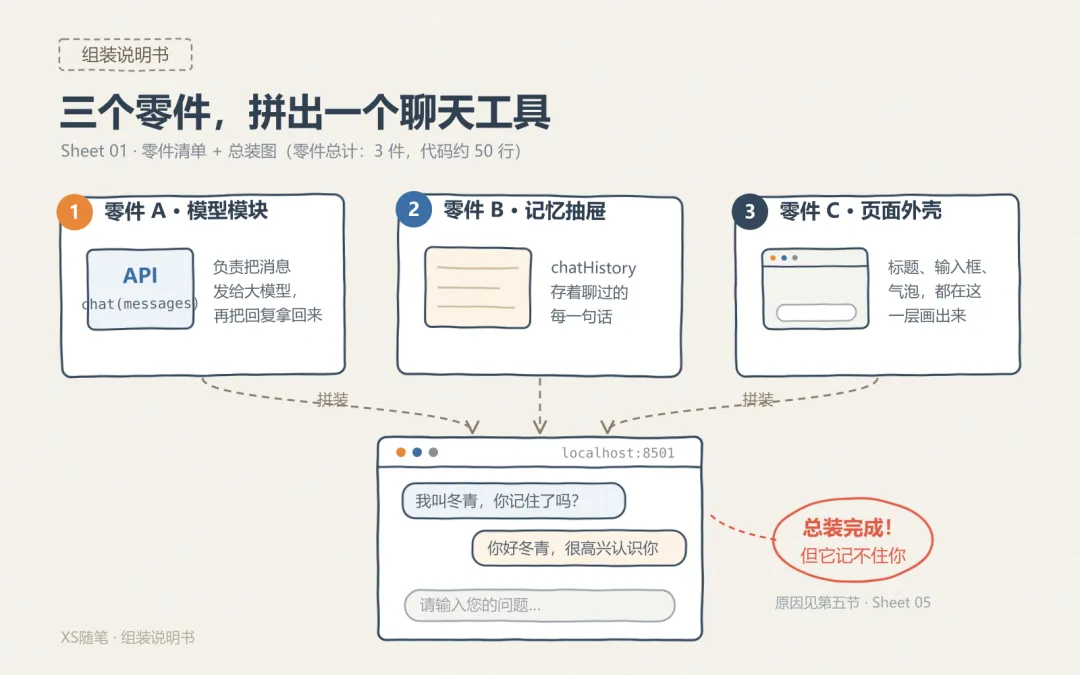
2.1 模型封装层:真正和 AI 打交道的 30 行
classDeepSeekLLM:"""真·大模型。DeepSeek 是 OpenAI 兼容接口,POST /v1/chat/completions。""" name = "DeepSeek(真模型)"def__init__(self):self.key = os.environ.get("DEEPSEEK_API_KEY", "").strip()ifnotself.key:raise RuntimeError("未设置 DEEPSEEK_API_KEY")self.model = os.environ.get("DEEPSEEK_MODEL", "deepseek-flash")self.url = "https://api.deepseek.com/v1/chat/completions"defchat(self, messages, temperature=0.2, timeout=60) -> str: resp = requests.post(self.url, headers={"Authorization": f"Bearer {self.key}","Content-Type": "application/json"}, json={"model": self.model, "messages": messages,"temperature": temperature, "stream": False}, timeout=timeout, ) resp.raise_for_status()return resp.json()["choices"][0]["message"]["content"]这里有几个值得记一笔的点:
• 密钥从环境变量读,不写死在代码里。密钥写进代码再推到 GitHub,等于把家门钥匙挂在门锁上(这类事故每个月都有几起)。没设置就直接报错拦下,比"跑起来才提示 401"友好。 • 模型名也走环境变量,默认 deepseek-flash。换成你账号里能用的模型名即可,改配置不改代码。• temperature=0.2,偏低。聊天问答希望答案稳一点、少发散;想让它有创意就调到 0.7~1.0。• timeout=60是保命参数。没有它,网络一卡,页面能一直转圈转到你怀疑人生。• 返回值就一句 resp.json()["choices"][0]["message"]["content"]——所有 OpenAI 格式的接口,回复都藏在这条路径里。
messages 是入参,长这样:
[{"role": "user", "content": "你好"}]role 取 user / assistant / system。记住这个格式,第五节要考。
2.2 会话记忆:一个字典,装下所有对话
if"chatHistory"notin st.session_state: st.session_state["chatHistory"] = []就两行。但这两行是整个聊天工具的"记忆器官"——没有它,你每说一句话页面就清空一次。
st.session_state 你可以理解成给当前这次浏览器访问开的一个储物柜,写进去的东西在多次交互之间一直保留。装什么随你,这里装的是一个消息列表,每条都是 {"role": ..., "content": ...}。
2.3 界面层:渲染 + 调用,收工
llm = DeepSeekLLM() # 顶层实例化,后面直接用st.title("测试") # 标题(先占个位,正式用记得改)st.divider() # 分割线prompt = st.chat_input("请输入您的问题") # 底部输入框if prompt: st.session_state["chatHistory"].append({"role": "user", "content": prompt})for message in st.session_state["chatHistory"]: st.chat_message(message["role"]).markdown(message["content"])with st.spinner("思考中"): response = llm.chat(messages=[{"role": "user", "content": prompt}]) st.session_state["chatHistory"].append({"role": "assistant", "content": response}) st.chat_message("assistant").markdown(response)翻译成人话:
1. 用户在输入框敲了东西, prompt拿到这句话;2. 把它塞进历史; 3. 把历史里的每一句话重新画一遍(这一步为什么必须做,下一节说); 4. 转圈显示"思考中",真去调模型; 5. 拿到回复,塞进历史,再画出来。
就这么点东西,一个能用的聊天工具就成型了。
三、Streamlit 最容易懵的一点:每次输入,脚本从头重跑
如果你写过前端,看上面那段代码一定会愣住:"把历史全画一遍"是什么操作?页面上原来的消息不还在吗?
不在了。
Streamlit 的心智模型和传统前端完全不同:用户的每一次交互(敲回车、点按钮),整个脚本都会从上到下重新执行一遍。
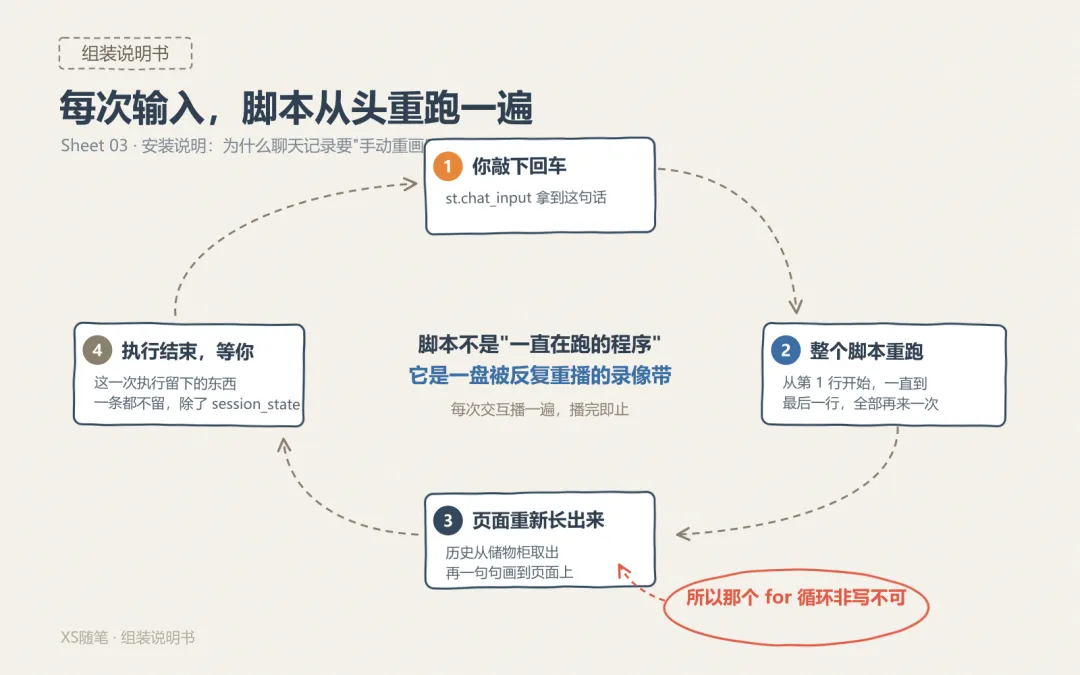
也就是说:
• 页面上你看到的所有内容,都是这次脚本执行的产物; • 上一次执行留下的东西,一个都不会自动保留; • 所以"聊天记录还在"这件事,只能靠 st.session_state从储物柜里取出来,手动重新画一遍。
这就是那个 for 循环存在的全部理由。
想通这一点,很多"玄学 bug"就自动解释了:为什么按钮点一下代码跑两次?为什么变量赋值了又变回去?为什么改个函数名页面没反应?——因为你的代码根本不是一个"一直运行的程序",而是一个"每次交互都被重新播放的录像带"。
顺带一提,这个储物柜是按浏览器会话开的:刷新页面、换个标签页,就是一个新柜子,聊天记录清零。这也是它和真正的"服务端记忆"最直接的区别。
四、模型那头:为什么要"手搓"HTTP 请求
你可能注意到了,上面调模型没用任何 SDK,是 requests.post 直接打的 HTTP 接口。原因很简单:
DeepSeek 提供的是 OpenAI 兼容接口。
"兼容"这两个字价值极高——它意味着所有按 OpenAI 格式写的东西,换个 base_url 就能用。请求体长这样:
{"model": ..., "messages": [...], "temperature": 0.2, "stream": False}model、messages、temperature、stream,四个字段,跟 OpenAI 的写法一模一样。
所以"手搓 HTTP"一点都不土——它顺手把一次对话调用的最小骨架摊开给你看。以后不管换成谁家的封装库、谁家的模型,你都知道底下真正在发生什么。
先会用裸接口,再去用封装库;顺序反了,就容易变成只会念咒的魔法师。
五、翻车现场:页面上像多轮,模型眼里每轮都是初见
回到开头那一跤。为什么它记不住我的名字?
问题就藏在这一行:
response = llm.chat(messages=[{"role": "user", "content": prompt}])我们满怀信心地把用户的问题单独打包发了过去——历史呢?没发。
chatHistory 里的那些消息,从头到尾只干了一件事:给页面的 for 循环画气泡用。 它们从来没有离开过浏览器。
于是出现了这个诡异的局面:
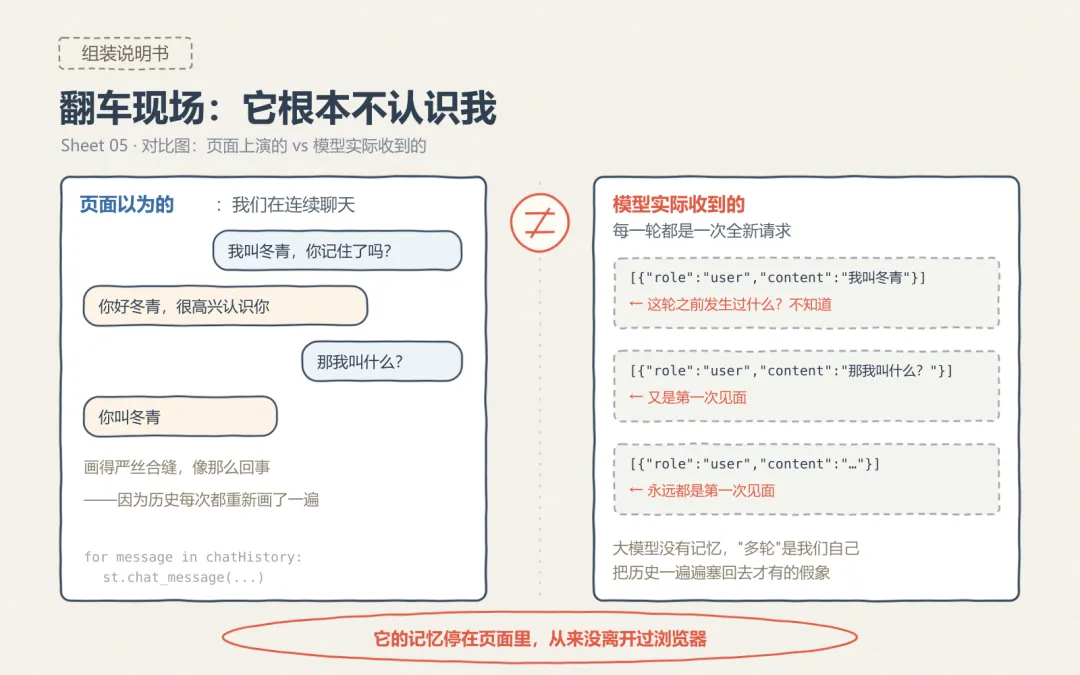
[用户:我叫冬青] | |
[用户:我叫什么?] | |
它不是在装傻,它是真不知道。 大模型没有"记忆",它不记得上一次请求里发生了什么——每次调用对它来说都是全新的、完全独立的一次。所谓"多轮对话",从来都是我们自己把历史一遍遍重新塞给它的结果。
(顺便说,那个 for 循环把历史全画一遍,恰恰把这件事伪装得很好——页面上的人设是"我们在连续聊天",模型的人设是"我们第一次见面"。UI 越像真的,bug 越难发现。)
修复只有一行:
with st.spinner("思考中"): response = llm.chat(messages=st.session_state["chatHistory"]) # 整个历史一起发注意一个细节:chatHistory 里存的字段名恰好就是 role / content,跟接口要求的格式严丝合缝,所以可以直接整包扔过去,连转换都省了。
改完之后再问"我叫什么"——
我: 我叫冬青,你记住了吗?它: 你好冬青,很高兴认识你。我: 我叫什么?它: 你叫冬青。
成了。
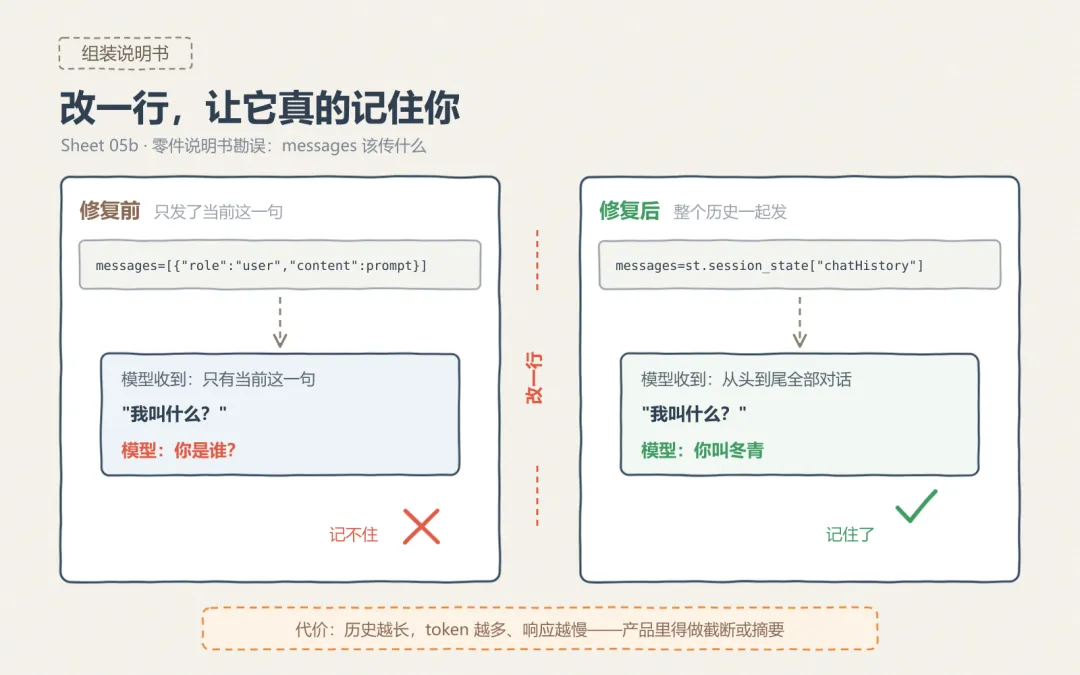
但别忘了它的代价:历史越长,token 烧得越快。聊到几十轮,成本和延迟都会爬上来——真正的产品里,上下文要做截断或者摘要,"什么都记住"不是免费的。
六、保命清单
如果这篇你只记七句话:
1. Streamlit 不用写前端,脚本从上到下执行,就是页面从上到下渲染; 2. 每次交互脚本从头重跑,所以历史必须靠 st.session_state手动重画;3. st.session_state是按浏览器会话开的柜子,刷新就清零,别当数据库用;4. 大模型没有记忆,多轮对话 = 每次把历史全量塞回去; 5. messages只发当前一句,就是"失忆"的根源——这是最容易埋、最难发现的坑;6. DeepSeek 是 OpenAI 兼容接口,四个字段就能发起一次对话——骨架看清了,再用什么封装库都不慌; 7. 上下文不是免费的,历史越长,token 和延迟越高,产品里必须做截断或摘要。
写在最后
50 行代码能跑出一个聊天工具,这件事本身就挺有意思:门槛低到不像真的,坑也深到不像真的。
我一开始以为难点在"怎么接通模型",结果真正让我卡住的,是"模型根本没记住我"——而这恰恰帮我想明白了 LLM 应用里最核心的一件事:模型本身无状态,所有"智能体验"都是外面这层壳精心维护出来的假象。
壳搭得好,它就像个贴心的助理;壳搭得糙,它就是个每次见面都要重新自我介绍的陌生人。