ARTICLE · 1214239
EdenLive 源码精读:状态留给引擎、画面交给模型,实时世界模型怎么在单张 H100 上跑过 24 FPS
EdenLive 源码精读:状态留给引擎、画面交给模型,实时世界模型怎么在单张 H100 上跑过 24 FPS10 月 18 日,VAST 开源了 Project Eden 系列的实时生成式渲染器 EdenLive:5B/14B 两档权重各分双向与少步两版,附实时流式服务与 35 页技术报告。仓库 7 天 159 星,开源当天 CSDN 上就有了部署教程。 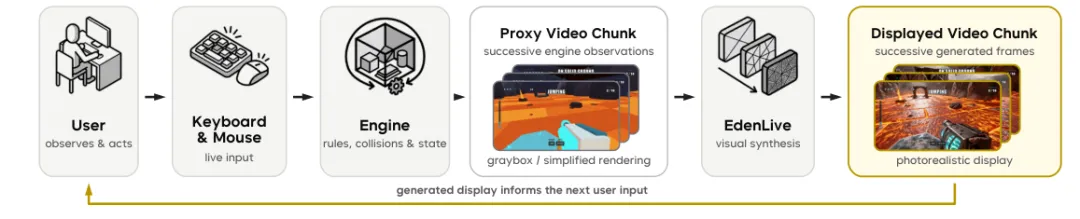
EdenLive 把交互式世界模型拆成两半:状态怎么演化,画面长什么样。上游程序——引擎或 agent 写的代码——执行规则、维护状态、渲染参考视频;EdenLive 只负责画好看,碰撞、得分、血量由上游算。开源给的是推理侧全套:四份 DiT 权重加离线与实时推理代码;训练代码与数据没发布。 报告口径:单张 H100 上,5B 在 1280×704 逐帧 29.80 FPS;经 LightX2V 加速,单张 RTX 5090 同分辨率约 24.7 FPS。我没有跑。 只看一处文件:edenlive/configs/wan22_5b_720p_few_step.yaml,控制注入、缓存窗口、chunk 大小全在里面。 场景:玩视频世界模型生成的游戏,按方向键画面要马上跟上。这类模型从自己生成的历史和当前输入直接预测下一帧,Genie 一脉到动作条件扩散模型都是。 矛盾在这。交互世界的状态是异构的:实体位置、血量、得分、视野外的对象、动作规则。全塞进一个生成网络,状态就只存在于潜上下文和已生成像素里,查不了、改不了、没法单独测试。容量也是矛盾:一张网络既学状态又学外观,实时部署下两头打折。 已有解法各有卡点:几何信号和稠密缓冲都要先做资产,coding agent 把状态显式化但画面还是灰盒,代理当像素拼进模型又会漏参考外观。EdenLive:状态交上游,外观用特征压,实时靠蒸馏加流水线。 主线:渲染器是一个三输入函数,其余设计都为它服务。 x(1..N) = R( r(1..N), y, p ) 三个量:r 是 N 帧参考视频,传布局、相机、事件时序,是状态进入模型的唯一通道;y 是目标首帧,锚定主体与外观;p 是静态或带时间戳的文本提示。 设计一:共享特征空间的视觉编码器。参考从灰盒到实拍,外观不同而布局运动相同。冻结 DINOv3 ViT-L/16 主干加训练出的线性投影,patch token 投到 1024 维后 L2 归一化,参考与目标共用一套。 训练用对齐损失、多正例 InfoNCE、梯度反转的域对抗三项联训。效果:条件走特征不走像素,外观漏出被压住;无配对视频把目标的外观扰动副本当参考。 设计二:少步 chunk 自回归蒸馏加有界缓存。先教师强制 SFT——双副本序列里干净副本当历史、噪声副本当目标,掩码照 chunk 因果结构写;再少步蒸馏,在模型自己的回放上训练,更新方向来自 real 与 fake score 的差。 推理时每 chunk 只走 4 步、不做 CFG。缓存固定 18 帧:前 6 帧是 attention sink 永久保留,其余滚动;RoPE 改按缓存槽位转,时间偏移永不出训练范围。 服务侧四段流水线——交互、仿真、生成、流送——一 chunk 前瞻,输入到显示延迟约两个 chunk;chunk 取 3 帧是折中。 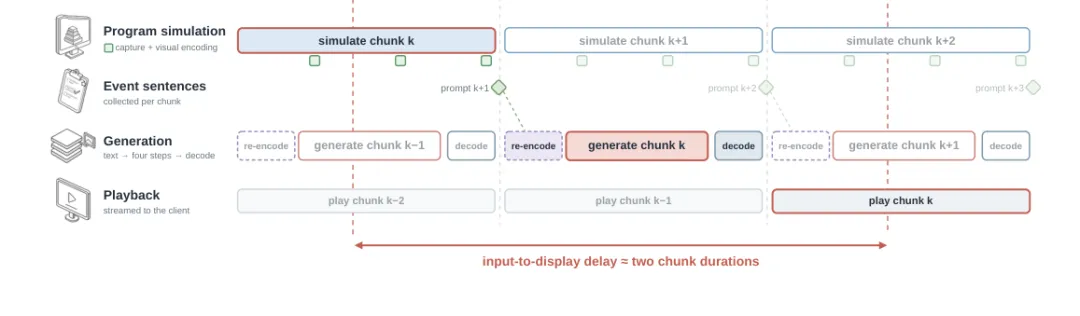
调用链:scripts/infer.py 调 inference/offline.py(建适配器 wan22_diffusers),样本经 inference/engine.py 进 strategies/chunk_causal.py,最后 runtime/cache/manager.py 跑 chunk-AR 主循环、调适配器的因果前向。 实现一:参考注入。论文在 4.2 与 4.3.1:参考特征沿通道维拼进 DiT,加宽的通道零初始化;代码在 models/adapters/wan22_diffusers/channel_concat.py。 if zero_init_control_channels: expanded_embedding.weight.zero_() expanded_embedding.weight[:, :latent_dim].copy_(old_embedding.weight) 整核置零、原 latent 通道权重原样拷回——加宽后的模型微调前与原版 Wan transformer 数值恒等。特征侧在 models/proxy_dino/encoder.py 的 L2 归一化,对应论文「投影后单位归一化」。 实现二:有界缓存、attention sink 与按槽位 RoPE。论文在 4.4.1 三段式索引;代码在配置 runtime.kv_cache(18 帧、6 sink、fixed_window)加 runtime/cache/manager.py。 max_attention_tokens = int(max_context_frames) * int(frame_seq_length) sink_attention_tokens = int(sink_context_frames) * int(frame_seq_length) 18 帧窗口、前 6 帧 sink、chunk 3 帧,对应论文 M=18、S=6、L=3;backend.forward 每步收 current_start 与窗口、sink 边界参数,槽位重排在 transformer 里做。 默认与分支分得清:四步、无 CFG 是默认路径;negative_prompt 配了不生效,是配置选择不是缺陷。rope_mode 默认 absolute、few-step 选 fixed_window,且必须配 pack_first_frame;RMSNorm 包装 5B 不开、14B 开。 数据两条来路:真实与游戏视频做「细到粗」变换、agent 建 3D 代理做「粗到细」合成,另配无配对开源视频;配对筛对齐与粒度,无配对筛质量。出自报告 4.1,仓库无对应代码。 优化与冻结:先微调视觉编码器(对齐、InfoNCE、域对抗,λctr=0.5),生成器训练时编码器冻结,蒸馏阶段冻结双向模型当 real score;生成器从 Wan2.2-TI2V-5B 与 Wan2.1-I2V-14B 初始化。训练步数与学习率没公开。 5B few-step 主配置:1280×704、117 帧、chunk_size 3、4 步、seed 2026092901;离线用 vae-5b 的 Wan2.2 VAE,实时测量用 LightTAE。14B 另一套:832×480、16fps、CLIP 编码、首帧掩码拼接。 最影响可比性的是计时口径:从模型侧条件处理起算,到生成帧进 CPU 内存停表,proxy 渲染与传输不计入;VACE 拿 DA3 估计深度,基线几何图预算好不计时。测量硬件 H100。 数字按表分开说。表 1(30 秒长程):14B 相机旋转误差最低 11.61°,I2V Subject 0.9465、VQAScore 0.8036、Aesthetic Drift 0.0419 等五项第一。 同表反面:平移误差与 Reference-DINO 最高都是 AgentGarten;DOVER 最高是 5B 的 9.938,14B 反而低于 AgentGarten——视觉质量这档 14B 不全面领先。 VLM 成对评测(45 例,Gemini-3.8-Flash 裁判):14B 五个维度全列第一(参考控制 1704.35 等),5B 五项全列第二。 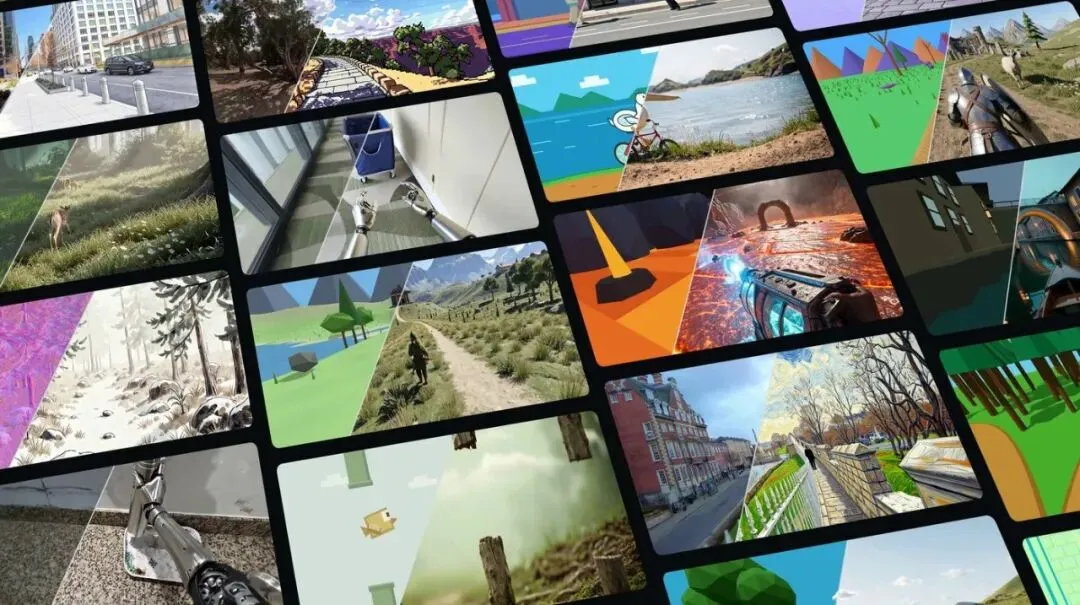
表 2(吞吐):5B 单 H100 832×480 73.52 FPS、1280×704 29.80;14B 八卡 26.76;AgentGarten 单卡 832×480 有 36.14——低于 5B 同分辨率、高于其 720P,分辨率不同不能拼成一个结论。 表 3:5B 720P 首帧 1161.79 ms、chunk 间隔 P95 391.54 ms、峰值显存 36.78 GiB。 表 4:粗输入下微调编码器把 DreamSim 从 0.5134 降到 0.3675;细输入 DreamSim 从 0.1049 升到 0.3344,是压掉源外观的设计使然。 RTX 5090 的 24.7 FPS 出自 LightX2V 部署指南、README 转述,我没有跑,不当实测。 已对应:4.2/4.3.1 对 channel_concat.py 加 encoder.py,4.4.1 对 kv_cache 配置加 manager.py;事件句子按 chunk 换文本,落在 chunk_causal.py 的 chunk_prompts。 代码比论文多讲的:pack_first_frame——首帧以 t=0 钉进第一个 chunk、每步后再钉一次;offload_generated_chunks 把回放挪去 CPU;RMSNorm 包装只归一化追加通道。 只是配置选择、不写成缺陷:negative_prompt 不建分支;离线 compile 关、实时在 FlashDreams 上开;编码器 image_size 与输出分辨率无关。 训练侧没法对读:SFT、蒸馏、数据管线都没发布。EdenLive 无 arXiv 号,论文载体是项目页的技术报告 PDF。 环境按 README:Linux、80GB 卡、Python 3.10、torch 2.13.0 cu130、diffusers 0.39.0;FA4 路线另需 SM90,文档在 docs/zh/wan22-fa4.md。 权重不在仓库里:hf download VAST-AI/EdenLive 到 models/EdenLive,约 210GB;挪位置就传 model.pretrained_dir。 最小样例自带:examples/samples 两条灰盒 recording.mp4,manifest 里第一帧指向 photoreal 封面。一条命令: python -m edenlive.scripts.infer --config edenlive/configs/wan22_5b_720p_few_step.yaml 成功标志:inference/wan22_5b_720p_few_step/save/inference/base 下落出生成视频、resolved.yaml 和逐样本 request.json。 容易看错的一处:fixed_window RoPE 与 pack_first_frame 绑死,不开就 raise;dit-5b 与 dit-5b-bidir 是两套权重,配错配置也不报错。 有证据的价值三条。规则精确性回到代码里:血量、计分直接从游戏状态叠到画面上,掉血只由程序判定。接口通用性:同一份权重吃灰盒、法线图到实拍。实时性:单 H100 720P 29.80 FPS,消费卡约 24.7 FPS。 限制写得出出处。报告 7 节自述三条:参考物体与目标身份的映射隐式;有界缓存没有外观细节记忆,长遮挡后重访会丢;单一学到的表征控制不了保留参考的哪一层粒度。 我读下来补两条推测:Reference-DINO 与 DOVER 两项 AgentGarten 仍有领先,压外观有代价;评测集是自建口径,第三方复现前表 1 只算报告实测。训练不开源是最大保留项,管线外界验证不了。 想上手的人先把 few-step YAML 读懂,再顺着 cache manager 走一遍 chunk 循环,取舍都在这两处。 EdenLive 官方技术报告 PDF(2026 年 10 月,项目页所挂,无 arXiv 编号):https://assets.vast-eden.ai/assets/edenlive/EdenLive-tech-report.pdf 项目页:https://vast-eden.ai/?p=edenlive 代码仓库(main 分支,commit f9f15fd1810fc274f167bc2ff8784b2645170286,2026-10-18):https://github.com/VAST-AI-Research/EdenLive 模型权重(约 210GB):https://huggingface.co/VAST-AI/EdenLive LightX2V 的 EdenLive 部署指南(RTX 5090 24.7 FPS 出处):https://github.com/ModelTC/LightX2V/blob/main/scripts/edenlive/README.md 主要源码与配置路径(相对仓库根):edenlive/configs/wan22_5b_720p_few_step.yaml、edenlive/configs/wan21_14b_480p_few_step.yaml、edenlive/scripts/infer.py、edenlive/inference/offline.py、edenlive/inference/engine.py、edenlive/inference/strategies/chunk_causal.py、edenlive/runtime/cache/manager.py、edenlive/runtime/cache/kv_cache.py、edenlive/models/proxy_dino/encoder.py、edenlive/models/adapters/wan22_diffusers/adapter.py、edenlive/models/adapters/wan22_diffusers/channel_concat.py、realtime/deploy.conf、realtime/start.sh
01 先看结论
02 问题背景
03 方法拆解
04 源码对照
05 实验配置
06 结果怎么看