ARTICLE · 1217502
1块钱/千页, 450万下载量,复杂文档解析标配
最近,LightOn 发布了第三代产品 LightOnOCR-3——一个端到端的文档理解模型家族。
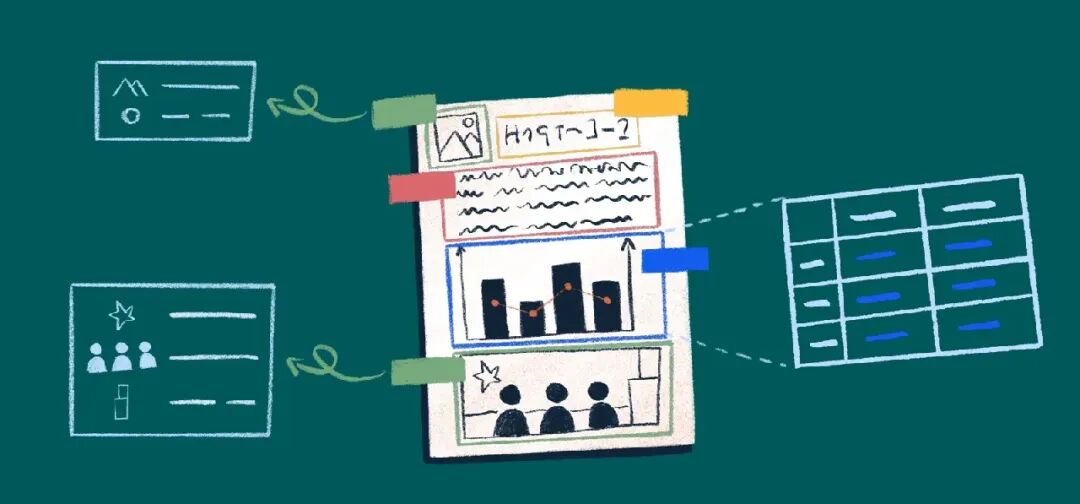
它的特点一句话就能概括:喂进去一页文档,一个模型直接输出全部。
不只是文字转写,还有版面元素的类型和坐标、图片的文字描述,甚至把图表直接还原成 HTML 数据表。
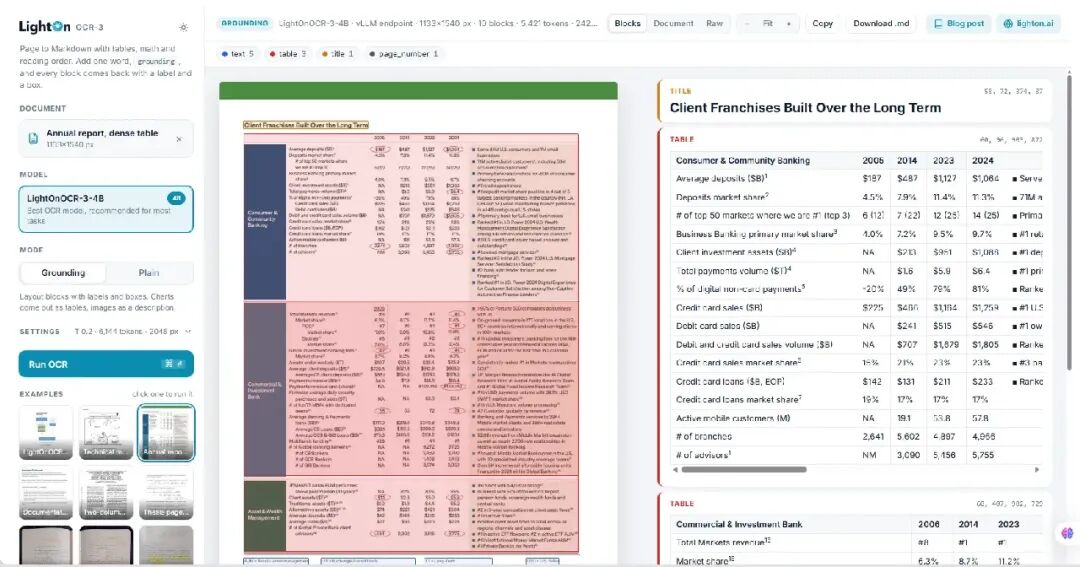
测试地址:https://huggingface.co/spaces/lightonai/LightOnOCR-3-Demo
一、为什么还需要 LightOnOCR-3
传统 OCR 的痛:不是识别不准,是“接力赛掉棒”
很多人对 OCR 的印象还停留在“把图片里的字认出来”。但真实业务文档从来不是一行行整齐的文字,而是标题、正文、表格、图表、公式、页眉页脚混杂的版面。
传统方案(包括不少知名框架)本质上是一条多模型流水线:先做版面检测,再做文字检测,然后文字识别,表格单独走结构识别,最后再排阅读顺序。
每个环节都是一个独立模型、一套独立工程。
流水线的问题不在于某一环不准,而在于:
误差逐级放大:版面检测错一个框,后面全错; 工程维护重:五六个模型版本各自迭代,部署、升级、排障都是成本; 结构信息丢失:就算文字全对,“这个表格在第几页哪个位置、图表里的数据是多少”这类结构化信息,往往需要再拼一套后处理逻辑。
通用大模型的路也不好走
那直接用 GPT-4o、Qwen-VL 这类通用视觉大模型做 OCR 行不行?
行,但贵、慢、重,而且输出格式不稳定——你要的是“这页文档的结构化 Markdown”,它可能顺手给你写一段读后感。
LightOnOCR-3:端到端,一个模型,全部输出
LightOnOCR-3 走的是第三条路:专为文档理解训练的端到端视觉语言模型。
喂进去一页文档图像,一个模型直接输出全部内容。文字转写只是基础,还包括版面元素的类型、坐标、图片描述,甚至把图表直接转成 HTML 数据表。
这一代的三个硬指标:
三个尺寸:0.8B、1B、4B 三个版本,全部开放权重,商用无附加条件; 更快更便宜:处理速度达到上一代 LightOnOCR-2 的 2 倍,官方称其为“领先 OCR 模型中最便宜的一档”,自托管场景下成本可低至每千页不足 1 块钱; 成绩站得住:在官方采用的三项公开基准上,4B 版本平均分 78.5、0.8B 版本 76.9——olmOCR-Bench 上排第二(仅次于参数量 35.1B、八倍于己的 Infinity-Parser2-Pro),ParseBench 上位列开源权重模型第一,手写体是强项。
二、一个架构、两种模式、一套坐标
LightOnOCR-3 的技术内核,可以用“一个架构、两种模式、一套坐标”来概括。
为文档而生的视觉语言模型
模型家族里,0.8B 和 4B 版本基于 Qwen3.5 视觉语言架构(Hugging Face 模型卡上带有 qwen3_5 标签),1B 版本沿用上一代 LightOnOCR-2 的架构,方便老用户无缝升级。
模型卡还带有 reinforcement-learning 标签,训练配方中可见 GRPO 强化学习与边界框奖励(rBBox reward)的身影——简单说,它不只是“看”文档,还被强化学习反复训练过“框得准不准”。
两种模式
这是设计上最讨巧的地方:
空提示词 → 纯文字转写,输出与 LightOnOCR-2 完全兼容,老用户零成本迁移; 提示词填入 “grounding” → 模型输出完整的 grounded 表示:每个版面元素带类型标签和坐标框。
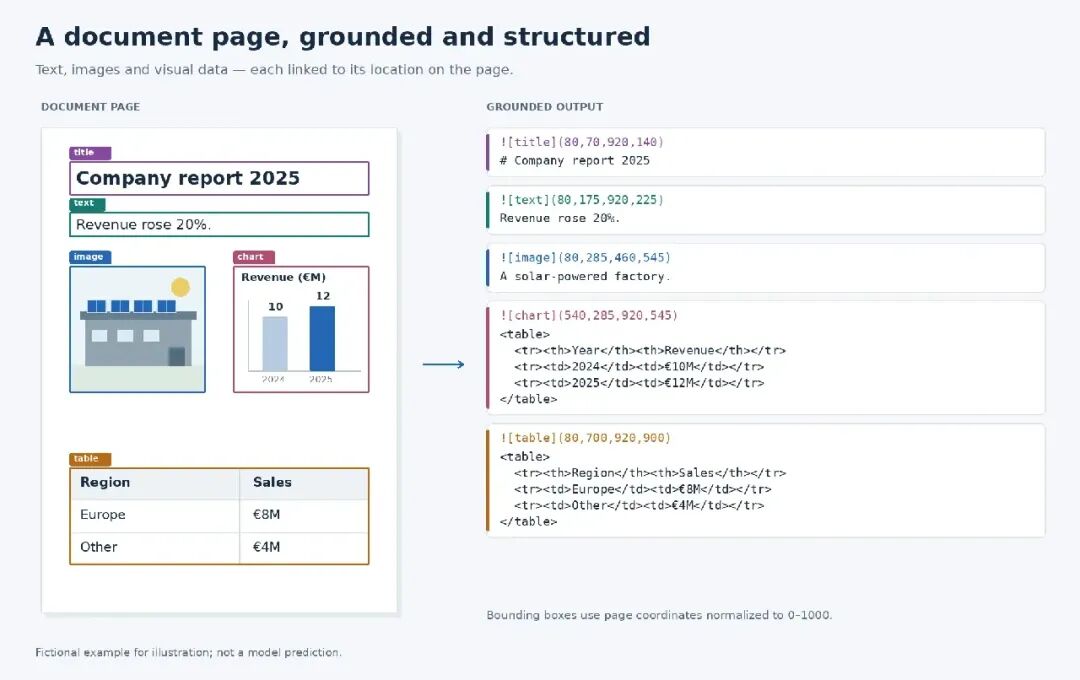
标题被标为 title,正文是 text,图片是 image 并附一句描述,柱状图被标为 chart 并直接还原成了 HTML 表格。
图表里的数据就这么变成了可计算的结构化数据。
标签体系与归一化位置
输出的标签体系覆盖文档的常见元素:标题、章节、正文、列表、表格、图表、公式、代码、图片、页眉页脚、页码、脚注等;坐标采用 0–1000 归一化的页面坐标系,与分辨率无关,方便你直接映射回原图做可视化或证据定位。
这个模型到底会什么?
LightOnOCR-3 的能力清单可以列得非常具体:
高精度文字转写:官方基准显示它在手写体上尤为突出——FRBench-pdf2md 排名第一,官方特别标注手写体为强项。 版面元素识别与定位(layout grounding):模型能识别标题、章节、正文、列表、表格、图表、公式、代码、图片、页眉、页脚、页码、脚注等元素,逐个给出类型标签和坐标框;跨块的长段落用 text+标签标记续接关系,保证长文本不断裂。标签 定义 text普通正文和段落。 title文档、章节或段落标题。 list项目符号或编号列表内容。 header页面页眉中的文本。 footer页面页脚中的文本。 page_number页码区域。 footnote脚注文本。 caption与图形、表格或其他视觉元素相关的说明文字。 formula数学公式和方程。 code代码块或类代码文本。 table表格区域及其内容。 image插图、照片及其他图像区域。 chart图表、图形及可视化数据。 header_image页面页眉中的图像区域,例如 Logo。 footer_image页面页脚中的图像区域。 aside_text主文本流之外的边注或侧栏文本。 +后缀 标记为延续块,而非独立的语义类别。
图片内容描述:每个图片块除了坐标,还附带一句简短的文字描述,让纯视觉内容变成可检索、可问答的文本信息。 图表数据提取:这是本代最亮眼的能力——柱状图、折线图、科学插图不只是被“看见”,而是被直接还原成 HTML 数据表,图表里的数字就此变成可计算的结构化数据。 文档结构理解与内容感知切块:模型会把页面内容组织成逻辑段落、标题、表格等带标签的语义块,天然适合下游做版面感知(layout-aware)的 RAG 切块;每个块都能回溯到原页位置,支撑带引用、可溯源的回答。 三档尺寸,按需取力:0.8B 主打轻量低成本,1B 沿用上一代架构方便平滑升级,4B 冲击最高精度;三者用法一致,切换成本几乎为零。 工程友好,成本可控:vLLM 原生支持,官方提供 Python 客户端与命令行工具,配合“每请求一图、服务端批量并发”的吞吐设计;官方口径下处理速度是上一代的 2 倍,自托管成本可低至每千页不足 1 美分,规模化处理存量文档的账很好算。
部署:vLLM 原生支持,一条命令跑起来
工程上它对开发者很友好——vLLM 原生支持,官方提供 Python 客户端和命令行工具:
# 启动服务(以 1B 为例)vllm serve lightonai/LightOnOCR-3-1B \ --limit-mm-per-prompt '{"image": 1}' --max-model-len 16384 \ --mm-processor-cache-gb 0 --no-enable-prefix-caching --port 8010# 一行命令解析整个 PDF,grounding 模式lightonocr paper.pdf --mode grounding几个官方建议的实用参数:
采样温度 0.1 0.8B/4B 版本页面最长边按 2048 像素处理,1B 版本为 1540 像素 批量处理靠 vLLM 并发64 页同时解析
三、融入 MinerU
MinerU 的优势在生态:从解析工具到本地文档库,它把“文档解析”做成了一套完整工具链;其核心模型 MinerU2.5 本身是模块化的两阶段架构(先版面分析,再内容识别)。
LightOnOCR-3可以作为专项补强模块,将常规页面交给现有流水线,遇到手写体、密集图表、需要把图表还原成数据表的“硬骨头”页面,单独路由给 LightOnOCR-3 的 grounding 模式处理,再把结果合并回去。
手写体和图表数据提取恰好是官方基准中它的强项。
https://www.lighton.ai/research/lightonocr-3 https://github.com/lightonai/LightOnOCR
推荐阅读