ARTICLE · 1227406
第 3.3 章:实现文档导入
文档导入唯一性
我们下载新的文档包、修正文件内容或者重新搭建索引时,都需要再次执行导入。
同一份文档重复出现时,程序需要根据数据库中的现有记录做出判断:
created | |
unchanged | |
updated | |
failed |
这个规则让导入命令可以安全地重复执行。判断依据是项目文档 ID 和内容 SHA-256。
文档录入数据库
创建 src/enterprise_rag_cli/infrastructure/document_repository.py:
from __future__ import annotationsfrom dataclasses import dataclassfrom typing import Literalfrom sqlalchemy import func, selectfrom sqlalchemy.orm import Sessionfrom enterprise_rag_cli.domain.models import Document, SourceDocumentfrom enterprise_rag_cli.infrastructure.tables import DocumentRecordImportAction = Literal["created", "updated", "unchanged"]@dataclass(frozen=True, slots=True)class ImportSummary: source_type: str parsed: int failed: int# 把解析成功的文档 存储/更新 到数据库中def save_document( session: Session, source: SourceDocument, document: Document, source_path: str,) -> ImportAction: # 查询 document_id 这条数据 # select * from documents where document_id = "xx" record = session.get(DocumentRecord, document.document_id) # 这个文档已经录入,并且没有改动 if ( record is not None and record.content_sha256 == document.content_sha256 and record.source_path == source_path and record.status == "parsed" ): return "unchanged" action: ImportAction = "created" if record is None else "updated" # 数据库中没有,添加 ORM 对象 if record is None: record = DocumentRecord( document_id=document.document_id, source_type=document.source_type, source_id=document.source_id, source_path=source_path, title=document.title, text=document.text, content_sha256=document.content_sha256, status="parsed", error_message=None, ) # 这里并不等于立即执行insert,还没提交事务 session.add(record) return action # 修改ORM对象 record.source_type = source.source_type record.source_id = source.source_id record.source_path = source_path record.title = document.title record.text = document.text record.content_sha256 = document.content_sha256 record.status = "parsed" record.error_message = None return action# 解析失败也要在数据库中创建一个失败记录def save_failure( session: Session, source: SourceDocument, document_id: str, source_path: str, error_message: str,) -> None: record = session.get(DocumentRecord, document_id) if record is None: record = DocumentRecord( document_id=document_id, source_type=source.source_type, source_id=source.source_id, source_path=source_path, title=None, text=None, content_sha256=source.content_sha256, status="failed", error_message=error_message, ) session.add(record) return record.source_path = source_path record.title = None record.text = None record.content_sha256 = source.content_sha256 record.status = "failed" record.error_message = error_message# 统计数据库中成功和失败个数,按类型分类def summarize_imports(session: Session) -> list[ImportSummary]: """ select 表示构建查询语句:select source_type from documents func.count() 表示聚合统计:count(*) filter 表示条件聚合: count(*) filter (where status = 'parsed') group_by 分组统计 order_by 升序排序 最终 SQL: SELECT source_type, COUNT(*) FILTER (WHERE status = 'parsed'), COUNT(*) FILTER (WHERE status = 'failed') FROM documents GROUP BY source_type ORDER BY source_type; """ statement = ( select( DocumentRecord.source_type, func.count().filter(DocumentRecord.status == "parsed"), func.count().filter(DocumentRecord.status == "failed"), ) .group_by(DocumentRecord.source_type) .order_by(DocumentRecord.source_type) ) # session.execute(statement)执行SQL return [ ImportSummary( source_type=source_type, parsed=parsed, failed=failed, ) for source_type, parsed, failed in session.execute(statement) ]save_document() 先通过主键读取现有记录。内容指纹、路径和状态都没有变化时,它直接返回 unchanged,不会执行无意义的更新。
save_failure() 使用同一个项目文档 ID 保存失败结果。以后文件修好后再次导入,成功结果会覆盖失败状态,不会多出一行。
summarize_imports() 按来源统计数据库中成功和失败的数量。它统计的是数据库当前状态,不只是本次命令处理的数量。
解析文档和数据库执行事务
创建 src/enterprise_rag_cli/application/ingest.py:
from __future__ import annotationsfrom collections.abc import Iterablefrom dataclasses import dataclassfrom pathlib import Pathfrom sqlalchemy.orm import Sessionfrom enterprise_rag_cli.domain.ids import make_document_idfrom enterprise_rag_cli.domain.models import SourceDocumentfrom enterprise_rag_cli.infrastructure.document_repository import ( save_document, save_failure,)from enterprise_rag_cli.infrastructure.documents import parse_text_document@dataclass(slots=True)class IngestStats: discovered: int = 0 created: int = 0 updated: int = 0 unchanged: int = 0 failed: int = 0# 解析文档,并写入数据库def ingest_documents( session: Session, sources: Iterable[SourceDocument], documents_dir: Path,) -> IngestStats: stats = IngestStats() for source in sources: stats.discovered += 1 source_path = source.path.relative_to(documents_dir).as_posix() document_id = make_document_id( source.source_type, source.source_id, ) try: document = parse_text_document(source) except (OSError, UnicodeError, ValueError) as error: # 解析文档失败,创建失败 ORM 对象 save_failure( session=session, source=source, document_id=document_id, source_path=source_path, error_message=str(error), ) stats.failed += 1 continue # 解析文档成功,创建 成功ORM对象 action = save_document( session=session, source=source, document=document, source_path=source_path, ) if action == "created": stats.created += 1 elif action == "updated": stats.updated += 1 else: stats.unchanged += 1 # 执行事务,写入数据库 session.commit() return stats应用层只负责串联已有步骤:
SourceDocument → parse_text_document() → save_document() 或 save_failure() → IngestStats这里只捕获文件读取和内容检查中可以预期的异常。编程错误和数据库错误不应该被当成普通坏文档悄悄忽略。
整批文档处理完成后统一提交事务,避免为 5,000 份文件分别执行 5,000 次提交。SQLAlchemy 的 Session 和事务行为可以参考 SQLAlchemy Session Basics(https://docs.sqlalchemy.org/en/20/orm/session_basics.html)。
测试
下面的代码同样只是临时检查,不需要保存到项目文件。它用两份文档确认数据库写入和重复导入判断是否正常。
在项目根目录启动 Python 交互环境:
uv run python执行一次小规模导入:
from pathlib import Pathfrom enterprise_rag_cli.application.ingest import ingest_documentsfrom enterprise_rag_cli.config import get_settingsfrom enterprise_rag_cli.infrastructure.database import create_session_factoryfrom enterprise_rag_cli.infrastructure.documents import discover_source_documentssettings = get_settings()documents_dir = settings.data_dir / "documents"sources = discover_source_documents( documents_dir, source_type="fireflies", limit=2,)session_factory = create_session_factory(settings)with session_factory() as session: stats = ingest_documents(session, sources, documents_dir)print(stats)第一次执行时会看到两份文档被创建。在 Navicat 中刷新 documents 表,可以看到数据库中新增了两条 source_type 为 fireflies 的记录,说明两份文档已经成功写入数据库。
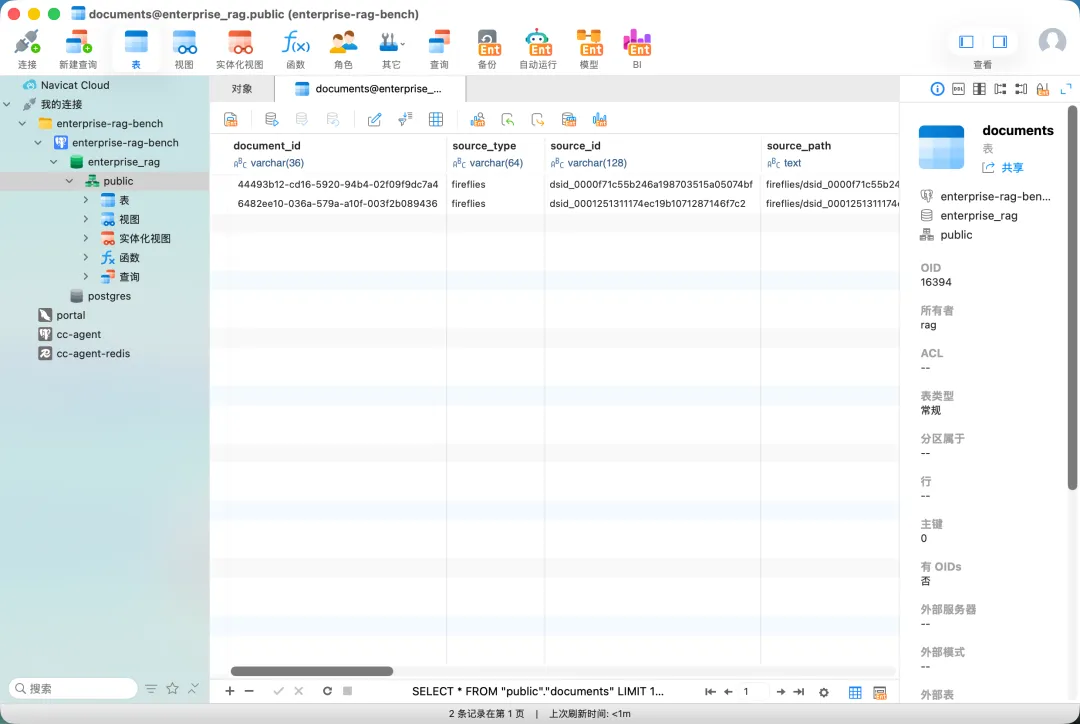
再次执行同一段代码,结果会变成两份文档未变化:
IngestStats(discovered=2, created=0, updated=0, unchanged=2, failed=0)检查完成后执行 exit() 退出 Python。
这说明导入流程已经可以安全地重复执行。下一节把它接入 rag ingest,并显示完整导入进度和质量汇总。
相关链接
• SQLAlchemy Session Basics:https://docs.sqlalchemy.org/en/20/orm/session_basics.html • 本节源码:https://github.com/agua-du/enterprise-rag-cli